

Hola, recientemente me encontré con un interesante desafío para configurar un almacenamiento para hacer copias de seguridad de una gran cantidad de dispositivos de bloques.
Cada semana realizamos copias de seguridad de todas las máquinas virtuales en nuestra nube, por lo que necesitamos ser capaces de gestionar miles de copias de seguridad y hacerlo de la manera más rápida y eficiente posible.
Desafortunadamente, las configuraciones estándar RAID5, RAID6 en este caso no nos servirán porque el proceso de recuperación en discos tan grandes como los nuestros será tediosamente largo y probablemente nunca terminará.
Veamos qué alternativas hay:
— Equivalente a RAID5, RAID6, pero con un nivel de paridad configurable. En este caso, la redundancia se realiza no por bloques, sino para cada objeto por separado. La forma más sencilla de probar el erasure coding es desplegar .
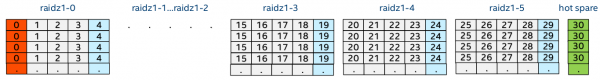
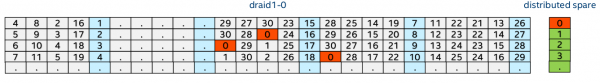
— es una característica aún no lanzada de ZFS. A diferencia de RAIDZ, DRAID tiene un bloque de paridad distribuido y al recuperarse involucra todos los discos del arreglo, lo que le permite manejar mejor las fallas de los discos y recuperarse más rápido después de un fallo.
Dispongo de un servidor Fujitsu Primergy RX300 S7 con un procesador Intel Xeon CPU E5-2650L 0 @ 1.80GHz, nueve módulos de memoria RAM Samsung DDR3-1333 8Gb PC3L-10600R ECC Registered (M393B1K70DH0-YH9), una cabina de discos Supermicro SuperChassis 847E26-RJBOD1, conectada a través de Dual LSI SAS2X36 Expander y 45 discos Seagate ST6000NM0115-1YZ110 en 6TB cada uno.
Antes de tomar una decisión, primero necesitamos probar todo adecuadamente.
Para ello me preparé y realicé pruebas de diversas configuraciones. Utilicé minio, que actuó como un backend S3, y lo ejecuté en diferentes modos con diversas cantidades de targets.
Principalmente se probó el caso de minio en erasure coding vs software raid con la misma cantidad de discos y discos de paridad, que son: RAID6, RAIDZ2 y DRAID2.
Para referencia: cuando inicias minio con un solo target, minio opera en modo S3 gateway, ofreciendo tu sistema de archivos local como un almacenamiento S3. Sin embargo, si inicias minio indicando múltiples targets, se activará automáticamente el modo Erasure Coding, que distribuirá los datos entre tus targets garantizando resistencia a fallos.
Por defecto, minio divide los objetivos en grupos de 16 discos, donde cada grupo tiene 2 paridades. Es decir, dos discos pueden fallar simultáneamente sin pérdida de datos.
Para probar el rendimiento, utilicé 16 discos de 6TB cada uno y escribí en ellos pequeños objetos de 1MB, lo cual describía con precisión nuestra carga futura, ya que todas las herramientas modernas de respaldo dividen los datos en bloques de varios megabytes y los escriben de esa manera.
Para realizar el benchmark se utilizó la herramienta s3bench ejecutada en un servidor remoto, que envió a minio decenas de miles de tales objetos en cien hilos. Luego intentó solicitarlos de la misma manera.
Los resultados del benchmark se presentan en la siguiente tabla:
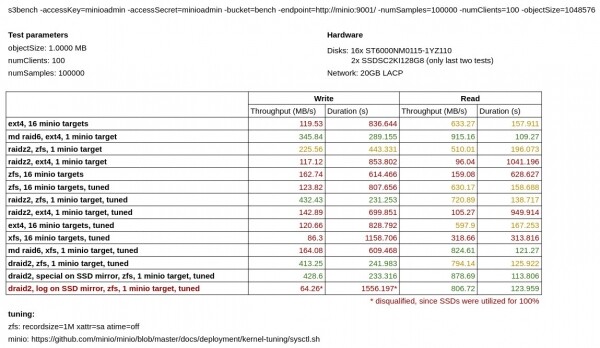
Como podemos ver, minio en modo propio de erasure coding trabaja significativamente peor en escritura que minio ejecutado sobre RAID6, RAIDZ2 y DRAID2 en la misma configuración.
Me probar minio en ext4 vs XFS. Sorprendentemente, para mi tipo de carga, XFS resultó ser significativamente más lento que ext4.
En la primera serie de pruebas, Mdadm mostró superioridad sobre ZFS, pero luego , que se puede mejorar el rendimiento de ZFS instalando las siguientes opciones:
xattr=sa atime=off recordsize=1My después de eso, las pruebas con ZFS fueron mucho mejores.
También se puede notar que DRAID no proporciona una ventaja significativa en rendimiento sobre RAIDZ, pero en teoría debería ser mucho más seguro.
En las últimas dos pruebas también intenté mover los metadatos (special) y ZIL (log) a un espejo de SSD. Sin embargo, mover los metadatos no proporcionó una ventaja significativa en velocidad de escritura, y al mover ZIL mis se encontraron con un límite del 100% de utilización, por lo que considero que esta prueba ha sido fallida. No descarto que si hubiera tenido discos SSD más rápidos, podría haber mejorado significativamente mis resultados, pero, desafortunadamente, no los tuve.
En conclusión, decidí detenerme en el uso de DRAID y, a pesar de su estado beta, es la solución más rápida y efectiva para el almacenamiento en nuestro caso.
Creé un DRAID2 sencillo en una configuración con tres grupos y dos spares distribuidos:
# zpool status data
  pool: data
 state: ONLINE
  scan: none requested
config:

    NAME                 STATE     READ WRITE CKSUM
    data                 ONLINE       0     0     0
      draid2:3g:2s-0     ONLINE       0     0     0
        sdy              ONLINE       0     0     0
        sdam             ONLINE       0     0     0
        sdf              ONLINE       0     0     0
        sdau             ONLINE       0     0     0
        sdab             ONLINE       0     0     0
        sdo              ONLINE       0     0     0
        sdw              ONLINE       0     0     0
        sdak             ONLINE       0     0     0
        sdd              ONLINE       0     0     0
        sdas             ONLINE       0     0     0
        sdm              ONLINE       0     0     0
        sdu              ONLINE       0     0     0
        sdai             ONLINE       0     0     0
        sdaq             ONLINE       0     0     0
        sdk              ONLINE       0     0     0
        sds              ONLINE       0     0     0
        sdag             ONLINE       0     0     0
        sdi              ONLINE       0     0     0
        sdq              ONLINE       0     0     0
        sdae             ONLINE       0     0     0
        sdz              ONLINE       0     0     0
        sdan             ONLINE       0     0     0
        sdg              ONLINE       0     0     0
        sdac             ONLINE       0     0     0
        sdx              ONLINE       0     0     0
        sdal             ONLINE       0     0     0
        sde              ONLINE       0     0     0
        sdat             ONLINE       0     0     0
        sdaa             ONLINE       0     0     0
        sdn              ONLINE       0     0     0
        sdv              ONLINE       0     0     0
        sdaj             ONLINE       0     0     0
        sdc              ONLINE       0     0     0
        sdar             ONLINE       0     0     0
        sdl              ONLINE       0     0     0
        sdt              ONLINE       0     0     0
        sdah             ONLINE       0     0     0
        sdap             ONLINE       0     0     0
        sdj              ONLINE       0     0     0
        sdr              ONLINE       0     0     0
        sdaf             ONLINE       0     0     0
        sdao             ONLINE       0     0     0
        sdh              ONLINE       0     0     0
        sdp              ONLINE       0     0     0
        sdad             ONLINE       0     0     0
    spares
      s0-draid2:3g:2s-0  AVAIL
      s1-draid2:3g:2s-0  AVAIL

errors: No known data errors
Bien, ya hemos resuelto el almacenamiento, ahora hablemos de lo que vamos a utilizar para el respaldo. Aquí quiero hablar de tres soluciones que logré probar, que son:
— un fork , una solución especializada para el respaldo de dispositivos de bloques, tiene una estrecha integración con Ceph. Puede obtener diferencias entre instantáneas y generar copias de seguridad incrementales a partir de ellas. Soporta una gran cantidad de backends de almacenamiento, incluyendo almacenamiento local y S3. Requiere una base de datos separada para almacenar la tabla hash de deduplicación. Entre sus desventajas: está escrito en Python y tiene un CLI algo poco receptivo.
— un fork , un medio bien conocido y confiable para la copia de seguridad, puede respaldar datos y los deduplica de manera eficiente. Puede guardar copias de seguridad tanto localmente como en un servidor remoto a través de scp. Puede respaldar dispositivos de bloques si se ejecuta con la bandera --special, entre sus desventajas: al crear una copia de seguridad, se bloquea completamente el repositorio, por lo que se recomienda crear un repositorio separado para cada máquina virtual. En principio, esto no es un problema, ya que se crean con mucha facilidad.
— un proyecto en activo desarrollo, escrito en Go, es bastante rápido y soporta una gran cantidad de backends de almacenamiento, incluyendo almacenamiento local, scp, S3 y muchos más. Es importante destacar que hay un para restic, que permite exportar el almacenamiento de manera más rápida para uso remoto. De todos los anteriores, me gustó más. Puede respaldo desde stdin. No tiene desventajas notables, pero hay algunas peculiaridades:
Primero, intenté usarlo en modo de repositorio compartido para todas las máquinas virtuales (como Benji) y funcionó bastante bien, pero las operaciones de restauración tardaban mucho, ya que cada vez, antes de restaurar, restic intenta leer los metadatos de todas las copias de seguridad. Este problema se resolvió fácilmente, al igual que con Borg, creando un repositorio separado para cada máquina virtual. Este enfoque resultó ser muy efectivo también para la gestión de copias de seguridad. Los repositorios separados pueden tener una contraseña específica para acceder a los datos, y también podemos estar tranquilos sabiendo que el repositorio global no se dañará de ninguna manera. Crear nuevos repositorios es tan simple como en Borg Backup.
En cualquier caso, la deduplicación se realiza solo en relación con la versión anterior de la copia de seguridad; la copia anterior se define por la ruta del respaldo especificado. Así que, si estás respaldando diferentes objetos desde stdin en un repositorio compartido, no olvides indicar la opción
--stdin-filename, o especificar explícitamente la opción cada vez--parent.
En segundo lugar, la restauración en stdout lleva significativamente más tiempo que la restauración en el sistema de archivos debido a su paralelismo. En el futuro, se planea agregar un soporte más estrecho para las copias de seguridad de dispositivos de bloques.
En tercer lugar, en este momento se recomienda usar , ya que la versión 0.9.6 tiene un error con la lenta restauración de archivos grandes.
Para probar la eficacia de la copia de seguridad y la velocidad de escritura/restauración desde la copia de seguridad, creé un repositorio separado y traté de respaldar una pequeña imagen de máquina virtual (21 GB). Se realizaron dos copias de seguridad sin modificar el original, utilizando cada una de las soluciones enumeradas para verificar cuán rápido/lento se copian los datos deduplicados.
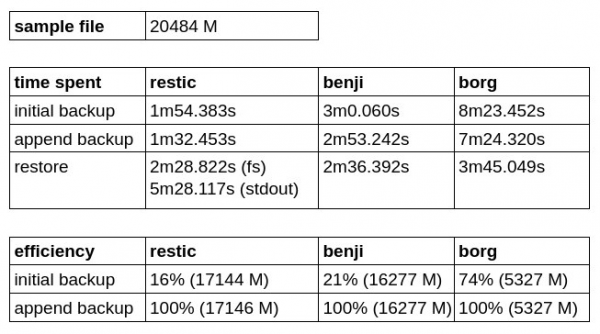
Como podemos notar, Borg Backup tiene el mejor coeficiente de eficiencia en la copia de seguridad inicial, pero pierde en velocidad tanto de escritura como de restauración.
Restic resultó ser más rápido que Benji Backup, pero restaura más lento en stdout, y lamentablemente aún no sabe escribir directamente en un dispositivo de bloques.
Sopesando todo lo bueno y lo malo, decidí parar en restic con rest-server como la solución de respaldo más conveniente y prometedora.
En este screencast, puedes ver cómo un canal de 10 gigabits se utiliza completamente durante varias operaciones de respaldo que se ejecutan simultáneamente. Es notable que la utilización de los discos no supera el 30%.
¡Estoy más que satisfecho con la solución obtenida!
Fuente: habr.com
