

Me llamo Denis Rozhkov, soy el líder de desarrollo de software en la empresa 'Gazinformservice', en el equipo de producto . La legislación y las normas corporativas imponen ciertos requisitos sobre la seguridad del almacenamiento de datos. Nadie quiere que terceros tengan acceso a información confidencial, por lo que para cualquier proyecto son importantes las siguientes cuestiones: identificación y autenticación, gestión de accesos a los datos, aseguramiento de la integridad de la información en el sistema, registro de eventos de seguridad. Por eso quiero hablar sobre algunos aspectos interesantes relacionados con la seguridad de las bases de datos.
Este artículo se ha preparado a partir de una presentación en organizado . Si no quieres leer, puedes ver:
El artículo constará de tres partes:
- Cómo proteger las conexiones.
- Qué es la auditoría de acciones y cómo registrar lo que sucede en el lado de la base de datos y las conexiones a ella.
- Cómo proteger los datos en la propia base de datos y qué tecnologías existen para ello.
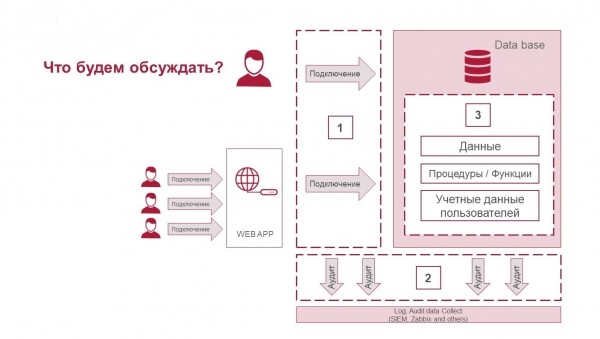
Tres componentes de la seguridad en bases de datos: protección de conexiones, auditoría de acciones y protección de datos
Protección de conexiones
Se puede conectar a la base de datos tanto directamente como indirectamente a través de aplicaciones web. Por lo general, el usuario del lado del negocio, es decir, la persona que trabaja con la base de datos, no interactúa con ella directamente.
Antes de hablar sobre la protección de las conexiones, es necesario responder a preguntas importantes que determinarán cómo se organizarán las medidas de seguridad:
- ¿es un usuario de negocio equivalente a un usuario de base de datos?
- ¿se garantiza el acceso a los datos de la base de datos solo a través de una API que controlas, o hay acceso directo a las tablas?
- ¿se ha aislado la base de datos en un segmento protegido, y quién interactúa con él y cómo?
- ¿se utiliza pooling/proxy y capas intermedias que pueden alterar la información sobre cómo se establece la conexión y quién utiliza la base de datos?
Ahora veamos qué herramientas se pueden aplicar para proteger las conexiones:
- Utiliza soluciones de tipo firewall de base de datos. Un nivel adicional de protección, como mínimo, aumentará la transparencia de lo que ocurre en la base de datos; en el mejor de los casos, podrás proporcionar protección adicional a los datos.
- Utilice políticas de contraseñas. Su aplicación depende de cómo esté estructurada su arquitectura. En cualquier caso, una sola contraseña en el archivo de configuración de la aplicación web que se conecta a la base de datos no es suficiente para protegerse. Hay varias herramientas de bases de datos que permiten controlar que el usuario y la contraseña requieran actualización.
Puede leer más sobre las funciones de evaluación de usuarios , también puede informarse sobre MS SQL Vulnerability Assessment .
- Enriquezca el contexto de la sesión con la información necesaria. Si la sesión es opaca, no entiende quién está operando en la base de datos, puede complementar la información sobre quién, qué y por qué se está haciendo algo dentro de la operación que se ejecuta. Esta información se puede ver en la auditoría.
- Configure SSL si no tiene una separación de red de la base de datos desde los usuarios finales, no está en una VLAN separada. En tales casos, es esencial proteger el canal entre el consumidor y la propia base de datos. Herramientas de protección también existen entre las de código abierto.
¿Cómo afectará esto el rendimiento de la base de datos?
Veamos el ejemplo de PostgreSQL, cómo SSL afecta la carga de la CPU, el aumento de tiempos y la disminución de TPS; ¿no consumirá demasiados recursos si se activa?
Cargamos PostgreSQL usando pgbench; es un programa simple para ejecutar pruebas de rendimiento. Ejecuta repetidamente una secuencia de comandos, posiblemente en sesiones paralelas de bases de datos, y luego calcula la velocidad media de las transacciones.
Prueba 1 sin SSL y con SSL — la conexión se establece con cada transacción:
pgbench.exe --connect -c 10 -t 5000 "host=192.168.220.129 dbname=taskdb user=postgres sslmode=require
sslrootcert=rootCA.crt sslcert=client.crt sslkey=client.key"
vs
pgbench.exe --connect -c 10 -t 5000 "host=192.168.220.129 dbname=taskdb user=postgres"Prueba 2 sin SSL y con SSL — todas las transacciones se ejecutan en una sola conexión:
pgbench.exe -c 10 -t 5000 "host=192.168.220.129 dbname=taskdb user=postgres sslmode=require
sslrootcert=rootCA.crt sslcert=client.crt sslkey=client.key"
vs
pgbench.exe -c 10 -t 5000 "host=192.168.220.129 dbname=taskdb user=postgres"Otras configuraciones:
factor de escalado: 1
modo de consulta: simple
número de clientes: 10
número de hilos: 1
número de transacciones por cliente: 5000
número de transacciones realmente procesadas: 50000/50000
No voy a escribir mucho texto explicativo aquí, solo compartiré los resultados obtenidos. Las pruebas se realizaron en 3 máquinas físicas (12 CPU, 384GB RAM, 15k SAS DISK, 10GBit/s Net), los brokers y zookeeper se desplegaron en lxc.:
SIN SSL
SSL
La conexión se establece en cada transacción
latencia promedio
171.915 ms
187.695 ms
tps incluyendo el establecimiento de conexiones
58.168112
53.278062
tps excluyendo el establecimiento de conexiones
64.084546
58.725846
CPU
24%
28%
Todas las transacciones se realizan en una sola conexión
latencia promedio
6.722 ms
6.342 ms
tps incluyendo el establecimiento de conexiones
1587.657278
1576.792883
tps excluyendo el establecimiento de conexiones
1588.380574
1577.694766
CPU
17%
21%
Con cargas pequeñas, el impacto de SSL es comparable al margen de error de medición. Si el volumen de datos transmitidos es muy grande, la situación puede ser diferente. Si establecemos una conexión por cada transacción (lo cual es raro, generalmente la conexión se comparte entre usuarios), se generan muchas conexiones/desconexiones, y el impacto puede ser un poco mayor. Es decir, hay riesgos de disminución del rendimiento, sin embargo, la diferencia no es lo suficientemente grande como para no utilizar la protección.
Tenga en cuenta que existe una gran diferencia al comparar los modos de operación: si trabaja dentro de una sesión o de diferentes. Esto es comprensible: se requieren recursos para crear cada conexión.
Tuvimos un caso en el que conectamos Zabbix en modo de confianza, es decir, no verificamos md5, no había necesidad de autenticación. Luego, el cliente pidió activar el modo de autenticación md5. Esto ejerció una gran carga en la CPU y el rendimiento cayó. Comenzamos a buscar formas de optimización. Una de las soluciones posibles al problema es implementar una restricción de red, crear VLAN separadas para la base de datos, agregar configuraciones para identificar quién se conecta y de dónde, y eliminar la autenticación. También se pueden optimizar las configuraciones de autenticación para disminuir los costos al habilitar la autenticación, pero en general, la aplicación de diferentes métodos de autenticación afecta el rendimiento y se deben considerar estos factores al diseñar la capacidad de computación de los servidores (hardware) para la base de datos.
Conclusión: en una serie de soluciones, incluso pequeños matices en la autenticación pueden tener un gran impacto en el proyecto, y es problemático cuando esto solo se entiende al implementarse en producción.
Auditoría de acciones
La auditoría puede no solo ser de la base de datos. La auditoría es la obtención de información sobre lo que sucede en diferentes segmentos. Esto puede incluir un firewall de base de datos y el sistema operativo sobre el cual se construye la base de datos.
En bases de datos comerciales de nivel Enterprise, la auditoría está bien, en open source — no siempre. Esto es lo que hay en PostgreSQL:
- logging predeterminado: registro incorporado;
- extensiones: pgaudit — si le falta el registro predeterminado, se pueden utilizar configuraciones separadas que abordan algunas tareas.
Complemento a la presentación en video:
La «registración básica de operadores puede ser asegurada con una herramienta estándar de registro con log_statement = all.
Esto es aceptable para la monitorización y otros tipos de uso, pero no proporciona el nivel de detalle normalmente requerido para auditorías.
No es suficiente tener una lista de todas las operaciones realizadas con la base de datos.
También debe haber la posibilidad de encontrar afirmaciones específicas que sean de interés para el auditor.
La herramienta estándar de registro muestra lo que el usuario solicitó, mientras que pgAudit se centra en los detalles de lo que ocurrió cuando la base de datos ejecutó la consulta.
Por ejemplo, un auditor puede querer asegurarse de que una tabla específica fue creada en la ventana de mantenimiento documentada.
Esto puede parecer una tarea sencilla para una auditoría básica y grep, pero ¿qué pasaría si se presenta algo como esto (intencionalmente confuso):
DO $$
BEGIN
EXECUTE ‘CREATE TABLE import’ || ‘ant_table (id INT)’;
END $$;
El registro estándar te dará esto:
LOG: declaración: DO $$
BEGIN
EXECUTE ‘CREATE TABLE import’ || ‘ant_table (id INT)’;
END $$;
Parece que encontrar la tabla de interés puede requerir cierto conocimiento del código en los casos en que las tablas son creadas dinámicamente.
Esto no es ideal, ya que sería preferible buscar simplemente por el nombre de la tabla.
Aquí es donde pgAudit será útil.
Para la misma entrada, generará esta salida en el registro:
AUDIT: SESIÓN,33,1,FUNCTION,DO,,,«DO $$
BEGIN
EXECUTE ‘CREATE TABLE import’ || ‘ant_table (id INT)’;
END $$;"
AUDIT: SESIÓN,33,2,DDL,CREE TABLA,TABLA,public.important_table,CREE TABLA important_table (id INT)
No solo se registra el bloque DO, sino también el texto completo CREATE TABLE con el tipo de operador, el tipo de objeto y el nombre completo, lo que facilita la búsqueda.
Al registrar operadores SELECT y DML, pgAudit se puede configurar para registrar una entrada separada para cada relación a la que se hace referencia en la declaración.
No se requiere análisis sintáctico para encontrar todos los operadores que tocan una tabla específica ()».
¿Cómo afectará esto el rendimiento de la base de datos?
Realicemos pruebas con la auditoría completa activada y veamos qué sucede con el rendimiento de PostgreSQL. Activaremos el registro máximo de la base de datos en todos los parámetros.
En el archivo de configuración cambiamos poco, de importancia, activamos el modo debug5 para obtener la máxima información.
postgresql.conf
log_destination = ‘stderr’
logging_collector = on
log_truncate_on_rotation = on
log_rotation_age = 1d
log_rotation_size = 10MB
log_min_messages = debug5
log_min_error_statement = debug5
log_min_duration_statement = 0
debug_print_parse = on
debug_print_rewritten = on
debug_print_plan = on
debug_pretty_print = on
log_checkpoints = on
log_connections = on
log_disconnections = on
log_duration = on
log_hostname = on
log_lock_waits = on
log_replication_commands = on
log_temp_files = 0
log_timezone = 'Europe/Moscow'
En la base de datos PostgreSQL con parámetros de 1 CPU, 2.8 GHz, 2 GB de RAM, 40 GB de HDD realizamos tres pruebas de carga, utilizando los comandos:
$ pgbench -p 3389 -U postgres -i -s 150 benchmark
$ pgbench -p 3389 -U postgres -c 50 -j 2 -P 60 -T 600 benchmark
$ pgbench -p 3389 -U postgres -c 150 -j 2 -P 60 -T 600 benchmark
Resultados de las pruebas:
Sin registro
Con registro
Tiempo total de llenado de la base de datos
43.74 seg
53.23 seg
RAM
24%
40%
CPU
72%
91%
Prueba 1 (50 conexiones)
Número de transacciones en 10 minutos
74169
32445
Transacciones/seg
123
54
Latencia media
405 ms
925 ms
Prueba 2 (150 conexiones con 100 posibles)
Número de transacciones en 10 minutos
81727
31429
Transacciones/seg
136
52
Latencia media
550 ms
1432 ms
Sobre los tamaños
Tamaño de la base de datos
2251 MB
2262 MB
Tamaño de los registros de la base de datos
0 MB
4587 MB
En resumen: una auditoría completa no es muy buena. El volumen de datos de la auditoría será igual al de los datos en la propia base de datos, o incluso más. Este volumen de registro que se genera al trabajar con la base de datos es un problema común en producción.
Veamos otros parámetros:
- La velocidad no cambia mucho: sin registro — 43.74 seg, con registro — 53.23 seg.
- El rendimiento de la RAM y CPU se verá afectado, ya que se necesita generar un archivo de auditoría. Esto también es notable en producción.
Al aumentar el número de conexiones, naturalmente, los indicadores empeorarán un poco.
En las corporaciones con auditoría es aún más complicado:
- hay muchos datos;
- la auditoría no solo se necesita a través de syslog en SIEM, sino también en archivos: si algo ocurre con syslog, debe haber un archivo cerca de la base de datos donde se almacenen los datos;
- para la auditoría se necesita una estantería separada, para no perjudicar el I/O de los discos, ya que ocupa mucho espacio;
- a veces, es necesario que los empleados de seguridad de la información requieran las normativas GOST, exigen la identificación conforme a estas normas.
Restricción del acceso a los datos
Veamos las tecnologías que se utilizan para proteger los datos y el acceso a ellos en bases de datos comerciales y de código abierto.
Qué se puede utilizar en general:
- Cifrado y ofuscación de procedimientos y funciones (Wrapping) — es decir, herramientas y utilidades que convierten el código legible en ilegible. Sin embargo, después no se puede cambiar ni refactorizar de nuevo. Este enfoque a veces se requiere al menos en el lado de la base de datos, ya que la lógica de las restricciones de licencia o de la autorización se cifra específicamente a nivel de procedimiento y función.
- La restricción de visibilidad de datos por filas (RLS) es cuando diferentes usuarios ven una misma tabla, pero con distintos conjuntos de filas, es decir, a algunas personas no se les puede mostrar ciertos datos a nivel de filas.
- La edición de datos mostrados (Masking) es cuando los usuarios en una misma columna de la tabla ven o los datos o solo asteriscos, es decir, para algunos usuarios la información estará oculta. La tecnología determina qué se le muestra a cada usuario según el nivel de acceso.
- La delimitación del acceso Security DBA/Application DBA/DBA se refiere más bien a la restricción del acceso a la propia base de datos, permitiendo desconectar a los empleados de seguridad de los administradores de bases de datos y administradores de aplicaciones. En el open source hay pocas tecnologías de este tipo, pero en bases de datos comerciales hay muchas. Son necesarias cuando hay muchos usuarios con acceso a los servidores.
- Restricción de acceso a archivos a nivel del sistema de archivos. Se pueden otorgar derechos y privilegios de acceso a directorios, de modo que cada administrador solo tenga acceso a los datos necesarios.
- El acceso mandatorio y la limpieza de memoria son tecnologías que se aplican poco.
- El cifrado de extremo a extremo en la base de datos es el cifrado del lado del cliente con la gestión de claves en el lado del servidor.
- Cifrado de datos. Por ejemplo, cifrado a nivel de columna: cuando se utiliza un mecanismo que cifra una columna específica de la base de datos.
¿Cómo afecta esto al rendimiento de la base de datos?
Veamos el ejemplo del cifrado a nivel de columna en PostgreSQL. Hay un módulo pgcrypto que permite almacenar campos seleccionados encriptados. Esto es útil cuando solo algunos datos tienen valor. Para leer los campos encriptados, el cliente envía la clave de descifrado, el servidor descifra los datos y se los entrega al cliente. Sin la clave, nadie podrá hacer nada con sus datos.
Realizaremos una prueba con pgcrypto. Crearemos una tabla con datos cifrados y otra con datos normales. A continuación, los comandos para crear las tablas, siendo el primer comando el útil para crear la extensión registrando la base de datos:
CREATE EXTENSION pgcrypto;
CREATE TABLE t1 (id integer, text1 text, text2 text);
CREATE TABLE t2 (id integer, text1 bytea, text2 bytea);
INSERT INTO t1 (id, text1, text2)
VALUES (generate_series(1,10000000), generate_series(1,10000000)::text, generate_series(1,10000000)::text);
INSERT INTO t2 (id, text1, text2) VALUES (
generate_series(1,10000000),
encrypt(cast(generate_series(1,10000000) AS text)::bytea, 'key'::bytea, 'bf'),
encrypt(cast(generate_series(1,10000000) AS text)::bytea, 'key'::bytea, 'bf'));
A continuación, intentaremos hacer una selección de datos de cada tabla y observaremos los tiempos de ejecución.
Selección de la tabla sin función de encriptación:
psql -c "timing" -c "select * from t1 limit 1000;" "host=192.168.220.129 dbname=taskdb
user=postgres sslmode=disable" > 1.txt
El cronómetro está activado.
id | text1 | text2
——+——-+——-
1 | 1 | 1
2 | 2 | 2
3 | 3 | 3
…
997 | 997 | 997
998 | 998 | 998
999 | 999 | 999
1000 | 1000 | 1000
(1000 líneas)
Tiempo: 1,386 ms
Selección de la tabla con función de encriptación:
psql -c "timing" -c "select id, decrypt(text1, 'key'::bytea, 'bf'),
decrypt(text2, 'key'::bytea, 'bf') from t2 limit 1000;"
"host=192.168.220.129 dbname=taskdb user=postgres sslmode=disable" > 2.txt
El cronómetro está activado.
id | decrypt | decrypt
——+—————+————
1 | x31 | x31
2 | x32 | x32
3 | x33 | x33
…
999 | x393939 | x393939
1000 | x31303030 | x31303030
(1000 líneas)
Tiempo: 50,203 ms
No voy a escribir mucho texto explicativo aquí, solo compartiré los resultados obtenidos. Las pruebas se realizaron en 3 máquinas físicas (12 CPU, 384GB RAM, 15k SAS DISK, 10GBit/s Net), los brokers y zookeeper se desplegaron en lxc.:
Sin encriptación
Pgcrypto (decrypt)
Selección de 1000 líneas
1,386 ms
50,203 ms
CPU
15%
35%
RAM
+5%
La encriptación impacta significativamente en el rendimiento. Se puede ver que el tiempo ha aumentado, ya que las operaciones de descifrado de datos encriptados (y el descifrado generalmente está envuelto en su lógica) requieren recursos considerables. Es decir, la idea de encriptar todas las columnas que contienen algún dato conlleva a una disminución del rendimiento.
Sin embargo, la encriptación no es una solución mágica que resuelva todos los problemas. Los datos descifrados y la clave de descifrado durante el proceso de descifrado y transmisión de datos están en el servidor. Por lo tanto, las claves pueden ser interceptadas por aquellos que tienen acceso total al servidor de base de datos, como el administrador del sistema.
Cuando hay una clave para toda la columna para todos los usuarios (incluso si no es para todos, sino para un conjunto limitado de clientes), esto no siempre es bueno ni correcto. Es por eso que se ha comenzado a implementar la encriptación de extremo a extremo, en las bases de datos se comenzaron a considerar opciones de encriptación de datos desde el lado del cliente y del servidor, y aparecieron esos mismos almacenes de claves — productos separados que aseguran la gestión de claves en el lado de la base de datos.

Medidas de seguridad en bases de datos comerciales y de código abierto
Funciones
Tipo
Política de Contraseñas
Auditoría
Protección del código fuente de procedimientos y funciones
RLS
Encriptación
Oracle
Comercial
+
+
+
+
+
MsSql
Comercial
+
+
+
+
+
Comercial
+
+
+
+
extensiones
PostgreSQL
Gratis
extensiones
extensiones
—
+
extensiones
MongoDb
Gratis
—
+
—
—
Disponible solo en MongoDB Enterprise
La tabla está lejos de ser completa, pero la situación es la siguiente: en los productos comerciales, las cuestiones de seguridad se han abordado durante mucho tiempo, en el código abierto, por lo general, se utilizan algunas extensiones para la seguridad, faltan muchas funciones y a veces es necesario escribir algo. Por ejemplo, las políticas de contraseñas: en PostgreSQL hay muchas extensiones diferentes., , , , ), que implementan políticas de contraseña, pero a mi parecer, ninguna cubre todas las necesidades del segmento corporativo nacional.
¿Qué hacer si no hay nada de lo que se necesita?? Например, хочется использовать определенную СУБД, в которой нет функций, которые требует заказчик.
Entonces se pueden utilizar soluciones de terceros que funcionan con diferentes SGBD, como ‘Crypto DB’ o ‘Garda DB’. En cuanto a las soluciones del segmento nacional, allí conocen mejor las normas GOST que en el open source.
La segunda opción es escribir por cuenta propia lo que se necesita, implementar a nivel de procedimientos el acceso a los datos y la encriptación en la aplicación. Sin embargo, con el GOST será más complicado. Pero en general, se puede ocultar los datos como se necesita, almacenarlos en el SGBD y luego extraerlos y desencriptarlos correctamente, directamente a nivel de la aplicación. Al mismo tiempo, piensen en cómo van a proteger estos algoritmos a nivel de la aplicación. En nuestra opinión, esto debe hacerse a nivel de SGBD, ya que así funcionará más rápido.
Esta presentación se pronunció por primera vez en por Mail.ru Cloud Solutions. Veaotras presentaciones y suscríbase a los anuncios de eventos en Telegram .
Lecturas adicionales sobre el tema:
- .
- .
Fuente: habr.com
