

Preludio
Este artículo se dedica a los árboles binarios de búsqueda. Recientemente escribí un artículo sobre En ese momento no presté mucha atención a los árboles binarios, ya que los métodos de búsqueda, inserción y eliminación no eran relevantes. Ahora decidí escribir un artículo específicamente sobre los árboles. Comencemos.
Un árbol es una estructura de datos compuesta por nodos conectados por aristas. Se puede decir que un árbol es un caso particular de un grafo. Aquí hay un ejemplo de un árbol:
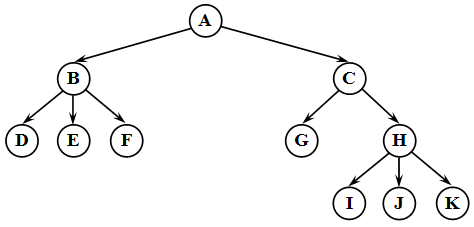
¡Este no es un árbol binario de búsqueda! ¡Todo lo demás debajo!
Terminología
Raíz
La raíz del árbol es su nodo más alto. En el ejemplo, este es el nodo A. Desde la raíz a cualquier otro nodo solo puede haber un camino. De hecho, cualquier nodo se puede considerar como la raíz de su respectivo subárbol.
Padres/hijos
Todos los nodos, excepto la raíz, tienen exactamente una arista que sube hacia otro nodo. El nodo ubicado por encima del actual se llama padre de este nodo. El nodo que se encuentra debajo del actual y conectado a él se llama hijo de este nodo. Vamos con un ejemplo. Tomemos el nodo B, entonces su padre será el nodo A, y sus hijos serán los nodos D, E y F.
Hoja
Un nodo que no tiene hijos se llamará hoja del árbol. En el ejemplo, las hojas son los nodos D, E, F, G, I, J, K.
Esta es la terminología básica. Otros conceptos se explicarán más adelante. Por lo tanto, un árbol binario es un árbol en el que cada nodo tendrá no más de dos hijos. Como habrán adivinado, el árbol del ejemplo no será binario, ya que los nodos B y H tienen más de dos hijos. Aquí hay un ejemplo de un árbol binario:
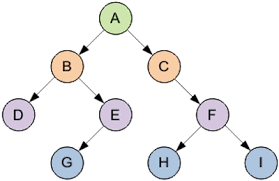
Los nodos del árbol pueden contener cualquier información. Un árbol binario de búsqueda es un árbol binario que presenta las siguientes propiedades:
- Ambos subárboles, el izquierdo y el derecho, son árboles binarios de búsqueda.
- Todos los nodos del subárbol izquierdo de un nodo X tienen valores de clave de datos que son menores que el valor de la clave de datos del propio nodo X.
- Todos los nodos del subárbol derecho de un nodo X tienen valores de clave de datos que son mayores o iguales al valor de la clave de datos del propio nodo X.
Clave es alguna característica del nodo (por ejemplo, un número). La clave es necesaria para poder encontrar el elemento del árbol correspondiente a esta clave. Ejemplo de árbol binario de búsqueda:
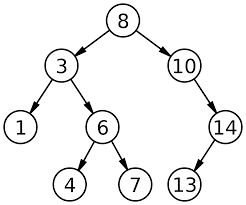
Introducción al árbol
A medida que avance, proporcionaré algunos (posiblemente incompletos) fragmentos de código para mejorar su comprensión. El código completo estará al final del artículo.
Un árbol consta de nodos. La estructura de un nodo:
public class Node<T> {
    private T data;
    private int key;
    private Node<T> leftChild;
    private Node<T> rightChild;

    public Node(T data, int key) {
        this.data = data;
        this.key = key;
    }
    public Node<T> getLeftChild() {
        return leftChild;
    }

    public Node<T> getRightChild() {
        return rightChild;
    }
//...otros métodos del nodo
}
Cada nodo tiene dos hijos (posiblemente, los hijos leftChild y/o rightChild pueden tener el valor nulo). Supongo que ya entendió que, en este caso, data es la información almacenada en el nodo; key es la clave del nodo.
Hemos entendido el nodo, ahora hablemos de los problemas actuales relacionados con los árboles. De aquí en adelante, al término 'árbol' me referiré al concepto de árbol binario de búsqueda. La estructura de un árbol binario:
public class BinaryTree<T> {
     private Node<T> root;

    //métodos del árbol
}
Como campo de clase, solo necesitaremos la raíz del árbol, porque desde la raíz, mediante los métodos getLeftChild() y getRightChild(), se puede llegar a cualquier nodo del árbol.
Algoritmos en el árbol
Búsqueda
Supongamos que tiene un árbol construido. ¿Cómo encontrar el elemento con la clave key? Debe moverse secuencialmente desde la raíz hacia abajo por el árbol y comparar el valor key con la clave del nodo actual: si key es menor que la clave del nodo actual, debe pasar al hijo izquierdo del nodo; si es mayor, al derecho; si las claves son iguales, ¡el nodo buscado ha sido encontrado! El código correspondiente es:
public Node<T> find(int key) {
    Node<T> current = root;
    while (current.getKey() != key) {
        if (key < current.getKey())
            current = current.getLeftChild();
        else
            current = current.getRightChild();
        if (current == null)
            return null;
    }
    return current;
}
Si current se convierte en nulo, significa que se ha llegado al final del árbol (en un nivel conceptual, se encuentra en un lugar inexistente del árbol: el hijo de una hoja).
Consideremos la eficiencia del algoritmo de búsqueda en un árbol balanceado (un árbol en el que los nodos están distribuidos más o menos uniformemente). Entonces, la eficiencia de la búsqueda será O(log(n)), siendo el logaritmo de base 2. Observe: si hay n elementos en un árbol balanceado, significa que habrá log(n) niveles en el árbol. Y en la búsqueda, en un paso del ciclo, usted baja un nivel.
Inserción
Si entendiste la esencia de la búsqueda, no te será difícil comprender la inserción. Solo necesitas bajar hasta el nodo hoja (según las reglas de descenso descritas en la búsqueda) y convertirte en su descendiente: izquierdo o derecho, dependiendo de la clave. Implementación:
   public void insert(T insertData, int key) {
        Node current = root;
        Node parent;
        Node newNode = new Node(insertData, key);
        if (root == null)
            root = newNode;
        else {
            while (true) {
                parent = current;
                if (key < current.getKey()) {
                    current = current.getLeftChild();
                    if (current == null) {
                         parent.setLeftChild(newNode);
                         return;
                    }
                }
                else {
                    current = current.getRightChild();
                    if (current == null) {
                        parent.setRightChild(newNode);
                        return;
                    }
                }
            }
        }
    }
En este caso, además del nodo actual, debemos almacenar información sobre el padre del nodo actual. Cuando current se convierta en null, la variable parent tendrá el nodo hoja que necesitamos.
La eficiencia de la inserción, obviamente, será la misma que la de la búsqueda: O(log(n)).
Eliminación
La eliminación es la operación más compleja que se debe realizar con el árbol. Es evidente que primero debemos encontrar el elemento que vamos a eliminar. Pero, ¿qué hacemos después? Si simplemente asignamos el valor null a su referencia, perderemos información sobre el subárbol cuyo raíz es este nodo. Los métodos de eliminación del árbol se dividen en tres casos.
Primer caso. El nodo eliminado no tiene descendientes
Si el nodo eliminado no tiene descendientes, significa que es una hoja. Por lo tanto, se puede asignar el valor null a los campos leftChild o rightChild de su padre.
Segundo caso. El nodo eliminado tiene un descendiente
Este caso tampoco es muy complicado. Volvamos a nuestro ejemplo. Supongamos que necesitamos eliminar el elemento con la clave 14. Acepten que, como es el descendiente derecho del nodo con la clave 10, cualquier descendiente suyo (en este caso, derecho) tendrá una clave mayor que 10, por lo que se puede "cortar" fácilmente del árbol y conectar directamente al padre con el descendiente del nodo eliminado, es decir, conectar el nodo con la clave 10 con el nodo 13. La situación sería similar si tuviésemos que eliminar un nodo que es el descendiente izquierdo de su padre. Piensa en esto tú mismo: es una analogía precisa.
Tercer caso. El nodo tiene dos descendientes
El caso más complicado. Analicemos un nuevo ejemplo.
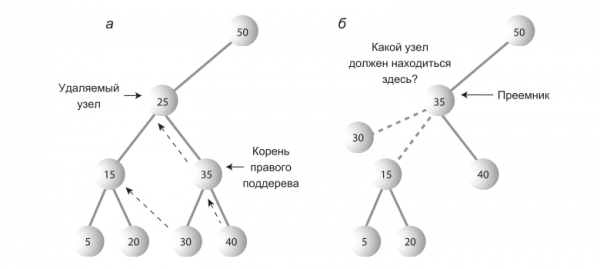
Búsqueda del sucesor
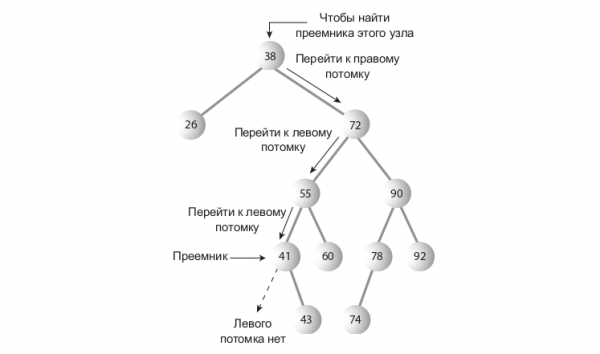
Supongamos que necesitamos eliminar el nodo con la clave 25. ¿A quién pondremos en su lugar? Alguien de sus seguidores (descendientes o descendientes de descendientes) debe convertirse en el sucesor(quien ocupe el lugar del nodo eliminado).
¿Cómo entender quién debe convertirse en sucesor? Es intuitivamente claro que este nodo en el árbol es aquel cuya clave es la siguiente más grande que la del nodo eliminado. El algoritmo consiste en lo siguiente. Debemos ir a su descendiente derecho (siempre al derecho, ya que ya se ha dicho que la clave del sucesor es mayor que la clave del nodo eliminado), y luego recorrer la cadena de descendientes izquierdos de ese descendiente derecho. En el ejemplo, debemos ir al nodo con la clave 35 y luego bajar por la cadena de descendientes izquierdos hasta llegar a la hoja; en este caso, esta cadena consiste solo en el nodo con la clave 30. Estrictamente hablando, estamos buscando el nodo más pequeño en el conjunto de nodos que son más grandes que el nodo buscado.
Código del método de búsqueda del sucesor:
    public Node<T> getSuccessor(Node<T> deleteNode) {
        Node<T> parentSuccessor = deleteNode; // padre del sucesor
        Node<T> successor = deleteNode; // sucesor
        Node<T> current = successor.getRightChild(); // nodo "travesía"
        while (current != null) {
            parentSuccessor = successor;
            successor = current;
            current = current.getLeftChild();
        }
        // al salir del ciclo tenemos al sucesor y al padre del sucesor
        if (successor != deleteNode.getRightChild()) { // si el sucesor no coincide con el hijo derecho del nodo eliminado
            parentSuccessor.setLeftChild(successor.getRightChild()); // entonces su padre toma el hijo del sucesor para no perderlo
            successor.setRightChild(deleteNode.getRightChild()); // enlazamos el sucesor con el hijo derecho del nodo eliminado
        }
        return successor;
    }
Código completo del método delete:
public boolean delete(int deleteKey) {
        Node current = root;
        Node parent = current;
        boolean isLeftChild = false; // Dependiendo de si el nodo a eliminar es un hijo izquierdo o derecho de su padre, la variable booleana isLeftChild tomará el valor true o false respectivamente.
        while (current.getKey() != deleteKey) {
            parent = current;
            if (deleteKey < current.getKey()) {
                current = current.getLeftChild();
                isLeftChild = true;
            } else {
                isLeftChild = false;
                current = current.getRightChild();
            }
            if (current == null)
                return false;
        }

        if (current.getLeftChild() == null && current.getRightChild() == null) { // Primer caso
            if (current == root)
                current = null;
            else if (isLeftChild)
                parent.setLeftChild(null);
            else
                parent.setRightChild(null);
        }
        else if (current.getRightChild() == null) { // Segundo caso
            if (current == root)
                root = current.getLeftChild();
            else if (isLeftChild)
                parent.setLeftChild(current.getLeftChild());
            else
                current.setRightChild(current.getLeftChild());
        } else if (current.getLeftChild() == null) {
            if (current == root)
                root = current.getRightChild();
            else if (isLeftChild)
                parent.setLeftChild(current.getRightChild());
            else
                parent.setRightChild(current.getRightChild());
        }
        else { // Tercer caso
            Node successor = getSuccessor(current);
            if (current == root)
                root = successor;
            else if (isLeftChild)
                parent.setLeftChild(successor);
            else
                parent.setRightChild(successor);
        }
        return true;
    }
La complejidad puede ser aproximada a O(log(n)).
Búsqueda de máximo/mínimo en el árbol
Obviamente, para encontrar el valor mínimo/máximo en el árbol, se debe ir recorriendo de manera secuencial la cadena de elementos izquierdos/derechos del árbol respectivamente; cuando llegues a una hoja, será el elemento mínimo/máximo.
    public Node getMinimum(Node startPoint) {
        Node current = startPoint;
        Node parent = current;
        while (current != null) {
            parent = current;
            current = current.getLeftChild();
        }
        return parent;
    }

    public Node getMaximum(Node startPoint) {
        Node current = startPoint;
        Node parent = current;
        while (current != null) {
            parent = current;
            current = current.getRightChild();
        }
        return parent;
    }
La complejidad es O(log(n))
Recorrido simétrico
El recorrido es visitar cada nodo del árbol con el objetivo de realizar alguna acción con él.
Algoritmo del recorrido simétrico recursivo:
- Realizar una acción con el hijo izquierdo
- Realizar una acción consigo mismo
- Realizar una acción con el hijo derecho
Código:
    public void inOrder(Node current) {
        if (current != null) {
            inOrder(current.getLeftChild());
            System.out.println(current.getData() + " ");//Aquí puede haber cualquier cosa
            inOrder(current.getRightChild());
        }
    }
Conclusión
¡Por fin! Si he dejado algo sin explicar o hay algún comentario, espero sus opiniones. Como prometí, aquí está el código completo.
Node.java:
public class Node {
    private T data;
    private int key;
    private Node leftChild;
    private Node rightChild;

    public Node(T data, int key) {
        this.data = data;
        this.key = key;
    }

    public void setLeftChild(Node newNode) {
        leftChild = newNode;
    }

    public void setRightChild(Node newNode) {
        rightChild = newNode;
    }

    public Node getLeftChild() {
        return leftChild;
    }

    public Node getRightChild() {
        return rightChild;
    }

    public T getData() {
        return data;
    }

    public int getKey() {
        return key;
    }
}
BinaryTree.java:
public class BinaryTree<T> {
    private Node<T> root;

    public Node<T> find(int key) {
        Node<T> current = root;
        while (current.getKey() != key) {
            if (key < current.getKey())
                current = current.getLeftChild();
            else
                current = current.getRightChild();
            if (current == null)
                return null;
        }
        return current;
    }

    public void insert(T insertData, int key) {
        Node<T> current = root;
        Node<T> parent;
        Node<T> newNode = new Node<>(insertData, key);
        if (root == null)
            root = newNode;
        else {
            while (true) {
                parent = current;
                if (key < current.getKey()) {
                    current = current.getLeftChild();
                    if (current == null) {
                         parent.setLeftChild(newNode);
                         return;
                    }
                }
                else {
                    current = current.getRightChild();
                    if (current == null) {
                        parent.setRightChild(newNode);
                        return;
                    }
                }
            }
        }
    }

    public Node<T> getMinimum(Node<T> startPoint) {
        Node<T> current = startPoint;
        Node<T> parent = current;
        while (current != null) {
            parent = current;
            current = current.getLeftChild();
        }
        return parent;
    }

    public Node<T> getMaximum(Node<T> startPoint) {
        Node<T> current = startPoint;
        Node<T> parent = current;
        while (current != null) {
            parent = current;
            current = current.getRightChild();
        }
        return parent;
    }

    public Node<T> getSuccessor(Node<T> deleteNode) {
        Node<T> parentSuccessor = deleteNode;
        Node<T> successor = deleteNode;
        Node<T> current = successor.getRightChild();
        while (current != null) {
            parentSuccessor = successor;
            successor = current;
            current = current.getLeftChild();
        }

        if (successor != deleteNode.getRightChild()) {
            parentSuccessor.setLeftChild(successor.getRightChild());
            successor.setRightChild(deleteNode.getRightChild());
        }
        return successor;
    }

    public boolean delete(int deleteKey) {
        Node<T> current = root;
        Node<T> parent = current;
        boolean isLeftChild = false;
        while (current.getKey() != deleteKey) {
            parent = current;
            if (deleteKey < current.getKey()) {
                current = current.getLeftChild();
                isLeftChild = true;
            } else {
                isLeftChild = false;
                current = current.getRightChild();
            }
            if (current == null)
                return false;
        }

        if (current.getLeftChild() == null && current.getRightChild() == null) {
            if (current == root)
                current = null;
            else if (isLeftChild)
                parent.setLeftChild(null);
            else
                parent.setRightChild(null);
        }
        else if (current.getRightChild() == null) {
            if (current == root)
                root = current.getLeftChild();
            else if (isLeftChild)
                parent.setLeftChild(current.getLeftChild());
            else
                current.setRightChild(current.getLeftChild());
        } else if (current.getLeftChild() == null) {
            if (current == root)
                root = current.getRightChild();
            else if (isLeftChild)
                parent.setLeftChild(current.getRightChild());
            else
                parent.setRightChild(current.getRightChild());
        }
        else {
            Node<T> successor = getSuccessor(current);
            if (current == root)
                root = successor;
            else if (isLeftChild)
                parent.setLeftChild(successor);
            else
                parent.setRightChild(successor);
        }
        return true;
    }

    public void inOrder(Node<T> current) {
        if (current != null) {
            inOrder(current.getLeftChild());
            System.out.println(current.getData() + " ");
            inOrder(current.getRightChild());
        }
    }
}
P.D.
Degeneración a O(n)
Muchos de ustedes habrán notado: ¿y si hacemos que el árbol se vuelva desequilibrado? Por ejemplo, si insertamos nodos en el árbol con claves crecientes: 1,2,3,4,5,6… Entonces el árbol se parecerá a una lista enlazada. Y sí, el árbol perderá su estructura jerárquica, y por lo tanto, la eficiencia en el acceso a los datos. La complejidad de las operaciones de búsqueda, inserción y eliminación será la misma que en una lista enlazada: O(n). Este es uno de los más importantes, en mi opinión, desventajas de los árboles binarios.
Solo los usuarios registrados pueden participar en la encuesta. , por favor.
No hace mucho que estoy en Habr, y me gustaría saber qué temas les gustaría ver más en los artículos.
Estructuras de datos
Algoritmos (DP, recursión, compresión de datos, etc.)
Aplicación de estructuras de datos y algoritmos en la vida real
Programación de aplicaciones Android en Java
Programación de aplicaciones web en Java
Votaron 2 usuarios. Se abstuvo 1 usuario.
Fuente: habr.com
