

En otoño de 2019, en el equipo de iOS de Mail.ru Cloud, ocurrió un evento muy esperado. La base de datos principal para el almacenamiento persistente del estado de la aplicación se convirtió en algo bastante exótico para el mundo móvil. (LMDB). A continuación, les ofrecemos una revisión detallada en cuatro partes. Primero, hablaremos sobre las razones de tal elección inusual y difícil. Luego, pasaremos a discutir los tres pilares de la arquitectura de LMDB: archivos mapeados en memoria, árbol B+-y el enfoque de copia sobre escritura para implementar la transaccionalidad y la multiversión. Finalmente, en la parte práctica, veremos cómo diseñar e implementar un esquema de base de datos sobre la API key-value de bajo nivel, incluyendo tablas de índice.
Contenido
3.1.
3.2.
3.3.
4.1.
4.2.
4.3.
1. Motivación para la implementación
Una vez, alrededor de 2015, nos preocupamos por medir con qué frecuencia la interfaz de nuestra aplicación se ralentizaba. No lo hicimos sin motivo. Recibimos más quejas sobre el hecho de que a veces la aplicación dejaba de responder a las acciones del usuario: los botones no se presionaban, las listas no se desplazaban, etc. Sobre la mecánica de las mediciones, ya en AvitoTech, por lo que aquí solo menciono los números.
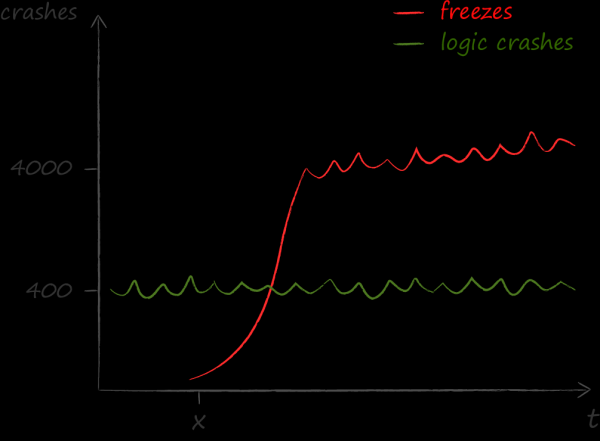
Los resultados de las mediciones fueron un balde de agua fría para nosotros. Resultó que había muchos más problemas causados por bloqueos que por cualquier otro. Si antes de este hecho, el principal indicador técnico de calidad era la ausencia de fallos, después el enfoque hacia la ausencia de bloqueos.
Al construir y realizar y de sus causas, se hizo evidente el principal enemigo: la pesada lógica empresarial que se ejecuta en el hilo principal de la aplicación. La reacción natural a este desorden fue un ardiente deseo de distribuirla entre hilos de trabajo. Para resolver sistemáticamente esta tarea, recurrimos a una arquitectura multihilo basada en actores ligeros. Dedique en el twitter colectivo y . En el contexto de la narrativa actual, quiero resaltar aquellos aspectos de la solución que influenciaron la elección de la base de datos.
El modelo actor de organización del sistema implica que la concurrencia se convierte en su segunda esencia. Los objetos del modelo tienden a cruzar las fronteras de los hilos. Y lo hacen no solo en ocasiones y en ciertos lugares, sino prácticamente de manera constante y en todas partes.
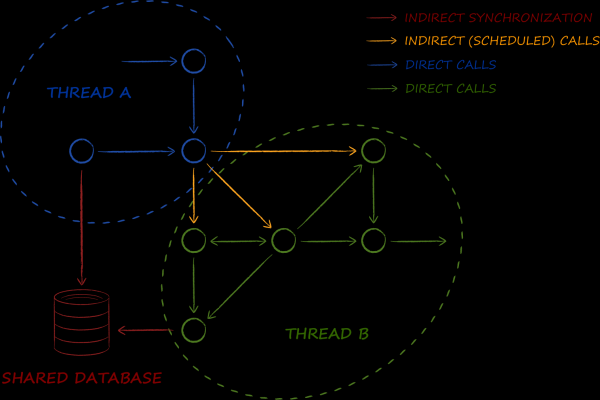
La base de datos es uno de los componentes fundamentales en el esquema presentado. Su tarea principal es implementar el macropatrón. . Si en el mundo empresarial se utiliza para organizar la sincronización de datos entre servicios, en el caso de la arquitectura actor, se trata de los datos entre hilos. Por lo tanto, necesitábamos una base de datos cuya manipulación en un entorno de múltiples hilos no genere siquiera dificultades mínimas. En particular, esto significa que los objetos obtenidos de ella deben ser al menos seguros para hilos, y en ideal, completamente inmutables. Como se sabe, estos últimos pueden ser utilizados simultáneamente por varios hilos, sin necesidad de bloqueos, lo que beneficia al rendimiento.
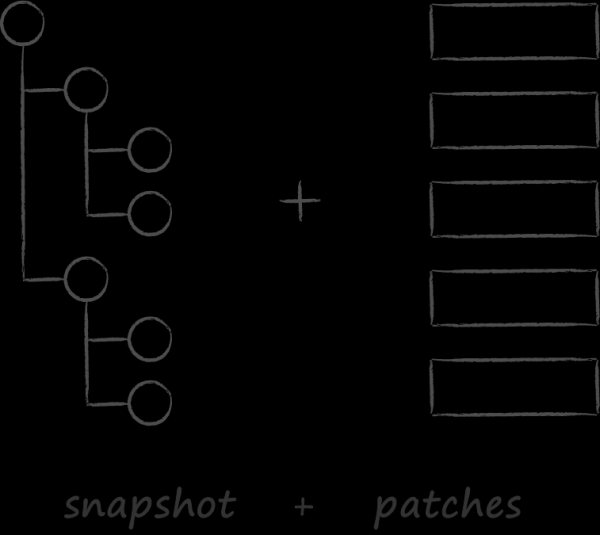 El segundo factor significativo que influyó en la elección de la base de datos fue nuestra API en la nube. Se inspiró en el enfoque de sincronización adoptado en git. Al igual que él, apuntábamos a , lo cual resulta más que apropiado para los clientes en la nube. Se supuso que solo descargarían una vez el estado completo de la nube, y luego la sincronización se llevaría a cabo en la mayoría de los casos mediante la aplicación de cambios. Lamentablemente, esta funcionalidad aún se encuentra solo en la zona teórica, y en la práctica, los clientes no han aprendido a trabajar con parches. Hay varias razones objetivas para esto, que, para no extender la introducción, dejaremos de lado. Ahora, hay un interés mucho mayor en las conclusiones instructivas de la lección sobre lo que sucede cuando la API dice «A», y su consumidor no dice «B».
Así que, si imaginas git, que al ejecutar el comando pull en lugar de aplicar parches a una instantánea local compara su estado completo con el estado completo del servidor, tendrás una idea bastante precisa de cómo se realiza la sincronización en los clientes de la nube. No es difícil adivinar que para lograr esto es necesario asignar en memoria dos árboles DOM con metainformación sobre todos los archivos del servidor y locales. Esto significa que si un usuario almacena 500 mil archivos en la nube, para su sincronización es necesario recrear y destruir dos árboles con 1 millón de nodos. Y cada nodo es un agregado que contiene un gráfico de subobjetos. En este sentido, los resultados de la profilación fueron esperados. Se descubrió que incluso sin contar la algorítmica de fusión, el propio procedimiento de creación y posterior destrucción de una gran cantidad de pequeños objetos ya tiene un costo considerable. La situación se agrava por el hecho de que la operación básica de sincronización está incluida en una gran cantidad de escenarios de usuario. Como resultado, fijamos el segundo criterio importante en la elección de la base de datos: la posibilidad de realizar operaciones CRUD sin asignación dinámica de objetos.
Otros requisitos son más tradicionales y su lista completa es la siguiente.
- Seguridad de hilos.
- Multiprocesamiento. Dictado por el deseo de utilizar la misma instancia de base de datos para sincronizar el estado no solo entre hilos, sino también entre la aplicación principal y las extensiones de iOS.
- La posibilidad de representar las entidades almacenadas como objetos inmutables.
- La ausencia de asignaciones dinámicas en las operaciones CRUD.
- Soporte transaccional de propiedades básicas : atomicidad, consistencia, aislamiento y durabilidad.
- Velocidad en los casos de uso más populares.
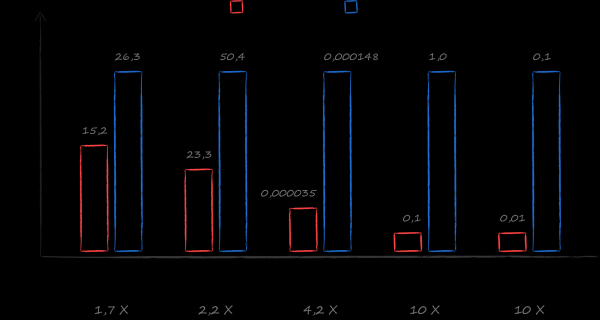
Una buena opción con este conjunto de requisitos fue y sigue siendo SQLite. Sin embargo, durante el estudio de alternativas, encontré un libro que me llamó la atención. . Bajo su dirección se elaboró un benchmark que compara la velocidad de trabajo con diferentes bases de datos en escenarios de nube reales. El resultado superó las expectativas más optimistas. En los casos más populares — el obtención de un cursor para una lista ordenada de todos los archivos y una lista ordenada de todos los archivos para un directorio dado — LMDB fue diez veces más rápido que SQLite. La elección se volvió evidente.
2. Posicionamiento de LMDB
LMDB es una pequeña biblioteca (solo 10K líneas) que implementa la capa fundamental de base de datos — el almacenamiento.
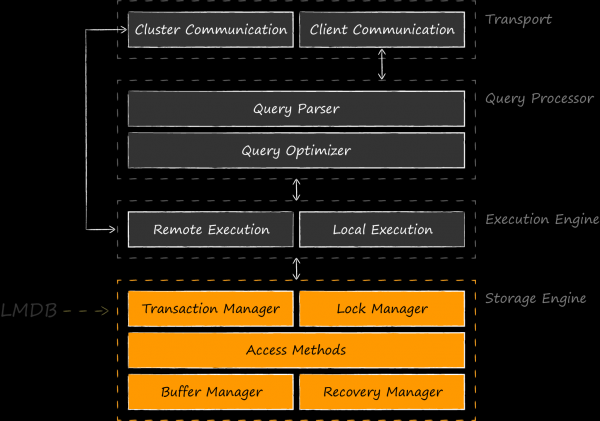
El esquema presentado muestra que comparar LMDB con SQLite, que también implementa niveles más altos, no es mucho más correcto que comparar SQLite con Core Data. Como competidores en igualdad de condiciones, sería más justo mencionar motores de almacenamiento similares — BerkeleyDB, LevelDB, Sophia, RocksDB, entre otros. Hay incluso desarrollos donde LMDB actúa como un componente del motor de almacenamiento para SQLite. El primero de estos experimentos fue realizado en 2012. el autor de LMDB . resultaron ser tan intrigantes que su emprendimiento fue adoptado por entusiastas de OSS, y encontró su continuación en . En enero de 2020, el autor de este proyecto, Den Shearer, en LinuxConfAu.
LMDB encuentra su principal aplicación como motor de bases de datos de aplicaciones. La biblioteca debe su existencia a los desarrolladores de , quienes estaban muy insatisfechos con BerkeleyDB como base para su proyecto. A partir de la modesta biblioteca , Howard Chu pudo crear una de las alternativas más populares en la actualidad. Esta historia, así como la estructura interna de LMDB, la dedicó en su increíble presentación . Un buen ejemplo de la conquista del almacenamiento fue compartido por Leonid Yuriev (aka ) de Positive Technologies en su charla en Highload 2015 . En ella, habla sobre LMDB en el contexto de una tarea similar de implementación de ReOpenLDAP, mientras que LevelDB fue objeto de crítica comparativa. Como resultado de la implementación, incluso surgió un fork en Positive Technologies que se está desarrollando activamente con características muy atractivas, optimizaciones y .
LMDB también se utiliza a menudo como un almacenamiento tal cual. Por ejemplo, el navegador Mozilla Firefox LMDB para una serie de necesidades, y, a partir de la versión 9, Xcode LMDB sobre SQLite para el almacenamiento de índices.
El motor ha aparecido en el mundo del desarrollo móvil. Se pueden rastrear sus usos en el cliente de iOS para Telegram. LinkedIn ha ido un paso más allá y eligió LMDB como la base de datos por defecto para su marco de caché de datos Rocket Data, lo que en su artículo de 2016.
LMDB está compitiendo exitosamente por un lugar bajo el sol en el nicho dejado por BerkeleyDB tras su transición al control de Oracle. Esta biblioteca es apreciada por su rapidez y fiabilidad incluso en comparación con similares. Como se sabe, no hay almuerzos gratis, y es importante subrayar el trade-off que se presentará al elegir entre LMDB y SQLite. El esquema anterior ilustra claramente cómo se consigue mayor velocidad. Primero, no pagamos por capas adicionales de abstracción sobre el almacenamiento en disco. Es evidente que en una buena arquitectura no se puede prescindir de ellas, y aparecerán inevitablemente en el código de la aplicación, pero serán mucho más delgadas. No contarán con características que no son necesarias para una aplicación específica, como el soporte para consultas en SQL. En segundo lugar, se da la oportunidad de implementar de manera óptima el mapeo de operaciones de aplicación a consultas a almacenamiento en disco. Si SQLite parte de las necesidades promedio de una aplicación promedio, usted, como desarrollador de aplicaciones, está bien informado sobre los principales escenarios de carga. Por una solución más eficiente, habrá que pagar un precio más alto tanto por el desarrollo de la solución inicial como por su posterior mantenimiento.
3. Los tres pilares de LMDB
Al observar LMDB desde una perspectiva elevada, ha llegado el momento de profundizar. Las siguientes tres secciones estarán dedicadas al análisis de los pilares fundamentales sobre los cuales se basa la arquitectura del almacenamiento:
- Archivos mapeados en memoria como mecanismo de trabajo con el disco y sincronización de estructuras internas de datos.
- Un árbol B+ como organización de la estructura de datos almacenados.
- Copy-on-write como enfoque para garantizar las propiedades ACID de las transacciones y la multiversionabilidad.
3.1. Pilar Nº1. Archivos mapeados en memoria
Los archivos mapeados en memoria son un elemento arquitectónico tan importante que incluso figuran en el nombre del almacén. Las cuestiones de caché y sincronización de acceso a la información almacenada están completamente delegadas al sistema operativo. LMDB no contiene cachés dentro de sí. Esta es una decisión consciente del autor, ya que leer datos directamente de los archivos mapeados permite simplificar significativamente la implementación del motor. A continuación, presento una lista no exhaustiva de algunos de ellos.
- Mantener la consistencia de los datos en el almacén al trabajar con él desde múltiples procesos se convierte en una responsabilidad del sistema operativo. En la siguiente sección, esta mecánica se examina con detalle y con imágenes.
- La ausencia de cachés libera completamente a LMDB de los costos relacionados con las asignaciones dinámicas. Leer datos, en la práctica, consiste en establecer un puntero en la dirección correcta en la memoria virtual y nada más. Suena como una fantasía, pero en el código fuente del almacén todas las llamadas a salloc están concentradas en la función de configuración del almacén.
- La falta de cachés también significa la ausencia de bloqueos relacionados con la sincronización de su acceso. Los lectores, que pueden existir en un número arbitrario al mismo tiempo, no encuentran un solo mutex en su camino hacia los datos. Esto hace que la velocidad de lectura tenga una escalabilidad lineal ideal en función del número de CPU. En LMDB, solo las operaciones que modifican están sujetas a sincronización. Solo puede haber un escritor en un momento dado.
- El mínimo de lógica de caché y sincronización libera al código de errores extremadamente complicados asociados con el trabajo en un entorno multihilo. En la conferencia Usenix OSDI 2014 hubo dos estudios interesantes sobre bases de datos: y . De ellos se puede extraer información tanto sobre la fiabilidad sin precedentes de LMDB como sobre la implementación prácticamente perfecta de las propiedades ACID en las transacciones, superando a este aspecto en SQLite.
- La minimalismo de LMDB permite que su representación de código se albergue completamente en la caché L1 del procesador, con las características de velocidad que eso conlleva.
Desafortunadamente, en iOS, los archivos mapeados en memoria no son tan perfectos como nos gustaría. Para hablar de sus desventajas de manera más consciente, es necesario recordar los principios generales de la implementación de este mecanismo en los sistemas operativos.
Información general sobre archivos mapeados en memoria
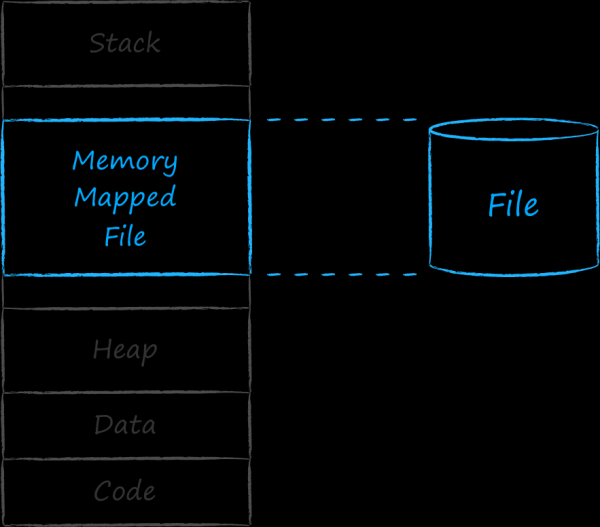 Cada aplicación ejecutable está asociada por el sistema operativo a una entidad llamada proceso. A cada proceso se le asigna un intervalo continuo de direcciones, donde coloca todo lo que necesita para funcionar. En las direcciones más bajas se encuentran las secciones con el código y los datos y recursos incorporados. Luego, hay un bloque creciente de espacio de direcciones dinámico, conocido como heap. En él se almacenan las direcciones de entidades que aparecen durante la ejecución del programa. En la parte superior se encuentra el área de memoria utilizada por la pila de la aplicación. Esta crece y se encoge, es decir, su tamaño también tiene una naturaleza dinámica. Para que la pila y el heap no se interfieran, están separados en los extremos opuestos del espacio de direcciones. Entre las dos secciones dinámicas, en la parte superior y en la inferior, hay un hueco. Las direcciones en esta sección intermedia son utilizadas por el sistema operativo para asociar diversas entidades al proceso. En particular, puede asociar un conjunto continuo de direcciones a un archivo en el disco. Este archivo se denomina mapeado en memoria.
El espacio de direcciones asignado a un proceso es enorme. Teóricamente, el número de direcciones está limitado solo por el tamaño del puntero, que se define por la arquitectura del sistema. Si este se asignara 1 a 1 a la memoria física, el primer proceso consumiría toda la RAM, y no podría hablarse de multitarea.
Sin embargo, por experiencia sabemos que los sistemas operativos modernos pueden ejecutar simultáneamente tantos procesos como se desee. Esto es posible porque, aunque solo en papel, asignan a los procesos un montón de memoria, en realidad cargan en la memoria física principal solo aquella parte que se demanda en el momento. Por lo tanto, la memoria asociada al proceso se llama virtual.
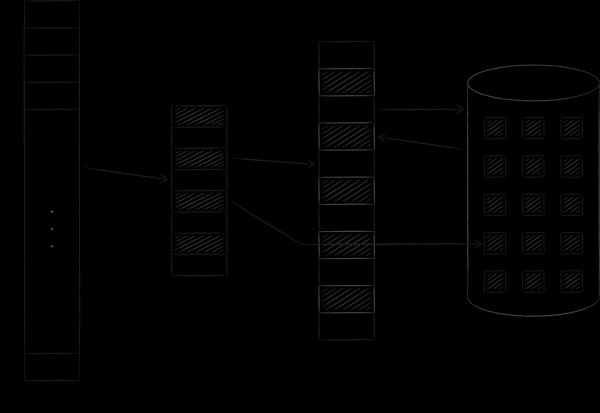
El sistema operativo organiza la memoria virtual y física en forma de páginas de un tamaño específico. Tan pronto como una página de memoria virtual se vuelve necesaria, el sistema operativo la carga en la memoria física y establece la correspondencia entre ellas en una tabla especial. Si no hay espacios libres, una de las páginas previamente cargadas se copia en el disco y la requerida ocupa su lugar. Este procedimiento, al que pronto volveremos, se llama intercambio (swapping). La imagen a continuación ilustra el proceso descrito. En ella, la página A con la dirección 0 fue cargada y ubicada en la página de la memoria principal con la dirección 4. Este hecho se refleja en la tabla de correspondencias en la celda número 0.
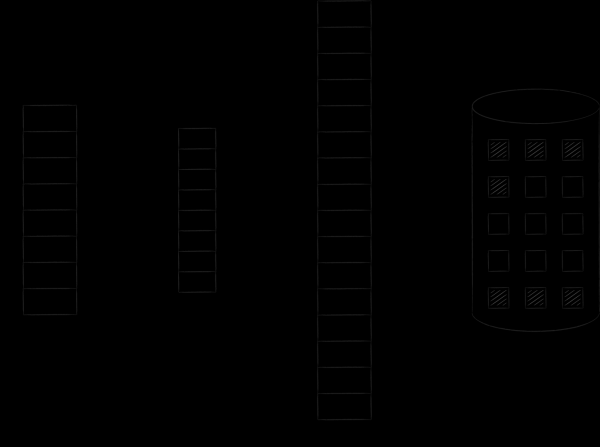
La historia con los archivos representados en memoria es exactamente la misma. Lógicamente, se colocan continua y completamente en un espacio de direcciones virtual. Sin embargo, en la memoria física llegan página por página y solo bajo demanda. La modificación de tales páginas se sincroniza con el archivo en el disco. De este modo, se puede realizar entrada/salida de archivos simplemente trabajando con bytes en memoria, y todos los cambios serán automáticamente transferidos al archivo original por el núcleo del sistema operativo.
La imagen a continuación demuestra cómo LMDB sincroniza su estado al trabajar con una base de datos desde diferentes procesos. Al mapear la memoria virtual de diferentes procesos en el mismo archivo, de facto estamos obligando al sistema operativo a sincronizar de forma transitiva entre ciertos bloques de sus espacios de direcciones, donde es lo que observa LMDB.
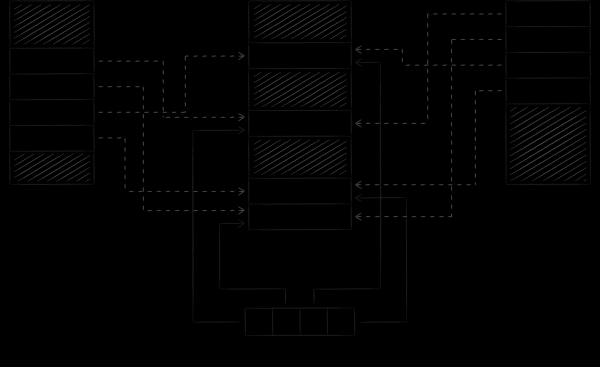
Un aspecto importante es que LMDB modifica el archivo de datos por defecto a través del mecanismo de llamada del sistema write, mientras que el mismo archivo se mapea en modo de solo lectura. Este enfoque tiene dos consecuencias importantes.
La primera consecuencia es común a todos los sistemas operativos. Su esencia radica en agregar protección contra la corrupción accidental de la base de datos por código incorrecto. Como se sabe, las instrucciones ejecutables de un proceso pueden acceder a datos desde cualquier lugar de su espacio de direcciones. Al mismo tiempo, como acabamos de recordar, mapear un archivo en modo de lectura-escritura significa que cualquier instrucción también puede modificarlo. Si esto se hace por error, intentando, por ejemplo, sobrescribir realmente un elemento de un array con un índice no existente, puede cambiar accidentalmente el archivo que está mapeado a esa dirección, lo que conducirá a la corrupción de la base de datos. Si el archivo está mapeado en modo de solo lectura, intentar modificar el espacio de direcciones correspondiente provocará un cierre anómalo del programa con la señal SIGSEGV, y el archivo permanecerá íntegro.
La segunda consecuencia es específica de iOS. Ni el autor ni ninguna otra fuente la mencionan explícitamente, pero sin ella LMDB no sería utilizable en este sistema operativo móvil. Su consideración se aborda en la siguiente sección.
Especificidad de los archivos mapeados en memoria en iOS
En 2018, en WWDC, hubo una magnífica presentación . En ella se explica que en iOS todas las páginas que están en la memoria física pertenecen a uno de tres tipos: dirty, compressed y clean.
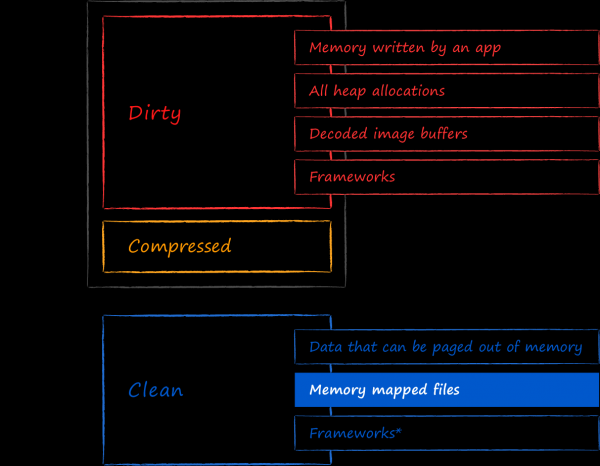
La memoria limpia (clean memory) es el conjunto de páginas que pueden ser eliminadas de la memoria física sin problemas. Los datos almacenados en ellas pueden ser recargados de sus fuentes originales cuando sea necesario. Los archivos mapeados en memoria de solo lectura caen exactamente en esta categoría. iOS no teme en ningún momento descargar las páginas mapeadas a archivos de la memoria, ya que están garantizadas para estar sincronizadas con el archivo en el disco.
En la memoria sucia (dirty memory) se clasifican todas las páginas modificadas, sin importar dónde estaban ubicadas originalmente. En particular, los archivos mapeados en memoria que han sido modificados mediante escritura en la memoria virtual asociada serán clasificados así. Al abrir LMDB con la bandera MDB_WRITEMAP, después de hacer cambios en esto se puede comprobar personalmente.
Cuando una aplicación comienza a ocupar demasiada memoria física, iOS comprime sus páginas sucias. La cantidad de memoria ocupada por las páginas sucias y comprimidas constituye lo que se llama la huella de memoria de la aplicación. Una vez que se alcanza un cierto umbral, el demonio del sistema OOM killer interviene y la cierra forzosamente. Esta es una característica de iOS en comparación con los sistemas operativos de escritorio. A diferencia de estos, la reducción de la huella de memoria mediante el intercambio de páginas de la memoria física al disco no se contempla en iOS. Las razones detrás de esto son solo especulaciones. Puede ser que el proceso intensivo de mover páginas al disco y de regreso consuma demasiada energía para dispositivos móviles, o que iOS ahorre recursos de reescritura de celdas en SSDs, o tal vez los diseñadores no estaban satisfechos con el rendimiento general del sistema, donde todo se intercambia constantemente. Sea como sea, el hecho sigue siendo un hecho.
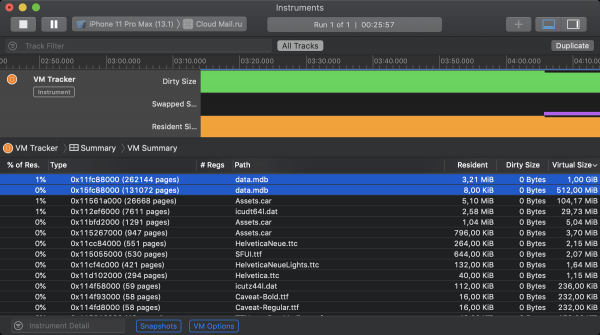
La buena noticia, como se mencionó anteriormente, es que LMDB no utiliza por defecto el mecanismo mmap para actualizar archivos. Esto significa que los datos mapeados son clasificados por iOS como memoria limpia y no contribuyen a la huella de memoria. Esto se puede comprobar utilizando la herramienta de Xcode llamada VM Tracker. En la captura de pantalla a continuación, se muestra el estado de la memoria virtual de la aplicación iOS de Nube durante su funcionamiento. Al inicio, se inicializaron 2 instancias de LMDB. A la primera se le permitió mapear su archivo en 1GiB de memoria virtual, mientras que a la segunda se le otorgaron 512MiB. A pesar de que ambos almacenes ocupan una cierta cantidad de memoria residente, ninguno contribuye al tamaño sucio.
Y ahora viene la mala noticia. Gracias al mecanismo de intercambio en sistemas operativos de escritorio de 64 bits, cada proceso puede ocupar tanto espacio de dirección virtual como el espacio libre en el disco duro lo permita para su posible intercambio. La sustitución del intercambio por la compresión en iOS reduce drásticamente el máximo teórico. Ahora todos los procesos activos deben caber en la memoria principal (es decir, la RAM), y aquellos que no pueden, serán cerrados de forma forzada. Esto se menciona en el texto mencionado anteriormente. , así como en Como resultado, iOS limita estrictamente el tamaño de memoria disponible para la asignación a través de mmap. Aquí está Se pueden observar los límites empíricos de los volúmenes de memoria que se han logrado asignar en diferentes dispositivos mediante esta llamada al sistema. En los modelos más modernos de smartphones, iOS ha asignado hasta 2 gigabytes, mientras que las versiones más avanzadas del iPad han alcanzado los 4. En la práctica, por supuesto, es necesario orientarse hacia los modelos más básicos compatibles, donde la situación es bastante desalentadora. Peor aún, al observar el estado de la memoria de la aplicación en VM Tracker, se puede descubrir que LMDB no es la única que compite por la memoria mapeada. Buenas porciones son devoradas por los alocadores del sistema, archivos de recursos, frameworks para trabajar con imágenes y otros depredadores menores.
Tras los experimentos en la Nube, hemos llegado a los siguientes valores de compromiso para la memoria asignada de LMDB: 384 megabytes para dispositivos de 32 bits y 768 para dispositivos de 64 bits. Después de consumir este volumen, cualquier operación que modifique comenzará a finalizar con el código MDB_MAP_FULL. Estos errores los hemos observado en nuestro monitoreo, pero son lo suficientemente escasos como para que en esta etapa se pueda hacer caso omiso de ellos.
Una razón no evidente del consumo excesivo de memoria por parte del almacenamiento pueden ser las transacciones de larga duración. Para entender cómo se relacionan estos dos fenómenos, nos ayudará considerar los otros dos pilares de LMDB.
3.2. Pilar №2. B+-árbol
Para emular tablas sobre un almacenamiento de clave-valor, es necesario que su API incluya las siguientes operaciones:
- Inserción de un nuevo elemento.
- Búsqueda de un elemento con la clave dada.
- Eliminación de un elemento.
- Iteración sobre intervalos de claves en orden de clasificación.
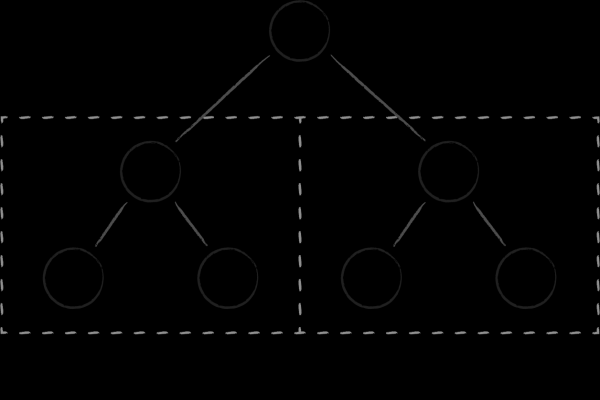 La estructura de datos más simple, mediante la cual se pueden implementar fácilmente las cuatro operaciones, es el árbol de búsqueda binaria. Cada nodo representa una clave, dividiendo todo el subconjunto de claves hijas en dos subárboles. En el izquierdo se agrupan las que son menores que la clave del padre, y en el derecho las que son mayores. Obtener un conjunto ordenado de claves se logra mediante uno de los recorridos clásicos del árbol.
Los árboles binarios tienen dos desventajas fundamentales que les impiden ser eficientes como estructuras de datos en disco. En primer lugar, su grado de equilibrio es impredecible. Existe un riesgo considerable de obtener árboles en los que la altura de las diferentes ramas puede diferir mucho, lo que empeora significativamente la complejidad algorítmica de búsqueda en comparación con lo esperado. En segundo lugar, la abundancia de enlaces cruzados entre nodos priva a los árboles binarios de la localidad en memoria. Los nodos cercanos (en términos de sus conexiones) pueden estar en páginas completamente diferentes en la memoria virtual. Como resultado, incluso para una simple exploración de varios nodos cercanos en el árbol, puede ser necesario visitar una cantidad comparable de páginas. Esto es un problema incluso cuando consideramos la eficiencia de los árboles binarios como estructuras de datos en memoria, ya que la rotación constante de páginas en la caché del procesador es un lujo costoso. Cuando se trata de cargar frecuentemente páginas relacionadas con nodos desde el disco, la situación se vuelve aún más .
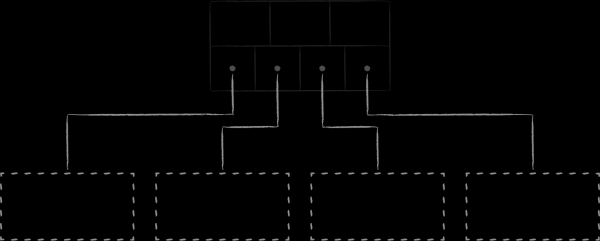 Los árboles B, al ser una evolución de los árboles binarios, resuelven los problemas mencionados en el párrafo anterior. En primer lugar, son auto-balanceables. En segundo lugar, cada nodo divide el conjunto de claves hijas no en 2, sino en M subconjuntos ordenados, donde el número M puede ser bastante grande, del orden de cientos o incluso miles.
Gracias a esto:
- Cada nodo contiene una gran cantidad de claves ya ordenadas, y los árboles resultan ser muy bajos.
- El árbol adquiere la propiedad de localidad de colocación en memoria, ya que claves cercanas en valor naturalmente se disponen una al lado de la otra en el mismo nodo o en nodos adyacentes.
- Disminuye el número de nodos intermedios al descender por el árbol durante la operación de búsqueda.
- Se reduce el número de nodos objetivo leídos en las consultas de rango, ya que cada uno de ellos ya contiene una gran cantidad de claves ordenadas.
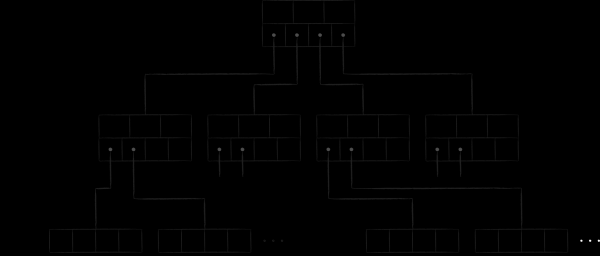
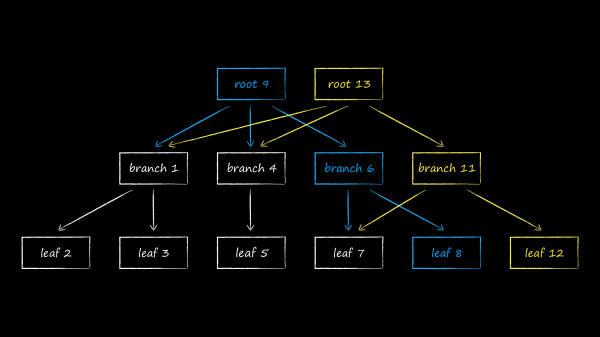
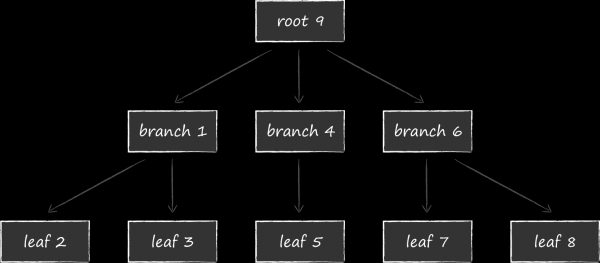
En LMDB, para el almacenamiento de datos se utiliza una de las variaciones del árbol B llamada árbol B+. En el esquema anterior se muestran los tres tipos de nodos que pueden existir en él:
- En la cima se encuentra la raíz (root). Esta materializa nada más que el concepto de base de datos dentro del almacenamiento. Dentro de una instancia de LMDB se pueden crear varias bases de datos que comparten un espacio de direcciones virtual mapeado. Cada una de ellas comienza con su propia raíz.
- En el nivel más bajo se encuentran las hojas (leaf). Estas son las únicas que contienen los pares clave-valor almacenados en la base de datos. A propósito, esta es la peculiaridad de los árboles B+. Mientras que un árbol B convencional almacena las partes de valor en nodos de todos los niveles, la variación B+ lo hace solo en el nivel más bajo. Reconociendo este hecho, a partir de ahora nos referiremos al subtipo de árbol utilizado en LMDB como simplemente un árbol B.
- Entre la raíz y las hojas se encuentran 0 o más niveles técnicos con nodos de navegación (branch). Su tarea es dividir el conjunto ordenado de claves entre las hojas.
Físicamente, los nodos son bloques de memoria de longitud predefinida. Su tamaño es múltiplo del tamaño de las páginas de memoria en el sistema operativo, del cual hemos hablado anteriormente. A continuación se muestra la estructura de un nodo. En el encabezado se encuentra la metainformación, siendo la más obvia para el ejemplo la suma de verificación. Luego vienen las informaciones sobre los desplazamientos donde se ubican las celdas de datos. Los datos pueden ser claves, si hablamos de nodos de navegación, o pares clave-valor completos en el caso de las hojas. Se puede leer más sobre la estructura de las páginas en el trabajo .
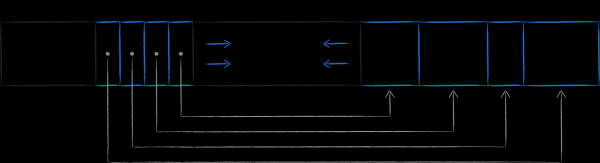
Una vez comprendido el contenido interno de los nodos-páginas, representaremos el árbol B de LMDB de manera simplificada en la siguiente forma.
Las páginas con nodos están dispuestas secuencialmente en el disco. Las páginas con un número mayor se encuentran más cerca del final del archivo. La llamada página meta (meta page) contiene información sobre los desplazamientos que permiten encontrar las raíces de todos los árboles. Al abrir un archivo, LMDB escanea el archivo página por página desde el final hacia el principio en busca de una página meta válida y, a través de ella, localiza las bases de datos existentes.
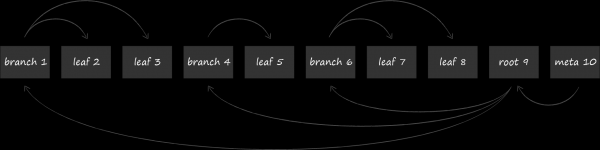
Ahora que tenemos una comprensión de la estructura lógica y física de la organización de datos, podemos pasar a considerar el tercer pilar de LMDB. Es a través de él que todas las modificaciones del almacenamiento se realizan de manera transaccional e independientemente unas de otras, otorgando a la base de datos en su conjunto la propiedad de la multiversión.
3.3. Pilar No. 3. Copy-on-write
Algunas operaciones con el árbol B implican realizar una serie completa de cambios en sus nodos. Un ejemplo de esto es agregar una nueva clave en un nodo que ya ha alcanzado su máxima capacidad. En este caso, es necesario, en primer lugar, dividir el nodo en dos, y en segundo lugar, agregar una referencia al nuevo nodo hijo desprendido en su padre. Este procedimiento es potencialmente muy peligroso. Si por alguna razón (un fallo, un corte de energía, etc.) solo se realizan algunos cambios de la serie, el árbol quedará en un estado inconsistente.
Una de las soluciones tradicionales para garantizar la resistencia a fallos de la base de datos es agregar junto al árbol B una estructura de datos en disco adicional: un registro de transacciones, conocido también como write-ahead log (WAL). Se trata de un archivo en el que se registra la operación prevista justo antes de modificar el propio árbol B. De esta manera, si durante la autodiagnosis se detecta corrupción de datos, la base de datos consulta el registro para restaurar su estado.
LMDB ha elegido un método diferente como mecanismo para asegurar la resistencia a fallos, que se llama copy-on-write. Su esencia radica en que, en lugar de actualizar los datos en la página existente, primero se copia completamente y todas las modificaciones se realizan ya en la copia.
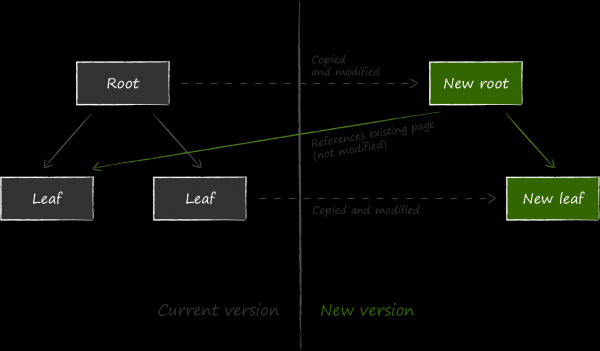
A continuación, para que los datos actualizados sean accesibles, es necesario cambiar la referencia al nodo que se ha vuelto relevante en su nodo padre. Dado que para ello también debe ser modificado, este también se copia previamente. El proceso continúa recursivamente hasta la raíz. Por último, se cambian los datos en la página de metadatos.
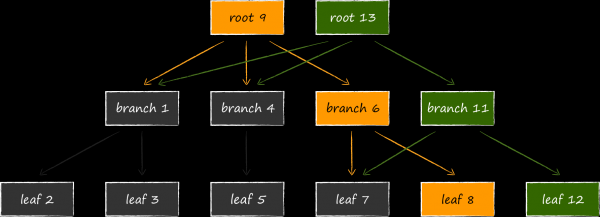
Si durante el proceso de actualización ocurre un cierre inesperado, es posible que no se cree una nueva meta-página o que no se registre en el disco por completo, y su suma de verificación será incorrecta. En cualquiera de estos dos casos, las nuevas páginas serán inalcanzables, mientras que las antiguas no se verán afectadas. Esto libera a LMDB de la necesidad de mantener un registro anticipado de escritura para garantizar la consistencia de los datos. La estructura de almacenamiento de datos en disco, descrita anteriormente, asume simultáneamente su función. La ausencia de un registro de transacciones de forma explícita es una de las características de LMDB que asegura una alta velocidad de lectura de datos.
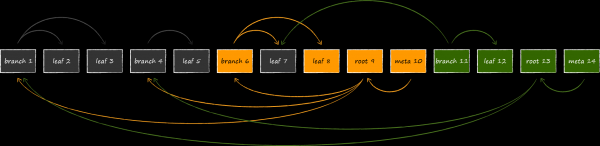
La estructura resultante llamada B-tree de solo anexado proporciona naturalmente la aislación de transacciones y la multi-versionidad. En LMDB, cada transacción abierta se asocia con la raíz del árbol que es actual en ese momento. Mientras la transacción no se haya completado, las páginas del árbol asociado nunca serán modificadas ni reutilizadas para nuevas versiones de datos. Así, se puede trabajar indefinidamente con el conjunto de datos que era vigente al momento de abrir la transacción, incluso si el almacenamiento se está actualizando activamente en ese momento. Esta es la esencia de la multi-versionidad que hace a LMDB una fuente de datos ideal para todos nosotros. UICollectionViewAl abrir una transacción, no es necesario aumentar el uso de memoria de la aplicación apresuradamente al volcar datos actuales en alguna estructura en memoria, por el temor de quedarse con las manos vacías. Esta característica diferencia favorablemente a LMDB de SQLite, que no puede presumir de tal aislación total. Al abrir en este último dos transacciones y eliminar algún registro en el marco de una de ellas, ese mismo registro ya no se podrá obtener en el marco de la segunda transacción restante.
El reverso de la moneda es un posible gasto significativamente mayor de memoria virtual. En la diapositiva se muestra cómo se verá la estructura de la base de datos si se modifica simultáneamente con 3 transacciones abiertas de lectura que observan diferentes versiones de la base de datos. Dado que LMDB no puede reutilizar nodos alcanzables desde las raíces asociadas con transacciones actuales, el almacenamiento no tiene más remedio que colocar en memoria otra cuarta raíz y clonar nuevamente las páginas modificables bajo ella.
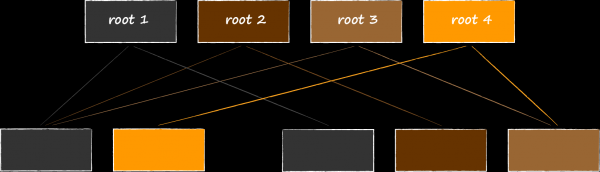
Aquí no está de más recordar la sección sobre archivos mapeados en memoria. Parece que el gasto adicional de memoria virtual no debería preocuparnos mucho, ya que no contribuye a la huella de memoria de la aplicación. Sin embargo, al mismo tiempo, se ha observado que iOS es muy reacia a asignarla, y no podemos, como en servidor o desktop, otorgar a LMDB una región de 1 terabyte sin pensar en esta característica. Siempre que sea posible, debemos intentar hacer la vida útil de las transacciones lo más corta posible.
4. Diseño del esquema de datos sobre la API de clave-valor
Comenzaremos el análisis de la API revisando las abstracciones básicas proporcionadas por LMDB: entorno y bases de datos, claves y valores, transacciones y cursores.
Nota sobre los listados de código
Todas las funciones en la API pública de LMDB devuelven el resultado de su trabajo en forma de código de error, pero en todos los listados subsecuentes, su verificación se ha omitido en favor de la concisión. En la práctica, usamos nuestro envoltorio de C++ , en el que los errores se materializan como excepciones de C++.
Como la forma más rápida de conectar LMDB a un proyecto para iOS o macOS, propongo mi CocoaPod .
4.1. Abstracciones básicas
Entorno (environment)
Estructura MDB_env es un contenedor del estado interno de LMDB. La familia de funciones con el prefijo mdb_env permite configurar algunas de sus propiedades. En el caso más simple, la inicialización del motor se ve de la siguiente manera.
mdb_env_create(env);
mdb_env_set_map_size(*env, 1024 * 1024 * 512)
mdb_env_open(*env, path.UTF8String, MDB_NOTLS, 0664);En la aplicación de Mail.ru Cloud, solo cambiamos los valores predeterminados de dos parámetros.
El primero de ellos es el tamaño del espacio de direcciones virtuales al que se asigna el archivo de almacenamiento. Desafortunadamente, incluso en el mismo dispositivo, un valor específico puede variar considerablemente de un lanzamiento a otro. Para tener en cuenta esta particularidad de iOS, el almacenamiento máximo se adapta dinámicamente. Comenzando con un valor determinado, se reduce a la mitad hasta que la función mdb_env_open devuelve un resultado diferente de ENOMEM. En teoría, existe un enfoque opuesto: primero asignar la cantidad mínima de memoria al motor y luego, al recibir errores MDB_MAP_FULL, incrementarla. Sin embargo, este camino es mucho más complicado. La razón es que el procedimiento de reasignación de memoria (remap) usando la función mdb_env_set_map_size invalida todas las entidades (cursos, transacciones, claves y valores) obtenidas del motor anteriormente. Tener en cuenta este giro de acontecimientos en el código complicará considerablemente su implementación. Si, no obstante, la memoria virtual es muy importante para usted, esto podría ser una razón para considerar un fork que ha avanzando mucho más allá , donde entre las características anunciadas se encuentra «ajuste automático del tamaño de la base de datos sobre la marcha».
El segundo parámetro, cuyo valor predeterminado no nos funcionó, regula la mecánica de garantía de seguridad en hilos. Desafortunadamente, al menos en iOS 10, hay problemas con el soporte de almacenamiento local en hilos. Por esta razón, en el ejemplo anterior, el almacenamiento se abre con la bandera MDB_NOTLS. Además, también fue necesario el envoltorio de C++ , para eliminar las variables con este atributo en él.
Bases de datos
La base de datos es una instancia separada de un árbol B, del que hemos hablado anteriormente. Su apertura ocurre dentro de una transacción, lo que al principio puede parecer un poco extraño.
MDB_txn *txn;
MDB_dbi dbi;
mdb_txn_begin(env, NULL, MDB_RDONLY, &txn);
mdb_dbi_open(txn, NULL, MDB_CREATE, &dbi);
mdb_txn_abort(txn);
De hecho, una transacción en LMDB es una entidad del almacenamiento, y no de una base de datos específica. Este concepto permite realizar operaciones atómicas sobre entidades que se encuentran en diferentes bases de datos. En teoría, esto abre la posibilidad de modelar tablas como diferentes bases, pero en su momento opté por un camino diferente, como se detalla a continuación.
Claves y valores
Estructura MDB_val modela el concepto de clave y valor. El almacenamiento no tiene idea de su semántica. Para él, lo que sea uno o lo otro es simplemente un arreglo de bytes de tamaño determinado. El tamaño máximo de la clave es de 512 bytes.
typedef struct MDB_val {
size_t mv_size;
void *mv_data;
} MDB_val;Con el comparador, el almacenamiento ordena las claves de manera ascendente. Si no se reemplaza por uno propio, se utilizará el predeterminado, que las clasifica byte por byte en orden léxico.
Transacciones
El mecanismo de transacciones se describe en , por lo que aquí repetiré brevemente sus propiedades principales:
- Soporte para todas las propiedades básicas : atomicidad, consistencia, aislamiento y durabilidad. No puedo dejar de mencionar que en cuanto a durabilidad, hay un bug en macOS e iOS que ha sido corregido en MDBX. Se puede leer más sobre esto en su .
- El enfoque para la multithreading se describe con el esquema «un escritor / múltiples lectores». Los escritores se bloquean entre sí, pero no bloquean a los lectores. Los lectores no bloquean ni a los escritores ni entre sí.
- Soporte para transacciones anidadas.
- Soporte para multi-versionado.
El multi-versionado en LMDB es tan bueno que quiero demostrarlo en acción. En el código a continuación se puede ver que cada transacción trabaja precisamente con la versión de la base de datos que era válida en el momento de su apertura, estando completamente aislada de todos los cambios posteriores. La inicialización del almacenamiento y la adición de un registro de prueba no representan nada interesante, por lo que estos rituales se han dejado bajo un spoiler.
Adición de un registro de prueba
MDB_env *env;
MDB_dbi dbi;
MDB_txn *txn;

mdb_env_create(&env);
mdb_env_open(env, ".\/testdb", MDB_NOTLS, 0664);

mdb_txn_begin(env, NULL, 0, &txn);
mdb_dbi_open(txn, NULL, 0, &dbi);
mdb_txn_abort(txn);

char k = 'k';
MDB_val key;
key.mv_size = sizeof(k);
key.mv_data = (void *)&k;

int v = 997;
MDB_val value;
value.mv_size = sizeof(v);
value.mv_data = (void *)&v;

mdb_txn_begin(env, NULL, 0, &txn);
mdb_put(txn, dbi, &key, &value, MDB_NOOVERWRITE);
mdb_txn_commit(txn);
MDB_txn *txn1, *txn2, *txn3;
MDB_val val;
// Abrimos 2 transacciones, cada una de las cuales observa
// la versión de la base de datos con un solo registro.
mdb_txn_begin(env, NULL, 0, &txn1); // lectura-escritura
mdb_txn_begin(env, NULL, MDB_RDONLY, &txn2); // solo lectura
// En el marco de la primera transacción, eliminamos el registro existente de la base de datos.
mdb_del(txn1, dbi, &key, NULL);
// Confirmamos la eliminación.
mdb_txn_commit(txn1);
// Abrimos la tercera transacción, que observa
// la versión actual de la base de datos, donde el registro ya no existe.
mdb_txn_begin(env, NULL, MDB_RDONLY, &txn3);
// Nos aseguramos de que el registro con la clave buscada ya no exista.
assert(mdb_get(txn3, dbi, &key, &val) == MDB_NOTFOUND);
// Finalizamos la transacción.
mdb_txn_abort(txn3);
// Nos aseguramos de que, en el marco de la segunda transacción, abierta en el momento
// de la existencia del registro en la base de datos, todavía se pueda encontrar por la clave.
assert(mdb_get(txn2, dbi, &key, &val) == MDB_SUCCESS);
// Verificamos que por la clave obtenemos no cualquier basura, sino datos válidos.
assert(*(int *)val.mv_data == 997);
// Finalizamos la transacción, que trabaja aunque con una base de datos obsoleta, pero consistente.
mdb_txn_abort(txn2);Opcionalmente, recomiendo intentar hacer el mismo truco con SQLite y ver qué resulta.
La multiversionalidad aporta ventajas muy agradables a la vida del desarrollador de iOS. Con esta propiedad, es posible regular de manera fácil y natural la velocidad de actualización de la fuente de datos para formularios en pantalla, basándose en consideraciones de experiencia de usuario. Por ejemplo, tomamos una función de la aplicación Nube de Mail.ru, como la carga automática de contenido desde la galería de medios del sistema. Con una buena conexión, el cliente puede añadir varias fotos al servidor por segundo. Si después de cada carga actualizamos UICollectionView el contenido multimedia en la nube del usuario, se puede olvidar de los 60 fps y el desplazamiento fluido durante este proceso. Para prevenir actualizaciones frecuentes de la pantalla, es necesario limitar la velocidad de cambio de datos en la base. UICollectionViewDataSource.
Si la base de datos no soporta la multiversionidad y solo permite trabajar con el estado actual, para crear un snapshot de datos estable en el tiempo es necesario realizar una copia en alguna estructura de datos en memoria o en una tabla temporal. Cualquiera de estos enfoques es muy costoso. En el caso de un almacenamiento en memoria, tenemos gastos tanto por la memoria utilizada para almacenar los objetos construidos como por el tiempo relacionado con las redundantes conversiones ORM. En cuanto a la tabla temporal, es un placer aún más costoso, que solo tiene sentido en casos no triviales.
La multiversionidad de LMDB aborda la tarea de mantener una fuente de datos estable de manera muy elegante. Basta con abrir una transacción y voilà: mientras no la finalicemos, el conjunto de datos está garantizado como fijo. La lógica de la velocidad de actualización ahora está completamente en manos de la capa de presentación, sin gastos generales significativos.
Cursores
Los cursores proporcionan un mecanismo para iterar ordenadamente sobre pares clave-valor mediante el recorrido de un árbol B. Sin ellos, sería imposible modelar tablas en la base de datos de manera eficiente, a las que ahora nos dirigimos.
4.2. Modelado de Tablas
La propiedad de ordenamiento de las claves permite construir encima de las abstracciones básicas una de alto nivel como una tabla. Examinemos este proceso tomando como ejemplo la tabla principal del cliente en la nube, que cachea la información sobre todos los archivos y carpetas del usuario.
Esquema de Tabla
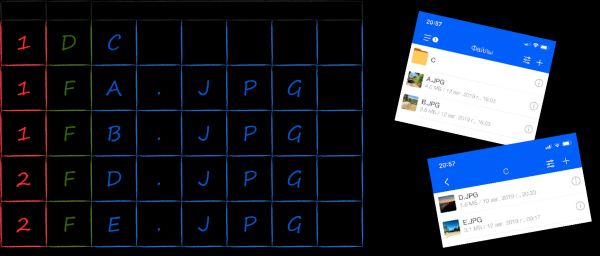
Uno de los escenarios frecuentes para los cuales debe estar diseñada la estructura de la tabla con un árbol de carpetas es la selección de todos los elementos ubicados dentro de un directorio dado. Un buen modelo de organización de datos para consultas eficaces de este tipo es . Para su implementación sobre un almacenamiento clave-valor, es necesario ordenar las claves de los archivos y carpetas de manera que se agrupen según la pertenencia al directorio padre. Además, para mostrar el contenido del directorio de una manera familiar para el usuario de Windows (primero carpetas, luego archivos, y ambos ordenados alfabéticamente), es necesario incluir campos adicionales en la clave.
En la imagen de abajo se muestra cómo, según la tarea planteada, podría verse la representación de las claves en forma de un array de bytes. Primero se colocan los bytes con el identificador del directorio padre (rojos), luego, los del tipo (verdes) y al final, los del nombre (azules). Al estar ordenados por el comparador por defecto de LMDB en orden lexicográfico, se organizan de la manera requerida. Un recorrido secuencial de las claves con el mismo prefijo rojo nos da los valores asociados en el orden en que deben aparecer en la interfaz de usuario (a la derecha), sin requerir ningún tipo de postprocesamiento adicional.
Serialización de claves y valores
En el mundo se han ideado numerosos métodos de serialización de objetos. Dado que no teníamos otro requisito que la velocidad, nosotros elegimos el más rápido de los disponibles: un volcado de la memoria ocupada por una instancia de la estructura del lenguaje C. Así, la clave de un elemento de directorio se puede modelar con la siguiente estructura NodeKey.
typedef struct NodeKey {
    EntityId parentId;
    uint8_t type;
    uint8_t nameBuffer[256];
} NodeKey;
Para guardar NodeKey en el almacenamiento, es necesario posicionar un puntero a los datos en la dirección del inicio de la estructura y calcular su tamaño con la función MDB_val sizeof MDB_val serialize(NodeKey * const key) { return MDB_val { .mv_size = sizeof(NodeKey), .mv_data = (void *)key }; }.
En el primer capítulo sobre los criterios de selección de bases de datos, mencioné que minimizar las asignaciones dinámicas es un factor importante. El código de la funciónserialize muestra cómo, en el caso de LMDB, se pueden evitar por completo al insertar nuevos registros en la base de datos. El array de bytes recibido del servidor se transforma primero en estructuras de pila, y luego se vuelcan trivialmente en el almacenamiento. Dado que dentro de LMDB tampoco hay asignaciones dinámicas, se puede obtener una situación fantástica en términos de iOS: ¡utilizar solo memoria de pila para trabajar con los datos en todo su recorrido, desde la red hasta el disco! Ordenamiento de claves por un comparador binario
Ordenación de claves con un comparador binario
La relación del orden de las claves se establece mediante una función especial llamada comparador. Como el motor no sabe nada sobre la semántica de los bytes que contiene, el comparador por defecto no tiene más opción que ordenar las claves en orden lexicográfico, utilizando su comparación byte a byte. Usarlo para ordenar estructuras es como afeitarse con un hacha de carne. Sin embargo, en casos simples, encuentro este método aceptable. La alternativa se describe más adelante, y aquí mencionaré un par de obstáculos en este camino.
Lo primero que hay que tener en cuenta es la representación en memoria de los tipos de datos primitivos. Así, en todos los dispositivos Apple, las variables enteras se almacenan en formato . Esto significa que el byte menos significativo estará a la izquierda, y ordenar números enteros utilizando su comparación byte a byte no será posible. Por ejemplo, intentar hacerlo con un conjunto de números del 0 al 511 dará como resultado lo siguiente.
// value (hex dump)
000 (0000)
256 (0001)
001 (0100)
257 (0101)
...
254 (fe00)
510 (fe01)
255 (ff00)
511 (ff01)
Para resolver este problema, los números enteros deben almacenarse en la clave en un formato adecuado para el comparador byte a byte. La conversión necesaria puede lograrse mediante funciones de la familia hton* (en particular, htons para los números de dos bytes del ejemplo).
El formato de representación de cadenas en programación es, como se sabe, una verdadera . Si la semántica de las cadenas así como la codificación utilizada para su representación en memoria sugiere que puede haber más de un byte por símbolo, entonces es mejor abandonar la idea de usar el comparador por defecto de inmediato.
Lo segundo que hay que tener en cuenta son los que realiza el compilador sobre los campos de la estructura. Debido a esto, puede haber bytes con valores basura en la memoria entre los campos, lo que, por supuesto, rompe la clasificación byte a byte. Para eliminar los residuos, es necesario declarar los campos en un orden estrictamente definido, teniendo en cuenta las reglas de alineación, o usar en la declaración de la estructura el atributo packed.
Ordenación de claves mediante un comparador externo
La lógica de comparación de claves puede resultar demasiado complicada para un comparador binario. Una de las muchas razones es la presencia de campos técnicos dentro de las estructuras. Ilustro su aparición con el ejemplo de la clave que ya conocemos de un elemento del directorio.
typedef struct NodeKey {
    EntityId parentId;
    uint8_t type;
    uint8_t nameBuffer[256];
} NodeKey;
A pesar de su simplicidad, en la gran mayoría de los casos consume demasiada memoria. El búfer para el nombre ocupa 256 bytes, aunque, en promedio, los nombres de archivos y carpetas rara vez superan los 20-30 caracteres.
Uno de los métodos estándar de optimización del tamaño de registro consiste en 'recortar' la estructura al tamaño real. La esencia es que el contenido de todos los campos de longitud variable se almacena en el búfer al final de la estructura, y sus longitudes se guardan en variables separadas. De acuerdo con este enfoque, la clave NodeKey se transforma de la siguiente manera.
typedef struct NodeKey {
EntityId parentId;
uint8_t type;
uint8_t nameLength;
uint8_t nameBuffer[256];
} NodeKey;Luego, al serializar, el tamaño de los datos indicado no es MDB_val serialize(NodeKey * const key) { return MDB_val { .mv_size = sizeof(NodeKey), .mv_data = (void *)key }; } toda la estructura, sino el tamaño de todos los campos de longitud fija más el tamaño de la parte realmente utilizada del búfer.
MDB_val serialize(NodeKey * const key) {
    return MDB_val {
        .mv_size = offsetof(NodeKey, nameBuffer) + key->nameLength,
        .mv_data = (void *)key
    };
}
Como resultado de la refactorización, obtuvimos un ahorrado significativo en el espacio ocupado por las claves. Sin embargo, debido al campo técnico nameLength, el comparador binario por defecto ya no es adecuado para comparar claves. Si no lo reemplazamos por uno propio, la longitud del nombre será un factor más prioritario en la ordenación que el propio nombre.
LMDB permite asignar a cada base de datos su propia función de comparación de claves. Esto se hace a través de la función mdb_set_compare estrictamente antes de su apertura. Por razones evidentes, no se puede cambiar a lo largo de la vida de la base de datos. Como entrada, el comparador recibe dos claves en formato binario y devuelve el resultado de la comparación: menos (-1), más (1) o iguales (0). El pseudocódigo para NodeKey se ve así.
int compare(MDB_val * const a, MDB_val * const b) {
NodeKey * const aKey = (NodeKey * const)a->mv_data;
NodeKey * const bKey = (NodeKey * const)b->mv_data;
return // ...
}Mientras todos los claves en la base de datos tengan el mismo tipo, la conversión incondicional de su representación en bytes al tipo de la estructura de clave de aplicación es válida. Aquí hay un matiz, pero se discutirá más adelante en la sección 'Lectura de registros'.
Serialización de valores
Las claves de los registros almacenados en LMDB funcionan de manera extremadamente intensiva. La comparación entre ellas ocurre en el contexto de cualquier operación de aplicación, y la velocidad del comparador afecta el rendimiento de toda la solución. En un mundo ideal, el comparador binario predeterminado debería ser suficiente para comparar claves, pero si es necesario utilizar uno propio, el proceso de deserialización de claves debe ser lo más rápido posible.
La parte de valor del registro (valor) no es de especial interés para la base de datos. Su conversión de representación de bytes a objeto ocurre solo cuando ya es requerida por el código de aplicación, por ejemplo, para su visualización en pantalla. Dado que esto ocurre relativamente raro, los requisitos de velocidad de este procedimiento no son tan críticos, y en su implementación podemos ser mucho más libres para orientarnos hacia la conveniencia. Por ejemplo, para serializar metadatos sobre archivos aún no cargados, utilizamos NSKeyedArchiver.
NSData *data = serialize(object);
MDB_val value = {
.mv_size = data.length,
.mv_data = (void *)data.bytes
};Sin embargo, hay casos en los que el rendimiento aún tiene importancia. Por ejemplo, al guardar metainformación sobre la estructura de archivos de la nube del usuario, usamos el mismo volcado de la memoria de objetos. La característica destacada de la tarea de formar su representación serializada es el hecho de que los elementos del directorio se modelan mediante una jerarquía de clases.
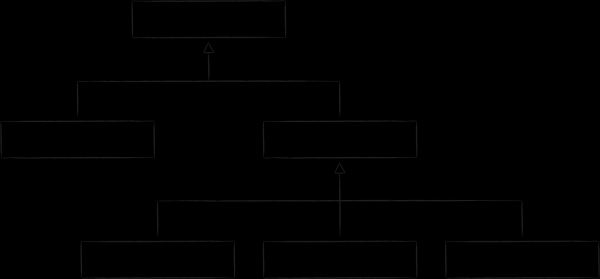
Para su implementación en el lenguaje C, los campos específicos de los herederos se extraen en estructuras separadas, y su relación con la base se establece a través del campo de tipo union. El contenido actual de la unión se especifica a través del atributo técnico type.
typedef struct NodeValue {
EntityId localId;
EntityType type;
union {
FileInfo file;
DirectoryInfo directory;
} info;
uint8_t nameLength;
uint8_t nameBuffer[256];
} NodeValue;Adición y actualización de registros
Claves y valores serializados pueden ser añadidos al almacenamiento. Para esto se utiliza la función mdb_put.
// key и value имеют тип MDB_val
mdb_put(..., &key, &value, MDB_NOOVERWRITE);En la etapa de configuración, se puede permitir o prohibir que el almacenamiento contenga múltiples registros con la misma clave. Si la duplicación de claves está prohibida, al insertar un registro se puede determinar si se permite actualizar un registro existente o no. Si la sobrescritura puede ocurrir solo debido a un error en el código, se puede prevenir estableciendo una bandera. NOOVERWRITE.
Lectura de registros
La función destinada a leer registros en LMDB es mdb_get. Si un par clave-valor se presenta anteriormente con estructuras volcado, el procedimiento se ve de la siguiente manera.
NodeValue * const readNode(..., NodeKey * const key) {
MDB_val rawKey = serialize(key);
MDB_val rawValue;
mdb_get(..., &rawKey, &rawValue);
return (NodeValue * const)rawValue.mv_data;
}El listado presentado muestra cómo la serialización a través del volcado de estructuras permite eliminar las asignaciones dinámicas no solo al escribir, sino también al leer datos. El puntero obtenido de la función mdb_get apunta exactamente a la dirección de la memoria virtual donde la base de datos almacena la representación en bytes del objeto. De hecho, conseguimos una especie de ORM, que prácticamente proporciona una velocidad de lectura de datos muy alta de manera gratuita. A pesar de la belleza del enfoque, es necesario recordar algunas características relacionadas con él.
- Para las transacciones de solo lectura, el puntero a la estructura-valor permanecerá garantizado como válido solo hasta que la transacción se cierre. Como se mencionó anteriormente, las páginas del árbol B donde se encuentra el objeto, gracias al principio de copy-on-write, permanecen inalteradas mientras al menos una transacción las esté refiriendo. Al mismo tiempo, una vez que la última transacción asociada finaliza, las páginas pueden ser reutilizadas para nuevos datos. Si es necesario que los objetos sobrevivan a la transacción que los generó, deberán ser copiados.
- Para las transacciones de lectura/escritura, el puntero a la estructura-valor obtenida será válido solo hasta la primera operación modificadora (escritura o eliminación de datos).
- A pesar de que la estructura
NodeValueno es completa, sino recortada (véase la sección "Ordenación de claves con un comparador externo"), se puede acceder a sus campos a través del puntero. ¡Lo importante es no desreferenciarlo! - De ninguna manera se debe modificar la estructura a través del puntero obtenido. Todos los cambios deben realizarse solo a través del método
mdb_put. Sin embargo, a pesar de todos los deseos de hacerlo, no se puede, ya que la región de memoria donde se ubica esta estructura está mapeada en modo de solo lectura. - Remapear el archivo al espacio de direcciones del proceso con el fin de, por ejemplo, aumentar el tamaño máximo de almacenamiento utilizando la función
mdb_env_set_map_sizeinvalidará completamente todas las transacciones y las entidades relacionadas en general, y los punteros a los objetos leídos en particular.
Finalmente, otra característica es tan engañosa que su revelación no cabe simplemente en otro punto. En el capítulo sobre el árbol B, presenté un esquema que muestra cómo se organizan sus páginas en memoria. De ello se deduce que la dirección del inicio del búfer con los datos serializados puede ser completamente arbitraria. Debido a esto, el puntero a ellos, obtenido en la estructura MDB_val y convertido a un puntero a la estructura, resulta en general no alineado. Al mismo tiempo, las arquitecturas de algunos chips (en el caso de iOS, es armv7) requieren que la dirección de cualquier dato sea un múltiplo del tamaño de la palabra de máquina o, en otras palabras, de la bitidad del sistema (para armv7, son 32 bits). En otras palabras, una operación como *(int *foo)0x800002 se considera una fuga y lleva a una condena con el veredicto EXC_ARM_DA_ALIGN. Se pueden evitar tales destinos tristes de dos maneras.
La primera consiste en copiar anticipadamente los datos en una estructura necesariamente alineada. Por ejemplo, en un comparador personalizado, esto se reflejaría de la siguiente manera.
int compare(MDB_val * const a, MDB_val * const b) {
    NodeKey aKey, bKey;
    memcpy(&aKey, a->mv_data, a->mv_size);
    memcpy(&bKey, b->mv_data, b->mv_size);
    return \/ /...
}
El camino alternativo es notificar de antemano al compilador que las estructuras con clave y valor pueden no estar alineadas mediante el atributo aligned(1). En ARM, se puede lograr el mismo efecto también mediante el atributo packed. Dado que además contribuye a la optimización del espacio ocupado por la estructura, considero que este método es preferible, aunque incrementa el costo de las operaciones de acceso a los datos.
typedef struct __attribute__((packed)) NodeKey {
    uint8_t parentId;
    uint8_t type;
    uint8_t nameLength;
    uint8_t nameBuffer[256];
} NodeKey;
Consultas de rango
Para iterar sobre un grupo de registros en LMDB, se ha previsto una abstracción de cursor. Veamos cómo trabajar con él utilizando como ejemplo una tabla de metadatos de usuario que ya conocemos.
En el contexto de mostrar una lista de archivos en un directorio, es necesario encontrar todas las claves asociadas a sus archivos e carpetas hijos. En las secciones anteriores, hemos ordenado las claves NodeKey de tal manera que primero se ordenen por el identificador del directorio padre. Por lo tanto, la tarea técnica de obtener el contenido de la carpeta se reduce a establecer el cursor en el límite superior del grupo de claves con un prefijo establecido y luego iterar hasta el límite inferior.
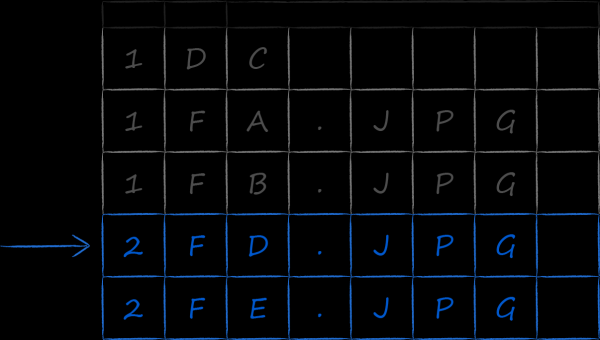
Se puede encontrar el límite superior "de manera directa" mediante una búsqueda secuencial. Para ello, se establece el cursor al inicio de la lista de claves en la base de datos y se incrementa hasta que debajo de él se encuentre una clave con el identificador del directorio padre. Este enfoque presenta 2 desventajas evidentes:
- La complejidad de búsqueda es lineal, aunque se sabe que en los árboles, en general, y en el árbol B en particular, esto se puede lograr en un tiempo logarítmico.
- Se cargan en vano desde el archivo a la memoria principal todas las páginas anteriores a la buscada, lo cual es extremadamente costoso.
Afortunadamente, en la API de LMDB se ha previsto un método eficaz para el posicionamiento inicial del cursor. Para ello, es necesario formar una clave tal que su valor sea claramente menor o igual a la clave que se encuentra en el límite superior del intervalo. Por ejemplo, en relación con la lista en la imagen anterior, podemos formar una clave en la que el campo parentId sea igual a 2, mientras que todos los demás se llenen con ceros. Esta clave parcialmente llena se pasa como entrada a la función mdb_cursor_get especificando la operación MDB_SET_RANGE.
NodeKey upperBoundSearchKey = {
.parentId = 2,
.type = 0,
.nameLength = 0
};
MDB_val value, key = serialize(upperBoundSearchKey);
MDB_cursor *cursor;
mdb_cursor_open(..., &cursor);
mdb_cursor_get(cursor, &key, &value, MDB_SET_RANGE);Si se encuentra el límite superior del grupo de claves, entonces se itera sobre él mientras no se encuentre una clave diferente parentId, o hasta que las claves se hayan agotado.
do {
rc = mdb_cursor_get(cursor, &key, &value, MDB_NEXT);
// procesando...
} while (MDB_NOTFOUND != rc && // verificar el final de la tabla
IsTargetKey(key)); // verificar el final del grupo de clavesLo agradable es que, al iterar usando mdb_cursor_get, obtenemos no solo la clave, sino también el valor. Si para cumplir con las condiciones de selección es necesario verificar también los campos de la parte del valor del registro, estos están fácilmente disponibles sin movimientos adicionales.
4.3. Modelado de relaciones entre tablas
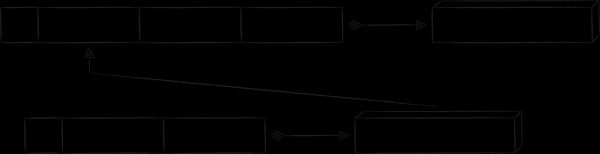
Hasta ahora hemos podido considerar todos los aspectos del diseño y funcionamiento de una base de datos de una sola tabla. Se puede decir que una tabla es un conjunto de registros ordenados, compuestos por pares clave-valor del mismo tipo. Si representamos la clave como un rectángulo y el valor asociado a ella como un paralelepípedo, obtendremos un esquema visual de la base de datos.

Sin embargo, en la vida real rara vez podemos prescindir de un esfuerzo considerable. A menudo, en la base de datos es necesario, por un lado, tener varias tablas y, por otro, realizar selecciones en un orden diferente al de la clave primaria. Este último apartado está dedicado a los temas de creación y vinculación entre ellas.
Tablas de índice
En la aplicación en la nube hay una sección llamada "Galería". En ella se muestra contenido multimedia de toda la nube, ordenado cronológicamente. Para una implementación óptima de tal selección, junto a la tabla principal, es necesario crear otra tabla con un nuevo tipo de claves. Esta contendrá un campo con la fecha de creación del archivo, que servirá como criterio primario de ordenación. Dado que las nuevas claves hacen referencia a los mismos datos que las claves en la tabla principal, se les llama claves indexadas. En la imagen de abajo, están destacadas en color naranja.
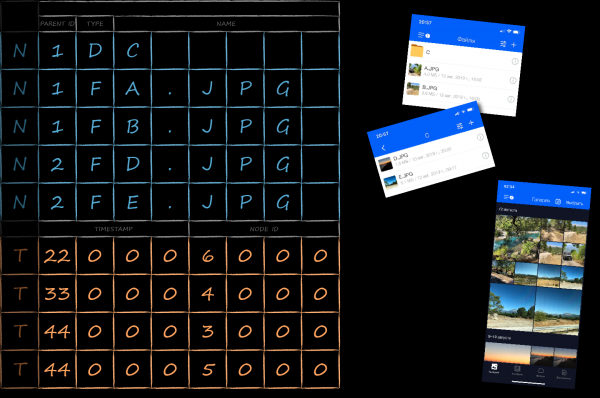
Para separar las claves de diferentes tablas dentro de una misma base de datos, se les ha añadido a todas un campo técnico adicional llamado tableId. Al hacer de este el más prioritario para la ordenación, lograremos agrupar las claves primero por tablas y luego dentro de las tablas por sus propias reglas.
La clave indexada hace referencia a los mismos datos que la clave primaria. La implementación directa de esta propiedad a través de la asociación con una copia de la parte de valor de la clave primaria es ineficiente desde varias perspectivas:
- Desde el punto de vista del espacio ocupado, dado que los metadatos pueden ser bastante ricos.
- Desde el punto de vista del rendimiento, ya que al actualizar los metadatos, los nodos tendrían que reescribirse en dos claves.
- Desde el punto de vista del soporte del código, si olvidamos actualizar los datos de una de las claves, obtendremos un error de inconsistencia de datos en el almacenamiento que es difícil de detectar.
A continuación, veremos cómo eliminar estas deficiencias.
Organización de relaciones entre tablas
Para vincular la tabla de índice con la tabla principal, es adecuado el patrón «clave como valor». Como su nombre indica, como parte del valor de la entrada del índice se utiliza una copia del valor de la clave primaria. Este enfoque minimiza todas las deficiencias mencionadas anteriormente relacionadas con el almacenamiento de una copia de la parte de valor del registro primario. La única desventaja es que para obtener el valor a través de la clave de índice se deben realizar 2 consultas a la base de datos en lugar de una. Esquemáticamente, el esquema resultante de la base de datos se ve de la siguiente manera.
Otro patrón de organización de relaciones entre tablas es «clave redundante». Su esencia radica en añadir atributos adicionales a la clave, que no son necesarios para ordenar, sino para recrear la clave relacionada. En la aplicación de la Nube Mail.ru hay ejemplos reales de su uso, sin embargo, para evitar una profunda inmersión en el contexto de los específicos frameworks de iOS, daré un ejemplo ficticio, pero más comprensible.
En las aplicaciones móviles en la nube hay una página donde se muestran todos los archivos y carpetas a los que el usuario ha otorgado acceso a otras personas. Dado que hay relativamente pocos archivos de este tipo y mucha información específica relacionada con la publicidad (a quién se le ha otorgado acceso, con qué derechos, etc.), no sería racional sobrecargar la parte de valor del registro en la tabla principal. Sin embargo, si se quiere mostrar esos archivos fuera de línea, de todos modos se necesita almacenarla en algún lugar. Una solución natural es crear una tabla separada para ello. En el esquema a continuación, su clave tiene el prefijo «P», y el marcador de posición «propname» puede ser reemplazado por un valor más específico «información pública».
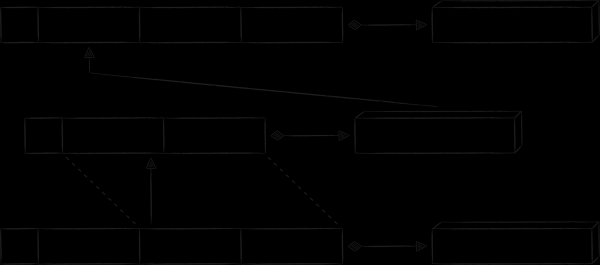
Todos los metadatos únicos, para los cuales se creó la nueva tabla, se colocan en la parte de valor del registro. Al mismo tiempo, no queremos duplicar aquellos datos sobre archivos y carpetas que ya se almacenan en la tabla principal. En su lugar, se añaden datos redundantes en la clave "P" na forma de los campos "node ID" y "timestamp". Gracias a ellos se puede construir una clave de índice, a partir de la cual se obtiene la clave primaria, y finalmente se recuperan los metadatos del nodo.
Conclusión
Evaluamos positivamente los resultados de la implementación de LMDB. Después de esta, la cantidad de bloqueos de la aplicación se redujo en un 30%.
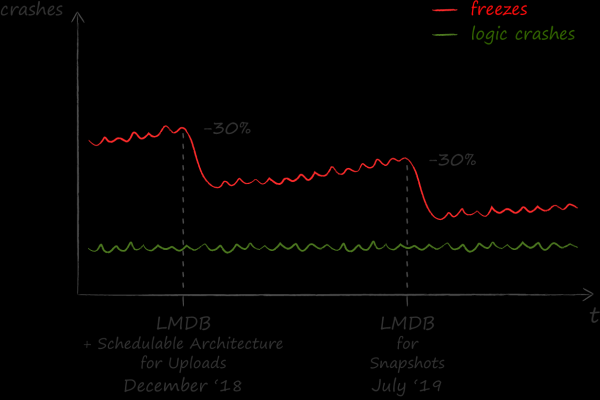
Los resultados del trabajo realizado encontraron eco más allá del equipo de iOS. Actualmente, uno de los principales secciones "Archivos" en la aplicación para Android también ha cambiado al uso de LMDB, y otras partes están en camino. El lenguaje C, en el que está implementado el almacenamiento key-value, resultó ser un buen apoyo para inicialmente hacer el envoltorio de aplicación en una forma multiplataforma en C++. Para la conexión sin problemas de la biblioteca C++ obtenida con el código de plataforma en Objective-C y Kotlin, se utilizó un generador de código. de Dropbox, pero esa es otra historia.
Fuente: habr.com
