

A menudo, las personas que entran en el campo de la Ciencia de Datos tienen ideas poco realistas sobre lo que les espera. Muchos piensan que ahora se dedicarán a escribir redes neuronales impresionantes, crear un asistente de voz al estilo de Iron Man o superar a todos en los mercados financieros.
Pero el trabajo Data de un Scientist se basa en datos, y uno de los aspectos más importantes y que requieren más tiempo es el procesamiento de datos antes de introducirlos en una red neuronal o analizarlos de alguna manera específica.
En este artículo, nuestro equipo describirá cómo se pueden procesar datos de manera rápida y sencilla con instrucciones paso a paso y código. Nos hemos esforzado por hacer que el código sea lo suficientemente flexible como para que se pueda aplicar a diferentes conjuntos de datos.
Es posible que muchos profesionales no encuentren nada extraordinario en este artículo, pero los principiantes podrán aprender algo nuevo, y aquellos que han soñado con crear su propio notebook para un procesamiento de datos rápido y estructurado pueden copiar el código y adaptarlo a sus necesidades, o
Recibimos el dataset. ¿Qué hacer ahora?
Así que, estándar: necesitamos entender con qué estamos tratando, la imagen general. Para ello, usamos pandas para definir simplemente los diferentes tipos de datos.
import pandas as pd #importamos pandas
import numpy as np  #importamos numpy
df = pd.read_csv("AB_NYC_2019.csv") #leemos el dataset y lo guardamos en la variable df
df.head(3) #vemos las primeras 3 filas para entender cómo se ven los valores 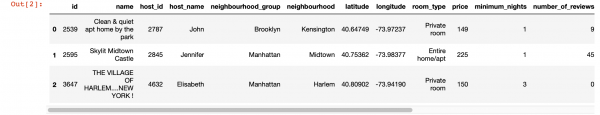
df.info() #mostramos información sobre las columnas 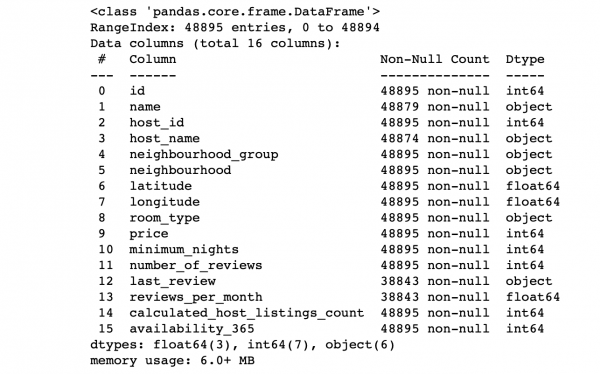
Observamos los valores de las columnas:
- ¿El número de filas en cada columna coincide con el número total de filas?
- ¿Cuál es la esencia de los datos en cada columna?
- ¿Qué columna queremos hacer objetivo para hacer predicciones sobre ella?
Las respuestas a estas preguntas permitirán analizar el conjunto de datos y esbozar un plan de acción inmediato.
Además, para tener una mirada más profunda sobre los valores en cada columna, podemos usar la función describe() de pandas. Sin embargo, la desventaja de esta función es que no proporciona información sobre columnas con valores de tipo string. Nos ocuparemos de eso más adelante.
df.describe() 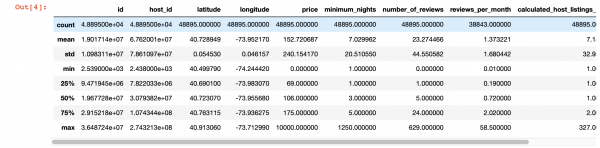
Visualización mágica
Veamos dónde nos faltan valores por completo:
import seaborn as sns
sns.heatmap(df.isnull(),yticklabels=False,cbar=False,cmap='viridis') 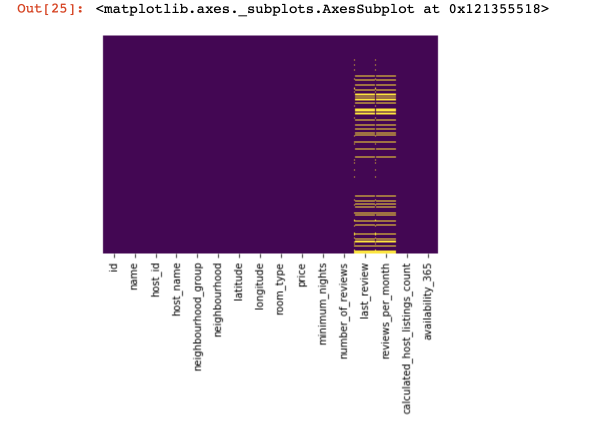
Este fue un breve vistazo general, ahora comenzaremos con cosas más interesantes.
Intentamos encontrar y, si es posible, eliminar las columnas que tienen un solo valor en todas las filas (no afectarán el resultado):
df = df[[c for c
        in list(df)
        if len(df[c].unique()) > 1]] #Sobreescribimos el conjunto de datos, dejando solo las columnas con más de un valor único
Ahora protegemos a nosotros mismos y el éxito de nuestro proyecto de las filas duplicadas (filas que contienen la misma información en el mismo orden que ya una de las filas existentes):
df.drop_duplicates(inplace=True) #Hacemos esto si creemos que es necesario.
                                 #En algunos proyectos, no es recomendable eliminar esos datos desde el principio.
Dividimos el conjunto de datos en dos: uno con valores cualitativos y otro con valores cuantitativos
Aquí es necesario hacer una pequeña aclaración: si las filas con datos faltantes en los datos cualitativos y cuantitativos no se relacionan entre sí, entonces será necesario decidir qué sacrificamos: todas las filas con datos faltantes, solo una parte de ellas o columnas específicas. Si las filas están relacionadas, tenemos todo el derecho de dividir el conjunto de datos en dos. De lo contrario, primero debemos abordar las filas en las que los datos faltantes en cualitativos y cuantitativos no se relacionan y solo después dividir el conjunto de datos en dos.
df_numerical = df.select_dtypes(include=[np.number])
df_categorical = df.select_dtypes(exclude=[np.number])
Hacemos esto para facilitar la gestión de estos dos tipos de datos diferentes; posteriormente entenderemos cuánto simplifica nuestra vida.
Trabajo con datos cuantitativos
Lo primero que debemos hacer es verificar si hay "columnas espías" en los datos cuantitativos. Llamamos a estas columnas así porque pretenden ser datos cuantitativos, pero en realidad funcionan como cualitativos.
¿Cómo podemos identificarlas? Por supuesto, todo depende de la naturaleza de los datos que estás analizando, pero en general, tales columnas pueden tener pocos datos únicos (alrededor de 3-10 valores únicos).
print(df_numerical.nunique())Después de determinar qué columnas son espías, las moveremos de los datos cuantitativos a los cualitativos:
spy_columns = df_numerical[['columna1', 'columna2', 'columna3']]#extraemos las columnas espía y las guardamos en un dataframe separado
df_numerical.drop(labels=['columna1', 'columna2', 'columna3'], axis=1, inplace = True)#eliminamos estas columnas de los datos numéricos
df_categorical.insert(1, 'columna1', spy_columns['columna1']) #añadimos la primera columna espía a los datos categóricos
df_categorical.insert(1, 'columna2', spy_columns['columna2']) #añadimos la segunda columna espía a los datos categóricos
df_categorical.insert(1, 'columna3', spy_columns['columna3']) #añadimos la tercera columna espía a los datos categóricos
Finalmente hemos separado completamente los datos numéricos de los categóricos y ahora podemos trabajar con ellos adecuadamente. Primero, debemos entender dónde tenemos valores vacíos (NaN, y en algunos casos 0 serán considerados como valores vacíos).
for i in df_numerical.columns:
    print(i, df[i][df[i]==0].count())
En este punto, es importante entender en qué columnas los ceros pueden significar valores ausentes: ¿está relacionado con la forma en que se recopilaron los datos? ¿O podría estar relacionado con los valores de los datos? Estas preguntas deben responderse caso por caso.
Así que, si decidimos que los datos pueden estar ausentes donde hay ceros, deberíamos reemplazar los ceros por NaN, para facilitar el trabajo posterior con estos datos perdidos:
df_numerical[["columna 1", "columna 2"]] = df_numerical[["columna 1", "columna 2"]].replace(0, nan)Ahora veamos dónde tenemos datos faltantes:
sns.heatmap(df_numerical.isnull(), yticklabels=False, cbar=False, cmap='viridis') # También se puede usar df_numerical.info() 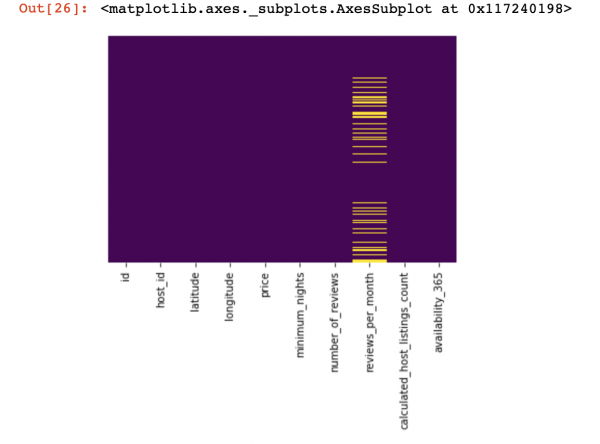
Aquí deberían estar marcados en amarillo aquellos valores dentro de las columnas que están ausentes. Y lo más interesante comienza ahora: ¿cómo tratar con estos valores? ¿Eliminar filas con estos valores o columnas? ¿O llenar estos valores vacíos con otros?
Aquí tienes un esquema aproximado que puede ayudarte a decidir qué se puede hacer con los valores vacíos:
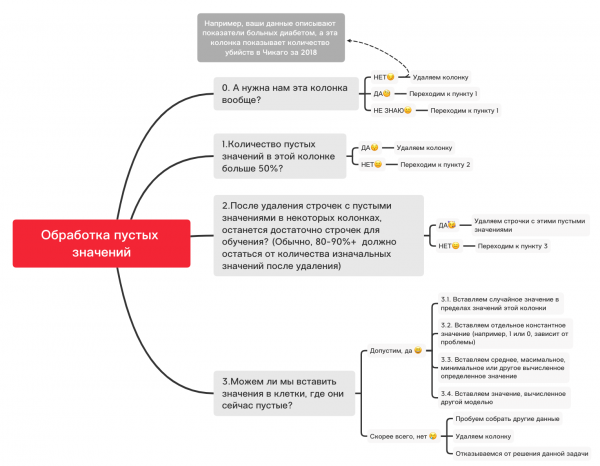
0. Eliminamos columnas innecesarias
df_numerical.drop(labels=["columna1", "columna2"], axis=1, inplace=True)1. ¿La cantidad de valores vacíos en esta columna es mayor al 50%?
print(df_numerical.isnull().sum() / df_numerical.shape[0] * 100)df_numerical.drop(labels=["columna1", "columna2"], axis=1, inplace=True)#Eliminamos si alguna columna tiene más de 50 valores vacíos2. Eliminamos filas con valores vacíos
df_numerical.dropna(inplace=True) # Eliminamos filas con valores vacíos, si luego hay suficientes datos para el entrenamiento3.1. Insertando un valor aleatorio
import random # importamos random
df_numerical["columna"].fillna(lambda x: random.choice(df[df[column] != np.nan]["columna"]), inplace=True) # insertamos valores aleatorios en las celdas vacías de la tabla
3.2. Insertando un valor constante
from sklearn.impute import SimpleImputer # importamos SimpleImputer, que ayudará a insertar valores
imputer = SimpleImputer(strategy='constant', fill_value="") # insertamos un valor específico usando SimpleImputer
df_numerical[["nueva_columna1", 'nueva_columna2', 'nueva_columna3']] = imputer.fit_transform(df_numerical[['columna1', 'columna2', 'columna3']]) # Aplicamos esto a nuestra tabla
df_numerical.drop(labels=["columna1", "columna2", "columna3"], axis=1, inplace=True) # Eliminamos las columnas con los valores antiguos
3.3. Insertando el promedio o el valor más frecuente
from sklearn.impute import SimpleImputer # importamos SimpleImputer, que ayudará a insertar valores
imputer = SimpleImputer(strategy='mean', missing_values=np.nan) # en lugar de mean, se puede usar most_frequent también
df_numerical[["nueva_columna1", 'nueva_columna2', 'nueva_columna3']] = imputer.fit_transform(df_numerical[['columna1', 'columna2', 'columna3']]) # Aplicamos esto a nuestra tabla
df_numerical.drop(labels=["columna1", "columna2", "columna3"], axis=1, inplace=True) # Eliminamos las columnas con los valores antiguos
3.4. Insertando un valor calculado por otro modelo
A veces, los valores se pueden calcular utilizando modelos de regresión, usando modelos de la biblioteca sklearn o de otras bibliotecas similares. Nuestro equipo dedicará un artículo aparte sobre cómo se puede hacer esto en un futuro cercano.
Así que, por ahora, la narración sobre datos cuantitativos se detendrá, porque hay muchos otros matices sobre cómo hacer mejor la preparación de datos y el preprocessing para diferentes tareas. Las cosas básicas para los datos cuantitativos han sido consideradas en este artículo, y ahora es el momento de volver a los datos cualitativos, que separamos hace algunos pasos de los cuantitativos. ¡Usted puede modificar este cuaderno como desee, adaptándolo a diferentes tareas para que el preprocesamiento de datos sea muy rápido!
Datos cualitativos
Principalmente, se utiliza el método de One-hot-encoding para formatear los datos de string (o object) a número. Antes de avanzar a este punto, usaremos el esquema y el código de arriba para entender los valores faltantes.
df_categorical.nunique()sns.heatmap(df_categorical.isnull(), yticklabels=False, cbar=False, cmap='viridis') 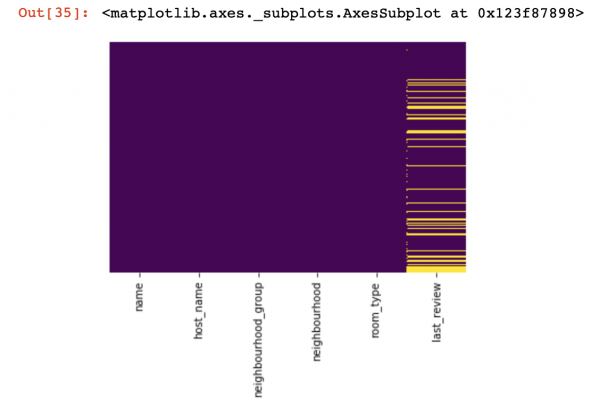
0. Eliminamos columnas innecesarias
df_categorical.drop(labels=["columna1", "columna2"], axis=1, inplace=True)1. ¿La cantidad de valores vacíos en esta columna es mayor al 50%?
print(df_categorical.isnull().sum() / df_numerical.shape[0] * 100)df_categorical.drop(labels=["columna1", "columna2"], axis=1, inplace=True) # Eliminamos si alguna columna
# tiene más del 50% de valores faltantes2. Eliminamos filas con valores vacíos
df_categorical.dropna(inplace=True) # Eliminamos filas con valores faltantes,
                                   # si después quedan suficientes datos para el entrenamiento
3.1. Insertando un valor aleatorio
import random
df_categorical["columna"].fillna(lambda x: random.choice(df[df[column] != np.nan]["columna"]), inplace=True)
3.2. Insertando un valor constante
from sklearn.impute import SimpleImputer
imputer = SimpleImputer(strategy='constant', fill_value="")
df_categorical[["nueva_columna1", 'nueva_columna2', 'nueva_columna3']] = imputer.fit_transform(df_categorical[['columna1', 'columna2', 'columna3']])
df_categorical.drop(labels = ["columna1", "columna2", "columna3"], axis = 1, inplace = True)
Así que, finalmente, hemos manejado los valores faltantes en los datos cualitativos. Ahora es momento de aplicar one-hot-encoding a los valores que tiene en su base de datos. Este método se utiliza con mucha frecuencia para que su algoritmo pueda aprender teniendo en cuenta los datos cualitativos.
def encode_and_bind(original_dataframe, feature_to_encode):
    dummies = pd.get_dummies(original_dataframe[[feature_to_encode]])
    res = pd.concat([original_dataframe, dummies], axis=1)
    res = res.drop([feature_to_encode], axis=1)
    return(res)
features_to_encode = ["columna1", "columna2", "columna3"]
for feature in features_to_encode:
df_categorical = encode_and_bind(df_categorical, feature)Así que, finalmente hemos terminado de procesar los datos cualitativos y cuantitativos por separado — es hora de combinarlos de nuevo
new_df = pd.concat([df_numerical, df_categorical], axis=1)Después de haber unido los datasets en uno, al final podemos utilizar la transformación de datos con MinMaxScaler de la librería sklearn. Esto hará que nuestros valores estén entre 0 y 1, lo que ayudará en el entrenamiento del modelo en el futuro.
from sklearn.preprocessing import MinMaxScaler
min_max_scaler = MinMaxScaler()
new_df = min_max_scaler.fit_transform(new_df)
¡Estos datos ahora están listos para todo — redes neuronales, algoritmos ML estándar, etc.!
En este artículo no hemos considerado el trabajo con datos relacionados con series temporales, ya que para tales datos se deben utilizar técnicas de procesamiento ligeramente diferentes, dependiendo de su tarea. En el futuro, nuestro equipo dedicará un artículo separado a este tema y esperamos que pueda aportar algo interesante, nuevo y útil a su vida, al igual que este.
Fuente: habr.com
