

¡Hola a todos! Me llamo Dmitry Samsonov, soy el administrador de sistemas principal en 'Odnoklassniki'. Contamos con más de 7,000 servidores físicos, 11,000 contenedores en nuestra nube y 200 aplicaciones, que en diversas configuraciones forman 700 clústeres diferentes. La gran mayoría de los servidores funcionan bajo CentOS 7.
El 14 de agosto de 2018 se publicó información sobre la vulnerabilidad FragmentSmack
() y SegmentSmack (). Estas son vulnerabilidades con un vector de ataque de red y una calificación bastante alta (7.5), que amenazan con provocar una denegación de servicio (DoS) debido al agotamiento de recursos (CPU). En ese momento, no se había propuesto un arreglo en el núcleo para FragmentSmack, además, salió significativamente más tarde que la publicación de la información sobre la vulnerabilidad. Para solucionar SegmentSmack se recomendó actualizar el núcleo. El paquete de actualización fue lanzado el mismo día, solo quedaba instalarlo.
No, ¡no estamos en contra de actualizar el núcleo! Sin embargo, hay matices...
Cómo actualizamos el núcleo en producción
En general, no hay nada complicado:
- Descargar los paquetes;
- Instalarlos en una cantidad determinada de servidores (incluidos los servidores que alojan nuestra nube);
- Asegurarse de que nada se haya roto;
- Verificar que todas las configuraciones estándar del núcleo se aplicaron sin errores;
- Esperar unos días;
- Comprobar los indicadores de los servidores;
- Cambiar la implementación de nuevos servidores al nuevo núcleo;
- Actualizar todos los servidores por centros de datos (uno por uno, para minimizar el efecto para los usuarios en caso de problemas);
- Reiniciar todos los servidores.
Repetir para todas las versiones de núcleos que tenemos. Actualmente, esto es:
- El núcleo estándar de CentOS 7 3.10 — para la mayoría de los servidores comunes;
- El núcleo vanilla 4.19 — para nuestra , porque necesitamos BFQ, BBR, etc.;
- Elrepo kernel-ml 5.2 — para , porque el 4.19 anteriormente era inestable, y se necesitan las mismas características.
Como habrás adivinado, la mayor parte del tiempo se dedica a reiniciar miles de servidores. Dado que no todas las vulnerabilidades son críticas para todos los servidores, reiniciamos solo aquellos que son accesibles directamente desde Internet. En la nube, para no limitar la flexibilidad, no asociamos los contenedores accesibles externamente a servidores individuales con un nuevo núcleo, sino que reiniciamos todos los hosts sin excepción. Afortunadamente, el proceso allí es más simple que con los servidores normales. Por ejemplo, los contenedores sin estado pueden simplemente trasladarse a otro servidor durante el reinicio.
Sin embargo, el trabajo sigue siendo mucho y puede llevar varias semanas, y si surge algún problema con la nueva versión, puede extenderse a varios meses. Los atacantes son muy conscientes de esto, por lo que se necesita un plan 'B'.
FragmentSmack/SementSmack. Solución alternativa
Afortunadamente, para algunas vulnerabilidades existe un plan 'B', y se llama Solución alternativa. A menudo, se trata de cambiar la configuración del núcleo/aplicaciones para minimizar el posible efecto o eliminar completamente la explotación de las vulnerabilidades.
En el caso de FragmentSmack/SementSmack la siguiente Solución alternativa:
«Se pueden cambiar los valores predeterminados de 4MB y 3MB en net.ipv4.ipfrag_high_thresh y net.ipv4.ipfrag_low_thresh (y sus equivalentes para ipv6 net.ipv6.ipfrag_high_thresh y net.ipv6.ipfrag_low_thresh) a 256 kB y 192 kB respectivamente o menores. Las pruebas muestran una disminución desde pequeña hasta significativa en el uso de CPU durante un ataque, dependiendo del hardware, la configuración y las condiciones. Sin embargo, puede haber cierto impacto en el rendimiento debido a ipfrag_high_thresh=262144 bytes, ya que solo dos fragmentos de 64K pueden caber simultáneamente en la cola de reensamblaje. Por ejemplo, existe el riesgo de que las aplicaciones que manejan grandes paquetes UDP fallen.».
Los parámetros mismos se describen así:
ipfrag_high_thresh - NÚMERO ENTERO LARGO
     Memoria máxima utilizada para reensamblar fragmentos de IP.
ipfrag_low_thresh - ENTERO LARGO
     Memoria máxima utilizada para reensamblar fragmentos IP antes de que el núcleo
     comience a eliminar colas de fragmentos incompletos para liberar recursos.
     El núcleo sigue aceptando nuevos fragmentos para la desfragmentación.
No tenemos servicios de producción de UDP grandes. En LAN no hay tráfico fragmentado, en WAN sí, pero no es significativo. Nada lo presagia: ¡se puede aplicar la Solución alternativa!
FragmentSmack/SementSmack. La primera sangre
El primer problema que encontramos fue que los contenedores en la nube a veces aplicaban nuevas configuraciones solo parcialmente (solo ipfrag_low_thresh), y a veces no las aplicaban en absoluto, simplemente fallaban al iniciar. No pudimos reproducir la falla de manera consistente (todas las configuraciones se aplicaron manualmente sin complicaciones). También es complicado entender por qué falla el contenedor al iniciar: no se encontraron errores. Una cosa era segura: revertir las configuraciones soluciona el problema de los contenedores que fallan.
¿Por qué no es suficiente aplicar Sysctl en el host? El contenedor vive en su propio namespace de red dedicado, por lo tanto, al menos dentro del contenedor puede diferir del host.
¿Cómo se aplican exactamente las configuraciones de Sysctl en el contenedor? Dado que nuestros contenedores son no privilegiados, no será posible cambiar ninguna configuración de Sysctl al entrar en el contenedor, simplemente no hay suficientes privilegios. Para iniciar contenedores, nuestra nube en ese momento utilizaba Docker (ahora ya ). A Docker se le pasaban los parámetros del nuevo contenedor a través de la API, incluidas las configuraciones de Sysctl necesarias.
Durante el análisis de versiones, se descubrió que la API de Docker no devolvía todos los errores (al menos en la versión 1.10). Al intentar iniciar el contenedor a través de 'docker run', finalmente vimos algo:
write /proc/sys/net/ipv4/ipfrag_high_thresh: argumento inválido docker: Respuesta de error del demonio: No se puede iniciar el contenedor <...>: [9] Error del sistema: no se pudo sincronizar con el proceso del contenedor.
El valor del parámetro no es válido. Pero, ¿por qué? ¿Y por qué solo a veces no es válido? Se descubrió que Docker no garantiza el orden de aplicación de los parámetros de Sysctl (la última versión verificada es la 1.13.1), por lo que a veces ipfrag_high_thresh intentaba establecerse en 256K, cuando ipfrag_low_thresh aún estaba en 3M, es decir, el límite superior estaba por debajo del inferior, lo que causaba el error.
En ese momento, ya utilizábamos nuestro propio mecanismo de reconfiguración del contenedor después de iniciar (congelando el contenedor a través de y ejecutando comandos en el namespace del contenedor a través de ), y también agregamos a esta parte la escritura de los parámetros de Sysctl. El problema se resolvió.
FragmentSmack/SegmentSmack. Primera sangre 2
No habíamos terminado de entender la aplicación del Workaround en la nube cuando empezaron a llegar las primeras quejas aisladas de los usuarios. En ese momento, habían pasado varias semanas desde que comenzamos a aplicar el Workaround en los primeros servidores. La investigación inicial mostró que las quejas se referían a servicios específicos y no a todos los servidores de esos servicios. El problema volvió a adquirir un carácter sumamente incierto.
En primer lugar, por supuesto, intentamos revertir la configuración de Sysctl, pero esto no dio ningún efecto. Varias manipulaciones con la configuración del servidor y la aplicación tampoco ayudaron. Un reinicio fue lo que ayudó. Reiniciar en Linux es tan antinatural como lo era en su día para trabajar con Windows. Sin embargo, resultó útil, y lo atribuímos a un 'fallo en el núcleo' al aplicar la nueva configuración de Sysctl. Qué ligero fue eso...
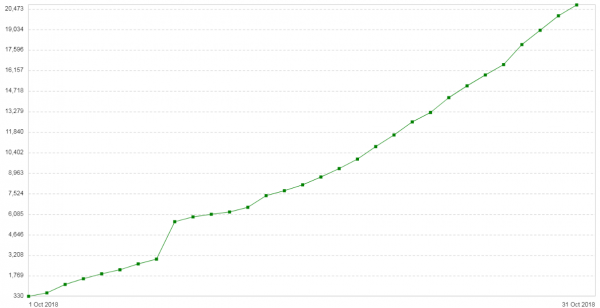
Tres semanas después, el problema se repitió. La configuración de estos servidores era bastante simple: Nginx en modo proxy/balanceador. El tráfico era escaso. Una nueva entrada: en los clientes, cada día aumentaba el número de errores 504 (). En el gráfico se muestra el número de errores 504 por día para este servicio:
Todos los errores son sobre el mismo backend — el que está en la nube. El gráfico de consumo de memoria para los fragmentos de paquetes en este backend era el siguiente:
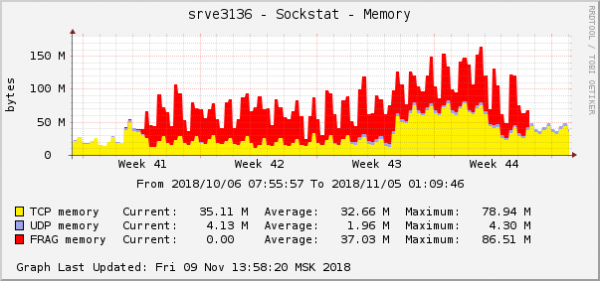
Esta es una de las manifestaciones más notables del problema en los gráficos del sistema operativo. En la nube, justo en ese momento, se solucionó otro problema de red con la configuración de QoS (Control de Tráfico). El gráfico de consumo de memoria para los fragmentos de paquetes se veía igual:
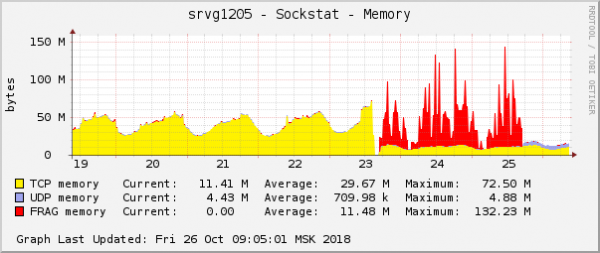
La suposición era simple: si en los gráficos se ven iguales, la causa también debe ser la misma. Más aún, los problemas con este tipo de memoria son extremadamente raros.
La esencia del problema reparado era que usábamos en QoS el programador de paquetes fq con la configuración predeterminada. Por defecto, para una conexión permite añadir a la cola 100 paquetes y algunas conexiones, en condiciones de falta de ancho de banda, comenzaron a llenar la cola hasta el límite. En este caso, los paquetes se descartan. En las estadísticas de tc (tc -s qdisc) esto se refleja así:
qdisc fq 2c6c: padre 1:2c6c límite 10000p flujo_límite 100p cubos 1024 máscara huérfana 1023 quantum 3028 quantum_inicial 15140 retraso_relleno 40.0ms
  Enviados 454701676345 bytes 491683359 pkt (caídos 464545, límites superados 0, re-ordenamientos 0)
  atraso 0b 0p re-ordenamientos 0
   1024 flujos (1021 inactivos, 0 limitados)
   0 gc, 0 alta_prioridad, 0 limitado, 464545 flujo_plimit
«464545 flows_plimit» son los paquetes que se descartaron por superar el límite de cola de una conexión, mientras que «dropped 464545» es la suma de todos los paquetes descartados de ese programador. Después de aumentar la longitud de la cola a 1,000 y reiniciar los contenedores, el problema dejó de manifestarse. Se puede recostar en la silla y disfrutar de un batido.
FragmentSmack/SegmentSmack. Última sangre
En primer lugar, después de varios meses desde el anuncio de las vulnerabilidades en el núcleo, finalmente ha aparecido un parche para FragmentSmack (recordemos que junto con el anuncio en agosto solo se lanzó un parche para SegmentSmack), lo que nos dio la oportunidad de dejar de utilizar el Workaround, que nos causó bastantes problemas. Durante este tiempo, ya hemos migrado algunos servidores al nuevo núcleo, y ahora había que empezar de nuevo. ¿Por qué actualizamos el núcleo sin esperar el parche de FragmentSmack? La razón es que el proceso de protección contra estas vulnerabilidades coincidió (y se fusionó) con el proceso de actualización de CentOS en sí (que requiere aún más tiempo que actualizar solo el núcleo). Además, SegmentSmack es una vulnerabilidad más peligrosa y el parche para ella salió de inmediato, por lo que tenía sentido de todos modos. Sin embargo, no podíamos simplemente actualizar el núcleo en CentOS porque la vulnerabilidad FragmentSmack, que apareció en CentOS 7.5, solo fue corregida en la versión 7.6, por lo que tuvimos que detener la actualización a 7.5 y comenzar todo de nuevo con la actualización a 7.6. También sucede.
En segundo lugar, hemos recibido algunas quejas raras de los usuarios sobre problemas. Ahora sabemos con certeza que todas están relacionadas con la carga de archivos por parte de los clientes en algunos de nuestros servidores. Sin embargo, a través de esos servidores solo se registró una muy pequeña cantidad de cargas respecto al total.
Como recordamos de la historia anterior, la reversión de Sysctl no ayudó. Ayudó reiniciar, pero temporalmente.
Las sospechas sobre Sysctl no se disiparon, pero esta vez se requería recopilar la mayor cantidad de información posible. También faltaba enormemente la posibilidad de reproducir el problema de carga en el cliente, para investigar de manera más específica qué estaba pasando.
El análisis de toda la estadística y los registros disponibles no nos acercó a comprender lo que estaba sucediendo. Faltaba urgentemente la capacidad de reproducir el problema para "tocar" una conexión específica. Finalmente, los desarrolladores en una versión especial de la aplicación lograron reproducir de manera estable los problemas en un dispositivo de prueba al conectarse a través de Wi-Fi. Esto marcó un avance en la investigación. El cliente se conectaba a Nginx, que estaba configurado como proxy hacia el backend, que era nuestra aplicación en Java.
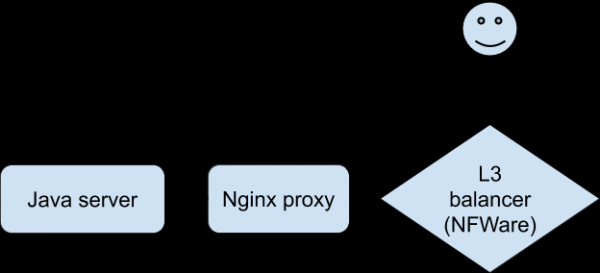
El diálogo durante los problemas fue el siguiente (registrado del lado del proxy Nginx):
- Cliente: solicitud de información sobre la reanudación de la descarga del archivo.
- Servidor Java: respuesta.
- Cliente: POST con el archivo.
- Servidor Java: error.
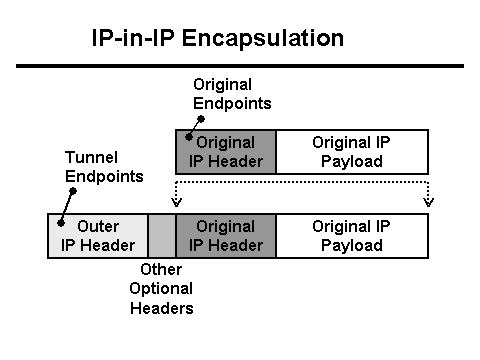
El servidor Java, además, escribe en el registro que recibió 0 bytes de datos del cliente, y el proxy Nginx indica que la solicitud tardó más de 30 segundos (30 segundos es el tiempo de espera en la aplicación del cliente). ¿Por qué entonces el tiempo de espera y por qué 0 bytes? Desde el punto de vista de HTTP, todo funciona como se supone que debe funcionar, pero el POST con el archivo parece desaparecer de la red. Además, desaparece entre el cliente y Nginx. ¡Ha llegado el momento de armarnos con Tcpdump! Pero antes, necesitamos entender la configuración de la red. El proxy Nginx está detrás de un balanceador de carga L3 . Se utiliza un túnel para entregar paquetes desde el balanceador de carga L3 al servidor, que añade sus propios encabezados a los paquetes:
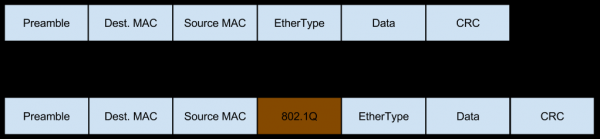
Al mismo tiempo, la red llega a este servidor en forma de tráfico etiquetado por VLAN, que también añade sus campos a los paquetes:
Y además, este tráfico puede fragmentarse (ese pequeño porcentaje de tráfico fragmentado entrante del que hablamos al evaluar los riesgos de la solución alternativa), lo que también modifica el contenido de los encabezados:
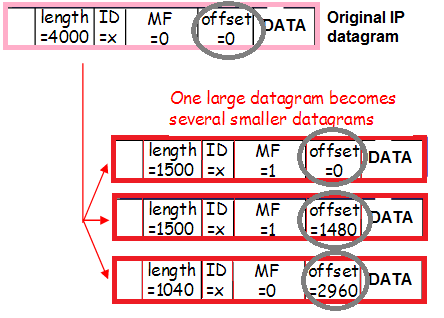
Una vez más: los paquetes están encapsulados en la etiqueta VLAN, encapsulados en el túnel, fragmentados. Para comprender mejor cómo sucede esto, sigamos la ruta de un paquete desde el cliente hasta el proxy Nginx.
- El paquete llega al balanceador de carga L3. Para el enrutamiento correcto dentro del centro de datos, el paquete se encapsula en un túnel y se envía a la tarjeta de red.
- Dado que el paquete + encabezados del túnel no caben en el MTU, el paquete se fragmenta en partes y se envía a la red.
- El switch después del balanceador de carga L3, al recibir el paquete, le añade la etiqueta VLAN y lo envía más adelante.
- El switch antes del proxy Nginx ve (según la configuración del puerto) que el servidor espera un paquete encapsulado en Vlan, por lo que lo envía tal como está, sin quitar la etiqueta Vlan.
- Linux recibe fragmentos de paquetes individuales y los une en un solo paquete grande.
- Luego, el paquete llega a la interfaz Vlan, donde se elimina la primera capa: la encapsulación Vlan.
- Después, Linux lo envía a la interfaz Tunnel, donde se elimina otra capa: la encapsulación Tunnel.
La dificultad radica en transmitir todo esto como parámetros en tcpdump.
Comencemos por el final: ¿hay paquetes IP limpios (sin encabezados adicionales) de clientes, con la encapsulación de vlan y tunnel eliminada?
tcpdump host
No, no había tales paquetes en el servidor. Por lo tanto, el problema debe estar antes. ¿Hay paquetes con solo la encapsulación Vlan eliminada?
tcpdump ip[32:4]=0xx390x2xx
0xx390x2xx es la dirección IP del cliente en formato hex.
32:4 es la dirección y longitud del campo donde se registra el IP SCR en el paquete Tunnel.
Tuve que encontrar la dirección del campo por ensayo y error, ya que en Internet se habla de 40, 44, 50, 54, pero no había direcciones IP allí. También se puede observar uno de los paquetes en hex (el parámetro -xx o -XX en tcpdump) y contar desde qué dirección está la IP que conoces.
¿Hay fragmentos de paquetes sin la encapsulación Vlan y Tunnel eliminada?
tcpdump ((ip[6:2] > 0) y (no ip[6] = 64))
Esta magia nos mostrará todos los fragmentos, incluido el último. Probablemente también se puede filtrar por IP, pero no lo intenté, ya que no hay muchos de esos paquetes, y en el flujo general encontré fácilmente los que necesitaba. Aquí están:
14:02:58.471063 En 00:de:ff:1a:94:11 ethertype IPv4 (0x0800), longitud 1516: (tos 0x0, ttl 63, id 53652, desplazamiento 0, flags [+], proto IPIP (4), longitud 1500)
     11.11.11.11 > 22.22.22.22: ip truncado - ¡faltan 20 bytes! (tos 0x0, ttl 50, id 57750, desplazamiento 0, flags [DF], proto TCP (6), longitud 1500)
     33.33.33.33.33333 > 44.44.44.44.80: Flags [.] , sec 0:1448, ack 1, win 343, opciones [nop,nop,TS val 11660691 ecr 2998165860], longitud 1448
         0x0000: 0000 0001 0006 00de fb1a 9441 0000 0800 ...........A....
         0x0010: 4500 05dc d194 2000 3f09 d5fb 0a66 387d E.......?....f8}
         0x0020: 1x67 7899 4500 06xx e198 4000 3206 6xx4 .faEE.....@.2.m.
         0x0030: b291 x9xx x345 2541 83b9 0050 9740 0x04 .......A...P.@..
         0x0040: 6444 4939 8010 0257 8c3c 0000 0101 080x dDI9...W.......
         0x0050: 00b1 ed93 b2b4 6964 xxd8 ffe1 006a 4578 ......ad.....jEx
         0x0060: 6966 0000 4x4d 002a 0500 0008 0004 0100 if..MM.*........
14:02:58.471103 En 00:de:ff:1a:94:11 ethertype IPv4 (0x0800), longitud 62: (tos 0x0, ttl 63, id 53652, offset 1480, flags [none], proto IPIP (4), longitud 40)
11.11.11.11 > 22.22.22.22: ip-proto-4
0x0000: 0000 0001 0006 00de fb1a 9441 0000 0800 ...........A....
0x0010: 4500 0028 d194 00b9 3f04 faf6 2x76 385x E..(....?....f8}
0x0020: 1x76 6545 xxxx 1x11 2d2c 0c21 8016 8e43 .faE...D-,.!...C
0x0030: x978 e91d x9b0 d608 0000 0000 0000 7c31 .x............|Q
0x0040: 881d c4b6 0000 0000 0000 0000 0000 ..............
Estos son dos fragmentos de un solo paquete (ID 53652 idéntico) con una fotografía (se ve la palabra Exif en el primer paquete). Debido a que a este nivel hay paquetes, mientras que en la forma unida en los volcado no hay, el problema está claramente en la unión. ¡Finalmente, esto tiene confirmación documental!
El decodificador de paquetes no encontró ningún problema que impidiera la unión. Probé aquí: Al principio, al intentar meter algo ahí, al decodificador no le gustaba el formato del paquete. Resultó que había dos octetos adicionales entre Srcmac y Ethertype (que no estaban relacionados con la información de fragmentos). Después de eliminarlos, el decodificador funcionó. Sin embargo, no mostró ningún problema.
Por mucho que se busque, no se encontró nada más que esos Sysctl. Quedaba encontrar una manera de identificar los servidores problemáticos, para entender la magnitud y tomar decisiones sobre las acciones a seguir. Rápidamente se encontró el contador necesario:
netstat -s | grep "packet reassembles failed"
También está en snmpd bajo OID=1.3.6.1.2.1.4.31.1.1.16.1 ().
«El número de fallos detectados por el algoritmo de reensamblaje IP (por cualquier motivo: tiempo de espera, errores, etc.).»
Entre el grupo de servidores donde se estudiaba el problema, en dos este contador aumentaba más rápido, en dos más lento, y en dos no aumentaba en absoluto. La comparación de la dinámica de este contador con la dinámica de errores HTTP en el servidor Java reveló una correlación. Es decir, el contador se podía poner bajo monitoreo.
La existencia de un indicador fiable de problemas es muy importante para poder determinar con precisión si el retroceso de Sysctl ayuda, ya que, como sabemos de la historia anterior, esto no se puede entender de inmediato a través de la aplicación. Este indicador permitiría identificar todos los puntos problemáticos en producción antes de que los usuarios lo descubrieran.
Después del retroceso de Sysctl, los errores en la monitorización cesaron, así que la causa de los problemas quedó probada, al igual que que el retroceso ayuda.
Retrocedimos la configuración de fragmentación en otros servidores, donde se encendió un nuevo monitoreo, y en algunos se asignó incluso más memoria a los fragmentos de la que había por defecto antes (se trataba de estadísticas udp, cuya pérdida parcial no era evidente en el contexto general).
Las preguntas más importantes
¿Por qué se fragmentan los paquetes en nuestro equilibrador L3? La mayoría de los paquetes que llegan de los usuarios a los equilibradores son SYN y ACK. El tamaño de estos paquetes es pequeño. Pero dado que la proporción de tales paquetes es muy alta, no notamos la existencia de paquetes más grandes que comenzaron a fragmentarse.
La causa fue un script de configuración roto en servidores con interfaces Vlan (en ese momento había muy pocos servidores con tráfico etiquetado en producción). Advmss permite comunicar al cliente que los paquetes que vienen hacia nosotros deben ser de menor tamaño, para que después de añadirles las cabeceras del túnel no sea necesario fragmentarlos.
¿Por qué el reinicio de Sysctl no ayudaba, mientras que un reinicio sí? El reinicio de Sysctl cambiaba la cantidad de memoria disponible para la unión de paquetes. Al mismo tiempo, al parecer, el mero hecho de desbordar la memoria destinada a los fragmentos provocaba una ralentización de las conexiones, lo que resultaba en que los fragmentos se quedaban atascados en la cola durante mucho tiempo. Es decir, el proceso se atascaba.
El reinicio restablecía la memoria y todo volvía a la normalidad.
¿Podría haberse evitado el Workaround? Sí, pero existía un gran riesgo de dejar a los usuarios sin servicio en caso de un ataque. Por supuesto, la aplicación del Workaround llevó a la aparición de varios problemas, incluido el retraso en uno de los servicios para los usuarios, pero aun así creemos que las acciones estaban justificadas.
Muchas gracias a Andrey Timofeyev () por su ayuda en la investigación, así como a Alexey Krenev () — por el titánico trabajo en la actualización de Centos y las kernels en los servidores. Un proceso que en este caso tuvo que comenzar varias veces desde el principio, lo que lo prolongó durante muchos meses.
Fuente: habr.com
