

Los Filtros de Paquetes de Berkeley (BPF) son una tecnología del núcleo de Linux que ha estado en las portadas de las publicaciones técnicas en inglés durante varios años. Las conferencias están llenas de presentaciones sobre el uso y desarrollo de BPF. David Miller, mantenedor del subsistema de red de Linux, titula su presentación en Linux Plumbers 2018 (XDP es una de las variantes de uso de BPF). Brendan Gregg presenta charlas tituladas . Toke Høiland-Jørgensen , diciendo que el núcleo ahora es un microkernel. Thomas Graf promociona la idea de que .
Todavía no hay una descripción sistemática de BPF en Habr, por lo que en esta serie de artículos trataré de relatar la historia de la tecnología, describir la arquitectura y las herramientas de desarrollo, delinear las áreas de aplicación y las prácticas de uso de BPF. En este artículo cero de la serie se cuenta la historia y la arquitectura del BPF clásico, así como se revelan los misterios de los principios de funcionamiento tcpdump, seccomp, strace, y mucho más.
El desarrollo de BPF está controlado por la comunidad de Linux, y las aplicaciones existentes de BPF están relacionadas principalmente con redes, por lo que, con el permiso de , nombré la serie "BPF para los más pequeños" en honor a la famosa serie .
Un breve curso de historia de BPF (c)
La moderna tecnología BPF es una versión mejorada y ampliada de la antigua tecnología con el mismo nombre, que hoy en día se llama, para evitar confusiones, BPF clásico. Basado en BPF clásico, se creó la famosa utilidad tcpdump, el mecanismo seccomp, así como el menos conocido módulo xt_bpf para iptables y el clasificador cls_bpf. En el Linux moderno, los programas BPF clásicos se traducen automáticamente a una nueva forma, sin embargo, desde el punto de vista del usuario, la API se ha mantenido y las nuevas aplicaciones de BPF clásico, como veremos en este artículo, todavía existen. Por esta razón, así como porque seguir la historia del desarrollo del BPF clásico en Linux aclarará cómo y por qué ha evolucionado a su forma moderna, decidí comenzar precisamente con un artículo sobre el BPF clásico.
A finales de los años ochenta, ingenieros del famoso Lawrence Berkeley Laboratory se interesaron en cómo filtrar correctamente los paquetes de red en el hardware moderno de esa época. La idea básica de filtrado, implementada originalmente en la tecnología CSPF (CMU/Stanford Packet Filter), consistía en filtrar los paquetes innecesarios lo antes posible, es decir, en el espacio del núcleo, ya que esto permite evitar la copia de datos innecesarios al espacio de usuario. Para garantizar la seguridad en la ejecución del código de usuario en el espacio del núcleo, se utilizó una máquina virtual — un entorno seguro.
Sin embargo, las máquinas virtuales para los filtros existentes estaban diseñadas para funcionar en máquinas con arquitectura de pila y no eran tan eficientes en las nuevas máquinas RISC. Como resultado, los ingenieros de Berkeley Labs desarrollaron una nueva tecnología llamada BPF (Berkeley Packet Filters), cuya arquitectura de máquina virtual fue diseñada en base al procesador Motorola 6502, que era la base de productos tan conocidos como o . La nueva máquina virtual aumentó el rendimiento de los filtros decenas de veces en comparación con las soluciones existentes.
Arquitectura de la máquina BPF
Vamos a conocer la arquitectura en detalle, analizando ejemplos. Sin embargo, para comenzar, digamos que la máquina tenía dos registros de 32 bits disponibles para el usuario: un acumulador A y un registro índice X, 64 bytes de memoria (16 palabras) disponibles para lectura y escritura, y un pequeño conjunto de instrucciones para trabajar con estos objetos. En los programas, también había instrucciones de salto para implementar expresiones condicionales, sin embargo, para garantizar la finalización oportuna del trabajo del programa, los saltos solo podían hacerse hacia adelante, es decir, en particular, crear ciclos estaba prohibido.
El esquema general de funcionamiento de la máquina es el siguiente. El usuario crea un programa para la arquitectura BPF y, a través de algún mecanismo del núcleo (por ejemplo, una llamada al sistema), carga y conecta el programa a algún generador de eventos en el núcleo (por ejemplo, un evento es la llegada de un nuevo paquete a la tarjeta de red). Cuando se produce un evento, el núcleo activa el programa (por ejemplo, en el intérprete), y la memoria de la máquina corresponde algún región de memoria del núcleo (por ejemplo, los datos del paquete recibido).
Lo anterior será suficiente para que comencemos a desglosar ejemplos: nos familiarizaremos con el sistema y el formato de los comandos según sea necesario. Si desea estudiar de inmediato el sistema de comandos de la máquina virtual y conocer todas sus posibilidades, puede leer el artículo original. y/o la primera mitad del archivo de la documentación del núcleo. Además, puede estudiar la presentación , en la que McCanne, uno de los autores de BPF, habla sobre la historia de su creación. libpcap.
Pasemos a revisar todos los ejemplos significativos de la aplicación del BPF clásico en Linux: tcpdump (libpcap), seccomp, xt_bpf, cls_bpf.
tcpdump
El desarrollo de BPF se realizó en paralelo con el desarrollo del frontend para la filtración de paquetes: la conocida utilidad tcpdump. Y, dado que este es el ejemplo más antiguo y conocido del uso del BPF clásico, disponible en muchos sistemas operativos, comenzaremos nuestro estudio de la tecnología con él.
(Todos los ejemplos en este artículo los ejecuté en Linux 5.6.0-rc6. La salida de algunos comandos ha sido editada para mayor legibilidad.)
Ejemplo: observamos paquetes IPv6
Supongamos que queremos observar todos los paquetes IPv6 en la interfaz eth0. Para esto, podemos ejecutar el programa tcpdump con un filtro simple ip6:
$ sudo tcpdump -i eth0 ip6Al mismo tiempo tcpdump compilará el filtro ip6 en código de bytes para la arquitectura BPF y lo enviará al núcleo (ver detalles en la sección ). El filtro cargado se ejecutará para cada paquete que pase a través de la interfaz eth0. Si el filtro devuelve un valor distinto de cero n, entonces hasta n bytes del paquete se copiarán al espacio del usuario y lo veremos en la salida. tcpdump.
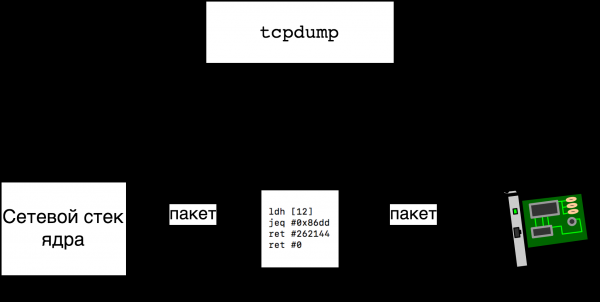
De hecho, podemos fácilmente averiguar qué código de bytes se envió al núcleo tcpdump mediante el propio tcpdump, si lo ejecutamos con la opción -d:
$ sudo tcpdump -i eth0 -d ip6
(000) ldh      [12]
(001) jeq      #0x86dd          jt 2    jf 3
(002) ret      #262144
(003) ret      #0
En la línea cero estamos ejecutando el comando ldh [12], que se traduce como 'cargar en el registro A media palabra (16 bits), ubicada en la dirección 12' y la única pregunta es: ¿qué memoria estamos direccionando? La respuesta es que en la dirección x comienza (x+1)-byte del paquete de red que se está analizando. Leemos paquetes desde la interfaz Ethernet eth0, lo que significa , que el paquete se ve de la siguiente manera (para simplificar, asumimos que no hay etiquetas VLAN en el paquete):
       6              6          2
|Destino MAC|Fuente MAC|Tipo Ether|...|
Entonces, después de ejecutar el comando ldh [12] en el registro A habrá un campo Tipo Ether — el tipo de paquete transmitido en este marco Ethernet. En la línea 1 comparamos el contenido del registro A (tipo de paquete) con 0x86dd, lo que significa el tipo que nos interesa: IPv6. En la línea 1 además del comando de comparación hay otras dos columnas — jt 2 y jf 3 — etiquetas a las que se debe saltar en caso de que la comparación tenga éxito (A == 0x86dd) y en caso de que falle. Entonces, en caso de éxito (IPv6) pasamos a la línea 2, y en caso de fallo — a la línea 3. En la línea 3 el programa termina con código 0 (no copiar el paquete), en la línea 2 el programa termina con código 262144 (copia máximo 256 kilobytes del paquete).
Ejemplo un poco más complicado: observamos paquetes TCP por el puerto de destino
Veamos cómo se ve el filtro que copia todos los paquetes TCP con puerto de destino 666. Consideraremos el caso IPv4, ya que el caso IPv6 es más sencillo. Después de estudiar este ejemplo, puedes como ejercicio estudiar por tu cuenta el filtro para IPv6 (ip6 and tcp dst port 666) y el filtro para el caso general (tcp dst port 666). Así que, el filtro que nos interesa se ve de la siguiente manera:
$ sudo tcpdump -i eth0 -d ip and tcp dst port 666
(000) ldh      [12]
(001) jeq      #0x800           jt 2    jf 10
(002) ldb      [23]
(003) jeq      #0x6             jt 4    jf 10
(004) ldh      [20]
(005) jset     #0x1fff          jt 10   jf 6
(006) ldxb     4*([14]&0xf)
(007) ldh      [x + 16]
(008) jeq      #0x29a           jt 9    jf 10
(009) ret      #262144
(010) ret      #0
Lo que hacen las líneas 0 y 1 ya lo sabemos. En la línea 2 ya verificamos que se trata de un paquete IPv4 (Tipo Ether = 0x800) y cargamos en el registro A el byte 24 del paquete. Nuestro paquete se ve como
       14            8      1     1
|encabezado ethernet|campos ip|ttl|protocolo|...|
es decir, cargamos en el registro A el campo Protocolo del encabezado IP, lo cual es lógico, ya que queremos copiar solo paquetes TCP. Comparamos el Protocolo con 0x6 () en la línea 3.
En las líneas 4 y 5 cargamos palabra media que está en la dirección 20, y con el comando jset comprobamos si uno de los tres — en la máscara emitida, han sido limpiados los tres bits más altos. Dos de los tres bits nos indican si el paquete es parte de un paquete IP fragmentado, y si es así, si es el último fragmento. El tercer bit está reservado y debe ser igual a cero. No queremos verificar paquetes que no están completos o que están dañados, así que revisamos los tres bits. jset se limpian los tres bits más significativos. Dos de los tres bits nos dicen si el paquete es parte de un paquete IP fragmentado, y si es así, si es el último fragmento. El tercer bit está reservado y debe ser igual a cero. No queremos verificar paquetes ni dañados, por lo que comprobamos los tres bits.
La línea 6 es la más interesante de este listado. La expresión ldxb 4*([14]&0xf) significa que estamos cargando en el registro X los cuatro bits menos significativos del quincuagésimo byte del paquete, multiplicados por 4. Los cuatro bits menos significativos del quincuagésimo byte son el campo del encabezado IPv4, donde se almacena la longitud del encabezado en palabras, por lo que luego hay que multiplicar por 4. Curiosamente, la expresión 4*([14]&0xf) es una designación de un esquema de direccionamiento especial que solo se puede usar de esta forma y únicamente para el registro X, es decir, no podemos decir ni ldb 4*([14]&0xf) ni ldxb 5*([14]&0xf) (solo podemos indicar otro offset, como por ejemplo, ldxb 4*([16]&0xf)). Es evidente que este esquema de direccionamiento se añadió en BPF precisamente para obtener en X (el registro índice) la longitud del encabezado IPv4.
Por lo tanto, en la línea 7 intentamos cargar media palabra en la dirección (X+16). Recordando que 14 bytes corresponde al encabezado de Ethernet, y X contiene la longitud del encabezado IPv4, entendemos que en A se carga el puerto de destino TCP:
       14           X           2             2
|encabezado ethernet|encabezado IP|puerto de origen|puerto de destino|
Finalmente, en la línea 8 comparamos el puerto de destino con el valor buscado y en las líneas 9 o 10 devolvemos el resultado: copiar el paquete o no.
Tcpdump: carga
En los ejemplos anteriores, intencionadamente no nos detuvimos a detallar cómo cargamos el bytecode BPF en el núcleo para la filtración de paquetes. En general, tcpdump se ha portado a muchos sistemas y para trabajar con filtros utiliza la biblioteca . En breve, para asignar un filtro a la interfaz mediante libpcap, hay que hacer lo siguiente:
- crear un descriptor del tipo
pcap_tdel nombre de la interfaz: , - activar la interfaz: ,
- compilar el filtro: ,
- conectar el filtro: .
Para ver cómo está implementada la función pcap_setfilter en Linux, utilizamos strace (se han eliminado algunas líneas):
$ sudo strace -f -e trace=%network tcpdump -p -i eth0 ip
socket(AF_PACKET, SOCK_RAW, 768)        = 3
bind(3, {sa_family=AF_PACKET, sll_protocol=htons(ETH_P_ALL), sll_ifindex=if_nametoindex("eth0"), sll_hatype=ARPHRD_NETROM, sll_pkttype=PACKET_HOST, sll_halen=0}, 20) = 0
setsockopt(3, SOL_SOCKET, SO_ATTACH_FILTER, {len=4, filter=0xb00bb00bb00b}, 16) = 0
...
En las dos primeras líneas de salida, creamos para leer todos los tramas Ethernet y lo vinculamos a la interfaz eth0. De sabemos que el filtro ip constará de cuatro instrucciones BPF, y en la tercera línea vemos cómo mediante la opción de la llamada al sistema setsockopt Cargamos y conectamos un filtro de longitud 4. Ese es nuestro filtro.
Cabe destacar que en BPF clásico, la carga y conexión del filtro siempre ocurre como una operación atómica, mientras que en la nueva versión de BPF, la carga del programa y su vínculo al generador de eventos están separados temporalmente.
La verdad oculta
Una versión un poco más completa de la salida es la siguiente:
$ sudo strace -f -e trace=%network tcpdump -p -i eth0 ip
socket(AF_PACKET, SOCK_RAW, 768)        = 3
bind(3, {sa_family=AF_PACKET, sll_protocol=htons(ETH_P_ALL), sll_ifindex=if_nametoindex("eth0"), sll_hatype=ARPHRD_NETROM, sll_pkttype=PACKET_HOST, sll_halen=0}, 20) = 0
setsockopt(3, SOL_SOCKET, SO_ATTACH_FILTER, {len=1, filter=0xbeefbeefbeef}, 16) = 0
recvfrom(3, 0x7ffcad394257, 1, MSG_TRUNC, NULL, NULL) = -1 EAGAIN (Recurso temporalmente no disponible)
setsockopt(3, SOL_SOCKET, SO_ATTACH_FILTER, {len=4, filter=0xb00bb00bb00b}, 16) = 0
...
Como se mencionó anteriormente, cargamos y conectamos nuestro filtro al socket en la línea 5, pero ¿qué ocurre en las líneas 3 y 4? Resulta que eso libpcap se encarga de nosotros — para que los paquetes que no satisfacen a nuestro filtro no se incluyan en la salida, la biblioteca un filtro ficticio ret #0 (descartar todos los paquetes), pone el socket en modo no bloqueante y trata de leer todos los paquetes que pudieron quedar de los filtros anteriores.
En resumen, para filtrar paquetes en Linux usando BPF clásico, es necesario tener un filtro en forma de estructura del tipo struct sock_fprog y un socket abierto, después de lo cual el filtro se puede adjuntar al socket mediante una llamada al sistema. setsockopt.
Es interesante que el filtro se puede conectar a cualquier socket, no solo a raw. Aquí está un programa que corta todo menos los dos primeros bytes de todos los datagramas UDP entrantes. (He añadido comentarios en el código para no sobrecargar el artículo).
Más información sobre el uso setsockopt para conectar filtros se puede encontrar en , y sobre cómo escribir nuestros propios filtros del tipo struct sock_fprog sin ayuda tcpdump hablaremos en la sección .
BPF clásico y el siglo XXI
BPF se incluyó en Linux en 1997 y durante mucho tiempo fue un caballo de batalla libpcap sin cambios significativos (cambios específicos de Linux, por supuesto, , pero no alteraron el panorama global). Los primeros signos serios de que BPF evolucionaría aparecieron en 2011, cuando Eric Dumazet propuso , añadiendo al núcleo un compilador Just In Time — un traductor para convertir bytecode de BPF a código nativo. x86_64 El compilador JIT fue el primero en la cadena de cambios: en 2012
la posibilidad de escribir filtros para , utilizando BPF, en enero de 2013 fue , utilizando BPF, en enero de 2013 se produjo módulo xt_bpf, que permite escribir reglas para iptables con BPF, y en octubre de 2013 se agregó también un módulo cls_bpf, que permite escribir clasificadores de tráfico usando BPF.
Pronto revisaremos todos estos ejemplos más a fondo, pero primero será útil aprender a escribir y compilar programas arbitrarios para BPF, ya que las capacidades que proporciona la biblioteca libpcap son limitadas (un ejemplo sencillo: un filtro generado libpcap puede devolver solo dos valores: 0 o 0x40000) o en algunos casos, como en el seccomp, no aplicables en absoluto.
Programando BPF con nuestras propias manos
Conozcamos el formato binario de las instrucciones BPF, es muy simple:
   16    8    8     32
| código | jt | jf |  k  |
Cada instrucción ocupa 64 bits, donde los primeros 16 bits son el código de la instrucción, seguidos de dos desplazamientos de ocho bits, jt y jf, y 32 bits para el argumento K, cuyo propósito varía de una instrucción a otra. Por ejemplo, la instrucción ret, que termina la ejecución del programa, tiene un código 6, y el valor devuelto proviene de una constante K. En lenguaje C, una instrucción BPF se presenta como una estructura
struct sock_filter {
        __u16   code;
        __u8    jt;
        __u8    jf;
        __u32   k;
}
y un programa completo como una estructura
struct sock_fprog {
        unsigned short len;
        struct sock_filter *filter;
}
Así, ya podemos escribir programas (los códigos de instrucciones los conocimos de ). Así se verá el filtro ip6 de :
struct sock_filter code[] = {
        { 0x28, 0, 0, 0x0000000c },
        { 0x15, 0, 1, 0x000086dd },
        { 0x06, 0, 0, 0x00040000 },
        { 0x06, 0, 0, 0x00000000 },
};
struct sock_fprog prog = {
        .len = ARRAY_SIZE(code),
        .filter = code,
};
El programa prog podemos usarlo legalmente en la llamada
setsockopt(sk, SOL_SOCKET, SO_ATTACH_FILTER, &prog, sizeof(prog))Escribir programas en forma de códigos de máquina no es muy conveniente, pero a veces es necesario (por ejemplo, para depuración, creación de pruebas unitarias, redacción de artículos en Habr, etc.). Para mayor comodidad en el archivo <linux/filter.h> se definen macros de ayuda; el mismo ejemplo anterior se podría reescribir como
struct sock_filter code[] = {
        BPF_STMT(BPF_LD|BPF_H|BPF_ABS, 12),
        BPF_JUMP(BPF_JMP|BPF_JEQ|BPF_K, ETH_P_IPV6, 0, 1),
        BPF_STMT(BPF_RET|BPF_K, 0x00040000),
        BPF_STMT(BPF_RET|BPF_K, 0),
}
Sin embargo, incluso esta opción no es muy conveniente. Así pensaron también los programadores del núcleo de Linux, y por eso en el directorio del núcleo se pueden encontrar un ensamblador y un depurador para trabajar con BPF clásico.
El lenguaje ensamblador es muy similar a la salida de depuración tcpdump, pero además podemos especificar etiquetas simbólicas. Por ejemplo, aquí hay un programa que elimina todos los paquetes excepto TCP/IPv4:
$ cat /tmp/tcp-over-ipv4.bpf
ldh [12]
jne #0x800, drop
ldb [23]
jneq #6, drop
ret #-1
drop: ret #0
Por defecto, el ensamblador genera código en formato , ,..., para nuestro ejemplo con TCP resultará
$ tools/bpf/bpf_asm /tmp/tcp-over-ipv4.bpf
6,40 0 0 12,21 0 3 2048,48 0 0 23,21 0 1 6,6 0 0 4294967295,6 0 0 0,
Para la comodidad de los programadores en C, se puede utilizar otro formato de salida:
$ tools/bpf/bpf_asm -c /tmp/tcp-over-ipv4.bpf
{ 0x28,  0,  0, 0x0000000c },
{ 0x15,  0,  3, 0x00000800 },
{ 0x30,  0,  0, 0x00000017 },
{ 0x15,  0,  1, 0x00000006 },
{ 0x06,  0,  0, 0xffffffff },
{ 0x06,  0,  0, 0000000000 },
Este texto se puede copiar en la definición de la estructura tipo struct sock_filter, como hicimos al inicio de esta sección.
Extensiones de Linux y netsniff-ng
Además de las instrucciones estándar de BPF, Linux y tools/bpf/bpf_asm también soportan . Principalmente, las instrucciones sirven para acceder a los campos de la estructura struct sk_buff, que describe un paquete de red en el núcleo. Sin embargo, hay instrucciones de ayuda de otro tipo, por ejemplo ldw cpu cargará en el registro A el resultado de la ejecución de la función del núcleo raw_smp_processor_id(). (En la nueva versión de BPF, estas extensiones no estándar se ampliaron proporcionando a los programas un conjunto de kernel helpers para acceder a la memoria, estructuras y generar eventos). Aquí hay un ejemplo interesante de un filtro, en el que copiamos en el espacio del usuario solo los encabezados de los paquetes, utilizando la extensión poff, offset de la carga útil:
ld poff
ret a
Las extensiones de BPF no se podrán usar en tcpdump, pero es una buena oportunidad para conocer el paquete de utilidades , que, entre otros, contiene un programa avanzado netsniff-ng, que, además de filtrar utilizando BPF, también incluye un generador de tráfico eficiente, y un ensamblador BPF más avanzado llamado tools/bpf/bpf_asmbpfc . El paquete contiene documentación bastante detallada, consulte también los enlaces al final del artículo.Así que ya sabemos cómo escribir programas BPF de complejidad arbitraria y estamos listos para ver nuevos ejemplos, el primero de los cuales es la tecnología seccomp, que permite, mediante filtros BPF, controlar muchos y un conjunto de argumentos de las llamadas al sistema disponibles para este proceso y sus descendientes.
seccomp
La primera versión de seccomp se agregó al núcleo en 2005 y no tuvo mucha popularidad, ya que solo proporcionaba una única posibilidad: restringir el conjunto de llamadas al sistema disponibles para el proceso a lo siguiente:
sigreturn read, write, exit y , y el proceso que violaba las reglas era terminado mediante, y el proceso que violaba las reglas era eliminado con SIGKILL. Sin embargo, en 2012 se añadió a seccomp la capacidad de utilizar filtros BPF, que permiten definir un gran número de llamadas al sistema permitidas e incluso realizar comprobaciones sobre sus argumentos. (Curiosamente, uno de los primeros usuarios de esta funcionalidad fue Chrome, y en este momento las personas de Chrome están desarrollando el mecanismo KRSI, basado en una nueva versión de BPF y que permite personalizar los Módulos de Seguridad de Linux). Los enlaces a la documentación adicional se pueden encontrar al final del artículo.
Cabe destacar que ya ha habido artículos en Habr sobre el uso de seccomp, podría interesarle leerlos antes (o en lugar de) los siguientes subapartados. En el artículo se presentan ejemplos de uso de seccomp, tanto de la versión de 2007 como de la versión con BPF (los filtros se generan con libseccomp), se habla sobre la relación de seccomp con Docker, así como se proporcionan muchos enlaces útiles. En el artículo se explica, en particular, cómo agregar listas negras o blancas de llamadas al sistema para los demonios bajo el control de systemd.
A continuación, veremos cómo escribir y cargar filtros para seccomp en C puro y usando la biblioteca libseccomp y cuáles son las ventajas y desventajas de cada opción, y al final veremos cómo seccomp es utilizado por el programa strace.
Escribiendo y cargando filtros para seccomp
Ya sabemos cómo escribir programas BPF y por lo tanto primero veremos la interfaz del programa de seccomp. Se puede establecer un filtro a nivel de proceso, de este modo todos los procesos secundarios heredarán las restricciones. Esto se hace mediante la llamada al sistema :
seccomp(SECCOMP_SET_MODE_FILTER, flags, &filter)donde &filter — es un puntero a la estructura que ya conocemos struct sock_fprog, es decir, un programa BPF.
¿En qué se diferencian los programas para seccomp de los programas para sockets? En el contexto que se pasa. En el caso de los sockets, se nos pasaba una región de memoria que contenía un paquete, mientras que en el caso de seccomp se nos pasa una estructura del tipo
struct seccomp_data {
    int   nr;
    __u32 arch;
    __u64 instruction_pointer;
    __u64 args[6];
};
Aquí nr — es el número de la llamada al sistema que se está ejecutando, arch — la arquitectura actual (sobre esto más adelante), args — hasta seis argumentos de la llamada al sistema, y instruction_pointer — es un puntero a una instrucción en el espacio de usuario que hizo esta llamada al sistema. Así, por ejemplo, para cargar el número de la llamada al sistema en el registro A debemos decir
ldw [0]Para los programas seccomp, hay otras características, como que el acceso al contexto solo es posible con un alineamiento de 32 bits y no se pueden cargar medio palabra o byte; al intentar cargar el filtro ldh [0] la llamada al sistema seccomp devolverá EINVAL. La función que lleva a cabo la verificación de los filtros cargados es del núcleo. (De manera curiosa, en el commit original que añadía la funcionalidad seccomp, se olvidaron de incluir el permiso para usar la instrucción mod (módulo) y ahora no está disponible para los programas BPF de seccomp, ya que su inclusión ABI.)
En principio, ya sabemos todo lo necesario para escribir y leer programas seccomp. Generalmente, la lógica del programa se organiza como una lista blanca o negra de llamadas al sistema, por ejemplo, el programa
ld [0]
jeq #304, bad
jeq #176, bad
jeq #239, bad
jeq #279, bad
good: ret #0x7fff0000 /* SECCOMP_RET_ALLOW */
bad: ret #0
verifica una lista negra de cuatro llamadas al sistema con los números 304, 176, 239, 279. ¿Qué llamadas al sistema son estas? No podemos decirlo con certeza, ya que no sabemos para qué arquitectura se escribió el programa. Por lo tanto, los autores de seccomp comienzan todos los programas con la verificación de la arquitectura (la arquitectura actual se indica en el contexto como un campo arch de la estructura struct seccomp_data). Con la verificación de la arquitectura, el inicio del ejemplo se vería como:
ld [4]
jne #0xc000003e, bad_arch ; SCMP_ARCH_X86_64
y entonces nuestros números de llamadas al sistema tendrían valores específicos.
Escribimos y cargamos filtros para seccomp usando libseccomp
Escribir filtros en código máquina o para ensamblador BPF permite tener control total sobre el resultado, pero a veces es preferible tener un código portátil y/o legible. En esto nos ayudará la biblioteca , que proporciona una interfaz estándar para escribir filtros negros o blancos.
Tomemos, por ejemplo, un programa que ejecuta un archivo binario según la elección del usuario, estableciendo, previamente, una lista negra de llamadas al sistema de (el programa se simplifica para mayor legibilidad, la versión completa puede encontrarse ):
#include <seccomp.h>
#include <unistd.h>
#include <err.h>

static int sys_numbers[] = {
        __NR_mount,
        __NR_umount2,
       // ... еще 40 системных вызовов ...
        __NR_vmsplice,
        __NR_perf_event_open,
};

int main(int argc, char **argv)
{
        scmp_filter_ctx ctx = seccomp_init(SCMP_ACT_ALLOW);

        for (size_t i = 0; i < sizeof(sys_numbers)/sizeof(sys_numbers[0]); i++)
                seccomp_rule_add(ctx, SCMP_ACT_TRAP, sys_numbers[i], 0);

        seccomp_load(ctx);

        execvp(argv[1], &argv[1]);
        err(1, "execlp: %s", argv[1]);
}
Al principio, definimos un arreglo sys_numbers de más de 40 llamadas del sistema para bloquear. Luego, inicializamos el contexto ctx y le decimos a la biblioteca que queremos permitir (SCMP_ACT_ALLOW) todas las llamadas del sistema por defecto (es más fácil construir listas negras). Luego, una por una, añadimos todas las llamadas del sistema de la lista negra. En respuesta a una llamada del sistema de la lista, solicitamos SCMP_ACT_TRAP, en este caso, seccomp enviará una señal al proceso SIGSYS con una descripción de cuál llamada del sistema ha violado las reglas. Finalmente, cargamos el programa en el núcleo utilizando seccomp_load, que compilará el programa y lo conectará al proceso mediante la llamada del sistema seccomp(2).
Para una compilación exitosa, el programa debe vincularse con la biblioteca libseccomp, por ejemplo:
cc -std=c17 -Wall -Wextra -c -o seccomp_lib.o seccomp_lib.c
cc -o seccomp_lib seccomp_lib.o -lseccomp
Ejemplo de ejecución exitosa:
$ ./seccomp_lib echo ok
ok
Ejemplo de llamada del sistema bloqueada:
$ sudo ./seccomp_lib mount -t bpf bpf /tmp
Bad system call
Usamos strace, para conocer los detalles:
$ sudo strace -e seccomp ./seccomp_lib mount -t bpf bpf /tmp
seccomp(SECCOMP_SET_MODE_FILTER, 0, {len=50, filter=0x55d8e78428e0}) = 0
--- SIGSYS {si_signo=SIGSYS, si_code=SYS_SECCOMP, si_call_addr=0xboobdeadbeef, si_syscall=__NR_mount, si_arch=AUDIT_ARCH_X86_64} ---
+++ killed by SIGSYS (core dumped) +++
Bad system call
de donde podemos saber que el programa fue terminado debido al uso de una llamada del sistema prohibida mount(2).
En resumen, hemos escrito un filtro utilizando la biblioteca libseccomp, encajando código no trivial en cuatro líneas. En el ejemplo anterior, con un gran número de llamadas del sistema, el tiempo de ejecución puede disminuir notablemente, ya que la verificación es simplemente una lista de comparaciones. Para optimizar, recientemente se incluyó un parche en libseccomp SCMP_FLTATR_CTL_OPTIMIZE . Si se establece este atributo en 2, el filtro se transformará en un programa de búsqueda binaria.Si desea ver cómo funcionan los filtros de búsqueda binaria, eche un vistazo a
un script simple $ echo 1 3 6 8 13 | ./generate_bin_search_bpf.py ld [0] jeq #6, bad jgt #6, check8 jeq #1, bad jeq #3, bad ret #0x7fff0000 check8: jeq #8, bad jeq #13, bad ret #0x7fff0000 bad: ret #0
No hay nada significativamente más rápido que escribir, ya que los programas BPF no pueden hacer saltos por desplazamiento (no podemos hacer, por ejemplo,jmp A jmp [label+X] o ) y por lo tanto todos los saltos son estáticos.seccomp y strace
Todos conocen la utilidad
Todos conocen la utilidad strace una herramienta indispensable para investigar el comportamiento de procesos en Linux. Sin embargo, muchos también han oído hablar de al utilizar esta utilidad. El hecho es que strace se implementa mediante ptrace(2), y en este mecanismo no podemos especificar en qué conjunto particular de llamadas al sistema necesitamos detener el proceso, es decir, por ejemplo, los comandos
$ time strace du /usr/share/ >/dev/null 2>&1

real    0m3.081s
user    0m0.531s
sys     0m2.073s
y
$ time strace -e open du /usr/share/ >/dev/null 2>&1

real    0m2.404s
user    0m0.193s
sys     0m1.800s
se ejecutan en aproximadamente el mismo tiempo, aunque en el segundo caso queremos rastrear solo una llamada al sistema.
La nueva opción --seccomp-bpf, añadida en strace la versión 5.3, permite acelerar el proceso múltiples veces y el tiempo de inicio bajo el rastreo de una sola llamada al sistema ya es comparable con el tiempo de un inicio normal:
$ time strace --seccomp-bpf -e open du /usr/share/ >/dev/null 2>&1

real    0m0.148s
user    0m0.017s
sys     0m0.131s

$ time du /usr/share/ >/dev/null 2>&1

real    0m0.140s
user    0m0.024s
sys     0m0.116s
(Aquí, por supuesto, hay un pequeño engaño en que no estamos rastreando la llamada al sistema principal de este comando. Si estuviéramos rastreando, por ejemplo, newfsstat, entonces strace tendría el mismo retraso que sin --seccomp-bpf.)
¿Cómo funciona esta opción? Sin ella strace se conecta al proceso y lo inicia mediante PTRACE_SYSCALL. Cuando el proceso controlado ejecuta (cualquier) llamada al sistema, el control se transfiere strace, que mira los argumentos de la llamada al sistema y la ejecuta mediante PTRACE_SYSCALL. Después de un tiempo, el proceso finaliza la llamada al sistema y al salir de ella, el control se transfiere de nuevo strace, que observa los valores de retorno y ejecuta el proceso mediante PTRACE_SYSCALL, etc.
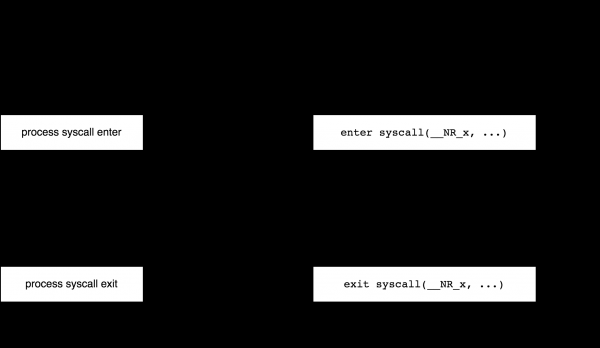
Sin embargo, mediante seccomp, este proceso se puede optimizar exactamente como nos gustaría. Específicamente, si queremos observar solo la llamada al sistema X, podemos escribir un filtro BPF, que para X devuelve el valor SECCOMP_RET_TRACE, y para las llamadas que no nos interesan — SECCOMP_RET_ALLOW:
ld [0]
jneq #X, ignore
trace: ret #0x7ff00000
ignore: ret #0x7fff0000
En este caso strace inicialmente se lanza el proceso como PTRACE_CONT, para cada llamada al sistema se ejecuta nuestro filtro; si la llamada al sistema no es X, el proceso continúa funcionando, pero si es X, entonces seccomp transferirá el control strace, que observará los argumentos y lanzará el proceso como PTRACE_SYSCALL (ya que seccomp no tiene la capacidad de ejecutar un programa al salir de una llamada del sistema). Cuando la llamada del sistema regrese, strace reiniciará el proceso utilizando PTRACE_CONT y esperará nuevos mensajes de seccomp.
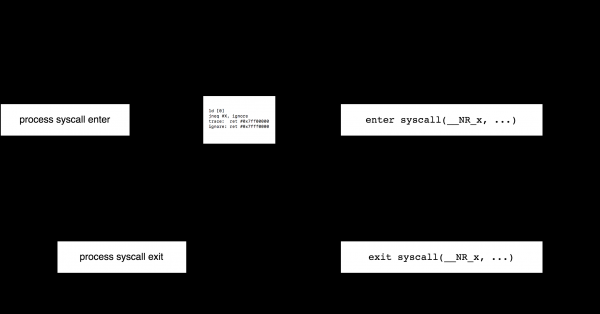
Al usar la opción --seccomp-bpf hay dos restricciones. Primero, no se puede adjuntar a un proceso ya existente (opción -p del programa strace), ya que esto no es compatible con seccomp. En segundo lugar, no hay forma de no mirar los procesos hijos, ya que los filtros de seccomp son heredados por todos los procesos hijos sin posibilidad de desactivarlos.
Un poco más de detalles sobre cómo exactamente strace funciona con seccomp se puede aprender de . Para nosotros, el hecho más interesante es que el clásico BPF a través de seccomp todavía tiene aplicaciones hoy en día.
xt_bpf
Ahora, volvamos al mundo de las redes.
Antecedentes: hace mucho tiempo, en 2007, se introdujo en el núcleo módulo xt_u32 para netfilter. Fue escrito por analogía con un clasificador de tráfico aún más antiguo, cls_u32 y permitía escribir reglas binarias arbitrarias para iptables utilizando las siguientes simples operaciones: cargar 32 bits del paquete y realizar con ellos un conjunto de operaciones aritméticas. Por ejemplo,
sudo iptables -A INPUT -m u32 --u32 "6&0xFF=1" -j LOG --log-prefix "seen-by-xt_u32"Carga 32 bits del encabezado IP, comenzando desde un desplazamiento de 6, y aplica una máscara 0xFF (tomar el byte menos significativo). Este es el campo protocol del encabezado IP y lo estamos comparando con 1 (ICMP). En una regla se pueden combinar muchas verificaciones, y también se puede ejecutar el operador @ — avanzar X bytes a la derecha. Por ejemplo, la regla
iptables -m u32 --u32 "6&0xFF=0x6 && 0>>22&0x3C@4=0x29"verifica que el número de secuencia de TCP 0x29. No entraré en más detalles, ya que ya está claro que escribir reglas a mano no es muy conveniente. En el artículo , hay algunos enlaces con ejemplos de uso y generación de reglas para xt_u32. Consulte también los enlaces al final de este artículo.
Desde 2013, en lugar del módulo xt_u32 se puede utilizar un módulo basado en BPF. xt_bpfA todos los que llegaron hasta aquí, ya debería estar claro el principio de su funcionamiento: ejecutar bytecode BPF como reglas de iptables. Se puede crear una nueva regla de la siguiente manera:
iptables -A INPUT -m bpf --bytecode -j LOGaquí <bytecode> — este es el código en formato de salida de ensamblador bpf_asm por defecto, por ejemplo,
$ cat /tmp/test.bpf
ldb [9]
jneq #17, ignore
ret #1
ignore: ret #0

$ bpf_asm /tmp/test.bpf
4,48 0 0 9,21 0 1 17,6 0 0 1,6 0 0 0,

# iptables -A INPUT -m bpf --bytecode "$(bpf_asm /tmp/test.bpf)" -j LOG
En este ejemplo, filtramos todos los paquetes UDP. El contexto para el programa BPF en el módulo xt_bpf, por supuesto, indica los datos del paquete, en el caso de iptables — el inicio del encabezado IPv4. El valor de retorno del programa BPF , donde false significa que el paquete no coincidió.
Es evidente que el módulo xt_bpf soporta filtros más complejos que en el ejemplo anterior. Veamos ejemplos reales de Cloudfare. Hasta hace poco, utilizaban el módulo xt_bpf para la protección contra ataques DDoS. En el artículo hablan sobre cómo (y por qué) generan filtros BPF y publican enlaces a un conjunto de utilidades para crear tales filtros. Por ejemplo, con la utilidad bpfgen se puede crear un programa BPF que coincide con la consulta DNS para el nombre habr.com:
$ ./bpfgen --assembly dns -- habr.com
ldx 4*([0]&0xf)
ld #20
add x
tax

lb_0:
    ld [x + 0]
    jneq #0x04686162, lb_1
    ld [x + 4]
    jneq #0x7203636f, lb_1
    ldh [x + 8]
    jneq #0x6d00, lb_1
    ret #65535

lb_1:
    ret #0
En el programa, primero cargamos en el registro X la dirección de inicio de la cadena x04habrx03comx00 dentro del datagrama UDP y luego comprobamos la consulta: 0x04686162 "x04hab" etc.
Un poco más tarde, Cloudfare publicó el código del compilador p0f -> BPF. En el artículo hablan sobre qué es p0f y cómo convertir las firmas de p0f a BPF:
$ ./bpfgen p0f -- 4:64:0:0:*,0::ack+:0
39,0 0 0 0,48 0 0 8,37 35 0 64,37 0 34 29,48 0 0 0,
84 0 0 15,21 0 31 5,48 0 0 9,21 0 29 6,40 0 0 6,
...
En este momento, Cloudfare ya no utiliza xt_bpf, ya que se mudaron a XDP — una de las formas de usar la nueva versión de BPF, ver .
cls_bpf
El último de los ejemplos del uso clásico de BPF en el kernel es un clasificador cls_bpf para el subsistema de control de tráfico en Linux, agregado a Linux a finales de 2013 y que conceptualmente reemplazó al antiguo cls_u32.
Sin embargo, no vamos a describir su funcionamiento ahora cls_bpf, ya que desde el punto de vista del conocimiento sobre el BPF clásico, no nos proporcionará nada — ya nos hemos familiarizado con toda la funcionalidad. Además, en los próximos artículos que tratan sobre el BPF extendido, nos encontraremos varias veces con este clasificador.
Otra razón para no hablar sobre el uso del BPF clásico con cls_bpf es que, en comparación con el BPF extendido, en este caso se restringe drásticamente el ámbito de aplicación: los programas clásicos no pueden cambiar el contenido de los paquetes y no pueden mantener el estado entre llamadas.
Así que ha llegado el momento de despedirse del BPF clásico y mirar hacia el futuro.
Despedida del BPF clásico
Hemos examinado cómo la tecnología BPF, desarrollada a principios de los noventa, ha sobrevivido exitosamente un cuarto de siglo y ha encontrado nuevas aplicaciones hasta el final. Sin embargo, al igual que con la transición de las máquinas de pila a RISC, que impulsó el desarrollo del clásico BPF, en los años dos mil ocurrió el cambio de máquinas de 32 bits a 64 bits y el BPF clásico comenzó a quedar obsoleto. Además, las capacidades del BPF clásico están muy limitadas y, además de su arquitectura anticuada, no tenemos la posibilidad de mantener el estado entre las llamadas a los programas BPF, no hay interacción directa con el usuario ni interacción con el núcleo, excepto para leer una cantidad limitada de campos de la estructura. sk_buff y ejecutar funciones auxiliares simples, no se puede modificar el contenido de los paquetes ni redirigirlos.
De hecho, en la actualidad, solo queda en Linux la interfaz API del BPF clásico, y dentro del núcleo todas las programas clásicos, ya sean filtros de sockets o filtros seccomp, se traducen automáticamente al nuevo formato, BPF Extendida. (Hablaremos sobre cómo sucede esto en el siguiente artículo.)
La transición a la nueva arquitectura comenzó en 2013, cuando Alexey Starovoitov propuso un esquema para actualizar el BPF. En 2014, se empezaron a publicar los parches correspondientes Hasta donde entiendo, inicialmente se planeaba solo optimizar la arquitectura y el compilador JIT para un funcionamiento más eficiente en máquinas de 64 bits, pero en cambio, estas optimizaciones dieron paso a un nuevo capítulo en el desarrollo de Linux.
Los próximos artículos de esta serie hablarán sobre la arquitectura y las aplicaciones de la nueva tecnología, que se conocía originalmente como BPF interno, luego BPF extendido y ahora simplemente como BPF.
Enlaces
- Steven McCanne y Van Jacobson, "El filtro de paquetes BSD: una nueva arquitectura para la captura de paquetes a nivel de usuario",
https://www.tcpdump.org/papers/bpf-usenix93.pdf - Steven McCanne, "libpcap: una metodología de arquitectura y optimización para la captura de paquetes",
https://sharkfestus.wireshark.org/sharkfest.11/presentations/McCanne-Sharkfest'11_Keynote_Address.pdf tcpdump,libpcap:- .
- BPF: el bytecode olvidado:
https://blog.cloudflare.com/bpf-the-forgotten-bytecode/ - Introducción a la herramienta BPF:
https://blog.cloudflare.com/introducing-the-bpf-tools/ bpf_cls:http://man7.org/linux/man-pages/man8/tc-bpf.8.html- Una visión general de seccomp:
https://lwn.net/Articles/656307/ https://github.com/torvalds/linux/blob/master/Documentation/userspace-api/seccomp_filter.rst- Paul Chaignon, "strace —seccomp-bpf: una mirada debajo del capó",
https://fosdem.org/2020/schedule/event/debugging_strace_bpf/ netsniff-ng:http://netsniff-ng.org/
Fuente: habr.com
