

¡Hola! Me llamo Vadim Madison, y dirijo el desarrollo de System Platform en Avito. Ya se ha hablado varias veces sobre cómo estamos transitando de una arquitectura monolítica a una basada en microservicios en la empresa. Es hora de compartir cómo hemos transformado nuestra infraestructura para sacar el máximo provecho de los microservicios y no perdernos en ellos. Cómo nos ayuda aquí PaaS, cómo simplificamos el despliegue y reducimos la creación de un microservicio a un solo clic, sigue leyendo. No todo lo que escribo a continuación se ha implementado completamente en Avito, parte de ello es cómo estamos desarrollando nuestra plataforma.
(Y al final de este artículo, hablaré sobre la posibilidad de asistir a un seminario de tres días del experto en arquitectura de microservicios Chris Richardson).
Cómo llegamos a los microservicios
Avito es uno de los clasificados más grandes del mundo, con más de 15 millones de nuevos anuncios publicados diariamente. Nuestro backend maneja más de 20,000 solicitudes por segundo. Actualmente tenemos varios cientos de microservicios.
Hemos estado construyendo una arquitectura de microservicios durante varios años. Cómo exactamente, nuestros colegas lo detallan en nuestra sección en RIT++ 2017. En CodeFest 2017 (ver ), Sergey Orlov y Mikhail Prokopchuk explicaron detalladamente por qué necesitábamos pasar a los microservicios y qué papel desempeñó Kubernetes aquí. Ahora hacemos todo lo posible para minimizar los costos de escalamiento que son inherentes a tal arquitectura.
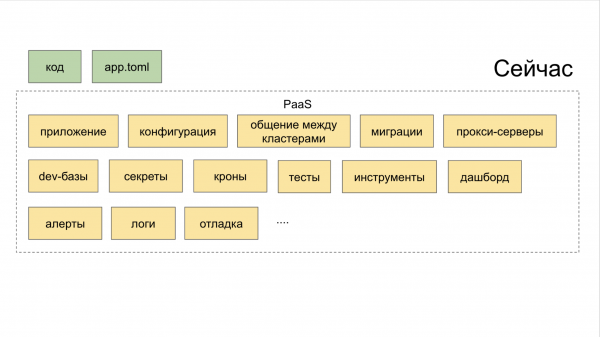
Inicialmente, no creamos un ecosistema que ayudara de manera integral en el desarrollo y lanzamiento de microservicios. Simplemente recopilamos soluciones de código abierto eficaces, las pusimos en funcionamiento y ofrecimos al desarrollador que se encargara de ellas. Como resultado, el desarrollador tenía que ir a diez lugares (tableros, servicios internos), lo que reforzaba su deseo de seguir escribiendo código de la manera tradicional, en monolito. En los diagramas a continuación, se indica en verde lo que hace el desarrollador por sí mismo de alguna manera, y en amarillo, la automatización.
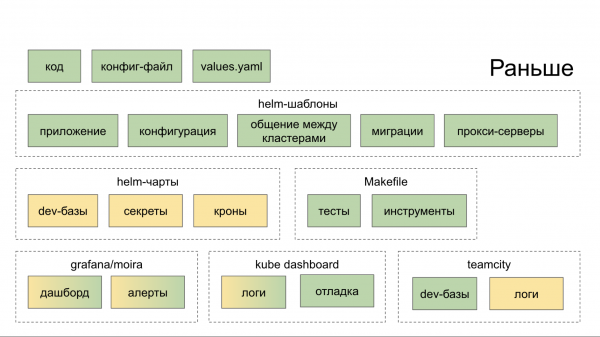
Ahora, en la herramienta CLI de PaaS, se puede crear un nuevo servicio con un solo comando, y con otros dos se añade una nueva base de datos y se despliega en Stage.
Cómo superar la era de la «fragmentación microservicios»
Con la arquitectura monolítica, por la consistencia de los cambios en el producto, los desarrolladores se vieron obligados a ocuparse de lo que sucedía con los demás. Con la nueva arquitectura, los contextos de los servicios dejaron de depender unos de otros.
Además, para que la arquitectura de microservicios sea efectiva, es necesario establecer múltiples procesos, a saber:
• registro;
• trazabilidad de solicitudes (Jaeger);
• agregación de errores (Sentry);
• estados, mensajes, eventos de Kubernetes (Procesamiento de Flujos de Eventos);
• límite de condiciones de carrera / circuitoBreaker (se puede usar Hystrix);
• control de la conectividad de los servicios (usamos Netramesh);
• monitoreo (Grafana);
• compilación (TeamCity);
• comunicación y notificación (Slack, correo electrónico);
• seguimiento de tareas; (Jira)
• redacción de documentación.
Para que el sistema no pierda su integridad y siga siendo efectivo a medida que escala, hemos repensado la organización del trabajo de los microservicios en Avito.
Cómo manejamos los microservicios
La implementación de una "política de partido" común entre numerosos microservicios de Avito se facilita mediante:
- división de la infraestructura en capas;
- concepto de Platform as a Service (PaaS);
- monitoreo de todo lo que ocurre con los microservicios.
Los niveles de abstracción de la infraestructura incluyen tres capas. Comenzaremos desde la superior a la inferior.
A. Superior — service mesh. Al principio probamos Istio, pero resultó que consume demasiados recursos, lo que resulta demasiado costoso para nuestros volúmenes. Por lo tanto, el ingeniero senior del equipo de arquitectura, Alexander Lukyanchенко, desarrolló una solución propia — (disponible en Open Source), que actualmente utilizamos en producción y que consume varias veces menos recursos que Istio (aunque no hace todo lo que puede ofrecer Istio).
B. Medio — Kubernetes. En él desplegamos y operamos los microservicios.
C. Inferior — bare metal. No utilizamos nubes ni cosas como OpenStack, seguimos completamente en bare metal.
Todas las capas se combinan en PaaS. Y esta plataforma, a su vez, consta de tres partes.
I. Generadores, controlados a través de una herramienta CLI. Es la que ayuda al desarrollador a crear microservicios de manera correcta y con el mínimo esfuerzo.
II. Colector consolidado con control de todas las herramientas a través de un tablero común.
III. Almacenamiento. Se conecta con programadores que automáticamente establecen disparadores para acciones significativas. Gracias a este sistema, ninguna tarea se queda sin atender simplemente porque alguien olvidó asignarse una tarea en Jira. Para esto, utilizamos una herramienta interna llamada Atlas.
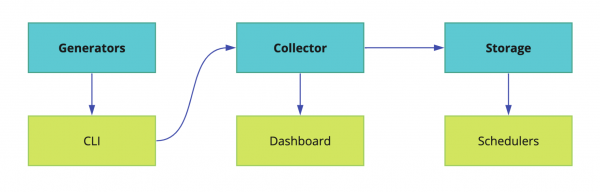
La implementación de microservicios en Avito también se lleva a cabo según un esquema unificado, lo que simplifica el control sobre ellos en cada etapa de desarrollo y lanzamiento.
Cómo funciona la cadena estándar de desarrollo de un microservicio
En términos generales, la cadena de creación de un microservicio se ve de la siguiente manera:
CLI-push → Integración Continua → Bake → Despliegue → Pruebas Artificiales → Pruebas Canary → Squeeze Testing → Producción → Mantenimiento.
Vamos a repasarla exactamente en ese orden.
CLI-push
• Creación de microservicio.
Hemos trabajado mucho para enseñar a cada desarrollador a crear microservicios. También hemos escrito instrucciones detalladas en Confluence. Pero los esquemas cambiaron y se actualizaron. El resultado: se formó un cuello de botella al principio del proceso: el lanzamiento de microservicios llevaba mucho más tiempo del permitido, y aun así, a menudo surgían problemas al crearles.
Al final, hemos creado una sencilla utilidad CLI que automatiza los pasos básicos en la creación de un microservicio. De hecho, reemplaza el primer git push. Esto es lo que hace concretamente.
— Crea el servicio a partir de una plantilla, paso a paso, en modo "asistente". Tenemos plantillas para los principales lenguajes de programación en el backend de Avito: PHP, Golang y Python.
— Con un solo comando despliega el entorno para el desarrollo local en una máquina específica: se levanta Minikube, los gráficos de Helm se generan y lanzan automáticamente en el kubernetes local.
— Conecta la base de datos necesaria. El desarrollador no necesita saber la IP, el nombre de usuario o la contraseña para acceder a la base de datos que necesita, ya sea local, en Stage o en producción. De hecho, la base de datos se despliega inmediatamente en una configuración tolerante a fallos y con balanceo.
— Realiza automáticamente una construcción en vivo. Supongamos que el desarrollador ha hecho algún cambio en el microservicio a través de su IDE. La utilidad detecta los cambios en el sistema de archivos y, a partir de ellos, recompila la aplicación (para Golang) y la reinicia. Para PHP, simplemente pasamos el directorio dentro del contenedor y ahí el live-reload se produce "automáticamente".
— Genera pruebas automáticas. En forma de plantillas, pero totalmente utilizables.
• Despliegue del microservicio.
Desplegar un microservicio antes solía ser algo complicado. Se requerían necesariamente:
I. Dockerfile.
II. Configuración.
III. Helm-chart, que en sí mismo es voluminoso e incluye:
— los propios charts;
— plantillas;
— valores específicos considerando diferentes entornos.
Nos hemos deshecho del dolor de reescribir los manifiestos de Kubernetes, y ahora se generan automáticamente. Pero lo más importante, hemos simplificado al máximo el despliegue. A partir de ahora, tenemos un Dockerfile y toda la configuración que el desarrollador escribe en un único archivo corto app.toml.
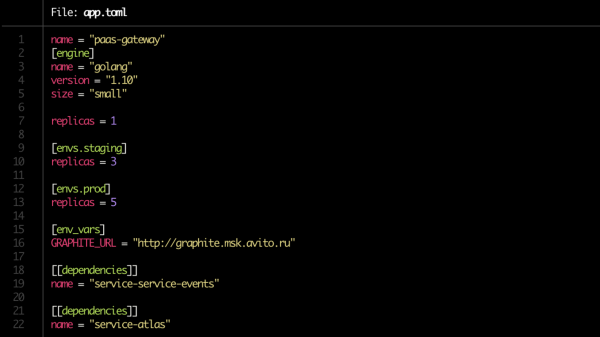
Incluso en el propio app.toml ahora se tarda un minuto. Indicamos cuántas copias del servicio levantar (en el servidor dev, en staging, en producción) y especificamos sus dependencias. Presta atención a la línea size = "small" en el bloque [engine]. Ese es el límite que se asignará al servicio a través de Kubernetes.
Luego, en base a la configuración, se generan automáticamente todos los Helm-charts necesarios y se crean las conexiones a las bases de datos.
• Validación básica. Estas verificaciones también están automatizadas.
Es necesario revisar:
— si hay un Dockerfile;
— si hay un app.toml;
— si hay documentación;
— si las dependencias están en orden;
— si están establecidas las reglas de alertas.
Sobre el último punto: el propietario del servicio indica qué métricas de producto monitorear.
• Preparación de la documentación.
Sigue siendo un punto problemático. Aparentemente lo más obvio, pero al mismo tiempo el eslabón más "olvidado", lo que lo convierte en un punto vulnerable.
Es necesario que haya documentación para cada microservicio. Incluye los siguientes bloques.
I. Descripción breve del servicio. Literalmente unas pocas frases sobre lo que hace y para qué sirve.
II. Enlace al diagrama de arquitectura. Es importante que a simple vista se pueda entender, por ejemplo, si usas Redis para la caché o como almacenamiento principal de datos en modo persistente. En Avito, por ahora, este es un enlace a Confluence.
III. Runbook. Una guía corta sobre cómo iniciar el servicio y detalles sobre su uso.
IV. FAQ, donde sería bueno anticipar los problemas que tus colegas podrían encontrar al trabajar con el servicio.
V. Descripción de endpoints para la API. Si por alguna razón no especificaste los destinos, es casi seguro que tus colegas, cuyas microservicios están relacionados con los tuyos, tendrán que pagar por ello. Actualmente, utilizamos Swagger y nuestra solución llamada brief para esto.
VI. Etiquetas. O marcadores que indican a qué producto, funcionalidad o departamento de la empresa pertenece el servicio. Ayudan a entender rápidamente, por ejemplo, si estás desarrollando funcionalidades que hace una semana tus colegas lanzaron para la misma unidad de negocio.
VII. Propietario o propietarios del servicio. En la mayoría de los casos, se puede determinar automáticamente mediante PaaS, pero para mayor seguridad, requerimos que el desarrollador los indique manualmente.
Finalmente, una buena práctica es realizar revisiones de la documentación, similar a una revisión de código.
Integración Continua
- Preparación de repositorios.
- Creación de un pipeline en TeamCity.
- Establecimiento de permisos.
- Búsqueda de propietarios del servicio. Aquí hay un esquema híbrido: etiquetado manual y mínima automatización por parte de PaaS. Un esquema completamente automático puede fallar al transferir servicios a otro equipo de desarrollo o, por ejemplo, si el desarrollador del servicio ha dejado la empresa.
- Registro del servicio en Atlas (ver arriba). Con todos sus propietarios y dependencias.
- Revisión de migraciones. Verificamos si hay potencialmente peligrosas entre ellas. Por ejemplo, si alguna de ellas contiene alteraciones de tablas o algo que pueda romper la compatibilidad del esquema de datos entre diferentes versiones del servicio. Entonces, la migración no se ejecuta y se coloca en suscripción; PaaS debe avisar al propietario del servicio cuando sea seguro aplicarla.
— es una herramienta para la construcción coordinada de software de múltiples repositorios, diseñada para el proyecto ns‑3.
La siguiente etapa es empaquetar los servicios antes del despliegue.
- Compilación de la aplicación. Por lo clásico, en una imagen de Docker.
- Generación de gráficos Helm para el propio servicio y los recursos asociados. Incluyendo bases de datos y cachés. Se crean automáticamente de acuerdo con la configuración app.toml que se formó durante la etapa de CLI-push.
- Creación de tickets para los administradores para abrir puertos (cuando sea necesario).
- Ejecución de pruebas unitarias y cálculo de la cobertura de código.. Si la cobertura de código está por debajo del umbral especificado, es probable que el servicio no pase más adelante en el despliegue. Si está en el límite aceptable, se asignará un coeficiente 'pesimista' al servicio: entonces, en ausencia de mejoras en el indicador con el tiempo, el desarrollador recibirá una notificación de que no hay progreso en las pruebas (y que se debe hacer algo al respecto).
- Consideraciones sobre la memoria y CPU. Principalmente, escribimos microservicios en Golang y los ejecutamos en Kubernetes. De aquí surge un matiz relacionado con la particularidad del lenguaje Golang: por defecto, al iniciarlo, se utilizan todos los núcleos de la máquina, a menos que se defina explícitamente la variable GOMAXPROCS; y cuando se ejecutan varios de estos servicios en una misma máquina, comienzan a competir por los recursos, interfiriendo entre sí. En los gráficos a continuación se muestra cómo varía el tiempo de ejecución si se ejecuta la aplicación sin competencia y en modo de carrera por recursos. (Los orígenes de los gráficos están) ).
Tiempo de ejecución, menor es mejor. Máximo: 643 ms, mínimo: 42 ms. La imagen es clicable.
Tiempo en operación, menor es mejor. Máximo: 14091 ns, mínimo: 151 ns. La imagen es clicable.
En la etapa de preparación de la compilación, se puede definir esta variable explícitamente o se puede utilizar la biblioteca de los chicos de Uber.
Despliegue
• Verificación de convenciones. Antes de comenzar a entregar las compilaciones del servicio a los entornos previstos, se debe verificar lo siguiente:
— Puntos finales de la API.
— Correspondencia de las respuestas de los puntos finales de la API con el esquema.
— Formato de los registros.
— Establecimiento de encabezados en las solicitudes al servicio (actualmente lo hace netramesh)
— Establecimiento de un marcador de propietario al enviar mensajes al bus (event bus). Esto es necesario para rastrear la coherencia de los servicios a través del bus. En el bus se pueden enviar datos idempotentes que no aumentan la coherencia de los servicios (lo cual es bueno), así como datos de negocio que aumentan la coherencia de los servicios (lo cual es muy malo). Y en el momento en que esta coherencia se convierte en un problema, entender quién escribe y lee en el bus ayuda a dividir correctamente los servicios.
Actualmente, hay pocas convenciones en Avito, pero su conjunto se está expandiendo. Cuantas más de estas convenciones existan en una forma clara y conveniente para el equipo, más fácil será mantener la coherencia entre los microservicios.
Pruebas sintéticas
• Pruebas en un entorno cerrado. Para esto, estamos utilizando ahora el open source Primero, registra la carga real en el servicio, luego, en un circuito cerrado, la emula.
• Pruebas de carga. Nos esforzamos por llevar todos los servicios a un rendimiento óptimo. Y todas las versiones de cada servicio deben someterse a pruebas de carga, así podemos entender el rendimiento actual del servicio y la diferencia con versiones anteriores del mismo. Si después de una actualización el rendimiento del servicio cae a la mitad, es una señal clara para sus propietarios: es necesario profundizar en el código y corregir la situación.
Nos basamos en los datos recopilados, por ejemplo, para implementar correctamente el auto scaling y, al final, para entender qué tan escalable es el servicio.
Durante las pruebas de carga, verificamos si el consumo de recursos cumple con las limitaciones establecidas. Y nos enfocamos principalmente en los extremos.
a) Observamos la carga total.
— Si es demasiado baja, probablemente algo no esté funcionando, si la carga de repente cae varias veces.
— Si es demasiado alta, se requiere optimización.
b) Observamos el corte por RPS.
Aquí observamos tanto la diferencia entre la versión actual y la anterior como el número total. Por ejemplo, si el servicio entrega 100 rps, entonces o está mal diseñado, o esa es su especificidad, pero en cualquier caso es un motivo para examinar el servicio con mucho detalle.
Si, por el contrario, el RPS es demasiado alto, entonces, posiblemente, haya un error y alguno de los endpoints ha dejado de realizar la carga útil, simplemente ejecutando algo como un return true;
Pruebas Canary
Después de realizar las pruebas sintéticas, evaluamos el funcionamiento del microservicio con un pequeño número de usuarios. Comenzamos cuidadosamente, con una ínfima parte de la audiencia prevista para el servicio — menos del 0,1%. En esta etapa, es muy importante que se hayan establecido métricas técnicas y de producto adecuadas en el monitoreo, para que puedan mostrar rápidamente cualquier problema en el servicio. El tiempo mínimo de prueba canary es de 5 minutos, el estándar es de 2 horas. Para servicios complejos, establecemos el tiempo manualmente.
Analizamos:
— Métricas específicas del lenguaje, en particular, los trabajadores de php-fpm;
— Errores en Sentry;
— Estados de respuesta;
— Tiempos de respuesta (response time), exactos y promedio;
— Latencia;
— Excepciones, tratadas y no tratadas;
— Métricas de producto.
Pruebas de Estrangulación
Las Pruebas de Squeeze también se conocen como pruebas de "expulsión". El término fue introducido por Netflix. La esencia de esta metodología es que primero llenamos una instancia con tráfico real hasta su punto de fallo y así establecemos su límite. Luego, añadimos otra instancia y cargamos esta pareja nuevamente hasta el máximo; observamos su techo y la diferencia con el primer "squiz". Y así, conectamos una instancia a la vez y calculamos la tendencia en los cambios.
Los datos de las pruebas de "expulsión" también se integran en una base de métricas común, donde o bien enriquecemos los resultados de las cargas artificiales, o incluso los sustituimos por "sintético".
Producción
• Escalado. Al desplegar un servicio en producción, monitorizamos cómo se escala. Según nuestra experiencia, monitorear solo los indicadores de CPU no es efectivo. El autoescalado con referencia a RPS funciona en su forma pura, pero solo para servicios individuales, como el streaming en línea. Así que, en primer lugar, observamos las métricas de producto específicas de la aplicación.
Al escalar, analizamos:
— índices de CPU y RAM,
— cantidad de solicitudes en la cola,
— tiempo de respuesta,
— pronóstico basado en datos históricos acumulados.
Al escalar un servicio, también es importante monitorizar sus dependencias, para evitar que escalemos el primer servicio en la cadena y que aquellos a los que se conecta fallen bajo carga. Para establecer una carga aceptable para todo el conjunto de servicios, observamos los datos históricos del servicio dependiente más "cercano" (basándonos en la combinación de indicadores de CPU y RAM junto con métricas específicas de la aplicación) y los comparamos con los datos históricos del servicio inicial, y así sucesivamente a lo largo de toda la "cadena de dependencias", de arriba hacia abajo.
Mantenimiento
Después de que el microservicio se ponga en funcionamiento, podemos asignarle disparadores.
Estas son situaciones típicas en las que se activan los disparadores.
— Se han detectado migraciones potencialmente peligrosas.
— Se han lanzado actualizaciones de seguridad.
— El propio servicio no se ha actualizado durante mucho tiempo.
— Ha disminuido notablemente la carga sobre el servicio o alguna de sus métricas de producto sale de los límites normales.
— El servicio ha dejado de cumplir con los nuevos requisitos de la plataforma.
Parte de los triggers asegura la estabilidad operativa, parte de ellos actúa como función de mantenimiento del sistema; por ejemplo, algún servicio no ha sido desplegado durante un tiempo y su imagen base ha dejado de pasar la verificación de seguridad.
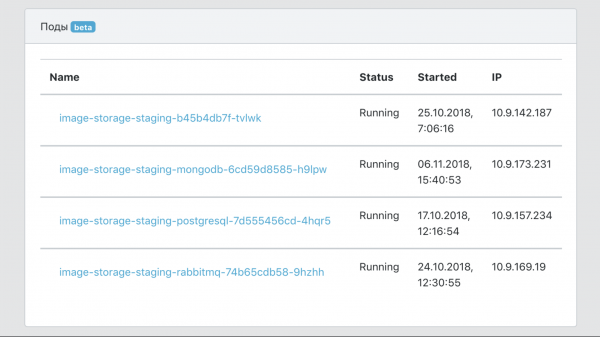
Panel de control
En pocas palabras, el panel de control es el centro de control de toda nuestra PaaS.
- Un punto único de información sobre el servicio, con datos sobre su cobertura de pruebas, cantidad de imágenes, número de copias en producción, versiones, etc.
- Herramienta de filtrado de datos por servicios y etiquetas (marcadores de pertenencia a unidades de negocio, funcionalidad del producto, etc.)
- Herramienta de integración con herramientas de infraestructura para trazado, registro y monitoreo.
- Punto único de documentación sobre servicios.
- Punto único de vista sobre todos los eventos relacionados con los servicios.
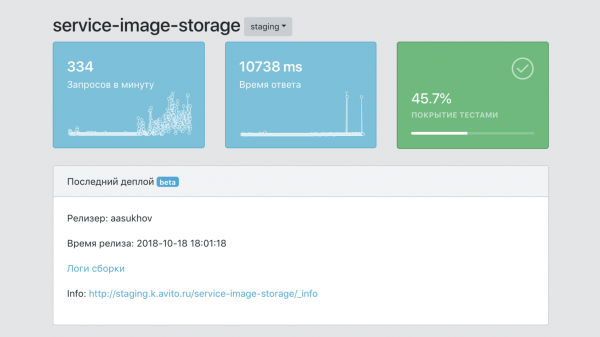
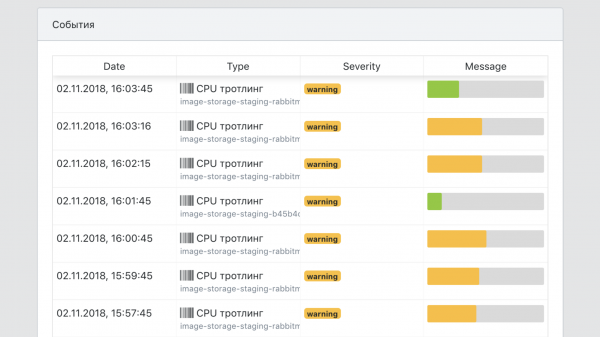
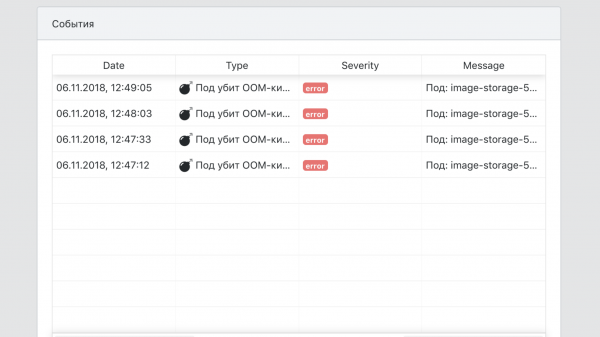
Total
Antes de implementar PaaS, un nuevo desarrollador podría tardar varias semanas en entender todas las herramientas necesarias para desplegar un microservicio en producción: Kubernetes, Helm, así como nuestras particularidades internas de TeamCity, la configuración de conexión a bases de datos y cachés en un formato resistente a fallos, etc. Ahora se tarda un par de horas: leer el guía rápida y crear el servicio.
Hice una presentación sobre este tema para HighLoad++ 2018, puedes verlo y .
Pista de bonificación para aquellos que leyeron hasta el final
En Avito, estamos organizando un entrenamiento interno de tres días para desarrolladores por parte de , experto en arquitectura de microservicios. Queremos regalar la oportunidad de participar a alguno de los lectores de esta publicación. El programa del entrenamiento está disponible.
El entrenamiento se llevará a cabo del 5 al 7 de agosto en Moscú. Serán días laborales completamente ocupados. El almuerzo y la formación se realizarán en nuestras oficinas, mientras que el viaje y el alojamiento corren a cuenta del participante elegido.
Puedes postularte para participar . Deberás responder a la pregunta de por qué realmente necesitas asistir al entrenamiento y proporcionar información sobre cómo contactarte. Responde en inglés, porque será Chris quien seleccione al participante que asistirá al entrenamiento.
Anunciaremos el nombre del participante del entrenamiento como una actualización de esta publicación y en las redes sociales de Avito para desarrolladores (AvitoTech en , , ) a más tardar el 19 de julio.
Fuente: habr.com
