

El mercado de la computación distribuida y los grandes datos, según los informes, , está creciendo entre un 18-19% al año. Esto significa que la pregunta sobre la elección de software para estos fines sigue siendo relevante. En esta publicación, comenzaremos explicando por qué son necesarias las computaciones distribuidas, detallaremos la elección de software, hablaremos sobre la aplicación de Hadoop a través de Cloudera, y finalmente discutiremos la selección de hardware y cómo este influye en el rendimiento de diferentes maneras.
¿Por qué son necesarias las computaciones distribuidas en los negocios convencionales? Es sencillo y complicado al mismo tiempo. Sencillo porque, en la mayoría de los casos, realizamos cálculos relativamente simples por unidad de información. Complicado porque hay mucha información. Muchísima. Como resultado, hay que . De esta forma, los escenarios de uso son bastante universales: los cálculos pueden aplicarse en cualquier lugar donde sea necesario tener en cuenta un gran número de métricas sobre un aún mayor conjunto de datos.
Uno de los ejemplos recientes: la cadena de pizzerías Dodo Pizza en base al análisis de la base de datos de pedidos de clientes, que al elegir una pizza con cualquier relleno, los usuarios normalmente utilizan solo seis conjuntos básicos de ingredientes más un par de aleatorios. En consecuencia, la pizzería ajustó sus compras. Además, logró recomendar mejor a los usuarios productos adicionales ofrecidos en el momento del pedido, lo que permitió aumentar las ganancias.
Otro ejemplo: de las posiciones de productos permitió a la tienda H&M reducir su surtido en ciertas tiendas en un 40%, manteniendo al mismo tiempo el nivel de ventas. Esto se logró eliminando los artículos que no vendían bien, teniendo en cuenta la estacionalidad.
La elección de la herramienta
El estándar de la industria para este tipo de cálculos es Hadoop. ¿Por qué? Porque Hadoop es un excelente marco bien documentado (Habr publica muchos artículos detallados sobre este tema) que viene acompañado de un conjunto completo de utilidades y bibliotecas. Puede ingresar conjuntos de datos masivos, tanto estructurados como no estructurados, y el sistema los distribuirá automáticamente entre los recursos computacionales. Además, estos recursos se pueden ampliar o desactivar en cualquier momento: así es como funciona la escalabilidad horizontal.
En 2017, la influyente empresa de consultoría Gartner , que Hadoop pronto quedará obsoleto. La razón es bastante banal: los analistas creen que las empresas comenzarán a migrar masivamente a la nube, ya que allí podrán pagar por el uso real de los recursos computacionales. Un segundo factor importante que supuestamente podría "enterrar" a Hadoop es la velocidad de operación. Porque opciones como Apache Spark o Google Cloud DataFlow funcionan más rápido que MapReduce, que es la base de Hadoop.
Hadoop se basa en varios pilares, siendo las tecnologías más destacadas MapReduce (un sistema de distribución de datos para cálculos entre servidores) y el sistema de archivos HDFS. Este último está diseñado específicamente para almacenar información distribuida entre los nodos del clúster: cada bloque de tamaño fijo puede ubicarse en varios nodos, y gracias a la replicación, se garantiza la resistencia del sistema a fallos de nodos individuales. En lugar de una tabla de archivos, se utiliza un servidor especial denominado NameNode.
En la ilustración a continuación se presenta un esquema de trabajo de MapReduce. En la primera etapa, los datos se dividen según un criterio determinado; en la segunda, se distribuyen entre los recursos computacionales; y en la tercera, se realiza el cálculo.
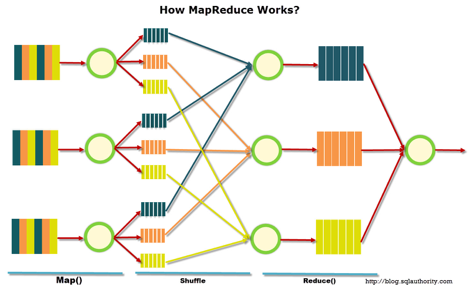
Inicialmente, MapReduce fue creado por Google para sus necesidades de búsqueda. Luego, MapReduce se liberó como código abierto y Apache se encargó del proyecto. Mientras tanto, Google ha migrado gradualmente a otras soluciones. Un detalle interesante: actualmente, Google tiene un proyecto llamado Google Cloud Dataflow, que se posiciona como el siguiente paso después de Hadoop, como su reemplazo rápido.
Al analizar detenidamente, se puede ver que Google Cloud Dataflow se basa en una variante de Apache Beam, que a su vez incluye un marco bien documentado de Apache Spark, lo que permite afirmar que la velocidad de ejecución de las soluciones es prácticamente la misma. Además, Apache Spark funciona excelentemente en el sistema de archivos HDFS, lo que permite desplegarlo en servidores Hadoop.
Si añadimos aquí el volumen de documentación y soluciones listas sobre Hadoop y Spark en comparación con Google Cloud Dataflow, la elección de la herramienta se vuelve obvia. Además, los ingenieros pueden decidir qué código ejecutar —¿Hadoop o Spark?— dependiendo de la tarea, su experiencia y calificación.
Nube o servidor local
La tendencia hacia la transición a la nube ha dado lugar a un término interesante como Hadoop-as-a-service. En este escenario, la administración de los servidores conectados se vuelve muy importante. Desafortunadamente, a pesar de su popularidad, Hadoop puro es una herramienta bastante complicada de configurar, ya que mucho tiene que hacerse manualmente. Por ejemplo, configurar los servidores por separado, monitorear sus métricas y ajustar cuidadosamente una multitud de parámetros. En general, es un trabajo para entusiastas y existe un gran riesgo de cometer errores o pasar algo por alto.
Por lo tanto, han ganado popularidad diversas distribuciones que inicialmente vienen con herramientas cómodas de despliegue y administración. Una de las distribuciones más populares que apoya a Spark y simplifica todo es Cloudera. Tiene versiones de pago y gratuitas, y en esta última está disponible toda la funcionalidad principal, sin límite en el número de nodos.
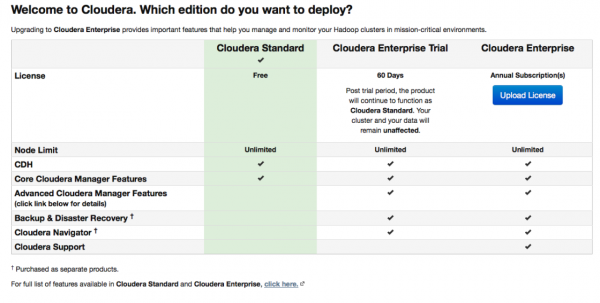
Durante la configuración, Cloudera Manager se conectará a sus servidores a través de SSH. Un detalle interesante: al instalar, es mejor indicar que se realice mediante parcelas: paquetes especiales, cada uno de los cuales contiene todos los componentes necesarios, configurados para trabajar entre sí. En esencia, es una versión mejorada de un gestor de paquetes.
Después de la instalación, obtendremos un panel de control del clúster, donde podrá ver la telemetría del clúster, los servicios instalados, además de que podrá agregar/eliminar recursos y editar la configuración del clúster.
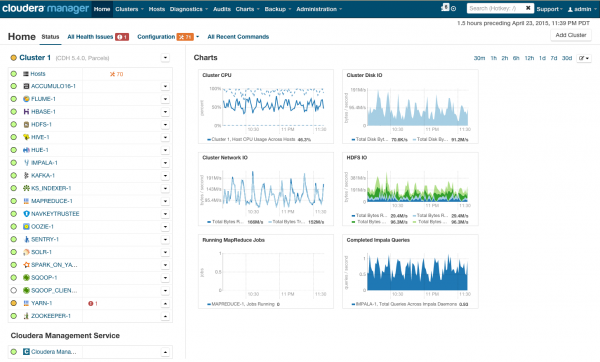
Como resultado, se presenta ante usted el corte de ese cohete que lo llevará hacia un futuro brillante de BigData. Pero antes de decir 'vamos', trasladémonos al motor.
Requisitos de hardware
En su sitio web, Cloudera menciona diferentes configuraciones posibles. Los principios generales sobre los que se construyen se presentan en la ilustración:
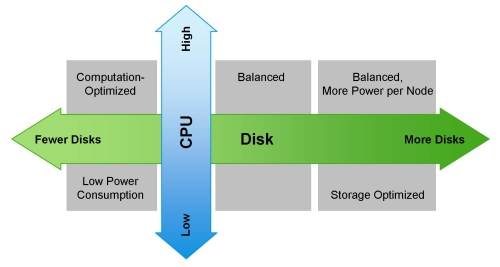
Este panorama optimista puede verse afectado por MapReduce. Si volvemos a observar el esquema de la sección anterior, queda claro que en casi todos los casos, la tarea de MapReduce puede enfrentar un 'cuello de botella' al leer datos desde el disco o la red. Esto también se menciona en el blog de Cloudera. Como resultado, para cualquier cálculo rápido, incluyendo aquellos a través de Spark, que se usa frecuentemente para cálculos en tiempo real, la velocidad de entrada/salida es muy importante. Por lo tanto, al usar Hadoop, es crucial que el clúster cuente con máquinas rápidas y equilibradas, lo cual, dicho sea de paso, no siempre se garantiza en la infraestructura en la nube.
El equilibrio en la distribución de cargas se logra mediante el uso de virtualización Openstack en servidores con potentes CPU multinúcleo. Se asignan recursos de CPU específicos y discos a los nodos de datos. En nuestra solución Atos Codex Data Lake Engine se logra una amplia virtualización, lo que nos beneficia tanto en rendimiento (minimizando la influencia de la infraestructura de red) como en TCO (eliminando servidores físicos innecesarios).
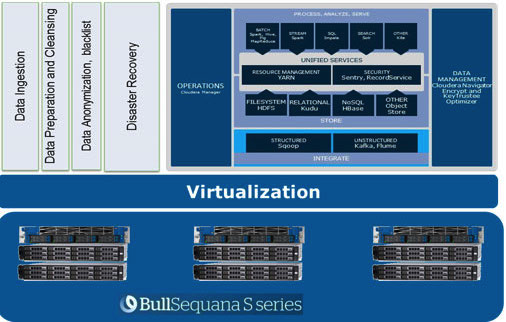
En el caso de usar servidores BullSequana S200, obtenemos una carga bastante uniforme, libre de algunos cuellos de botella. La configuración mínima incluye 3 servidores BullSequana S200, cada uno con dos JBOD, más opcionalmente se pueden conectar S200 adicionales que contengan cuatro nodos de datos cada uno. Aquí hay un ejemplo de carga en la prueba TeraGen:
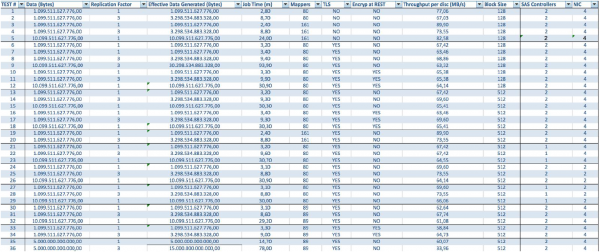
Las pruebas con diferentes volúmenes de datos y valores de replicación muestran resultados consistentes en cuanto a la distribución de la carga entre los nodos del clúster. A continuación se presenta un gráfico de distribución del acceso al disco en las pruebas de rendimiento.
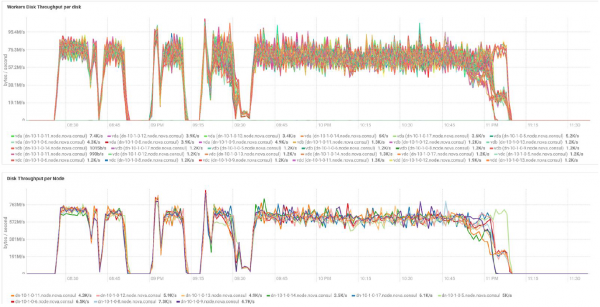
Los cálculos se realizaron sobre la base de la configuración mínima de 3 servidores BullSequana S200. Esta configuración incluye 9 nodos de datos y 3 nodos principales, así como máquinas virtuales reservadas en caso de implementar protección basada en OpenStack Virtualization. El resultado de la prueba TeraSort: bloque de tamaño 512 MB con un factor de replicación de tres y cifrado es de 23.1 minutos.
¿Cómo se puede ampliar el sistema? Para Data Lake Engine están disponibles diferentes tipos de extensiones:
- Nodos de transmisión de datos: por cada 40 TB de espacio útil
- Nodos analíticos con capacidad para instalar GPU
- Otras opciones dependiendo de las necesidades del negocio (por ejemplo, si se necesita Kafka y similares)
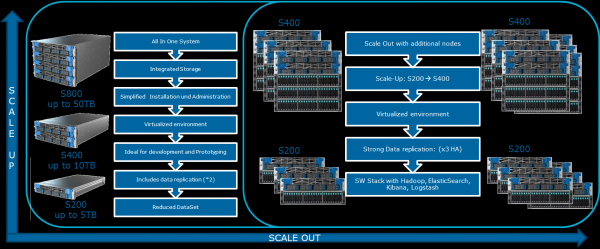
El complejo Atos Codex Data Lake Engine incluye tanto los servidores como el software preinstalado, que incluye el paquete Cloudera con licencia; el propio Hadoop, OpenStack con máquinas virtuales basadas en el núcleo de RedHat Enterprise Linux, sistemas de replicación de datos y copia de seguridad (incluyendo mediante el nodo de respaldo y Cloudera BDR — Backup and Disaster Recovery). Atos Codex Data Lake Engine se convirtió en la primera solución utilizando virtualización que fue certificada. .
Si le interesa más información, estaremos encantados de responder a sus preguntas en los comentarios.
Fuente: habr.com
