

Saludos, habr.
Si alguien está explotando el sistema y se ha encontrado con problemas de rendimiento del almacenamiento (IO, espacio en disco consumido), entonces la posibilidad de que se haya considerado ClickHouse como un reemplazo debe tender a uno. Esta afirmación implica que ya se está utilizando una implementación de terceros como el demonio receptor de métricas, por ejemplo o .
ClickHouse aborda bien los problemas descritos. Por ejemplo, después de transferir 2TiB de datos de whisper, los datos se comprimieron en 300GiB. No entraré en detalles de la comparación, hay suficientes artículos sobre este tema. Además, hasta hace poco, nuestra base de datos ClickHouse no era del todo perfecta.
Problemas con el espacio consumido
A primera vista, todo debería funcionar bien. Siguiendo , creamos la configuración para el esquema de almacenamiento de métricas (en adelante retention), luego creamos la tabla de acuerdo a las recomendaciones del backend elegido para graphite-web: + o , dependiendo de qué stack se utiliza. Y... se activa una bomba de tiempo.
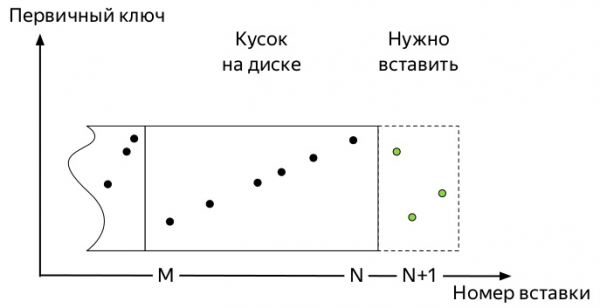
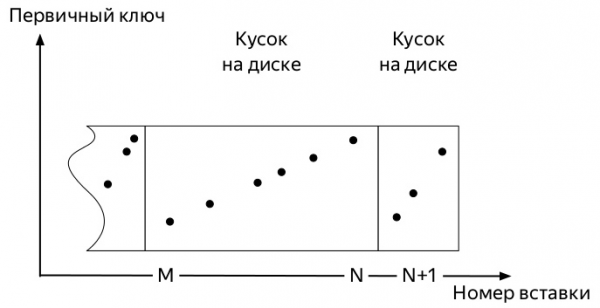
Para entender cuál, es necesario saber cómo funcionan las inserciones y la trayectoria subsiguiente de los datos en las tablas de motores del tipo *MergeTree ClickHouse (los diagramas fueron tomados de Aleksey Zatelepin):
- Se inserta
un bloquede datos. En nuestro caso, estas son las métricas que llegaron.

- Cada bloque se ordena antes de ser escrito en disco de acuerdo con la clave
ORDER BY, especificada al crear la tabla. - Después de la ordenación,
un trozo(part) de datos se escribe en disco.
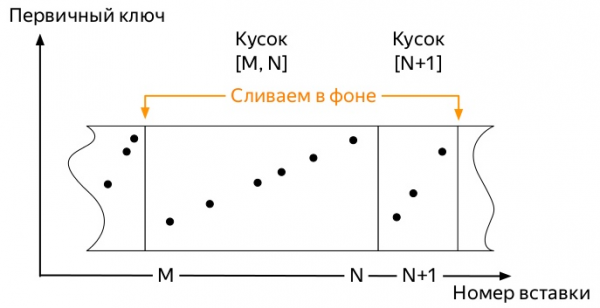
- El servidor vigila en segundo plano para que no haya muchos de estos trozos, y comienza las
fusiones(merge, o merges.
- El servidor deja de ejecutar merges automáticamente una vez que los datos dejan de llegar activamente a la
partición(partition), pero se puede iniciar manualmente el proceso con el comandoOPTIMIZE. - Si en la partición solo queda un trozo, no se podrá iniciar un merge con el comando habitual, debe utilizarse
OPTIMIZE ... FINAL
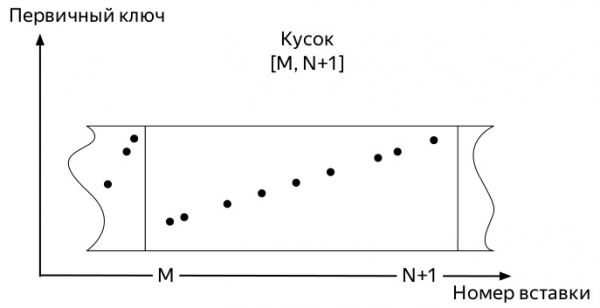
Así, llegan las primeras métricas. Y ocupan un cierto espacio. Los eventos posteriores pueden variar ligeramente dependiendo de muchos factores:
- La clave de partición puede ser tan pequeña (un día) como muy grande (varios meses).
- La configuración de retención puede albergar varios umbrales significativos de agregación de datos dentro de la partición activa (a donde se graban las métricas), o puede que no.
- Si hay muchos datos, entonces las porciones más antiguas, que debido a las fusiones en segundo plano pueden ser ya enormes (al elegir una clave de particionamiento subóptima), no se fusionarán con las porciones nuevas y pequeñas.
Y siempre termina igual. El espacio ocupado por métricas en ClickHouse solo crece si:
- no se aplica
OPTIMIZE ... FINALmanualmente o - no se insertan datos en todas las particiones de manera constante, para que tarde o temprano se inicie una fusión en segundo plano.
El segundo método parece el más fácil de implementar y, por lo tanto, es incorrecto y se ha probado primero.
Escribí un script bastante sencillo en Python que enviaba métricas ficticias para cada día durante los últimos 4 años y se ejecutaba cada hora mediante cron.
Dado que todo el trabajo de ClickHouse DBMS se basa en que este sistema hará todo el trabajo de fondo en algún momento, pero no se sabe cuándo, no logré esperar el momento en que las porciones antiguas y enormes comenzaron a fusionarse con las nuevas y pequeñas. Se hizo evidente que debía buscar una forma de automatizar optimizaciones forzadas.
La información en las tablas del sistema de ClickHouse
Veamos la estructura de la tabla . Esta es información exhaustiva sobre cada porción de todas las tablas en el servidor ClickHouse. Contiene, entre otras, las siguientes columnas:
- nombre de la base de datos (
database); - nombre de la tabla (
tabla); - nombre e ID de la partición (
partition&partition_id); - cuándo se creó la porción (
modification_time); - fecha mínima y máxima en la porción (la particionamiento se realiza por días) (
min_date&max_date);
También hay una tabla , con los siguientes campos interesantes:
- nombre de la base de datos (
Tables.database); - nombre de la tabla (
Tables.table); - la edad de la métrica, cuando debe aplicarse la siguiente agregación (
edad);
Así que:
- Tenemos una tabla de porciones y una tabla de reglas de agregación.
- Unimos su intersección y obtenemos todas las tablas *GraphiteMergeTree.
- Buscamos todas las particiones en las que:
- hay más de una porción
- o ha llegado el momento de aplicar la siguiente regla de agregación, y
modification_timees más antigua que este momento.
Implementación
Esta consulta
SELECCIONAR
    concat(p.database, '.', p.table) AS table,
    p.partition_id AS partition_id,
    p.partition AS partition,
    -- La regla "más antigua" que se puede aplicar a
    -- la partición, pero no en el futuro, ver (*)
    max(g.age) AS age,
    -- Número de piezas en la partición
    countDistinct(p.name) AS parts,
    -- La métrica más antigua de la partición se considera 00:00:00 del día siguiente
    toDateTime(max(p.max_date + 1)) AS max_time,
    -- Cuándo debe ser optimizada la partición
    max_time + age AS rollup_time,
    -- Cuándo se actualizó la pieza más antigua en la partición
    min(p.modification_time) AS modified_at
FROM system.parts AS p
INNER JOIN
(
    -- Todas las reglas para todas las tablas *GraphiteMergeTree
    SELECCIONAR
        Tables.database AS database,
        Tables.table AS table,
        age
    FROM system.graphite_retentions
    ARRAY JOIN Tables
    GROUP BY
        database,
        table,
        age
) AS g ON
    (p.table = g.table)
    Y (p.database = g.database)
DONDE
    -- Solo piezas activas
    p.active
    -- (*) Y solo filas donde las reglas de agregación ya deberían haberse aplicado
    Y ((toDateTime(p.max_date + 1) + g.age) < now())
GROUP BY
    table,
    partition
HAVING
    -- Solo particiones que son más jóvenes que el momento de optimización
    (modified_at  1)
ORDER BY
    table ASC,
    partition ASC,
    age ASC
devuelve cada una de las particiones de las tablas *GraphiteMergeTree, cuyos merges deberían liberar espacio en disco. Solo queda un pequeño paso: recorrerlas todas con la consulta OPTIMIZE ... FINAL. En la implementación final, también se tuvo en cuenta que no es necesario tocar las particiones con escritura activa.
Esto es exactamente lo que hace el proyecto . Antiguos colegas de Yandex.Market lo probaron en producción, el resultado del trabajo se puede ver a continuación.
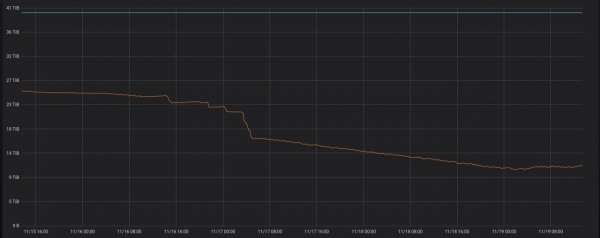
Si ejecutas el programa en un servidor con ClickHouse, simplemente comenzará a funcionar en modo demonio. Una vez por hora se ejecutará la consulta, comprobando si hay nuevas particiones de más de tres días que se pueden optimizar.
En los próximos planes está proporcionar, al menos, paquetes deb, y si es posible, también rpm.
En conclusión
En los más de 9 meses pasados, he estado dentro de mi empresa pasando mucho tiempo, sumergido en la interfaz entre ClickHouse y graphite-web. Ha sido una buena experiencia, cuyo resultado ha hecho posible una rápida transición de whisper a ClickHouse como almacenamiento de métricas. Espero que este artículo sea algo así como el inicio de un ciclo sobre las mejoras que hemos realizado en varias partes de este stack, y lo que se hará en el futuro.
Se gastaron varios litros de cerveza y días de administrador en desarrollar esta solicitud junto con , por lo cual quiero expresar mi agradecimiento. También por la revisión de este artículo.
Fuente: habr.com
