

Discutamos por qué las herramientas CI y CI son cosas completamente diferentes.
¿Qué problema pretende resolver CI, de dónde surgió la idea, cuáles son las últimas evidencias de que funciona, y cómo saber si usted tiene realmente práctica y no solo un Jenkins instalado?
La idea de hacer una presentación sobre Continuous Integration surgió hace un año, cuando estuve en entrevistas buscando trabajo. Hablé con 10-15 empresas, de las cuales solo una pudo responder claramente qué es CI y explicar cómo se dieron cuenta de que no la tenían. Las demás decían tonterías confusas sobre Jenkins 🙂. Bueno, tenemos Jenkins, hace compilaciones, ¡CI! En la presentación intentaré explicar qué es realmente Continuous Integration y por qué Jenkins y herramientas similares tienen una relación muy débil con eso.
Y así, ¿qué suele venir a la mente al escuchar CI? A la mayoría de la gente le viene a la mente Jenkins, GitLab CI, Travis, etc.
Incluso si lo buscamos en Google, nos mostrarán estas herramientas.
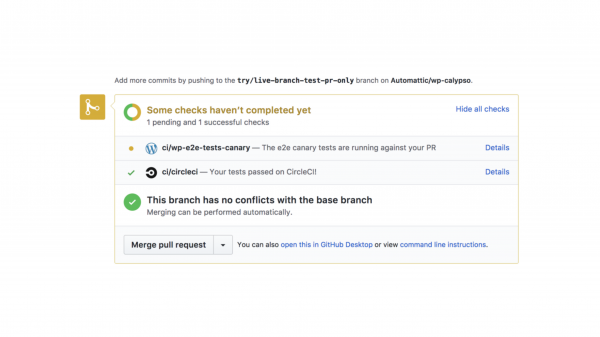
Si preguntamos a los conocidos, justo después de enumerar las herramientas, les contarán que CI es cuando en un Pull Request se realizan compilaciones y pruebas en el commit.
Continuous Integration no se trata de herramientas, ni de compilaciones con pruebas en la rama. Continuous Integration es la práctica de integrar muy frecuentemente nuevo código y para su aplicación no es necesario construir Jenkins, GitLab, etc.
Antes de que analicemos cómo se ve un CI completo, primero sumergámonos en el contexto de las personas que lo idearon y sintamos el dolor que intentaron resolver.
Y enfrentaron el problema de la colaboración en equipo.
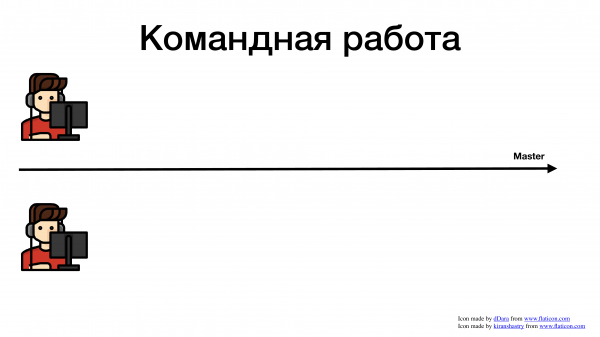
Miremos ejemplos de las dificultades que enfrentan los desarrolladores en el trabajo en equipo. Supongamos que tenemos un proyecto, la rama master en git y dos desarrolladores.
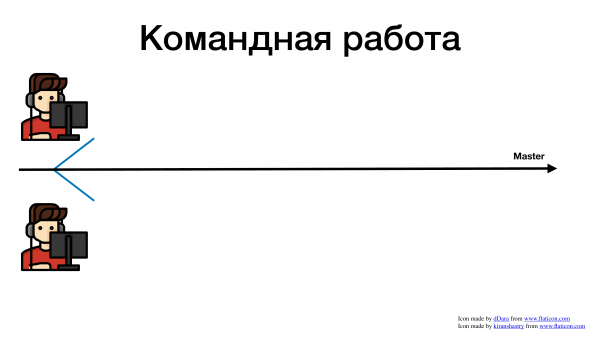
Y comenzaron a trabajar como todos están acostumbrados a hacerlo. Tomaron una tarea en Jira, crearon una rama feature, están escribiendo código.
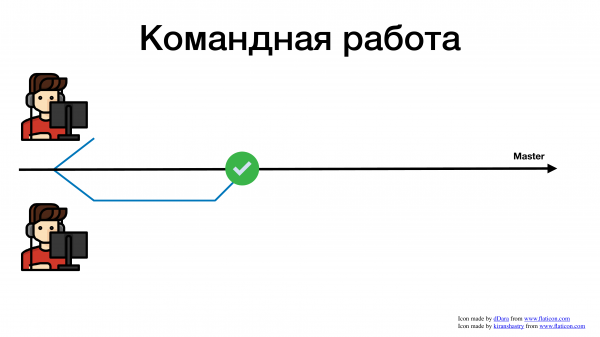
Uno terminó la función más rápido y la fusionó en master.
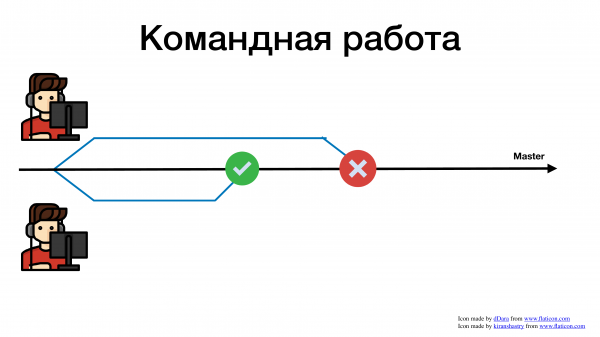
El otro necesitó más tiempo, se fusionó más tarde y recibió un conflicto. Ahora, en lugar de escribir las funciones necesarias para el negocio, el desarrollador gasta su tiempo y esfuerzo resolviendo conflictos.
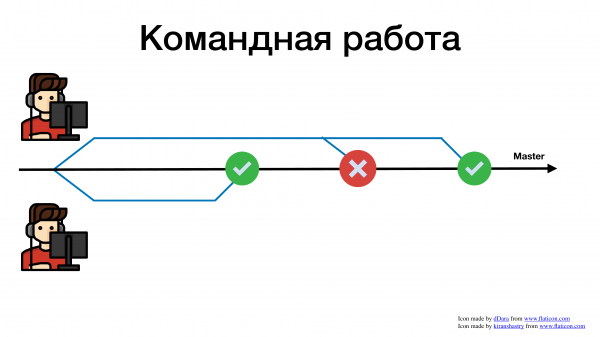
Cuanto más complicado es combinar tu característica con el maestro común, más tiempo pasamos en ello. Y este es un ejemplo bastante simple. Este es un caso donde solo hay 2 desarrolladores. Imagina si hay 10, 15 o 100 personas en la empresa escribiendo en un solo repositorio. Te volverás loco tratando de resolver todos esos conflictos.
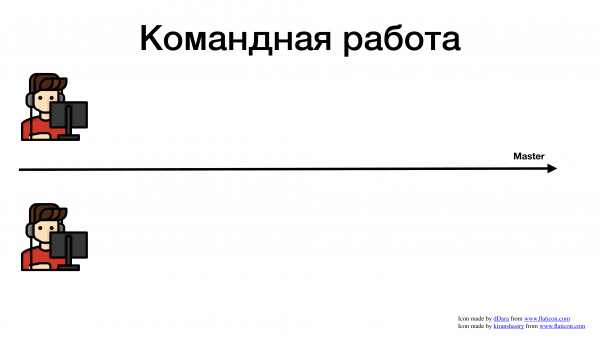
Hay un caso un poco diferente. Tenemos un maestro y varios desarrolladores que están trabajando en algo.
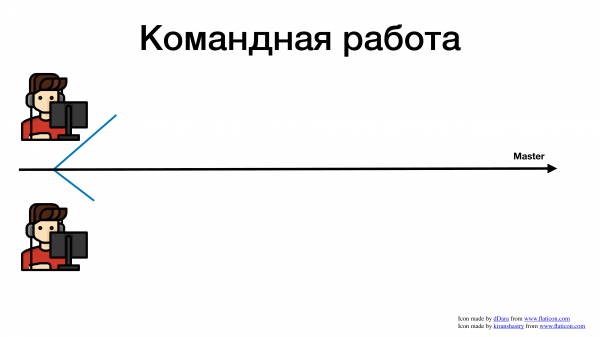
Crearon una rama cada uno.
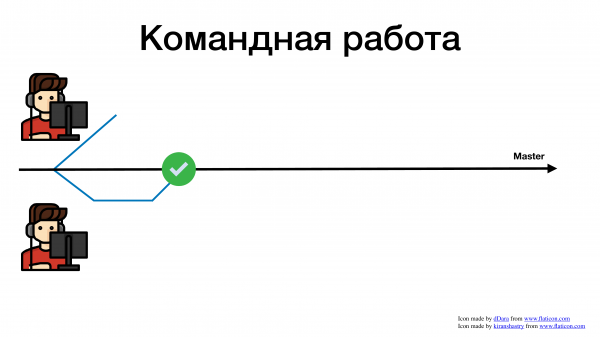
Uno se fusionó, todo bien, entregó la tarea.
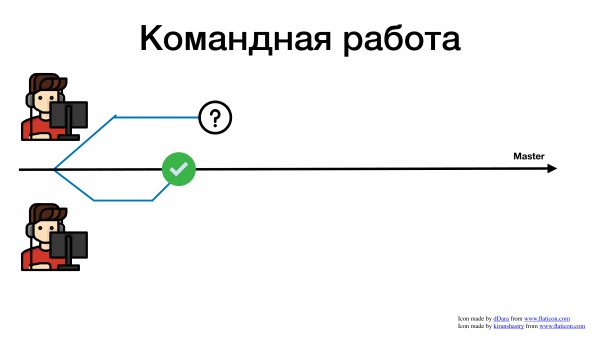
El segundo desarrollador, mientras tanto, entregó su tarea. Supongamos que la envió para revisión. En muchas empresas existe la práctica de la revisión. Por un lado, es una práctica buena y útil, pero por otro, nos frena en muchos aspectos. No profundizaremos en ello, pero aquí hay un gran ejemplo de a dónde puede llevar una historia torcida con la revisión. Entregaste un pull request para revisión. El desarrollador ya no tiene nada más que hacer. ¿Qué empieza a hacer? Comienza a tomar otras tareas.
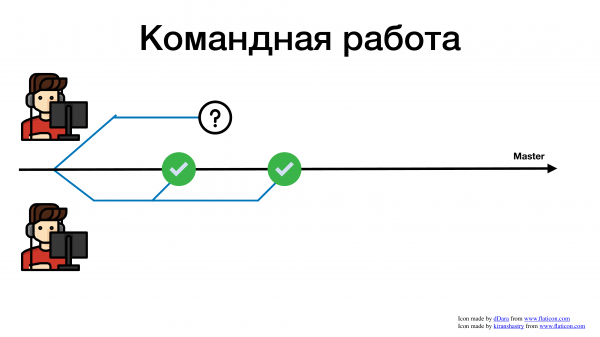
Durante ese tiempo, el segundo desarrollador hizo algo más.
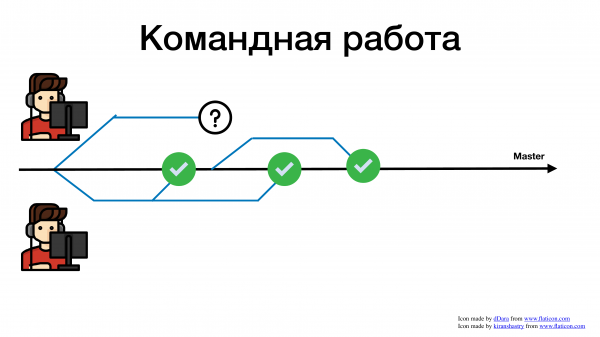
El primero completó la tercera tarea.
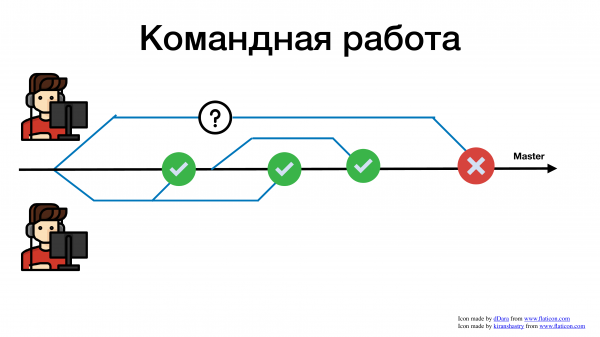
Y después de un tiempo prolongado, su revisión fue probada, y él intenta fusionarse. ¿Y qué sucede? Encuentra una gran cantidad de conflictos. ¿Por qué? Porque mientras su pull request estaba en revisión, el código ya ha cambiado mucho.
Además de la historia de los conflictos, hay una historia sobre las comunicaciones. Mientras tu rama está en revisión, esperando, mientras estás trabajando durante mucho tiempo en la funcionalidad, dejas de seguir qué más está cambiando en la base de código de tu servicio. Es posible que lo que ahora estás tratando de resolver ya se haya solucionado ayer y podrías reutilizar algún método. Pero no lo verás, porque siempre trabajas con una rama desactualizada. Y esta rama desactualizada siempre lleva a tener que resolver conflictos de fusión.
Por lo tanto, si trabajamos en equipo, es decir, no una sola persona está metiendo mano en el repositorio, sino unas 5-10 personas, cuanto más tiempo no añadimos nuestro código al maestro, más sufrimos porque al final hay que fusionar algo. Y cuanto más conflictos tengamos, y cuanto más antigua sea la versión con la que trabajamos, más problemas tendremos.
Hacer algo juntos es doloroso. Siempre nos interrumpimos entre nosotros.
Este problema fue señalado hace más de 20 años. La primera mención de la práctica de la Integración Continua la encontré en la programación extrema.
La programación extrema es el primer marco ágil. La página apareció en 1996. La idea era utilizar ciertas prácticas de programación, planificación y demás, para que el desarrollo fuera lo más flexible posible, para que pudiéramos reaccionar más rápidamente a cambios y requisitos de nuestros clientes. Y hace 24 años comenzaron a enfrentarse al hecho de que si haces algo durante mucho tiempo y por tu cuenta, gastas más tiempo en ello debido a los conflictos.
Ahora desglosaremos la expresión "Integración Continua" palabra por palabra. Si traducimos literalmente, queda integración continua. Pero no está muy claro cuán continua es, porque en realidad es bastante intermitente. Y también no es tan obvio cuán grande es la integración.
Por eso les traigo ahora citas de la programación extrema. Y ambos términos los desglosaremos por separado.
Integración — Como ya mencioné, buscamos que cada ingeniero trabaje con la versión más actual del código, para que su código se añada tan a menudo como sea posible a la rama principal, utilizando ramas pequeñas. Porque si son grandes, podemos quedarnos atrapados durante una semana en conflictos de merge. Especialmente si tenemos un ciclo de desarrollo largo tipo waterfall, donde un desarrollador se dedicó un mes a crear alguna característica enorme. En el momento de la integración, puede quedar atascado durante mucho tiempo.
Integración es cuando tomamos nuestra rama y la integramos con la principal, la fusionamos. Hay una variante definitiva, donde transbasamos al desarrollador, donde buscamos escribir directamente a la rama principal sin crear ramas innecesarias.
En general, la integración es tomar tu código y llevarlo a la rama principal.
¿Qué se entiende aquí por la palabra «continuous» y qué se llama continuidad? La práctica implica que el desarrollador se esfuerza por integrar su código lo más rápido posible. Ese es su objetivo al realizar cualquier tarea: hacer que su código aparezca en el maestro lo más rápido posible. En un mundo ideal, los desarrolladores lo harían cada pocas horas. Es decir, tomas una pequeña tarea, la fusionas en el maestro. Todo está genial. Te esfuerzas por eso. Y hay que hacerlo continuamente. En cuanto haces algo, lo integras inmediatamente en el maestro.
Y el desarrollador que hace algo es responsable de lo que hizo, para que funcione y no rompa nada. Aquí es donde suele surgir la historia de las pruebas. Queremos ejecutar algunas pruebas en nuestro commit, en nuestra fusión, para asegurarnos de que funciona. Y aquí es donde Jenkins puede ser de ayuda.
Pero con historias como: hagamos que los cambios sean pequeños, hagamos que las tareas sean pequeñas, hagamos una tarea y tratemos de fusionarla en el maestro de inmediato, aquí ningún Jenkins puede ayudar. Porque Jenkins solo te ayuda a ejecutar pruebas.
Puedes prescindir de ellos. Eso no te perjudicará en absoluto. Porque el objetivo de la práctica es fusionar lo más a menudo posible, para no perder mucho tiempo en conflictos en el futuro.
Imaginemos que en 2020 por alguna razón no hay internet. Y trabajamos localmente. No tenemos Jenkins. Está bien. Aún puedes crear una rama local. Escribiste algún código en ella. Hiciste la tarea en 3-4 horas. Cambias a maestro, haces un git pull, fusionas tu rama allí. Listo. Si haces esto a menudo, ¡felicitaciones, tienes Integración Continua!
¿Qué evidencias hay en el mundo moderno de que vale la pena invertir esfuerzo en esto? Porque en general es complicado. Si intentas trabajar así, te darás cuenta de que tendrás que hacer algo de planificación, tendrás que dedicar más tiempo a la descomposición de tareas. Porque si haces un man… no podrás fusionar rápido y, por lo tanto, te meterás en problemas. La práctica ya no existirá.
Y esto será caro. No se podrá trabajar desde mañana con Continuous Integration. Todos ustedes se acostumbrarán a descomponer las tareas muy lentamente, se acostumbrarán a rehacer la práctica de revisión, si la tienen. Porque nuestro objetivo es que se integre hoy. Y si hacen la revisión en tres días, entonces tienen problemas y no obtienen Continuous Integration.
Pero, ¿tenemos actualmente algunas pruebas que nos digan que invertir en esta práctica tiene sentido?
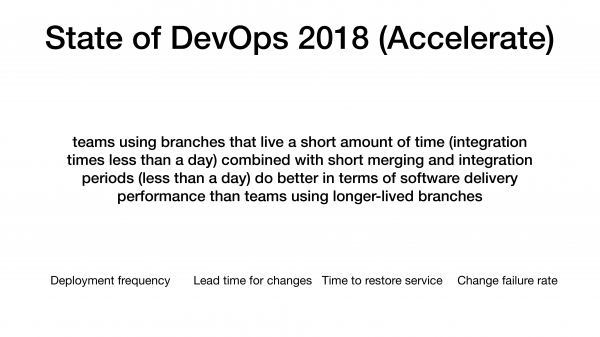
Lo primero que se me ocurre es el State of DevOps. Es un estudio que el equipo ha estado realizando durante 7 años. Ahora lo hacen como una organización independiente, pero bajo Google.
Y su investigación en 2018 mostró una correlación entre las empresas que intentan usar ramas de corta vida, que se integran rápidamente y con frecuencia, y tienen mejores indicadores de rendimiento en TI.
¿Cuáles son esos indicadores? Son 4 métricas que recogen de todas las empresas en sus encuestas: frecuencia de despliegue, tiempo de cambio, tiempo para restaurar el servicio, tasa de fallo en cambios.
Y, en primer lugar, existe esta correlación; sabemos que las empresas que se fusionan con frecuencia tienen métricas significativamente mejores. Y hay una clasificación de las empresas en varias categorías: empresas lentas que producen algo lentamente, de rendimiento medio, de alto rendimiento y la élite. La élite son Netflix, Amazon, que son superrápidos, hacen todo rápido, bonito y de calidad.
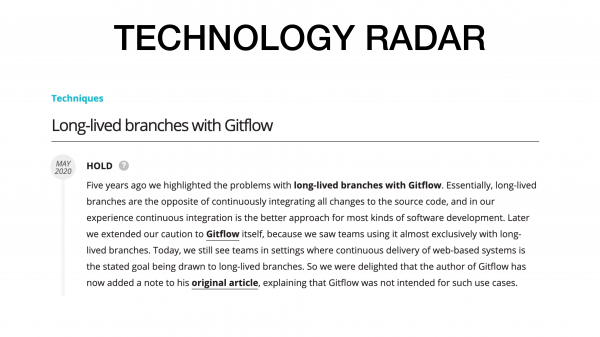
La segunda historia, que ocurrió hace apenas un mes. En el Technology Radar apareció una nota interesante sobre Gitflow. Gitflow se diferencia de los demás en que sus ramas viven mucho tiempo. Hay ramas de lanzamiento que viven mucho tiempo y ramas de características que también viven mucho. Esta práctica se movió a HOLD en el Technology Radar. ¿Por qué? Porque las personas se enfrentan a la dificultad de la integración.
Si tu rama vive mucho tiempo, se estanca, se pudre, comenzamos a gastar más tiempo en hacer cambios en ella.
Y recientemente, el autor de Gitflow dijo que si te esfuerzas por la Integración Continua, si deseas integrar tan a menudo como sea posible, entonces Gitflow es una mala idea. En un artículo aparte, mencionó que si tienes un backend donde puedes esforzarte en eso, Gitflow es innecesario para ti, porque Gitflow te ralentizará y te generará problemas de integración.
Esto no significa que Gitflow sea malo y que no debas usarlo. Es adecuado para otros casos. Por ejemplo, cuando necesitas mantener varias versiones de un servicio o aplicación, es decir, cuando necesitas ofrecer soporte durante un período prolongado.
Pero si hablas con personas que mantienen esos servicios, escucharás mucho dolor sobre cómo esta versión fue la 3.2, que fue hace 4 meses, y que no se incluyó este arreglo, y ahora, para integrarlo, hay que realizar un montón de cambios. Y así están atascados de nuevo, y pasan una semana tratando de fusionar alguna nueva característica.
Como Alexander Kovalev señaló correctamente en el chat, la correlación no es igual a la causalidad. Es así. Es decir, no hay una relación directa que indique que si tienes Integración Continua, todas las métricas serán excelentes; no es así. Pero hay una correlación positiva, donde si una cosa ocurre, es muy probable que la otra también. No es un hecho, pero es probable. Es solo una correlación.
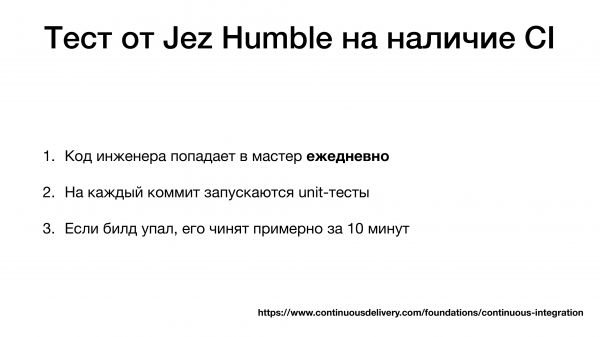
Parece que ya estamos haciendo algo, parece que ya estamos fusionando, pero ¿cómo entender que realmente tenemos Integración Continua, que nos fusionamos con suficiente frecuencia?
Jez Humble es el autor del Handbook, Accelerate, del sitio Continuous Delivery y del libro "Continuous Delivery". Propone esta prueba:
- El código del ingeniero llega a master a diario.
- Por cada commit, ejecutas pruebas unitarias.
- La compilación en master falló, y se reparó en aproximadamente 10 minutos.
Él sugiere utilizar esta prueba para asegurarte de que efectivamente estás practicando.
Lo último que encuentro un poco discutible. Es decir, si puedes arreglarlo en 10 minutos, entonces tienes Integración Continua; suena un poco extraño, en mi opinión, pero tiene sentido. ¿Por qué? Porque si haces merges con frecuencia, significa que tus cambios son pequeños. Si un pequeño cambio hace que tu compilación master falle, podrás encontrar el problema rápidamente porque el cambio es pequeño. Has tenido un pequeño merge en el que cambiaron 20-30 líneas. Y, por lo tanto, podrás entender rápidamente cuál fue la causa, porque los cambios son minúsculos, tienes un área de búsqueda del problema muy reducida.
E incluso si después del lanzamiento se cae el prod, si tenemos la práctica de Integración Continua, es mucho más fácil actuar, porque los cambios son pequeños. Sí, esto afectará la planificación. Va a ser doloroso. Y, probablemente, lo más difícil en esta práctica es acostumbrarse a descomponer las tareas, es decir, cómo hacer algo y completarlo en unas pocas horas y pasar la revisión, si la tienes. La revisión es un dolor aparte.
Las pruebas unitarias son simplemente una herramienta que te ayuda a entender si tu integración ha salido bien, si realmente no se ha roto nada. En mi opinión, esto tampoco es un punto del todo obligatorio, porque el sentido de la práctica no se basa en esto.
Esto es un breve resumen sobre Integración Continua. Eso es todo lo que hay en esta práctica. Estoy listo para las preguntas.
En resumen, solo volveré a hacer un repaso:
- Integración Continua no es Jenkins, no es Gitlab.
- No es una herramienta, es una práctica que consiste en hacer merges de nuestro código en master lo más frecuentemente posible.
- Lo hacemos para evitar el gran dolor que surge con los merges en el futuro; es decir, experimentamos un pequeño dolor ahora para no experimentar uno grande después. Ese es todo el sentido.
- La comunicación pasa a través del código, pero rara vez lo veo; sin embargo, para eso también fue diseñado.
Preguntas
¿Qué hacer con las tareas que no se pueden descomponer?
Descomponer. ¿Cuál es el problema? ¿Puedes dar un ejemplo de que hay una tarea y no se puede descomponer?
Hay tareas que no se pueden descomponer en absoluto, por ejemplo, aquellas que requieren una experiencia muy profunda y que realmente pueden tardar un mes en llegar a un resultado razonable.
Si te entendí correctamente, hay una tarea grande y compleja cuyo resultado solo será visible dentro de un mes?
Sí, es correcto. Sí, se podrá evaluar el resultado no antes de un mes.
Está bien. En general, esto no es un problema. ¿Por qué? Porque en este caso, cuando hablamos de ramas, no hablamos de una rama con una función. Las funciones pueden ser grandes y complejas. Pueden involucrar muchos componentes. Y, posiblemente, no podamos completar todo en una sola rama. Eso está bien. Solo necesitamos dividir esta historia. Si la función no está completamente lista, eso no significa que no se puedan fusionar algunos fragmentos de su código. Supongamos que has agregado una migración y dentro de la función hay algunos pasos. Supongamos que tienes un paso: hacer la migración, agregar un nuevo método. Y ya puedes fusionar estas cosas a diario.
Está bien. Entonces, ¿cuál es el sentido de esto?
¿Cuál es el sentido de fusionar pequeñas cosas a diario?
Sí.
Si te rompieron algo, lo ves inmediatamente. Tienes un pequeño fragmento que rompió algo, te resulta más fácil solucionarlo. El sentido está en que fusionar un pequeño fragmento ahora es mucho más fácil que fusionar algo grande en unas semanas. Y el tercer sentido es que otros ingenieros trabajarán con la versión de código actual. Verán que se han agregado algunas migraciones aquí y que ha aparecido algún método que también podrían querer usar. Todos verán lo que está sucediendo en tu código. Esta práctica se realiza precisamente por estas tres razones.
Gracias, ¡pregunta cerrada!
(Oleg Soroka) ¿Puedo agregar algo? Tienes razón, solo quiero añadir una frase.
Bien.
Con la Integración Continua, el código se fusiona en la rama principal no cuando la función está completamente lista, sino cuando la construcción ha dejado de romperse. Y puedes comprometerte al maestro tantas veces como quieras al día. El segundo aspecto es que si no puedes, por alguna razón, dividir una tarea mensual en tareas de al menos tres días, no hablemos de tres horas, significa que tienes un gran problema. Y el hecho de que no tengas Integración Continua es el menor de esos problemas. Significa que tienes problemas con la arquitectura y las prácticas de ingeniería están en cero. Porque incluso si se trata de investigación, en cualquier caso, debe formularse en forma de hipótesis o ciclos.
Hablamos de 4 métricas que distinguen a las empresas exitosas de las rezagadas. Aún hay que alcanzar estas 4 métricas. Si una tarea promedio toma un mes, me concentraría primero en esa métrica. La reduciría a 3 días. Después de eso, empezaría a pensar en Continuous.
¿Entendí bien que piensas que, en general, invertir en prácticas de ingeniería no tiene sentido si cualquier tarea toma un mes?
Tienes Continuous Integration. Y hay un tema en el que, en 10 minutos, o corriges el error o lo retrocedes. Imagina que lo implementaste. Y tienes incluso continuous deployment, lo lanzaste en producción y luego te das cuenta de que algo salió mal. Necesitas retroceder, pero ya has migrado la base de datos. La estructura de la base de datos ya está en una versión más reciente, además, ya ha pasado alguna copia de seguridad, y se han registrado datos allí.
¿Y qué alternativa tienes? Si retrocedes el código, ya no puede funcionar con esta base de datos actualizada.
La base avanza solo hacia adelante, sí.
Las personas con malas prácticas de ingeniería probablemente tampoco leyeron un libro grueso sobre… ¿qué hacer con las copias de seguridad? Si te recuperas de una copia de seguridad, significa que pierdes los datos que se han generado en ese momento. Por ejemplo, trabajaste tres horas con la nueva versión de la base de datos, y los usuarios se registraron allí. Retrocedes a la copia de seguridad antigua porque con la nueva versión la estructura no funciona, así que esos usuarios se pierden. Y están descontentos, se quejan.
Para dominar todo el espectro de prácticas que respaldan la Integración Continua y la Entrega Continua, no es suficiente con aprender a escribir simplemente… En primer lugar, pueden llegar a ser muchas y eso sería poco práctico. Además, hay un montón de otras prácticas como la Científica. Hay una práctica que GitHub popularizó en su momento. Es cuando ejecutas al mismo tiempo el código antiguo y el nuevo. Es cuando estás trabajando en una función no terminada, pero que puede devolver algún valor: ya sea como función o como API Rest. Ejecutas tanto el código nuevo como el antiguo y comparas la diferencia entre ellos. Y si hay una diferencia, registras ese evento. De esta manera, sabes que tu nueva característica está lista para ser implementada sobre la antigua, si no ha habido discrepancias entre los dos durante un tiempo determinado.
Hay cientos de tales prácticas. Yo sugeriría comenzar con el desarrollo transbase. No está 100 % enfocado en la Integración Continua, pero las prácticas son las mismas, y una sin la otra no funciona bien.
¿Has mencionado el desarrollo transbase como ejemplo de dónde se pueden ver las prácticas o estás sugiriendo a las personas que empiecen a usar el desarrollo transbase?
Mirar, ya que no podrán usarlo. Para poder utilizarlo, hay que leer mucho. Y cuando la pregunta de una persona es: "¿Qué hacer con una característica que toma un mes?", eso significa que no ha leído sobre el desarrollo transbase. Yo no recomendaría eso por ahora. Sugeriría concentrarse exclusivamente en el tema de cómo descomponer arquitectónicamente tareas grandes en tareas más pequeñas. Esa es la esencia de la descomposición.
La descomposición es una de las herramientas del arquitecto. Primero hacemos un análisis, luego la descomposición, después la síntesis, y finalmente la integración. Así es como todo encaja. Y hay que crecer hacia la Integración Continua a través de la descomposición. En la primera etapa surgen preguntas, y ya estamos hablando de la cuarta etapa, es decir, cuanto más frecuente sea la integración, mejor. Aún es pronto para hacerlo; sería bueno primero descomponer tu monolito.
Es necesario dibujar algunas flechas y rectángulos en algún esquema. No puedes decir que ahora voy a mostrar el diagrama arquitectónico de una nueva aplicación y mostrar un solo cuadrado, dentro del cual hay un botón verde para la aplicación. En cualquier caso, habrá más cuadrados y flechas. En cualquier diagrama que he visto, había más de uno. Y la descomposición, incluso a nivel de presentación gráfica, ya se está realizando. Por lo tanto, se pueden hacer rectángulos independientes. Si no, tengo muchas preguntas para el arquitecto.
Hay una pregunta del chat: «Si la revisión es obligatoria y dura más de un día, ¿qué se hace?».
Tienes problemas con la práctica. La revisión no debería durar más de un día. Esta es la misma historia que la pregunta anterior, solo que un poco más suave. Si la revisión dura un día, significa que, probablemente, se trata de una revisión de un cambio muy grande. Por lo tanto, debe hacerse más pequeña. En el desarrollo de transbase, que Oleg recomendó, hay una historia llamada revisión continua. La idea es que hacemos solicitudes de extracción lo suficientemente pequeñas intencionadamente, porque buscamos fusionarnos constantemente y en pequeñas cantidades. Y por eso la solicitud de extracción cambia una abstracción o 10 líneas. Gracias a esto, la revisión nos lleva un par de minutos.
Si la revisión tarda un día o más, significa que algo no está bien. En primer lugar, puede que tengas problemas con la arquitectura. O es un gran bloque de código, de 1000 líneas, por ejemplo. O tienes una arquitectura tan compleja que la persona no puede entenderla. Este es un problema secundario, pero también habrá que resolverlo. Tal vez ni siquiera necesites revisión. También hay que pensar en eso. La revisión es esa cosa que te frena. Tiene sus ventajas en general, pero hay que entender por qué lo haces. ¿Es para ti una forma rápida de transmitir información? ¿Es para establecer algunos estándares internos? ¿Para qué? Porque la revisión debe hacerse muy rápido o cancelarse por completo. Es como el desarrollo de transbase: una historia muy bonita, pero solo para personas muy maduras.
Con respecto a las 4 métricas, recomendaría que las quites, para entender a qué conduce. Mirar los números, ver la imagen, cuán mal está todo.
(Dmitry) Estoy listo para discutir esto contigo. Los números y métricas son geniales, la práctica es genial. Pero hay que entender si esto es necesario para el negocio. Hay negocios que no necesitan tal velocidad de cambio. Conozco empresas en las que no se pueden hacer cambios cada 15 minutos. Y no porque sean malas. Es un ciclo de vida. Y para implementar la funcionalidad de branches, la funcionalidad de toggle, se requieren conocimientos profundos.
Es complicado. Si deseas leer más sobre la historia de la funcionalidad de toggle, te lo recomiendo encarecidamente. . Y hay un artículo maravilloso de Martin Fowler sobre las funcionalidades de toggle: sobre los tipos que existen, ciclos de vida, etc. La funcionalidad de toggle es compleja.
Y aun así no respondiste a la pregunta: «¿Jenkins es necesario o no?»
Jenkins no es necesario en ningún caso, en realidad. Hablando en serio, herramientas como Jenkins o Gitlab te brindarán comodidad. Podrás ver si la compilación se realizó o no. Pero no te proporcionarán la práctica. Solo te darán un círculo: Ok, no Ok. Y eso, si aún escribes pruebas, porque si no hay pruebas, es casi inútil. Así que es necesario, porque es más conveniente, pero en general se puede vivir sin él, no perderás mucho.
Es decir, si tienes prácticas, ¿significa que no lo necesitas?
Correcto. Recomiendo la prueba de Jez Humble. Tengo una relación ambigua con el último punto. Pero en general, si tienes tres cosas: te fusionas constantemente, ejecutas pruebas en los commits en master y reparas rápidamente la compilación en master, entonces posiblemente no necesites nada más.
Mientras esperamos preguntas de los participantes, tengo una pregunta. Hablamos sobre código de producto. ¿Has utilizado esto para código de infraestructura? ¿Es el mismo código, tiene los mismos principios y el mismo ciclo de vida, o hay otros ciclos de vida y principios? Normalmente, cuando todos hablan sobre Integración y Desarrollo Continuos, olvidan que también existe el código de infraestructura. Y últimamente se está utilizando cada vez más. ¿Deberíamos llevar todas estas reglas allí?
No es solo que debamos, sería genial, porque definitivamente simplificará la vida. En cuanto trabajamos con código, no con scripts en bash, y tenemos código normal.
Espera, espera, el script en bash también es código. No toques a mi viejo amor.
Está bien, no voy a pisotear tus recuerdos. Tengo una aversión personal hacia bash. Se rompen de forma poco agradable y siempre asustan. Y a menudo se rompen de manera impredecible, por lo que no me agrada. Pero bien, supongamos que tienes código en bash. Tal vez realmente no entiendo y hay frameworks decentes para pruebas. Simplemente no estoy al tanto. Y obtenemos los mismos beneficios.
Una vez que trabajamos con infraestructura como código, obtenemos los mismos problemas que los desarrolladores. Hace unos meses me encontré en una situación en la que un colega me envió un pull request de 1,000 líneas en bash. Y te quedas atascado en la revisión durante 4 horas. Los problemas son los mismos. Todavía es código. Y aún es trabajo colaborativo. Nos quedamos atascados con el pull request y lidiamos con los mismos conflictos de fusión del mismo bash, por ejemplo.
Actualmente estoy observando intensamente esta cuestión de la programación de infraestructura de la manera más hermosa. He incorporado Pulumi a la infraestructura. Esto es programación en su máxima expresión. Es aún más atractivo, porque tengo todas las posibilidades del lenguaje de programación, es decir, con las mismas condiciones hice toggles bonitos en un abrir y cerrar de ojos y todo va bien. Es decir, mi cambio ya está en el master. Todos ya lo ven. Otros ingenieros están al tanto. Ya ha influido en algo. Pero no se ha activado para todas las infraestructuras. Se activó para mis entornos de prueba, por ejemplo. Por lo tanto, respondiendo a tu pregunta una vez más, es necesario. Esto, para nosotros como ingenieros que trabajamos con código, definitivamente facilita la vida.
¿Alguien más tiene preguntas?
Tengo una pregunta. Quiero continuar la discusión con Oleg. En general, creo que tienes razón, que si una tarea te lleva un mes, entonces tienes un problema con la arquitectura, tienes un problema con el análisis, la descomposición, la planificación, etc. Pero tengo la sensación de que si comienzas a tratar de vivir con la Integración Continua, empezarás a corregir los problemas con la planificación, porque no puedes escapar de eso.
(Oleg) Sí, es así. En términos de esfuerzo, esta práctica es comparable a cualquier otra práctica seria que cambie la cultura. Lo más difícil de superar son los hábitos, especialmente los malos hábitos. Y si para implementar esta práctica se requiere un cambio significativo en los hábitos de quienes te rodean: desarrolladores, dirección, gerente de producción, entonces te esperan sorpresas.
¿Qué sorpresas pueden haber? Supongamos que decidiste que harás más integraciones. Y en la integración tienes atados algunas cosas, como artefactos. Y en tu empresa, por ejemplo, hay una política de que cada artefacto debe ser contabilizado de alguna manera en un sistema de almacenamiento de artefactos. Y esto toma un cierto tiempo. La persona necesita marcar que, como gerente de lanzamientos, ha probado este artefacto para su disposición en producción. Si esto toma 5-10-15 minutos, pero al mismo tiempo haces lanzamientos una vez a la semana, entonces gastar media hora una vez a la semana no es un gran impuesto.
Si realizas Integración Continua 10 veces al día, entonces debes multiplicar 10 veces por 30 minutos. Y esto supera la cantidad de tiempo laboral de ese gerente de lanzamientos. Simplemente se cansa de hacerlo. Hay costos constantes asociados a ciertas prácticas. Y eso es todo.
Y necesitas o cancelar esta regla, para que ya no te ocupes de tonterías, es decir, no asignas manualmente un grado de conformidad de algo a algo. Confías total y completamente en un conjunto automatizado de pruebas de preparación.
Y si necesitas que alguien te dé pruebas para que el jefe firme, y no entras en producción sin que Vasya haya dicho que lo permite, etc., toda esta tontería se interpone en el camino de las prácticas. Porque si hay actividades relacionadas que son como un impuesto, todo se multiplica por 100. Por lo tanto, el cambio generalmente no es bien recibido por todos. Porque es difícil corregir los hábitos de la gente.
Cuando una persona realiza un trabajo habitual, lo hace prácticamente sin pensarlo. Su carga cognitiva es igual a cero. Simplemente se dedica a lo que ya está, tiene una lista de verificación en su cabeza, lo ha hecho mil veces. Y tan pronto como llegas y le dices: 'Vamos a cancelar esta práctica y a partir del lunes implementaremos una nueva', para él se convierte en una carga cognitiva enorme. Y esto afecta a todos de inmediato.
Por lo tanto, lo más fácil, aunque esta es una lujo que no todos pueden permitirse, es siempre hacer exactamente eso, lo siguiente. Si se lanza un nuevo proyecto, por lo general se introducen de inmediato todas las prácticas no probadas en este proyecto. Mientras el proyecto es joven, no estamos asumiendo un gran riesgo. No hay producción, no hay nada que destruir. Por lo tanto, se puede utilizar como práctica. Este enfoque funciona. Sin embargo, no todas las empresas tienen la oportunidad de iniciar tales proyectos con frecuencia. Aunque esto también resulta un poco extraño, porque actualmente estamos en plena transformación digital, todos deberían lanzar experimentos para seguir el ritmo de la competencia.
Aquí te enfrentas a que primero debes tener claridad sobre lo que necesitas hacer. El mundo no es perfecto, la producción tampoco es perfecta.
Sí, estas cosas están interrelacionadas.
Las empresas tampoco siempre tienen claridad sobre que necesitan dirigirse hacia eso.
Hay situaciones en las que ningún cambio es posible. Esta es una situación en la que hay más presión sobre el equipo. El equipo ya está bastante quemado. No tiene tiempo extra para ningún tipo de experimentos. Desde la mañana hasta la noche están desarrollando características. Y la dirección siempre pide más y más características. Se necesita cada vez más. En tal situación, no es posible realizar ningún cambio. Solo se les puede decir al equipo que mañana haremos lo mismo que ayer, solo que necesitamos hacer un poco más de características. No hay transición a ninguna práctica significativa en este sentido. Esta es una situación clásica donde no hay tiempo para afilar el hacha, hay que talar árboles, así que se talan con un hacha desafilada. Aquí no hay consejos sencillos.
(Dmitry) Voy a leer una aclaración del chat: «Pero es necesario tener una amplia cobertura de pruebas a diferentes niveles. ¿Cuánto tiempo se dedica a las pruebas? Es algo costoso, lleva mucho tiempo».
(Oleg) Este es un mito clásico. Debe haber suficientes pruebas para que ustedes mismos tengan confianza. La Integración Continua no es algo donde primero se realizan el 100% de las pruebas y solo luego se comienza a aplicar esta práctica. La Integración Continua reduce su carga cognitiva porque cada uno de los cambios que ven con sus propios ojos es tan obvio que pueden entender si va a romper algo o no, incluso sin pruebas. Pueden probarlo rápidamente en su mente, porque son cambios pequeños. Incluso si solo tienen testers manuales, para ellos también es más sencillo. Ustedes hacen un despliegue y dicen: 'Mira, ¿no se rompió nada?'. Ellos verifican y dicen: 'No, no se rompió nada'. Porque el tester sabe a dónde mirar. Tienen un commit relacionado con un fragmento de código. Y esto se explota hacia un comportamiento específico.
Aquí, por supuesto, has embellecido las cosas.
(Dmitry) Aquí no estoy de acuerdo. Existe una práctica: desarrollo a través de pruebas, que es precisamente lo que salvará de esto.
(Oleg) Aún no he llegado a eso. La primera ilusión es que hay que escribir el 100% de las pruebas o no se debe hacer nada relacionado con la Integración Continua. Eso es falso. Son dos prácticas paralelas. Y no dependen entre sí directamente. Su cobertura de pruebas debe ser óptima. Óptima significa que ustedes mismos están seguros de que la calidad del maestro, que quedó después del commit, les permite presionar el botón 'Deploy' con confianza el viernes por la noche, incluso si han bebido. ¿Cómo logran esto? A través de revisiones, cobertura y buen monitoreo.
Un buen monitoreo es indistinguible de las pruebas. Si ejecutan las pruebas una vez en pre producción, solo verifican todos sus escenarios de usuario una vez. Pero si las ejecutan en un ciclo infinito, esto se convierte en su sistema de monitoreo desplegado, que prueba todo de forma continua – si falló o no. En este caso, la única diferencia es si es una vez o muchas veces. Un conjunto muy bueno de pruebas..., ejecutado de forma infinita, es monitoreo. Y el monitoreo correcto debe ser así.
Y por lo tanto, cómo exactamente lograrán este estado, donde el viernes por la noche despliegan y se van a casa, es otra cuestión. Tal vez simplemente sean un atrevido.
Volvamos un poco atrás a la Integración Continua. Nos hemos desviado hacia otra práctica compleja.
Y la segunda ilusión es que, se dice, hay que hacer el MVP rápidamente, por lo que no se necesitan pruebas en absoluto. No es del todo así. La cuestión es que cuando escribes una historia de usuario para el MVP, puedes desarrollarla de dos maneras: o a la ligera, es decir, escuchas que hay alguna historia de usuario y te pones a codificarla de inmediato, o puedes trabajar con TDD. Y con TDD, como demuestra la práctica, no se tarda más, es decir, las pruebas son un efecto secundario. La práctica de TDD no se trata de probar. A pesar de que se llama Desarrollo Impulsado por Pruebas, realmente no se trata de pruebas. También es más bien un enfoque arquitectónico. Es un enfoque sobre cómo escribir exactamente lo que se necesita y no escribir lo que no se necesita. Esta práctica se centra en la siguiente iteración de tu desarrollo de ideas en términos de creación de la arquitectura de la aplicación.
Por lo tanto, no es tan fácil deshacerse de estas ilusiones. El MVP y las pruebas no se contradicen mutuamente. De hecho, más bien, si haces tu MVP siguiendo la práctica de TDD, lo harás mejor y más rápido que si lo haces sin ninguna práctica y a la ligera.
Es un pensamiento muy poco obvio y complicado. Cuando escuchas que ahora vas a escribir más pruebas y aun así vas a hacer algo más rápido, suena absolutamente inadecuado.
(Dmitry) Aquí muchos, cuando mencionan el MVP, es que la gente simplemente no quiere escribir algo decente. Y, de hecho, son cosas diferentes. No conviertas el MVP en algo que no funcione.
Sí, tienes razón.
Y luego, de repente, el MVP en producción.
Para siempre.
Y TDD suena muy extraño cuando escuchas que estás escribiendo pruebas y parece que tienes más trabajo. Suena muy raro, pero en realidad resulta más rápido y más estético. Cuando escribes una prueba, ya piensas mucho en cómo será el código, cómo será invocado, y también qué comportamiento esperamos de él. No solo dices que has escrito alguna función y que hace algo. Primero piensas en qué condiciones tendrá, cómo será invocada. Cubres esto con pruebas y a partir de ahí entiendes cómo se verán las interfaces dentro de tu código. Esto influye mucho en la arquitectura. Tu código automáticamente se vuelve más modular, porque primero intentas entender cómo lo vas a probar, y solo luego lo escribes.
En mi experiencia con TDD, en algún momento contraté un mentor de Ruby cuando aún era programador de Ruby. Él me dijo: "Hagamos esto usando TDD". Y pensé: "Vaya, ahora tengo que escribir algo adicional". Entonces acordamos que durante dos semanas, escribiría todo el código funcional en Python usando TDD. Al cabo de esas dos semanas, comprendí que ya no quería volver atrás. Al intentar aplicarlo en todos lados durante dos semanas, te das cuenta de lo mucho más fácil que se vuelve incluso solo pensar. Pero no es obvio, así que recomiendo a todos que, si sienten que TDD es complicado, largo y innecesario, lo intenten por dos semanas. A mí me bastaron esos dos para darme cuenta.
(Dmitry) Podemos desarrollar esta idea desde la perspectiva de la explotación de infraestructura. Antes de lanzar algo nuevo, hacemos un monitoreo y luego lo lanzamos. En este caso, el monitoreo se convierte en una prueba normal. Y hay desarrollo a través del monitoreo. Pero casi todos dicen que es largo, que les da pereza, y que hacen un borrador temporal. Si hacemos un monitoreo adecuado, entendemos el estado del sistema CI. Y en el sistema CI hay mucho monitoreo. Entendemos el estado del sistema, entendemos lo que hay dentro de él. Y durante el desarrollo, precisamente creamos el sistema para que alcance el estado deseado.
Estas prácticas son conocidas desde hace tiempo. Hace unos 4 años lo discutimos. Pero en 4 años prácticamente nada ha cambiado.
Pero propongo finalizar esta discusión oficial en esta nota.
Video (insertado como elemento multimedia, pero por alguna razón no funciona):
Fuente: habr.com
