

Nota de traducción.: Esta instructiva historia de Omio, un agregador de viajes europeo, lleva a los lectores desde la teoría básica hasta los emocionantes matices prácticos de la configuración de Kubernetes. Familiarizarse con tales casos no solo ayuda a ampliar horizontes, sino también a prevenir problemas no trivialidades.
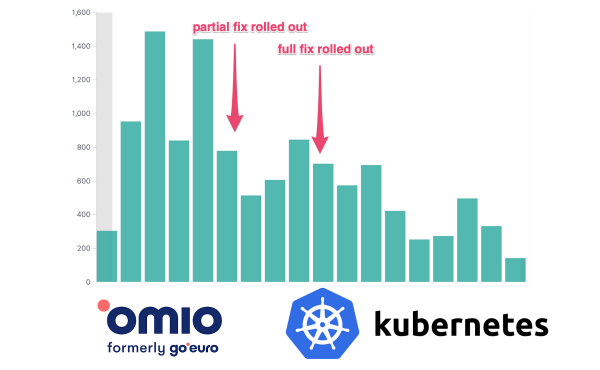
¿Alguna vez se ha encontrado con que una aplicación se "atascaba" en su lugar, dejaba de responder a las solicitudes de verificación de estado (health checks) y no podía entender la causa de dicho comportamiento? Una posible explicación está relacionada con el límite de cuotas en los recursos de CPU. De eso trata este artículo.
TL;DR:
Recomendamos encarecidamente evitar los límites de CPU en Kubernetes (o desactivar las cuotas CFS en Kubelet) si se utiliza una versión del kernel de Linux con errores en las cuotas CFS. En el núcleo hay un error grave y que causa un exceso de throttling y retrasos.
En Omio toda la infraestructura está gestionada por Kubernetes. Todas nuestras cargas de trabajo stateful y stateless funcionan exclusivamente en Kubernetes (utilizamos Google Kubernetes Engine). En los últimos seis meses, hemos observado un retraso aleatorio. Las aplicaciones se congelan o dejan de responder a las verificaciones de estado, pierden conexión con la red, etc. Comportamientos como este nos han dejado en un callejón sin salida durante mucho tiempo, y finalmente decidimos abordar el problema de cerca.
Resumen del artículo:
- Algunas palabras sobre contenedores y Kubernetes;
- Cómo están implementadas las solicitudes y límites de CPU;
- Cómo funciona el límite de CPU en entornos de múltiples núcleos;
- Cómo monitorear el throttling de CPU;
- Solución del problema y matices.
Algunas palabras sobre contenedores y Kubernetes
Kubernetes es, en esencia, el estándar moderno en el mundo de la infraestructura. Su principal tarea es la orquestación de contenedores.
Contenedores
En el pasado, teníamos que crear artefactos como JAR/WAR de Java, Egg de Python o archivos ejecutables para su posterior ejecución en servidores. Sin embargo, para hacerlos funcionar, era necesario realizar un trabajo adicional: instalar el entorno de ejecución (Java/Python), colocar los archivos necesarios en los lugares correctos, asegurar la compatibilidad con una versión específica del sistema operativo, etc. En otras palabras, había que prestar especial atención a la gestión de configuraciones (lo que a menudo causaba disputas entre desarrolladores y administradores de sistemas).
Los contenedores cambiaron todo. Ahora, el artefacto es una imagen de contenedor. Se puede imaginar como un archivo ejecutable ampliado que contiene no solo el programa, sino también un entorno de ejecución completo (Java/Python/…), así como los archivos/paquetes necesarios, preinstalados y listos para ejecutarse. Los contenedores se pueden desplegar y ejecutar en varios servidores sin ninguna acción adicional.
Además, los contenedores funcionan en su propio entorno aislado. Tienen su propio adaptador de red virtual, su propio sistema de archivos con acceso restringido, su jerarquía de procesos, sus límites en CPU y memoria, etc. Todo esto se realiza gracias a una subsistema especial del núcleo de Linux: namespaces.
Kubernetes
Como se mencionó anteriormente, Kubernetes es un orquestador de contenedores. Funciona de la siguiente manera: usted le proporciona un conjunto de máquinas y luego dice: 'Ey, Kubernetes, ejecuta diez instancias de mi contenedor con 2 procesadores y 3 GB de memoria cada una, ¡y manténlas en funcionamiento!'. Kubernetes se encargará de todo lo demás. Encontrará recursos disponibles, iniciará los contenedores y los reiniciará cuando sea necesario, implementará actualizaciones al cambiar de versiones, etc. En esencia, Kubernetes permite abstraerse del componente de hardware y hace que todas las diversas configuraciones de sistemas sean adecuadas para desplegar y ejecutar aplicaciones.
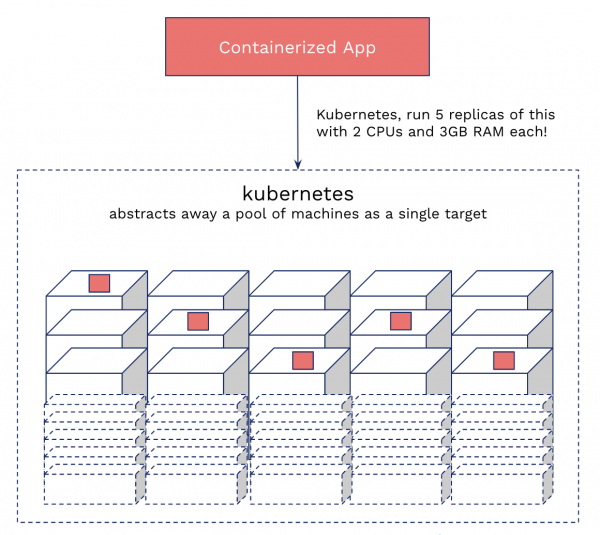
Kubernetes desde la perspectiva del ciudadano común
¿Qué son los requests y limits en Kubernetes?
Bien, hemos entendido sobre los contenedores y Kubernetes. También sabemos que varios contenedores pueden estar en una misma máquina.
Se puede hacer una analogía con un departamento compartido. Se toma un espacio amplio (máquinas/nodos) y se alquila a varios inquilinos (contenedores). Kubernetes actúa como el agente inmobiliario. Surge la pregunta de cómo evitar que los inquilinos entren en conflicto entre sí. ¿Qué pasa si uno de ellos, digamos, decide ocupar el baño durante medio día?
Aquí es donde entran en juego los requests y limits. CPU Request se necesita exclusivamente para la planificación. Es algo así como una 'lista de deseos' del contenedor y se utiliza para encontrar el nodo más adecuado. Al mismo tiempo, CPU Límite se puede comparar con un contrato de alquiler: una vez que seleccionamos un nodo para el contenedor, este no podrá superar los límites establecidos. Y aquí es donde surge el problema...
¿Cómo se implementan las solicitudes y límites en Kubernetes?
Kubernetes utiliza un mecanismo de throttling (estrangulamiento) integrado en el núcleo para implementar los límites de CPU. Si la aplicación excede el límite, se activa el throttling (es decir, recibe menos ciclos de CPU). Las solicitudes y límites para la memoria están organizados de manera diferente, por lo que son más fáciles de detectar. Para esto, es suficiente verificar el último estado de reinicio del pod: si no es "OOMKilled". Con el throttling de CPU, las cosas no son tan simples, ya que K8s solo proporciona métricas de uso, no de cgroups.
Solicitud de CPU
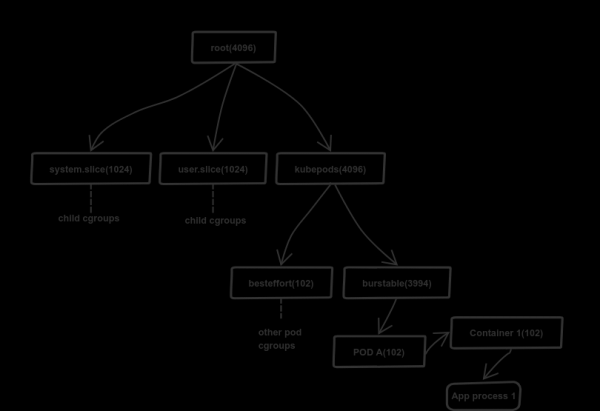
¿Cómo se implementa la solicitud de CPU?
Para simplificar, consideremos el proceso utilizando una máquina con un CPU de 4 núcleos.
K8s utiliza el mecanismo de grupos de control (cgroups) para gestionar la distribución de recursos (memoria y CPU). Tiene un modelo jerárquico: un hijo hereda los límites del grupo padre. Los detalles de la distribución se almacenan en un sistema de archivos virtual (/sys/fs/cgroup). En el caso de la CPU, esto es /sys/fs/cgroup/cpu,cpuacct/*.
K8s utiliza el archivo cpu.share para distribuir los recursos de CPU. En nuestro caso, el grupo de control raíz recibe 4096 partes de recursos de CPU, que equivale al 100% de la potencia de CPU disponible (1 núcleo = 1024; este es un valor fijo). El grupo raíz distribuye los recursos de manera proporcional según las partes de los descendientes especificadas en cpu.share, y estos, a su vez, hacen lo mismo con sus descendientes, etc. En un nodo típico de Kubernetes, el grupo de control raíz tiene tres descendientes: system.slice, user.slice y kubepods. Los dos primeros subgrupos se utilizan para distribuir recursos entre cargas críticas del sistema y programas de usuario externos a K8s. El último — kubepods — es creado por Kubernetes para distribuir recursos entre los pods.
En el diagrama de arriba se puede ver que el primer y segundo subgrupo recibieron cada uno 1024 partes, mientras que al subgrupo kubepod se le asignaron 4096 partes. ¿Cómo es esto posible? Dado que al grupo raíz solo le están disponibles 4096 partes, y la suma de las partes de sus descendientes supera con creces este número (6144)? La clave es que el valor tiene un sentido lógico, por lo que el programador de Linux (CFS) lo utiliza para la distribución proporcional de los recursos de CPU. En nuestro caso, los dos primeros grupos reciben cada uno 680 partes reales (16,6% de 4096), y kubepod recibe las restantes 2736 partes. En caso de inactividad, los dos primeros grupos no utilizarán los recursos asignados.
Afortunadamente, el programador tiene un mecanismo que permite evitar la pérdida de recursos de CPU no utilizados. Transfiere las capacidades "en espera" a un grupo global, del cual se distribuyen a los grupos que necesitan capacidades de procesador adicionales (la transferencia se realiza por lotes para evitar pérdidas por redondeo). Un método similar se aplica a todos los descendientes.
Este mecanismo asegura una distribución equitativa de las capacidades de procesamiento y previene que un proceso "robe" recursos de otros.
Límite de CPU
Aunque las configuraciones de límites y solicitudes en K8s son similares, su implementación difiere radicalmente: es la parte más engañosa y menos documentada.
K8s utiliza para implementar límites. Sus configuraciones se establecen en los archivos cfs_period_us y cfs_quota_us en el directorio cgroup (donde también se encuentra el archivo cpu.share).
A diferencia de cpu.share, la cuota se basa en un período de tiempo, no en la capacidad de procesamiento disponible. cfs_period_us define la duración del período (era) — siempre es 100000 µs (100 ms). En K8s hay opción de cambiar este valor, aunque por ahora está disponible solamente en la versión alfa. El programador utiliza la era para reiniciar las cuotas utilizadas. El segundo archivo, cfs_quota_us, define el tiempo disponible (cuota) en cada era. Nota que también se especifica en microsegundos. La cuota puede exceder la duración de la era; en otras palabras, puede ser mayor a 100 ms.
Veamos dos escenarios en máquinas de 16 núcleos (el tipo de computadora más común que tenemos en Omio):
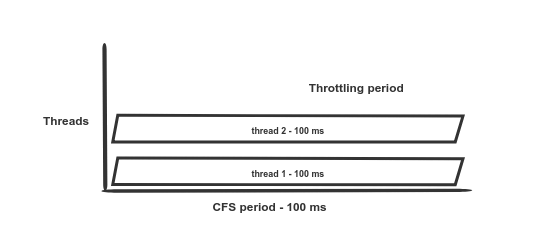
Escenario 1: 2 hilos y un límite de 200 ms. Sin estrangulamiento.
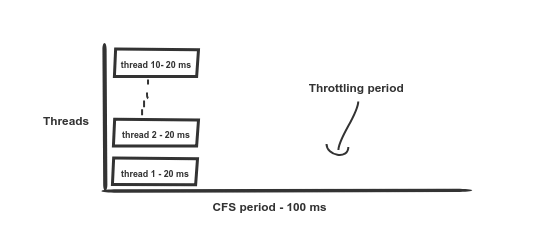
Escenario 2: 10 hilos y un límite de 200 ms. El estrangulamiento comienza después de 20 ms, el acceso a los recursos de CPU se reanuda otros 80 ms después.
Supongamos que estableciste un límite de CPU en 2 núcleos; Kubernetes convertirá este valor a 200 ms. Esto significa que el contenedor puede usar un máximo de 200 ms de tiempo de CPU sin estrangulamiento.
Y aquí es donde comienza lo interesante. Como se mencionó anteriormente, la cuota disponible es de 200 ms. Si tienes diez hilos funcionando en una máquina de 12 núcleos (ver ilustración del escenario 2), mientras todos los demás pods están inactivos, la cuota se agotará en solo 20 ms (ya que 10 * 20 ms = 200 ms), y todos los hilos de este pod "se estrangularán" (throttle) (throttle) en los siguientes 80 ms. Agrava la situación el ya mencionado , que provoca un throttling excesivo y el contenedor no puede utilizar ni siquiera su cuota existente.
¿Cómo evaluar el throttling en los pods?
Simplemente ingrese al pod y ejecute cat /sys/fs/cgroup/cpu/cpu.stat.
-
nr_periods— número total de períodos del planificador; -
nr_throttled— número de períodos throttled dentro denr_periods; -
throttled_time— tiempo total en throttled en nanosegundos.
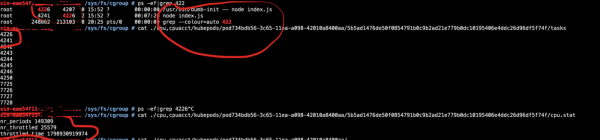
¿Qué está sucediendo realmente?
Al final, tenemos un alto throttling en todas las aplicaciones. ¡A veces es una vez y media más fuerte de lo esperado!
Esto conduce a varios errores: fallos en las comprobaciones de disponibilidad (readiness), bloqueos de contenedores, cortes en las conexiones de red, timeouts en las llamadas de servicio. En última instancia, se traduce en un aumento de la latencia y un mayor número de errores.
Solución y consecuencias
Es simple. Renunciamos a los límites de CPU y nos enfocamos en actualizar el núcleo del sistema operativo en los clústeres a la versión más reciente, donde el error fue corregido. El número de errores (HTTP 5xx) en nuestros servicios disminuyó significativamente de inmediato:
Errores HTTP 5xx
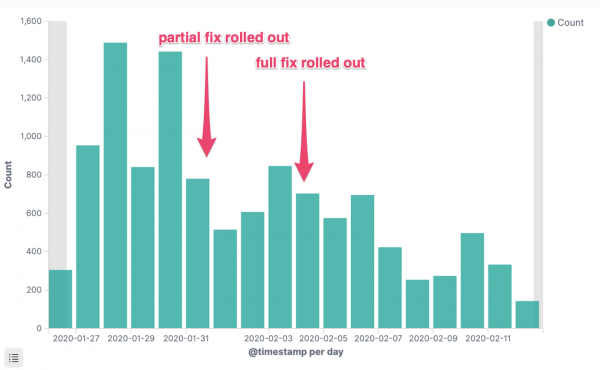
Errores HTTP 5xx de un servicio crítico
Tiempo de respuesta p95
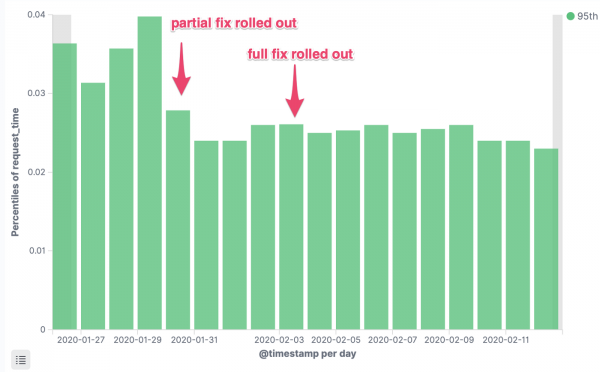
Latencia de las solicitudes del servicio crítico, percentil 95
Gastos de operación
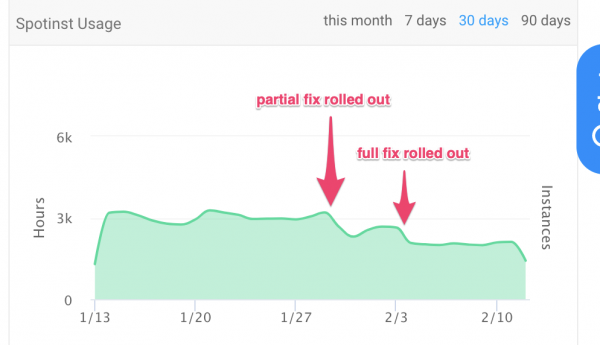
Número de horas de instancia gastadas
¿Cuál es el truco?
Como se mencionó al principio del artículo:
Se puede hacer una analogía con un apartamento compartido… Kubernetes actúa como el agente inmobiliario. Pero, ¿cómo evitar que los inquilinos tengan conflictos entre sí? ¿Qué pasa si uno de ellos, digamos, decide ocupar el baño durante medio día?
Aquí está el truco. Un contenedor descuidado puede consumir todos los recursos de CPU disponibles en la máquina. Si tiene un stack de aplicaciones adecuado (por ejemplo, JVM, Go, Node VM correctamente configurados), entonces no es un problema: se puede trabajar en esas condiciones durante mucho tiempo. Pero si las aplicaciones están mal optimizadas o no están optimizadas en absoluto (FROM java:latest), la situación puede salirse de control. En Omio tenemos Dockerfiles básicos automatizados con configuraciones predeterminadas razonables para los principales lenguajes de stack, así que no existió ese problema.
Recomendamos monitorear las métricas (uso, saturación y errores), retrasos de API y frecuencia de errores. Asegúrese de que los resultados coincidan con las expectativas.
Enlaces
Esta es nuestra historia. Los siguientes materiales ayudaron mucho a entender lo que está sucediendo:
- ;
- ;
- ;
- ;
- — busque «cpu throttling».
Informes de errores de Kubernetes:
- ;
- ;
- .
¿Has encontrado problemas similares en tu práctica o tienes experiencia relacionada con el throttling en entornos de producción containerizados? ¡Comparte tu historia en los comentarios!
P.D. del traductor
También puedes leer en nuestro blog:
- «»;
- «»;
- «».
Fuente: habr.com
