

¿Sobre qué principios se construye un Almacenamiento de Datos ideal?
Enfoque en el valor empresarial y el análisis en ausencia de código boilerplate. Gestión del DWH como una base de código: versionado, revisión, pruebas automáticas y CI. Modularidad, escalabilidad, código abierto y comunidad. Documentación amigable para el usuario y visualización de dependencias (Data Lineage).
Para más detalles sobre esto y el papel de DBT en el ecosistema de Big Data & Analytics, bienvenidos a continuación.
Hola a todos
Soy Arseniy Kozyr. Llevo más de 5 años trabajando con almacenes de datos, construyendo ETL/ELT, así como análisis de datos y visualización. Actualmente trabajo en , enseño en OTUS en el curso , y hoy quiero compartir con ustedes un artículo que escribí en anticipación al inicio de un nuevo grupo en el curso.
Resumen
El marco DBT trata sobre la letra T en el acrónimo ELT (Extract — Transform — Load).
Con la aparición de bases de datos analíticas tan potentes y escalables como BigQuery, Redshift, Snowflake, ha dejado de tener sentido realizar transformaciones fuera del Almacenamiento de Datos.
DBT no extrae datos de las fuentes, pero ofrece enormes posibilidades para trabajar con los datos que ya están cargados en el Almacenamiento (en Internal o External Storage).
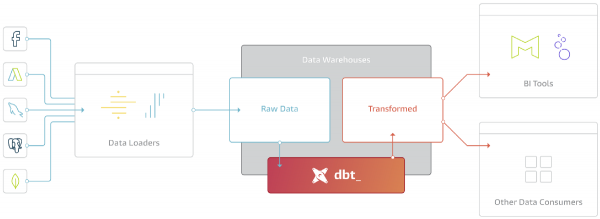
El propósito principal de DBT es tomar el código, compilarlo en SQL, ejecutar comandos en el Almacenamiento en el orden correcto.
Estructura del proyecto DBT
El proyecto consiste en directorios y archivos de solo 2 tipos:
- Modelo (.sql) — unidad de transformación expresada como una consulta SELECT
- Archivo de configuración (.yml) — parámetros, configuraciones, pruebas, documentación
A un nivel básico, el trabajo se organiza de la siguiente manera:
- El usuario prepara el código de los modelos en cualquier IDE que le resulte cómodo
- Mediante CLI se llama a la ejecución de los modelos, DBT compila el código de los modelos en SQL
- El SQL compilado se ejecuta en el Almacenamiento en la secuencia establecida (grafo)
Así es como puede verse la ejecución desde CLI:
Todo está en SELECT
Esta es la característica asesina del marco Data Build Tool. Dicho de otro modo, DBT abstrae todo el código relacionado con la materialización de sus consultas en el Almacenamiento (variaciones de los comandos CREATE, INSERT, UPDATE, DELETE, ALTER, GRANT, ...).
Cualquier modelo implica escribir una única consulta SELECT que define el conjunto de datos resultante.
La lógica de las transformaciones puede ser multinivel y consolidar datos de varios otros modelos. Un ejemplo de un modelo que construirá una vitrina de pedidos (f_orders):
{% set payment_methods = ['credit_card', 'coupon', 'bank_transfer', 'gift_card'] %}

with orders as (

   select * from {{ ref('stg_orders') }}

),

order_payments as (

   select * from {{ ref('order_payments') }}

),

final as (

   select
       orders.order_id,
       orders.customer_id,
       orders.order_date,
       orders.status,
       {% for payment_method in payment_methods -%}
       order_payments.{{payment_method}}_amount,
       {% endfor -%}
       order_payments.total_amount as amount
   from orders
       left join order_payments using (order_id)

)

select * from final
¿Qué podemos ver de interesante aquí?
En primer lugar: Se utilizaron CTE (Expresiones de Tabla Comunes) — para organizar y entender el código que contiene muchas transformaciones y lógica empresarial.
En segundo lugar: El código del modelo es una mezcla de SQL y (lenguaje de plantillas).
En el ejemplo se utiliza un bucle para para formar el total de cada método de pago mencionado en la expresión set. También se utiliza la función ref — una forma de referirse dentro del código a otros modelos:
- Durante la compilación ref se convertirá en un puntero a la tabla o vista en el Almacén
- ref permite construir un gráfico de dependencias de los modelos.
Es precisamente lo que añade a DBT capacidades casi ilimitadas. Los más utilizados son:
- Instrucciones if / else — operadores de ramificación.
- Bucles for — ciclos.
- Variables — variables.
- Macro — creación de macros.
Materialización: Tabla, Vista, Incremental.
La Estrategia de Materialización — un enfoque según el cual el conjunto de datos resultante del modelo se guardará en el Almacén.
En una visión básica, esto es:
- Tabla — tabla física en el Almacén.
- Vista — vista, tabla virtual en el Almacén.
También hay estrategias de materialización más complejas:
- Incremental — carga incremental (de grandes tablas de hechos); se añaden nuevas filas, se actualizan las modificadas y se eliminan las que se han borrado.
- Ephemeral — el modelo no se materializa directamente, sino que participa como CTE en otros modelos.
- Cualquier otra estrategia que puedas añadir tú mismo.
Además de las estrategias de materialización, se ofrecen oportunidades para la optimización para almacenes específicos, por ejemplo:
- Snowflake: Tablas transitorias, Comportamiento de fusión, Agrupación de tablas, Copia de permisos, Vistas seguras.
- Redshift: Distkey, Sortkey (intercalado, compuesto), Vistas de enlace tardío.
- BigQuery: Particionamiento y agrupación de tablas, Comportamiento de fusión, Encriptación KMS, Etiquetas y Tags.
- Spark: Formato de archivo (parquet, csv, json, orc, delta), partition_by, clustered_by, buckets, incremental_strategy
Actualmente se admiten los siguientes Almacenamientos:
- Postgres
- Redshift
- BigQuery
- Snowflake
- Presto (parcialmente)
- Spark (parcialmente)
- Microsoft SQL Server (adaptador comunitario)
Mejoramos nuestro modelo:
- Hagamos que su llenado sea incremental (Incremental)
- Agregaremos claves de segmentación y ordenación para Redshift
-- Configuración del modelo:
-- Llenado incremental, clave única para actualizar registros (unique_key)
-- Clave de segmentación (dist), clave de ordenación (sort)
{{
  config(
       materialized='incremental',
       unique_key='order_id',
       dist="customer_id",
       sort="order_date"
   )
}}

{% set payment_methods = ['credit_card', 'coupon', 'bank_transfer', 'gift_card'] %}

with orders as (

   select * from {{ ref('stg_orders') }}
   where 1=1
   {% if is_incremental() -%}
       -- Este filtro se aplicará solo para la ejecución incremental
       and order_date >= (select max(order_date) from {{ this }})
   {%- endif %}

),

order_payments as (

   select * from {{ ref('order_payments') }}

),

final as (

   select
       orders.order_id,
       orders.customer_id,
       orders.order_date,
       orders.status,
       {% for payment_method in payment_methods -%}
       order_payments.{{payment_method}}_amount,
       {% endfor -%}
       order_payments.total_amount as amount
   from orders
       left join order_payments using (order_id)

)

select * from final
Gráfico de dependencias de modelos
También conocido como árbol de dependencias. También DAG (Directed Acyclic Graph — Grafo Acíclico Dirigido).
DBT construye un grafo basado en la configuración de todos los modelos del proyecto, más precisamente en las referencias ref() dentro de los modelos a otros modelos. La existencia de un grafo permite hacer lo siguiente:
- Ejecutar modelos en la secuencia correcta
- Paralelización de la formación de vistas
- Ejecución de un subgrafo arbitrario
Ejemplo de visualización del grafo:
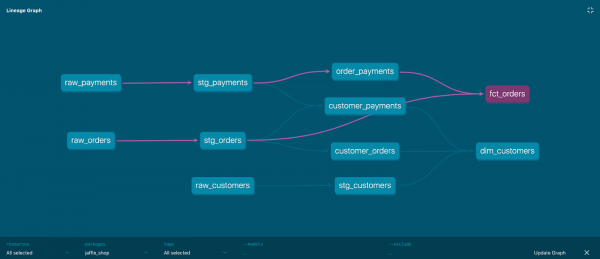
Cada nodo del grafo es un modelo, las aristas del grafo están definidas por la expresión ref.
Calidad de datos y Documentación
Además de formar los propios modelos, DBT permite probar una serie de suposiciones (assertions) sobre el conjunto de datos resultante, tales como:
- Not Null
- Unique
- Integridad de referencia — integridad referencial (por ejemplo, customer_id en la tabla orders corresponde a id en la tabla customers)
- Conformidad a la lista de valores permitidos
Es posible añadir pruebas personalizadas (custom data tests), como, por ejemplo, % de desviación de ingresos con respecto a los indicadores de hace un día, una semana, un mes. Cualquier suposición formulada como una consulta SQL puede convertirse en una prueba.
De este modo, se pueden detectar en las vistas del Almacenamiento desviaciones y errores no deseados en los datos.
En cuanto a la documentación, DBT proporciona mecanismos para agregar, versionar y distribuir metadatos y comentarios a nivel de modelos e incluso de atributos.
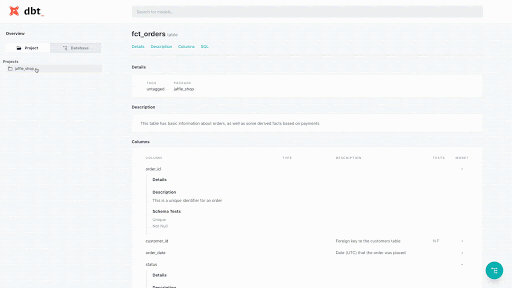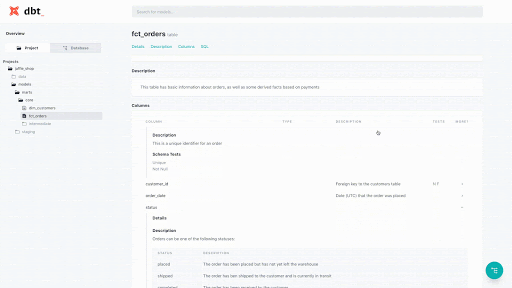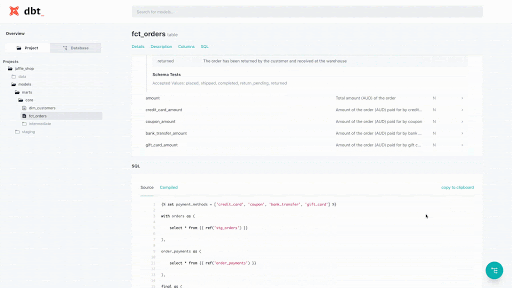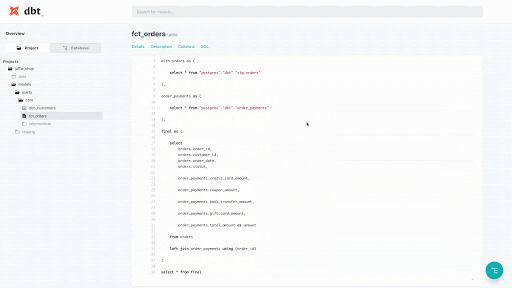
Así es como se ve la adición de pruebas y documentación a nivel de archivo de configuración:
 - name: fct_orders
   description: Esta tabla tiene información básica sobre los pedidos, así como algunos hechos derivados basados en pagos
   columns:
     - name: order_id
       tests:
         - unique # comprobación de valores únicos
         - not_null # comprobación de nulidad
       description: Este es un identificador único para un pedido
     - name: customer_id
       description: Llave foránea a la tabla de clientes
       tests:
         - not_null
         - relationships: # comprobación de integridad referencial
             to: ref('dim_customers')
             field: customer_id
     - name: order_date
       description: Fecha (UTC) en que se realizó el pedido
     - name: status
       description: '{{ doc("orders_status") }}'
       tests:
         - accepted_values: # comprobación de valores permitidos
             values: ['placed', 'shipped', 'completed', 'return_pending', 'returned']
Así es como se ve esta documentación en el sitio web generado:
Macros y Módulos
El propósito de DBT no es tanto convertirse en un conjunto de scripts SQL, sino proporcionar a los usuarios herramientas poderosas y ricas en funciones para construir sus propias transformaciones y distribuir estos módulos.
Las macros son conjuntos de construcciones y expresiones que se pueden invocar como funciones dentro de los modelos. Las macros permiten reutilizar SQL entre modelos y proyectos de acuerdo al principio de ingeniería DRY (Don’t Repeat Yourself).
Ejemplo de una macro:
{% macro rename_category(column_name) %}
case
 when {{ column_name }} ilike '%osx%' then 'osx'
 when {{ column_name }} ilike '%android%' then 'android'
 when {{ column_name }} ilike '%ios%' then 'ios'
 else 'other'
end as renamed_product
{% endmacro %}
Y su uso:
{% set column_name = 'product' %}
select
 product,
 {{ rename_category(column_name) }} -- llamada a la macro
from my_table
DBT viene con un gestor de paquetes (packages), que permite a los usuarios publicar y reutilizar módulos y macros individuales.
Esto significa la posibilidad de cargar y utilizar bibliotecas como:
- : trabajo con Date/Time, Claves Sustitutas, pruebas de esquema, Pivotar/Despivotar y más
- Plantillas listas para usar para servicios como y
- Bibliotecas para ciertos Almacenes de Datos, por ejemplo
- — Módulo para registrar el trabajo de DBT
Puedes consultar la lista completa de paquetes en .
Aún más funcionalidades
Aquí describiré algunas otras características e implementaciones interesantes que yo y el equipo usamos para construir el Almacén de Datos en .
División de entornos de ejecución DEV - TEST - PROD
Incluso dentro de un mismo clúster DWH (dentro de diferentes esquemas). Por ejemplo, utilizando la siguiente expresión:
with source as (

   select * from {{ source('salesforce', 'users') }}
   where 1=1
   {%- if target.name in ['dev', 'test', 'ci'] -%}
       where timestamp >= dateadd(day, -3, current_date)
   {%- endif -%}

)
Este código literalmente dice: para los entornos dev, test, ci toma los datos de solo los últimos 3 días y no más. Es decir, la ejecución en estos entornos será mucho más rápida y requerirá menos recursos. Al ejecutarse en el entorno prod la condición de filtro será ignorada.
Materialización con codificación alternativa de columnas
Redshift es un sistema de gestión de bases de datos (SGBD) columnar que permite establecer algoritmos de compresión de datos para cada columna por separado. La elección de algoritmos óptimos puede reducir el espacio ocupado en disco de un 20 a un 50%.
Macro ejecutará el comando ANALYZE COMPRESSION, creará una nueva tabla con los algoritmos de codificación de columnas recomendados, especificando las claves de segmentación (dist_key) y ordenación (sort_key), trasladará los datos a ella y, si es necesario, eliminará la copia antigua.
Firma del macro:
{{ compress_table(schema, table,
                     drop_backup=False,
                     comprows=none|Integer,
                     sort_style=none|compound|interleaved,
                     sort_keys=none|List,
                     dist_style=none|all|even,
                     dist_key=none|String) }}
Registro de ejecuciones de modelos
En cada ejecución de modelo se pueden agregar hooks que se ejecutan antes del inicio o justo después de terminar la creación del modelo:
   pre-hook: "{{ logging.log_model_start_event() }}"
   post-hook: "{{ logging.log_model_end_event() }}"
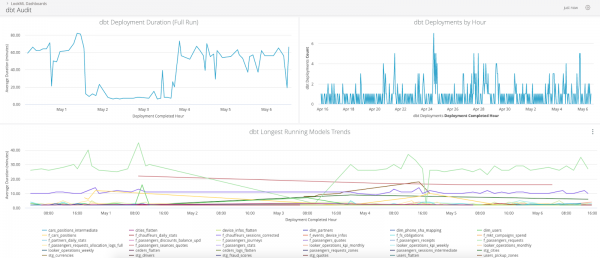
El módulo de registro permitirá almacenar todos los metadatos necesarios en una tabla separada, con la cual se pueden realizar auditorías y análisis de puntos problemáticos (bottlenecks) posteriormente.
Así es como se ve el tablero de registros en Looker:
Automatización del mantenimiento del Almacén
Si utilizas alguna extensión del funcionalidad del Almacén utilizado, como UDF (Funciones Definidas por el Usuario), la versión de estas funciones, la gestión de accesos y la implementación automatizada de nuevas versiones es muy conveniente llevarla a cabo en DBT.
Usamos UDF en Python para calcular valores hash, dominios de direcciones de correo electrónico y decodificar máscaras de bits (bitmask).
Ejemplo de un macro que crea UDF en cualquier entorno de ejecución (dev, test, prod):
{% macro create_udf() -%}

 {% set sql %}
       CREATE OR REPLACE FUNCTION {{ target.schema }}.f_sha256(mes "varchar")
           RETURNS varchar
           LANGUAGE plpythonu
           STABLE
       AS $$
           import hashlib
           return hashlib.sha256(mes).hexdigest()
       $$
       ;
 {% endset %}

 {% set table = run_query(sql) %}

{%- endmacro %}
En Wheely utilizamos Amazon Redshift, que se basa en PostgreSQL. Para Redshift es importante recopilar estadísticas de las tablas regularmente y liberar espacio en disco: comandos ANALYZE y VACUUM, respectivamente.
Para esto, cada noche se ejecutan los comandos del macro redshift_maintenance:
{% macro redshift_maintenance() %}

   {% set vacuumable_tables=run_query(vacuumable_tables_sql) %}

   {% for row in vacuumable_tables %}
       {% set message_prefix=loop.index ~ " de " ~ loop.length %}

       {%- set relation_to_vacuum = adapter.get_relation(
                                               database=row['table_database'],
                                               schema=row['table_schema'],
                                               identifier=row['table_name']
                                   ) -%}
       {% do run_query("commit") %}

       {% if relation_to_vacuum %}
           {% set start=modules.datetime.datetime.now() %}
           {{ dbt_utils.log_info(message_prefix ~ " Limpiando " ~ relation_to_vacuum) }}
           {% do run_query("VACUUM " ~ relation_to_vacuum ~ " BOOST") %}
           {{ dbt_utils.log_info(message_prefix ~ " Analizando " ~ relation_to_vacuum) }}
           {% do run_query("ANALYZE " ~ relation_to_vacuum) %}
           {% set end=modules.datetime.datetime.now() %}
           {% set total_seconds = (end - start).total_seconds() | round(2)  %}
           {{ dbt_utils.log_info(message_prefix ~ " Terminado " ~ relation_to_vacuum ~ " en " ~ total_seconds ~ "s") }}
       {% else %}
           {{ dbt_utils.log_info(message_prefix ~ ' Saltando relación "' ~ row.values() | join ('"."') ~ '" ya que no existe') }}
       {% endif %}

   {% endfor %}

{% endmacro %}
DBT Cloud
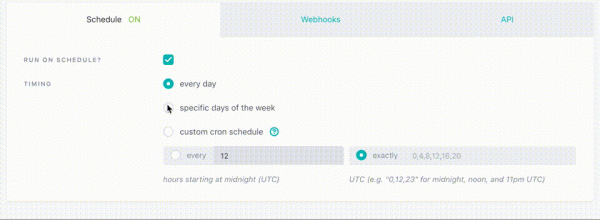
Hay opción de usar DBT como servicio (Managed Service). Incluye:
- Web IDE para desarrollo de proyectos y modelos
- Configuración de trabajos y programación
- Acceso fácil y conveniente a los registros
- Sitio web con la documentación de su proyecto
- Conexión CI (Integración Continua)
Conclusión
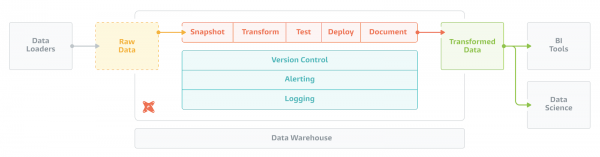
Preparar y consumir DWH se vuelve tan agradable y beneficioso como beber un batido. DBT está compuesto por Jinja, extensiones personalizadas (módulos), un compilador, un motor (executor) y un gestor de paquetes. Al juntar estos elementos, obtienes un entorno de trabajo completo para tu Almacén de Datos. Difícilmente existe hoy un mejor modo de gestionar las transformaciones dentro de un DWH.
Las creencias seguidas por los desarrolladores de DBT se pueden expresar de la siguiente manera:
- El código, no la interfaz gráfica, es la mejor abstracción para expresar lógica analítica compleja.
- El trabajo con datos debe adoptar las mejores prácticas del desarrollo de software (Software Engineering).
- La infraestructura más importante para el trabajo con datos debe ser controlada por la comunidad de usuarios como software de código abierto.
- No solo las herramientas de análisis, sino también el código se convertirá cada vez más en patrimonio de la comunidad de código abierto.
Estas creencias fundamentales han dado lugar a un producto que hoy se utiliza en más de 850 empresas y constituyen la base de muchas interesantes extensiones que se crearán en el futuro.
Para aquellos interesados, hay una grabación de la lección abierta que di hace unos meses como parte de una lección abierta en OTUS — .
Además de DBT y Almacenes de Datos, en el curso de Data Engineer en la plataforma OTUS, mis colegas y yo impartimos clases sobre otros temas relevantes y contemporáneos:
- Conceptos arquitectónicos de aplicaciones de Big Data.
- Práctica con Spark y Spark Streaming.
- Estudio de métodos y herramientas para cargar fuentes de datos.
- Construcción de vitrinas analíticas en DWH.
- Conceptos NoSQL: HBase, Cassandra, ElasticSearch.
- Principios de organización de monitoreo y orquestación.
- Proyecto Final: uniendo todas las habilidades con apoyo de un mentor.
Enlaces:
- — Documentación oficial.
- — Artículo informativo de uno de los autores de DBT.
- — YouTube, Grabación de la lección abierta de OTUS.
- — Próxima lección abierta el 15 de mayo de 2020.
- — OTUS.
- — Mirada hacia el futuro del trabajo con datos y análisis.
- — Evolución de la analítica y el impacto del código abierto.
- — Principios de construcción de CI utilizando DBT.
- — Práctica, Instrucciones paso a paso para el autoaprendizaje.
- — Github, código del proyecto educativo
Fuente: habr.com
