

¡Hola, Habr! En Dodo Pizza Engineering amamos los datos (¿quién no los ama hoy en día?). Ahora vamos a contar la historia de cómo acumular todos los datos del mundo de Dodo Pizza y darle a cualquier empleado de la empresa acceso fácil a este gran conjunto de datos. La tarea con estrellita: mantener la calma del equipo de Data Engineering.
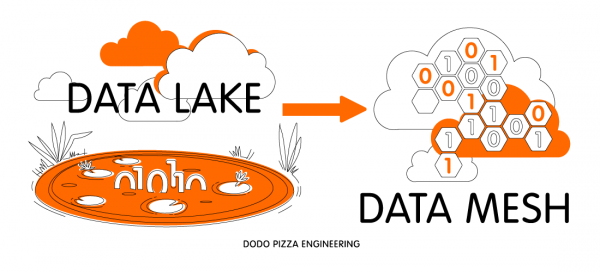
Como verdaderos acumuladores, recopilamos toda la información posible sobre el funcionamiento de nuestras pizzerías:
- recordamos todos los pedidos de los usuarios;
- sabemos cuánto tiempo llevó hacer la primera pizza en Syktyvkar;
- vemos cuánto tiempo se enfría una pizza en la estantería térmica en Voronezh en este momento;
- almacenamos datos sobre la mermas de productos;
- y mucho, mucho más.
Actualmente, varias equipos son responsables de trabajar con los datos en Dodo Pizza, uno de ellos es el equipo de Data Engineering. Ahora, se nos presenta la tarea de proporcionar a cualquier empleado de la empresa acceso fácil a este gran conjunto de datos.
Cuando comenzamos a pensar en cómo hacerlo y empezamos a discutir la tarea, encontramos un enfoque muy interesante para la gestión de datos – (en el enlace encontrarás un artículo enorme y fantástico). Sus ideas encajaron muy bien con nuestra visión sobre cómo queremos construir nuestro sistema. Más adelante en el artículo, compartiremos nuestra reinterpretación del enfoque y cómo lo vemos implementado en Dodo Pizza Engineering.
¿Qué entendemos por «datos»?
Primero, definamos qué entendemos por datos en Dodo Pizza Engineering:
- Eventos que envían los servicios (tenemos un bus común, construido con RabbitMQ);
- Registros dentro de la base de datos (para nosotros esto es MySQL y CosmosDB);
- Clickstream de la aplicación móvil y del sitio web.
Para que el negocio de Dodo Pizza pueda utilizar estos datos y confiar en ellos, es importante que se cumplan las siguientes condiciones:
- Deben ser íntegros. Debemos estar seguros de que no alteramos los datos durante su procesamiento, almacenamiento y visualización. Si el negocio no puede confiar en nuestros datos, no servirán de nada.
- Deben tener una marca de tiempo y no ser sobrescritos. Esto significa que en cualquier momento queremos poder retroceder y ver los datos de ese período de tiempo. Por ejemplo, saber cuántas pizzas se vendieron el 8 de julio de 2018.
- Deben ser fiables. En el proceso de recopilación y almacenamiento de datos, debemos no solo mantener la integridad, sino también la confiabilidad. No podemos perder datos, momentos críticos, porque junto con ellos, perdemos la confianza de nuestros clientes (tanto externos como internos).
- Deben tener un esquema estable: estamos escribiendo consultas para estos datos. No nos gustaría que con el cambio del código de la aplicación, con la refactorización, cambiaran tanto que nuestras consultas dejaran de funcionar. Quien escribe las consultas nunca sabrá que hiciste refactorización hasta que todo se arruine. No nos gustaría enterarnos de esto por parte de los clientes.
Teniendo en cuenta todos estos requisitos, llegamos a la conclusión de que los datos en Dodo son un producto. Igual que el API público del servicio. Por lo tanto, el equipo que posee los datos debe ser el mismo que posee el servicio. Además, los cambios en el esquema de datos deben ser siempre retrocompatibles.
Enfoque tradicional: Data Lake
Para abordar la tarea de almacenamiento y procesamiento confiable de grandes datos, existe un enfoque tradicional adoptado por muchas empresas que trabajan con este conjunto de información: Data Lake. En este enfoque, los ingenieros de datos recopilan información de todos los componentes del sistema y la almacenan en un gran repositorio (puede ser, por ejemplo, Hadoop, Azure Kusto, Apache Cassandra o incluso una réplica de MySQL, si los datos caben en ella).
Luego, esos mismos ingenieros escriben consultas para ese repositorio. La implementación de este enfoque en Dodo Pizza Engineering implica que el equipo de Data Engineering poseerá el esquema de datos en el almacén analítico.
En este escenario, el equipo se convierte en gatos tristes y aquí está el porqué:
- Deben estar atentos a los cambios en TODOS los servicios dentro de la empresa. Y hay muchos, y hay muchos cambios (en promedio, fusionamos ~100 pull requests a la semana, mientras que muchos servicios no hacen pull requests en absoluto).
- Cuando cambia el esquema de datos, el product owner y el equipo que modifica el esquema de datos deben esperar a que Data Engineering complete el código necesario para que los cambios sean compatibles. Además, aquí llevamos tiempo en que una equipo espera a otro – algo muy raro. Y no queremos que eso se convierta en una parte «normal» del proceso de desarrollo.
- Deben estar inmersos en TODO negocios de la empresa. Una red de pizzerías parece un negocio simple, pero eso es solo una impresión. Es muy difícil reunir en un solo equipo las competencias necesarias para construir un modelo de datos adecuado para toda la empresa.
- Es un único punto de falla. Cada vez que hay que cambiar los datos que devuelve el servicio o escribir una consulta, todas esas tareas recaen en el equipo de Data Engineering. Como resultado, el equipo tiene un backlog sobrecargado.
Así que el equipo se encuentra en la intersección de una enorme cantidad de necesidades y es poco probable que pueda satisfacerlas. Al mismo tiempo, estará en un estado constante de falta de tiempo y estrés. No queremos eso. Por lo tanto, tenemos que pensar en cómo resolver estos problemas y, al mismo tiempo, obtener la capacidad de analizar datos.
Fluyendo del Data Lake al Data Mesh
Afortunadamente, no solo nosotros nos hemos hecho esta pregunta. De hecho, este problema ya ha sido resuelto en la industria (¡aleluya!). Solo que en otro campo: el despliegue de aplicaciones. Sí, estoy hablando del enfoque DevOps, donde el equipo determina cómo se debe desplegar el producto que están creando.
Un enfoque similar para resolver problemas de Data Lake fue propuesto por Zhamak Dehghani, consultora de ThoughtWorks. Al observar cómo abordan estas tareas Netflix y Spotify, escribió un artículo impresionante (el enlace a él estaba al principio del artículo). Las ideas principales que hemos extraído de él son:
- Dividir el gran Data Lake en dominios de datos que son muy similares a los dominios del diseño orientado a dominios. Cada dominio representa un contexto delimitado.
- Los Feature Teams, que son responsables de los dominios de DDD, también son responsables de los dominios de datos correspondientes. Ellos mantienen el esquema, hacen cambios en él, cargan los datos. Y saben todo: cómo modificar la carga de datos sin romper nada cuando la aplicación cambia. El conocimiento no se pierde. Para abrir los datos, no necesitan ir a ningún lado. El propio equipo lleva a cabo todo el ciclo de desarrollo, desde el cambio de datos operativos hasta la provisión de datos analíticos a terceros. Un equipo posee todo lo relacionado con el dominio (tanto el dominio del negocio como el dominio de los datos).
- El Data Engineer es un rol dentro del Feature Team. No tiene que ser necesariamente una persona separada, pero es esencial que el equipo tenga esta competencia.
Y mientras tanto, el equipo de Data Engineering...
Si imaginamos que todo esto se realiza con un chasquido de dedos, solo queda responder dos preguntas:
¿En qué se dedicará ahora el equipo de Data Engineering? En Dodo Pizza Engineering ya existe un equipo de plataforma/SRE. Su objetivo es proporcionar a los desarrolladores herramientas para un despliegue sencillo de servicios. El equipo de Data Engineering desempeñará un papel similar, pero para los datos.
Transformar los datos operativos en analíticos es un proceso complicado. Hacer que los datos analíticos sean accesibles para toda la empresa es aún más difícil. Precisamente en la resolución de estos problemas se centrará el equipo de Data Engineering.
Vamos a ofrecer al Feature Team un conjunto cómodo de herramientas y prácticas, mediante las cuales podrán publicar datos de su servicio para el resto de la empresa. También seremos responsables de las partes infraestructurales comunes del data pipeline (colas, almacenamiento seguro, clústeres para realizar transformaciones sobre los datos).
¿Cómo se desarrollarán las habilidades de Data Engineer dentro del Feature Team? Con el Feature Team es más complicado. Por supuesto, podríamos intentar contratar a un Data Engineer en cada uno de nuestros equipos. Pero es muy difícil. Encontrar a alguien con una buena experiencia en procesamiento de datos y convencerlo de trabajar dentro de un equipo de producto es complicado.
Una gran ventaja de Dodo es que valoramos la formación interna. Así que ahora nuestro plan es el siguiente: el equipo de Data Engineering comienza a publicar los datos de algunos servicios, llora, se pincha, pero sigue comiendo cactus. Una vez que comprendamos que tenemos un proceso listo para la publicación, comenzaremos a contarles sobre él al Feature Team.
Tenemos varias maneras de hacerlo:
- , donde hablaremos sobre cómo es el proceso que hemos creado, qué herramientas hay y cómo usarlas de manera más efectiva.
- Una presentación en DevForum nos ayudará a recoger comentarios de los desarrolladores de productos. Después de eso, podremos unirnos a los equipos de producto y ayudarles a resolver problemas con la publicación de datos, organizar entrenamientos para los equipos.
Consumo de datos
Ahora he hablado mucho sobre la publicación de datos. Pero también existe el consumo. ¿Qué hay al respecto?
Tenemos un equipo increíble de BI que elabora informes muy complejos para la empresa de gestión. Dentro de Dodo IS hay muchos informes para nuestros socios que les ayudan a gestionar las pizzerías. En nuestro nuevo modelo, los consideramos como consumidores de datos, cada uno con sus propios dominios de datos. Y son precisamente los consumidores quienes serán responsables de sus propios dominios. A veces, el dominio del consumidor puede describirse con una sola consulta en el almacenamiento analítico, lo cual está bien. Pero entendemos que no siempre funcionará así. Por eso queremos que la plataforma que crearemos para los equipos de productos también pueda ser utilizada por los consumidores de datos (pues en el caso de los informes dentro de Dodo IS, serán los mismos equipos).
Así es como vemos el trabajo con los datos en Dodo Pizza Engineering. Nos encantaría conocer tus opiniones al respecto en los comentarios.
Fuente: habr.com
