

SQL, ¿qué puede ser más sencillo? Todos nosotros podemos escribir una consulta simple: escribimos select, enumeramos las columnas necesarias, luego from, el nombre de la tabla, un poco de condiciones en donde y voilà, tenemos datos útiles en nuestras manos, casi independientemente de qué sistema de gestión de bases de datos esté en funcionamiento (o puede que no sea una ). Como resultado, trabajar con casi cualquier fuente de datos (relacional o no) se puede ver desde la perspectiva del código habitual (con todas las implicaciones: control de versiones, revisión de código, análisis estático, pruebas automáticas y todo eso). Esto no solo se refiere a los propios datos, esquemas y migraciones, sino a la actividad general del almacén. En este artículo, hablaremos sobre las tareas cotidianas y los problemas al trabajar con varias bases de datos bajo la mirada de "base de datos como código".
Y comenzaremos justo con . Las primeras batallas del tipo "SQL vs ORM" se observaron aún en .
Mapeo objeto-relacional
Los defensores de ORM valoran tradicionalmente la velocidad y la simplicidad en el desarrollo, la independencia del sistema de gestión de bases de datos y la limpieza del código. Para muchos de nosotros, el código que trabaja con la base de datos (y a menudo la propia base de datos)
por lo general se ve algo así…
@Entity
@Table(name = "stock", catalog = "maindb", uniqueConstraints = {
        @UniqueConstraint(columnNames = "STOCK_NAME"),
        @UniqueConstraint(columnNames = "STOCK_CODE") })
public class Stock implements java.io.Serializable {

    @Id
    @GeneratedValue(strategy = IDENTITY)
    @Column(name = "STOCK_ID", unique = true, nullable = false)
    public Integer getStockId() {
        return this.stockId;
    }
  ...
El modelo está adornado con inteligentes anotaciones, y en algún lugar detrás de escena, el valiente ORM genera y ejecuta toneladas de código SQL. Cabe mencionar que los desarrolladores están tratando por todos los medios de aislarse de su base de datos con kilómetros de abstracciones, lo que indica una cierta .
Al otro lado de las barricadas, los partidarios del "SQL hecho a mano" destacan la capacidad de extraer el máximo rendimiento de su sistema de gestión de bases de datos sin capas y abstracciones adicionales. Como resultado, surgen proyectos "centrados en los datos", donde la base es manejada por personas específicamente capacitadas (también conocidos como "básicos", "básicos de datos" y similares), mientras que a los desarrolladores solo les queda "tirar" de vistas y procedimientos almacenados ya listos, sin entrar en detalles.
¿Y si tomamos lo mejor de ambos mundos? Como se hace en la maravillosa herramienta con un nombre alentador . Citaré un par de líneas de la concepción general en mi libre traducción, y se puede conocer más a fondo. .
Clojure es un gran lenguaje para crear DSLs, pero SQL ya es en sí mismo un gran DSL, y no necesitamos otro. Las expresiones S son geniales, pero aquí no añaden nada nuevo. Al final, tenemos paréntesis solo por tener paréntesis. ¿No estás de acuerdo? Entonces espera el momento en que la abstracción sobre la base de datos se rompa, y empezarás a luchar con la función. (raw-sql)
¿Y qué hacer? Dejemos SQL como SQL: un archivo por consulta:
-- name: users-by-country
select *
  from users
 where country_code = :country_code
… y luego lee este archivo, convirtiéndolo en una función normal de Clojure:
(defqueries "some/where/users_by_country.sql"
   {:connection db-spec})

;;; Se ha creado una función con el nombre `users-by-country`.
;;; Usemosla:
(users-by-country {:country_code "GB"})
;=> ({:name "Kris" :country_code "GB" ...} ...)
Siguiendo el principio de "SQL separado, Clojure separado", obtienes:
- Sin sorpresas sintácticas. Tu base de datos (como cualquier otra) no cumple al 100% con el estándar SQL — pero para Yesql eso no importa. Nunca perderás tiempo buscando funciones con una sintaxis equivalente a SQL. Nunca tendrás que regresar a la función (raw-sql "some (‘funky’ :: SYNTAX)")).
- El mejor soporte del editor. Tu editor ya tiene un excelente soporte para SQL. Al mantener SQL como SQL, simplemente puedes usarlo.
- Compatibilidad del equipo. Tus DBA pueden leer y escribir SQL, que utilizas en tu proyecto de Clojure.
- Configuración de rendimiento más simple. ¿Necesitas crear un plan para una consulta problemática? No hay problema, cuando tu consulta es solo SQL normal.
- Reutilización de consultas. Lleva esos mismos archivos SQL a otros proyectos, porque es solo el viejo y confiable SQL — simplemente compártelo.
Para mí, la idea es muy genial y a la vez muy simple, lo que ha permitido que el proyecto gane mucho. en una variedad de lenguajes. Y a continuación intentaremos aplicar una filosofía similar de separación del código SQL de todo lo demás, lejos de ORM.
IDE & DB-gestores
Comencemos con una tarea cotidiana sencilla. A menudo tenemos que buscar ciertos objetos en la base de datos, por ejemplo, encontrar una tabla en el esquema y estudiar su estructura (qué columnas, claves, índices, restricciones, etc., se utilizan). Y de cualquier IDE gráfico o de un mínimo gestor de bases de datos, en primer lugar, esperamos precisamente estas capacidades. Necesitamos que sea rápido y que no tengamos que esperar media hora mientras aparece la ventana con la información necesaria (especialmente en una conexión lenta a una base de datos remota), y además, que la información obtenida sea nueva y actual, y no algo en caché que ya está desactualizado. Cuanto más grande y compleja sea la base de datos, y mayor su número, más complicado es hacerlo.
Pero normalmente dejo el ratón a un lado y simplemente escribo código. Supongamos que necesitamos saber qué tablas (y con qué propiedades) hay en el esquema "HR". En la mayoría de los sistemas de gestión de bases de datos, se puede obtener el resultado deseado con esta sencilla consulta de information_schema:
select table_name
     , ...
  from information_schema.tables
 where schema = 'HR'
De base de datos a base de datos, el contenido de estas tablas de referencia varía dependiendo de las capacidades de cada sistema de gestión de bases de datos. Y, por ejemplo, para MySQL, de este mismo diccionario se pueden obtener parámetros específicos para esta base de datos:
select table_name
     , storage_engine -- Motor utilizado ("MyISAM", "InnoDB", etc.)
     , row_format     -- Formato de la fila ("Fixed", "Dynamic", etc.)
     , ...
  from information_schema.tables
 where schema = 'HR'
Oracle no tiene information_schema, pero tiene , y no surgen grandes problemas:
select table_name
     , pct_free       -- Mínimo espacio libre en el bloque de datos (%)
     , pct_used       -- Mínimo espacio utilizado en el bloque de datos (%)
     , last_analyzed  -- Fecha del último análisis estadístico
     , ...
  from all_tables
 where owner = 'HR'
ClickHouse no es una excepción:
select name
     , engine -- Motor utilizado ("MergeTree", "Dictionary", etc.)
     , ...
  from system.tables
 where database = 'HR'
Algo similar se puede hacer en Cassandra (donde hay columnfamilies en lugar de tablas y keyspaces en lugar de esquemas):
select columnfamily_name
     , compaction_strategy_class  -- Estrategia de compactación
     , gc_grace_seconds           -- Tiempo de vida del basura
     , ...
  from system.schema_columnfamilies
 where keyspace_name = 'HR'
Para la mayoría de las demás bases de datos, también se pueden idear consultas similares (incluso en Mongo hay , que contiene información sobre todas las colecciones en el sistema).
Por supuesto, de esta manera se puede obtener información no solo sobre tablas, sino sobre cualquier objeto en general. Periódicamente, algunas buenas personas comparten este tipo de código para diferentes bases de datos, como en la serie de artículos de Habr "Funciones para documentar bases de datos PostgreSQL" (, , ). Por supuesto, mantener toda esta cantidad de consultas en la cabeza y tener que escribirlas constantemente no es un "placer" muy grande, así que en mi IDE/editor favorito tengo un conjunto de snippets preparados para consultas que uso con frecuencia, y solo queda introducir los nombres de los objetos en la plantilla.
Al final, este método de navegación y búsqueda de objetos es mucho más flexible, ahorra mucho tiempo y permite obtener exactamente la información en el formato necesario (como se describe, por ejemplo, en la publicación ).
Operaciones con objetos
Después de encontrar y estudiar los objetos necesarios, es hora de hacer algo útil con ellos. Por supuesto, sin despegar los dedos del teclado.
No es un secreto que la simple eliminación de una tabla se verá igual casi en todas las bases de datos:
drop table hr.personsPero la creación de una tabla es un poco más interesante. Prácticamente cualquier SGBD (incluyendo muchos NoSQL) de alguna manera maneja "create table", y la parte principal apenas se diferenciará (nombre, lista de columnas, tipos de datos), pero los demás detalles pueden variar considerablemente y dependen de la estructura interna y características específicas de cada SGBD. Mi ejemplo favorito: en la documentación de Oracle, solo las "BNF" desnudas para la sintaxis de "create table" . Otros SGBD tienen capacidades más modestas, pero cada uno también tiene muchas características interesantes y únicas para la creación de tablas (, , , ). Es poco probable que algún "asistente" gráfico de otra IDE (especialmente universal) pueda cubrir completamente todas estas capacidades, y si lo logran, será un espectáculo no apto para personas sensibles. Al mismo tiempo, un operador correctamente escrito y a su debido tiempo create table permitirá aprovechar todas ellas sin dificultades, haciendo que el almacenamiento y el acceso a tus datos sean fiables, óptimos y lo más cómodos posible.
Además, en muchas bases de datos hay tipos de objetos específicos que no están presentes en otras bases de datos. De hecho, podemos realizar operaciones no solo sobre los objetos de la base de datos, sino también sobre la propia base de datos, como "matar" un proceso, liberar alguna área de memoria, activar el trazado, cambiar a modo "solo lectura" y mucho más.
Ahora vamos a dibujar un poco
Una de las tareas más comunes es construir un diagrama con los objetos de la base de datos, para ver de manera visual los objetos y las relaciones entre ellos. Esto lo puede hacer prácticamente cualquier IDE gráfico, junto con utilidades de línea de comandos, herramientas gráficas especializadas y modeladores. Los cuales te dibujarán "como puedan", y puedes influir un poco en este proceso solo a través de algunos parámetros en el archivo de configuración o marcando opciones en la interfaz.
Pero este problema se puede resolver de manera mucho más simple, flexible y elegante, y, por supuesto, utilizando código. Para la construcción de diagramas de cualquier complejidad, tenemos varios lenguajes de marcado especializados (DOT, GraphML, etc.), a los que se les suman múltiples aplicaciones (GraphViz, PlantUML, Mermaid) que pueden leer tales instrucciones y visualizarlas en diversos formatos. Y ya sabemos cómo obtener la información sobre los objetos y las relaciones entre ellos.
Proporcionemos un pequeño ejemplo de cómo podría verse esto, utilizando PlantUML y (a la izquierda la consulta SQL que genera la instrucción necesaria para PlantUML, y a la derecha el resultado):
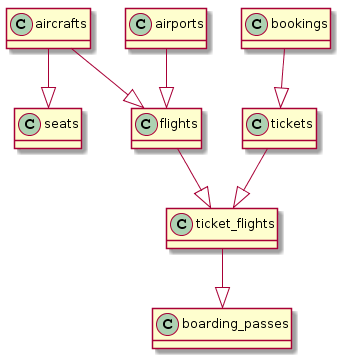
select '@startuml'||chr(10)||'hide methods'||chr(10)||'hide stereotypes' union all
select distinct ccu.table_name || ' --|> ' ||
       tc.table_name as val
  from table_constraints as tc
  join key_column_usage as kcu
    on tc.constraint_name = kcu.constraint_name
  join constraint_column_usage as ccu
    on ccu.constraint_name = tc.constraint_name
 where tc.constraint_type = 'FOREIGN KEY'
   and tc.table_name ~ '.*' union all
select '@enduml'
Y si te esfuerzas un poco, a partir de puedes obtener algo que se asemeje bastante a un verdadero diagrama ER:
La consulta SQL es un poco más compleja
-- Encabezado
select '@startuml
!define Table(name,desc) class name as "desc" << (T,#FFAAAA) >>
!define primary_key(x) <b>x</b>
!define unique(x) <color:green>x</color>
!define not_null(x) <u>x</u>
hide methods
hide stereotypes'
union all
-- Tablas
select format('Table(%s, "%s n información sobre %s") {'||chr(10), table_name, table_name, table_name) ||
(select string_agg(column_name || ' ' || upper(udt_name), chr(10))
from information_schema.columns
where table_schema = 'public'
and table_name = t.table_name) || chr(10) || '}'
from information_schema.tables t
where table_schema = 'public'
union all
-- Relaciones entre tablas
select distinct ccu.table_name || ' "1" --> "0..N" ' || tc.table_name || format(' : "Un %s puede tener muchos %s"', ccu.table_name, tc.table_name)
from information_schema.table_constraints as tc
join information_schema.key_column_usage as kcu on tc.constraint_name = kcu.constraint_name
join information_schema.constraint_column_usage as ccu on ccu.constraint_name = tc.constraint_name
where tc.constraint_type = 'FOREIGN KEY'
and ccu.constraint_schema = 'public'
and tc.table_name ~ '.*'
union all
-- Pie
select '@enduml' 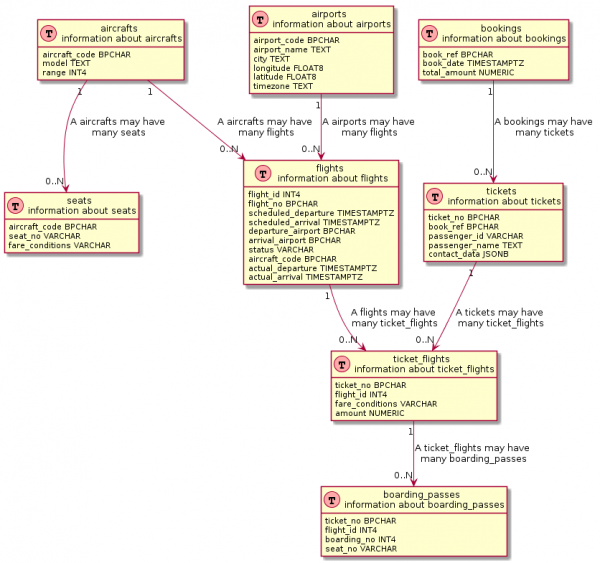
Si observas detenidamente, muchos de los herramientas visualizadoras utilizan consultas similares en su funcionamiento. Sin embargo, estas consultas generalmente están profundamente , sin mencionar cualquier tipo de modificación de las mismas.
Métricas y monitoreo
Pasemos a un tema tradicionalmente complicado: el monitoreo del rendimiento de bases de datos. Recuerdo una pequeña historia real que me contó "un amigo mío". En un proyecto, había un poderoso DBA del que pocos desarrolladores conocían personalmente, y mucho menos lo habían visto alguna vez (a pesar de que, según rumores, trabajaba en algún lugar cercano). En la hora "X", cuando el sistema de producción de un gran minorista comenzaba a "sentirse mal", él enviaba en silencio capturas de pantalla de gráficos del Oracle Enterprise Manager, resaltando con un marcador rojo los puntos críticos para mayor "claridad" (lo que, dicho sea de paso, ayudaba poco). Así que había que solucionar el problema basado en esa "fotografía". Mientras tanto, nadie tenía acceso al valioso (en ambos sentidos de la palabra) Enterprise Manager, ya que el sistema era complejo y costoso; no fuera que los "desarrolladores metieran mano y lo rompieran todo". Por lo tanto, los desarrolladores encontraban el lugar y la razón de las ralentizaciones de forma "empírica" y lanzaban un parche. Si la temida carta del DBA no llegaba de nuevo en un breve lapso, todos exhalaban aliviados y volvían a sus tareas actuales (hasta la próxima carta).
Pero el proceso de monitoreo puede ser más divertido y amigable, y lo más importante, accesible y transparente para todos. Al menos su parte básica, como complemento a los sistemas de monitoreo principales (que son sin duda útiles e indispensables en muchas ocasiones). Cualquier SGBD está dispuesto a compartir información sobre su estado actual y rendimiento de forma gratuita y sin reservas. En la misma "sanguinaria" Oracle DB, se puede obtener prácticamente cualquier información sobre rendimiento desde las vistas del sistema, comenzando por procesos y sesiones, y terminando con el estado de la caché de búfer (por ejemplo, , sección "Monitoreo"). En PostgreSQL también hay una abundante variedad de vistas del sistema para , en particular, aquellas que son indispensables en la vida cotidiana de cualquier DBA, como , , . En MySQL, hay incluso un esquema separado destinado a esto, . Y en Mongo, un agrega datos sobre el rendimiento en una colección del sistema .
Así, armándose con algún recolector de métricas (Telegraf, Metricbeat, Collectd), que puede ejecutar consultas SQL personalizadas, un almacenamiento para estas métricas (InfluxDB, Elasticsearch, Timescaledb) y un visualizador (Grafana, Kibana), se puede obtener un sistema de monitoreo bastante ligero y flexible, que estará estrechamente integrado con otras métricas generales del sistema (obtenidas, por ejemplo, desde el servidor de aplicaciones, desde el SO, etc.). Como se hace, por ejemplo, en pgwatch2, donde se utiliza la combinación InfluxDB + Grafana y un conjunto de consultas a vistas del sistema, a las que también se pueden .
Total
Y esta es solo una lista aproximada de lo que se puede hacer con nuestra base de datos mediante código SQL convencional. Estoy seguro de que se pueden encontrar muchas más aplicaciones, escríbanos en los comentarios. Y sobre cómo (y, lo más importante, por qué) automatizar todo esto e integrarlo en su pipeline de CI/CD, hablaremos la próxima vez.
Fuente: habr.com
