

DataHub de código abierto: plataforma de búsqueda y descubrimiento de metadatos de LinkedIn.
La búsqueda rápida de datos necesarios es esencial para cualquier empresa que confíe en una gran cantidad de datos para tomar decisiones basadas en ellos. Esto no solo afecta la productividad de los usuarios de datos (incluyendo analistas, desarrolladores de aprendizaje automático, especialistas en procesamiento de datos e ingenieros de datos), sino que también impacta directamente en los productos finales que dependen de una canalización de aprendizaje automático (ML) de calidad. Además, la tendencia a implementar o crear plataformas de aprendizaje automático naturalmente plantea la cuestión: ¿cuál es su método para el descubrimiento interno de funciones, modelos, métricas, conjuntos de datos, etc.
En este artículo hablaremos sobre cómo publicamos bajo una licencia abierta la fuente de datos en nuestra plataforma de búsqueda y descubrimiento de metadatos, desde los primeros días del proyecto . LinkedIn mantiene su propia versión de DataHub por separado de la versión de código abierto. Comenzaremos explicando por qué necesitamos dos entornos de desarrollo separados, luego discutiremos los primeros enfoques para utilizar WhereHows de código abierto y haremos una comparación entre nuestra versión interna (de producción) de DataHub y la versión en . También compartiremos detalles sobre nuestra nueva solución automatizada para enviar y recibir actualizaciones de código abierto, para sincronizar ambos repositorios. Por último, daremos instrucciones sobre cómo empezar a usar DataHub de código abierto y discutiremos brevemente su arquitectura.
¡WhereHows ahora es DataHub!
El equipo de metadatos de LinkedIn previamente presentó (el sucesor de WhereHows), la plataforma de búsqueda y descubrimiento de metadatos de LinkedIn, y compartió planes para abrirla. Poco después de este anuncio, lanzamos la versión alfa de DataHub y la compartimos con la comunidad. Desde entonces, hemos contribuido constantemente al repositorio y trabajado con usuarios interesados para agregar las características más solicitadas y abordar problemas. Ahora estamos emocionados de anunciar el lanzamiento oficial .
Enfoques de código abierto
WhereHows, el portal original de LinkedIn para la búsqueda de datos y su origen, se lanzó como un proyecto interno; el equipo de metadatos lo abrió . Desde entonces, el equipo ha mantenido dos bases de código diferentes: una para código abierto y otra para uso interno de LinkedIn, ya que no todas las funciones del producto diseñadas para los casos de uso de LinkedIn eran aplicables a un público más amplio en general. Además, WhereHows tiene algunas dependencias internas (infraestructura, bibliotecas, etc.) cuyo código fuente no es abierto. A lo largo de los años, WhereHows ha pasado por múltiples iteraciones y ciclos de desarrollo, lo que ha hecho que la sincronización de las dos bases de código sea un gran desafío. El equipo de metadatos ha estado tratando diferentes enfoques durante años para intentar sincronizar el desarrollo interno y el desarrollo de código abierto.
Primer intento: 'Primero código abierto'
Inicialmente seguimos un modelo de desarrollo 'primero código abierto', donde el desarrollo principal ocurre en un repositorio de código abierto y los cambios se hacen para el despliegue interno. El problema con este enfoque es que el código siempre se envía primero a GitHub antes de ser completamente revisado internamente. No detectaremos problemas de producción hasta que se implementen cambios desde el repositorio de código abierto y se realice un nuevo despliegue interno. En caso de un mal despliegue, también fue muy difícil determinar el culpable, ya que los cambios se hicieron en lotes.
Además, este modelo redujo la productividad del equipo al desarrollar nuevas funciones que requerían iteraciones rápidas, ya que obligaba a colocar todos los cambios primero en el repositorio de código abierto y luego transferirlos al repositorio interno. Para acortar el tiempo de procesamiento, cualquier corrección o cambio podría hacerse primero en el repositorio interno, pero esto se convirtió en un gran problema cuando se trató de fusionar esos cambios de nuevo en el repositorio de código abierto, porque las dos bases de código se desincronizaron.
Este modelo es mucho más fácil de implementar para plataformas generales, bibliotecas o proyectos de infraestructura que para aplicaciones web completas del usuario. Además, este modelo es ideal para proyectos que comienzan con código abierto desde el primer día, pero WhereHows fue creado como una aplicación web completamente interna. Fue difícil abstraerse por completo de todas las dependencias internas, así que necesitamos mantener un fork interno, pero mantener ese fork interno y desarrollar principalmente con código abierto no funcionó del todo.
Segundo intento: 'Primero interno'
** Como segunda tentativa, pasamos a un modelo de desarrollo 'primero interno' en el que el desarrollo principal ocurre dentro de la empresa, y los cambios se realizan en el código abierto de manera regular. Aunque este modelo es el más adecuado para nuestro caso de uso, presenta problemas. Enviar directamente todas las diferencias al repositorio de código abierto y luego intentar resolver los conflictos de fusión más tarde es una opción, pero consume mucho tiempo. Los desarrolladores en la mayoría de los casos intentan evitar esto en cada revisión de código. Como resultado, esto se realizará mucho menos frecuentemente, en lotes, dificultando así la resolución posterior de conflictos de fusión.
¡En el tercer intento, todo salió bien!
Los dos intentos fallidos mencionados anteriormente llevaron a que el repositorio de WhereHows en GitHub permaneciera desactualizado durante un largo período. El equipo continuó mejorando las funciones y la arquitectura del producto, por lo que la versión interna de WhereHows para LinkedIn se volvió cada vez más avanzada que la versión de código abierto. Incluso tuvo un nuevo nombre: DataHub. Basándose en los intentos fallidos anteriores, el equipo decidió desarrollar una solución escalable a largo plazo.
Para cualquier nuevo proyecto de código abierto, el equipo de desarrolladores de código abierto de LinkedIn asesora y respalda un modelo de desarrollo en el que los módulos del proyecto se desarrollan completamente con código abierto. Los artefactos con soporte de versiones se implementan en un repositorio público y luego se devuelven al artefacto interno de LinkedIn mediante Seguir este modelo de desarrollo no solo es beneficioso para quienes utilizan código abierto, sino que también conduce a la creación de arquitecturas más modulares, escalables y conectables.
Sin embargo, alcanzar este estado para una aplicación interna madura, como DataHub, requerirá una cantidad significativa de tiempo. Esto también excluye la posibilidad de tener una implementación completamente funcional de código abierto antes de que todas las dependencias internas se hayan abstraído por completo. Por lo tanto, hemos desarrollado herramientas que nos ayudan a contribuir al código abierto de manera más rápida y menos dolorosa. Esta solución beneficia tanto al equipo de metadatos (desarrollador de DataHub) como a la comunidad de código abierto. En las siguientes secciones se discutirá este nuevo enfoque.
Automatización de la publicación de código abierto
El último enfoque del grupo de metadatos hacia DataHub de código abierto consiste en desarrollar una herramienta que sincroniza automáticamente la base de código interna y el repositorio de código abierto. Las características de alto nivel de esta herramienta incluyen:
- Sincronización del código de LinkedIn con el código abierto y viceversa, similar a .
- Generación de encabezados de licencia, similar a .
- Creación automática de registros de commits de código abierto a partir de registros de commits internos.
- Prevención de cambios internos que rompan la construcción del código abierto mediante .
En las siguientes subsecciones se detallarán las características mencionadas anteriormente, que presentan problemas interesantes.
Sincronización del código fuente
A diferencia de la versión de DataHub de código abierto, que es un único repositorio de GitHub, la versión de DataHub para LinkedIn es una combinación de varios repositorios (dentro de la empresa llamados ). La interfaz de DataHub, la biblioteca de modelos de metadatos, el servicio de almacenamiento de metadatos y las tareas de flujo se encuentran en diferentes repositorios en LinkedIn. Sin embargo, para facilitar el trabajo de los usuarios con el código abierto, tenemos un único repositorio para la versión de DataHub de código abierto.
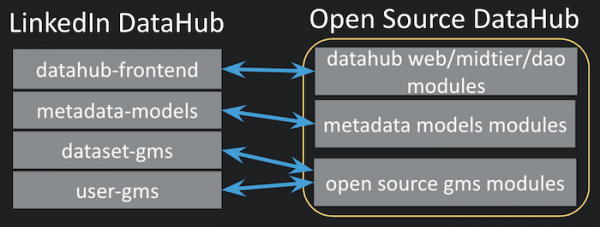
Figura 1: Sincronización entre repositorios LinkedIn DataHub y un único repositorio DataHub de código abierto
Para admitir flujos de trabajo automáticos de construcción, envío y extracción, nuestra nueva herramienta crea automáticamente un mapeo a nivel de archivo correspondiente a cada archivo fuente. Sin embargo, se requiere una configuración inicial para el kit de herramientas, y los usuarios deben proporcionar un mapeo de módulos de alto nivel, como se muestra a continuación.
{
  "datahub-dao": [
    "${datahub-frontend}\/datahub-dao"
  ],
  "gms\/impl": [
    "${dataset-gms}\/impl",
    "${user-gms}\/impl"
  ],
  "metadata-dao": [
    "${metadata-models}\/metadata-dao"
  ],
  "metadata-builders": [
    "${metadata-models}\/metadata-builders"
  ]
}
El mapeo a nivel de módulo es un JSON simple, cuyos claves son los módulos de destino en el repositorio de código abierto, y los valores son una lista de módulos fuente en los repositorios de LinkedIn. Cualquier módulo de destino en el repositorio de código abierto puede alimentarse de cualquier cantidad de módulos fuente. Para denotar nombres internos de repositorios en los módulos fuente, se utiliza estilo Bash. Usando el archivo de mapeo a nivel de módulo, las herramientas crean un archivo de mapeo a nivel de archivos, escaneando todos los archivos en los directorios relacionados.
{
  "${metadata-models}\/metadata-builders\/src\/main\/java\/com\/linkedin\/Foo.java":
"metadata-builders\/src\/main\/java\/com\/linkedin\/Foo.java",
  "${metadata-models}\/metadata-builders\/src\/main\/java\/com\/linkedin\/Bar.java":
"metadata-builders\/src\/main\/java\/com\/linkedin\/Bar.java",
  "${metadata-models}\/metadata-builders\/build.gradle": null,
}
El mapeo a nivel de archivo se crea automáticamente por las herramientas; sin embargo, también puede ser actualizado manualmente por el usuario. Este mapeo es 1:1 entre el archivo fuente de LinkedIn y el archivo en el repositorio de código abierto. Hay varias reglas asociadas con esta creación automática del mapeo de archivos:
- En caso de que haya múltiples módulos fuente para un módulo de destino en el código abierto, pueden surgir conflictos, como el mismo , que existe en más de un módulo fuente. Como estrategia de resolución de conflictos, nuestras herramientas por defecto utilizan la opción de 'último gana'.
- «null» significa que el archivo fuente no es parte del repositorio de código abierto.
- Después de cada envío al código fuente abierto o su extracción, esta correspondencia se actualiza automáticamente y se crea una instantánea. Esto es necesario para identificar las adiciones y eliminaciones del código fuente después de la última acción.
Creación de registros de confirmaciones
Los registros de confirmaciones para las confirmaciones de código abierto también se crean automáticamente al fusionar los registros de confirmaciones de los repositorios internos. A continuación se muestra un ejemplo de registro de confirmación para ilustrar la estructura del registro de confirmación creado por nuestra herramienta. La confirmación indica claramente qué versiones de los repositorios de origen están empaquetadas en esta confirmación y proporciona un resumen del registro de confirmación. Consulte este en un ejemplo real del registro de confirmación creado por nuestras herramientas.
metadata-models 29.0.0 -> 30.0.0
    Se agregó el modelo de aspecto foo
    Se solucionó el problema bar

dataset-gms 2.3.0 -> 2.3.4
    Se agregó la API rest.li para servir el aspecto foo

MP_VERSION=dataset-gms:2.3.4
MP_VERSION=metadata-models:30.0.0
Pruebas de dependencia
LinkedIn tiene , que ayuda a garantizar que los cambios en el multiproducto interno no rompan la construcción de los multiproductos dependientes. El repositorio DataHub de código abierto no es multiproducto y no puede ser una dependencia directa de ningún multiproducto, pero mediante un contenedor multiproducto que extrae el código fuente de DataHub de código abierto, aún podemos usar este sistema de pruebas de dependencia. Por lo tanto, cualquier cambio (que posiblemente se abrirá más tarde) en cualquiera de los multiproductos que alimentan el repositorio DataHub de código abierto activa un evento de construcción en el contenedor multiproducto. Por consiguiente, cualquier cambio que no permita construir el contenedor multiproducto no pasa las pruebas antes de la confirmación del multiproducto de origen y se rechaza.
Este es un mecanismo útil que ayuda a prevenir cualquier confirmación interna que rompa la construcción del código abierto y lo detecta durante la creación de la confirmación. Sin esto, sería bastante difícil identificar qué confirmación interna causó la falla en la construcción del repositorio de código abierto, ya que colocamos cambios internos por lotes en el repositorio DataHub de código abierto.
Diferencias entre DataHub de código abierto y nuestra versión de producción
Hasta este momento, hemos discutido nuestra solución para sincronizar las dos versiones de los repositorios de DataHub, pero aún no hemos señalado las razones por las cuales necesitamos dos flujos de desarrollo diferentes. En esta sección, enumeraremos las diferencias entre la versión pública de DataHub y la versión de producción en los servidores de LinkedIn, así como explicaremos las razones de estas diferencias.
Una de las fuentes de discrepancias proviene del hecho de que nuestra versión de producción tiene dependencias de código que aún no son de código abierto, como Offspring de LinkedIn (la estructura interna de implementación de dependencias de LinkedIn). Offspring se utiliza ampliamente en la base de código interna, ya que es el método preferido para gestionar la configuración dinámica. Sin embargo, como no es de código abierto, necesitamos encontrar alternativas de código abierto para DataHub de código abierto.
Hay otras razones también. A medida que creamos extensiones del modelo de metadatos para las necesidades de LinkedIn, estas extensiones suelen ser muy específicas de LinkedIn y pueden no aplicarse directamente a otros entornos. Por ejemplo, tenemos etiquetas muy específicas para identificadores de participantes y otros tipos de metadatos de coincidencia. Por lo tanto, actualmente hemos excluido estas extensiones del modelo de metadatos de DataHub de código abierto. A medida que interactuamos con la comunidad y comprendemos sus necesidades, trabajaremos en versiones comunes de estas extensiones de código abierto donde sea necesario.
La facilidad de uso y una adaptación más sencilla para la comunidad de código abierto también han inspirado algunas diferencias entre las dos versiones de DataHub. Las diferencias en la infraestructura de procesamiento en tiempo real son un buen ejemplo de esto. Aunque nuestra versión interna utiliza infraestructura de procesamiento en tiempo real gestionado, decidimos usar procesamiento en tiempo real integrado (autónomo) para la versión de código abierto, ya que evita la creación de otra dependencia de infraestructura.
Otro ejemplo de la diferencia es la presencia de un único GMS (Almacenamiento Generalizado de Metadatos) en la implementación de código abierto, en lugar de varios GMS. GMA (Arquitectura Generalizada de Metadatos) es el nombre de la arquitectura interna para DataHub, mientras que GMS es el almacenamiento de metadatos en el contexto de GMA. GMA es una arquitectura muy flexible que le permite distribuir cada construcción de datos (por ejemplo, conjuntos de datos, usuarios, etc.) en su propio almacenamiento de metadatos o almacenar varias construcciones de datos en un único almacenamiento de metadatos siempre que el registro que contiene el mapeo de la estructura de datos en GMS se actualice. Para mayor facilidad de uso, elegimos una instancia de GMS que almacena todas las diversas construcciones de datos en DataHub de código abierto.
La lista completa de diferencias entre las dos implementaciones se presenta en la tabla a continuación.
Características del producto
LinkedIn DataHub
Open Source DataHub
Construcciones de datos soportadas
1) Conjuntos de datos 2) Usuarios 3) Métricas 4) Características de ML 5) Gráficos 6) Paneles
1) Conjuntos de datos 2) Usuarios
Fuentes de metadatos soportadas para conjuntos de datos
1) 2) Couchbase 3) 4) 5) HDFS 6) Hive 7) Kafka 8) MongoDB 9) MySQL 10) Oracle 11) 12) Presto 12) 13) Teradata 13) Vector 14)
Hive Kafka RDBMS
Pub-sub
Confluent Kafka
Procesamiento de flujos
Gestión
Integrado (independiente)
Inyección de dependencias y configuración dinámica
LinkedIn Offspring
Herramientas de construcción
Ligradle (el envoltorio de Gradle interno de LinkedIn)
CI/CD
CRT (CI/CD interno de LinkedIn)
y
Almacenes de metadatos
Múltiples GMS distribuidos: 1) GMS de conjunto de datos 2) GMS de usuario 3) GMS de métrica 4) GMS de características 5) GMS de gráfico/panel
Un GMS único para: 1) Conjuntos de datos 2) Usuarios
Microservicios en contenedores Docker
simplifica el despliegue y la distribución de aplicaciones utilizando . Cada parte del servicio en DataHub de código abierto, incluidos los componentes de infraestructura como Kafka, , y , tiene su propia imagen de Docker. Para la orquestación de contenedores Docker, utilizamos .
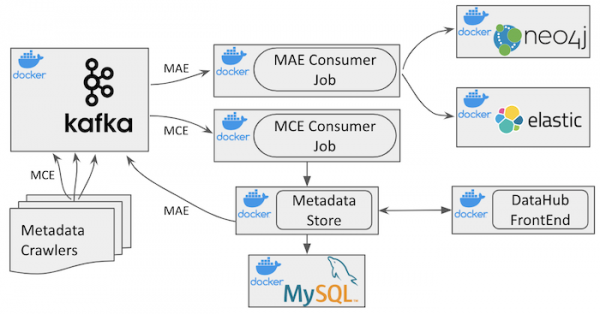
Figura 2: Arquitectura DataHub *de código abierto*
Puede ver la arquitectura de alto nivel de DataHub en la imagen anterior. Además de los componentes de infraestructura, tiene cuatro contenedores Docker diferentes:
datahub-gms: servicio de almacenamiento de metadatos
datahub-frontend: aplicación , que sirve la interfaz de DataHub.
datahub-mce-consumer: aplicación , que utiliza un flujo de eventos de cambio de metadatos (MCE) y actualiza el almacenamiento de metadatos.
datahub-mae-consumer: aplicación , que utiliza un flujo de eventos de auditoría de metadatos (MAE) y crea una base de datos de índice de búsqueda y un gráfico.
Documentación del repositorio de código abierto y contiene más información sobre las funciones de varios servicios.
CI / CD en DataHub de código abierto
El repositorio de DataHub de código abierto utiliza para la integración continua y para el despliegue continuo. Ambos tienen una buena integración con GitHub y son fáciles de configurar. Para la mayor parte de la infraestructura de código abierto, desarrollada por la comunidad o empresas privadas (por ejemplo, ), se han creado imágenes de Docker, que se despliegan en Docker Hub para facilitar su uso por parte de la comunidad. Cualquier imagen de Docker que se encuentre en Docker Hub se puede utilizar fácilmente con el siguiente comando .
Con cada commit en el repositorio de código abierto de DataHub, todas las imágenes de Docker se crean y despliegan automáticamente en Docker Hub con la etiqueta 'latest'. Si en Docker Hub se configura alguna , todas las etiquetas en el repositorio de código abierto también se publican con los nombres de etiquetas correspondientes en Docker Hub.
Uso de DataHub
es muy simple y consta de tres pasos sencillos:
- Clona el repositorio de código abierto y lanza todos los contenedores de Docker utilizando docker-compose con el script proporcionado para un inicio rápido.
- Descarga muestras de datos presentadas en el repositorio mediante la herramienta de línea de comandos que también se proporciona.
- Visualiza DataHub en tu navegador.
Un también está configurado para preguntas rápidas. Los usuarios también pueden crear problemas directamente en el repositorio de GitHub. Lo más importante es que valoramos y apreciamos todos los comentarios y sugerencias.
Planes futuros
Actualmente, cada infraestructura o microservicio para DataHub de código abierto se construye como un contenedor Docker, y todo el sistema se orquesta utilizando . Dada su popularidad y amplia adopción, también nos gustaría proporcionar una solución basada en Kubernetes en un futuro próximo.
También planeamos ofrecer una solución lista para el despliegue de DataHub en un servicio en la nube público, como , o Dado el reciente anuncio sobre la migración de LinkedIn a Azure, esto se alineará con las prioridades internas del grupo de metadatos.
Y por último, pero no menos importante: agradecemos a todos los primeros usuarios de DataHub en la comunidad de código abierto, quienes han valorado las versiones alfa de DataHub y nos han ayudado a identificar problemas y mejorar la documentación.
Fuente: habr.com
