

La empresa Variti desarrolla protección contra bots y ataques DDoS, así como realiza pruebas de estrés y carga. En la conferencia HighLoad++ 2018, hablamos sobre cómo proteger los recursos de diversos tipos de ataques. En resumen: aísle partes del sistema, utilice servicios en la nube y CDN, y manténgase actualizado regularmente. Pero sin empresas especializadas en protección, usted aún no podrá manejarlo 🙂
Antes de leer el texto, puede consultar un resumen breve .
Y si no le gusta leer o simplemente quiere ver el video, la grabación de nuestra presentación está a continuación bajo el spoiler.
Grabación del informe
Muchas empresas ya saben cómo realizar pruebas de carga, pero no todas hacen pruebas de estrés. Algunos de nuestros clientes piensan que su sitio es invulnerable porque tienen un sistema de alta carga, y este protege bien contra ataques. Sin embargo, nosotros mostramos que esto no es del todo cierto.
Por supuesto, antes de realizar las pruebas, obtenemos permiso del cliente, con firma y sello, y con nuestra ayuda, no se puede realizar un ataque DDoS a nadie. La prueba se lleva a cabo en el momento elegido por el cliente, cuando la asistencia a su recurso es mínima, y los problemas de acceso no afectarán a los clientes. Además, dado que en el proceso de prueba siempre puede salir algo mal, mantenemos contacto constante con el cliente. Esto permite no solo informar sobre los resultados alcanzados, sino también hacer ajustes durante la prueba. Al finalizar la prueba, siempre elaboramos un informe en el que señalamos las deficiencias encontradas y damos recomendaciones para corregir los puntos débiles del sitio.
Cómo trabajamos
Al realizar las pruebas, emulamos una botnet. Dado que trabajamos con clientes que no se encuentran en nuestras redes, para que la prueba no finalice en el primer minuto debido a límites o protecciones activadas, generamos carga no desde una IP, sino desde nuestra propia subred. Además, para crear una carga considerable, contamos con nuestro propio servidor de pruebas bastante potente.
Postulados
Mucho no significa bien
Cuanto menor sea la carga que podamos llevar al recurso hasta el fallo, mejor. Si logramos que el sitio deje de funcionar con una solicitud por segundo, o incluso con una solicitud por minuto, sería excelente. Porque, por ley de Murphy, los usuarios o delincuentes acabarán cayendo en esa vulnerabilidad.
Un fallo parcial es mejor que un fallo total.
Siempre aconsejamos que los sistemas sean heterogéneos. Además, deben separarse a nivel físico, no solo a través de la contenedorización. En caso de separación física, incluso si algo falla en el sitio, es probable que no deje de funcionar por completo, y los usuarios mantendrán al menos un acceso parcial a la funcionalidad.
La arquitectura correcta es la base de la resiliencia.
La resiliencia del recurso y su capacidad para soportar ataques y cargas deben incorporarse desde la fase de diseño, de hecho, desde el momento en que se dibujan los primeros diagramas de bloques en un cuaderno. Porque si se cometen errores fatales, se pueden corregir más adelante, pero será muy difícil.
No solo el código debe ser bueno, también la configuración.
Muchos piensan que un buen equipo de desarrollo garantiza la resiliencia del servicio. Un buen equipo de desarrollo es realmente necesario, pero también debe haber una buena operación, un buen DevOps. Es decir, se necesitan especialistas que configuren Linux y la red correctamente, que redacten las configuraciones en nginx de manera adecuada, que configuren los límites, etc. De lo contrario, el recurso solo funcionará bien en pruebas, pero en producción, en algún momento, todo fallará.
Diferencias entre pruebas de carga y pruebas de estrés.
Las pruebas de carga permiten identificar los límites de funcionamiento del sistema. Las pruebas de estrés se centran en encontrar los puntos débiles del sistema y se utilizan para romper ese sistema y observar cómo se comporta durante la falla de ciertas partes. Sin embargo, la naturaleza de la carga suele ser desconocida para el cliente antes de comenzar las pruebas de estrés.
Características distintivas de los ataques L7.
Los tipos de carga los dividimos normalmente en cargas de nivel L7 y L3&4. L7 es carga a nivel de aplicación, y con frecuencia se entiende solo HTTP, pero nosotros consideramos cualquier carga a nivel del protocolo TCP.
Los ataques L7 tienen ciertas características distintivas. En primer lugar, se dirigen directamente a la aplicación, lo que significa que es poco probable que se puedan mitigar mediante medios de red. Estos ataques utilizan lógica y, gracias a eso, consumen de manera muy efectiva y con poco tráfico, CPU, memoria, disco, base de datos y otros recursos.
Inundación HTTP
En el caso de cualquier ataque, es más fácil generar la carga que manejarla, y esto también es cierto para L7. El tráfico de ataque no siempre es fácil de distinguir del legítimo, y a menudo esto se logra por la frecuencia, pero si todo está bien planificado, es imposible determinar a partir de los registros dónde está el ataque y dónde están las solicitudes legítimas.
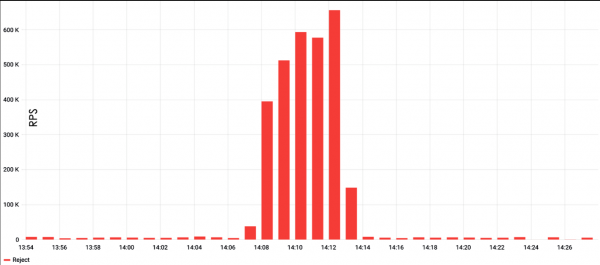
Como primer ejemplo, consideremos el ataque de Inundación HTTP. En el gráfico se puede ver que, por lo general, estos ataques son muy potentes; en el ejemplo a continuación, el número máximo de solicitudes superó los 600 mil por minuto.
La Inundación HTTP es la forma más simple de generar carga. Generalmente, se utiliza alguna herramienta de prueba de carga, como ApacheBench, y se establecen la solicitud y el objetivo. Con este enfoque sencillo, hay una alta probabilidad de encontrarse con el almacenamiento en caché del servidor, pero es fácil de eludir. Por ejemplo, agregando cadenas aleatorias a la solicitud, lo que obligará al servidor a entregar una página nueva constantemente.
Tampoco hay que olvidar el user-agent al generar carga. Muchos user-agents de herramientas de prueba populares son filtrados por administradores de sistemas, y en tal caso, la carga puede simplemente no llegar al backend. Se puede mejorar significativamente el resultado al insertar en la solicitud un encabezado más o menos válido de un navegador.
A pesar de la simplicidad del ataque, la Inundación HTTP también tiene sus desventajas. En primer lugar, se requieren grandes recursos para generar carga. En segundo lugar, estos ataques son muy fáciles de detectar, especialmente si provienen de una sola dirección. Como resultado, las solicitudes comienzan a ser filtradas por administradores de sistemas o incluso a nivel del proveedor.
Qué buscar
Para reducir la cantidad de solicitudes por segundo sin perder eficiencia, es necesario ser un poco creativo e investigar el sitio web. Así, se puede cargar no solo el canal o el servidor, sino también partes específicas de la aplicación, como bases de datos o sistemas de archivos. También se pueden buscar áreas en el sitio que realicen grandes cálculos: calculadoras, páginas de selección de productos, entre otros. Finalmente, a menudo hay algún script php en el sitio que genera una página a partir de cientos de miles de líneas. Este script también carga significativamente al servidor y puede convertirse en un objetivo de ataque.
Dónde buscar
Cuando escaneamos un recurso antes de realizar pruebas, lo primero que miramos, por supuesto, es el propio sitio. Buscamos todo tipo de campos de entrada, archivos pesados, en resumen, todo lo que pueda causar problemas al recurso y ralentizar su funcionamiento. Aquí ayudan las herramientas de desarrollo en Google Chrome y Firefox, que muestran los tiempos de respuesta de la página.
También escaneamos subdominios. Por ejemplo, hay una tienda en línea, abc.com, y tiene un subdominio admin.abc.com. Probablemente sea un panel de administración con autenticación, pero si se le aplica carga, puede causar problemas al recurso principal.
El sitio puede tener un subdominio api.abc.com. Lo más probable es que sea un recurso para aplicaciones móviles. Se puede encontrar la aplicación en App Store o Google Play, establecer un punto de acceso especial, explorar la API y registrar cuentas de prueba. El problema es que a menudo las personas piensan que todo lo que está protegido por autenticación es invulnerable a los ataques de denegación de servicio. Supuestamente, la autenticación es la mejor CAPTCHA, pero eso no es cierto. Crear 10-20 cuentas de prueba es sencillo, y al hacerlo, obtenemos acceso a funcionalidad compleja y sin proteger.
Por supuesto, miramos el historial, el robots.txt y WebArchive, ViewDNS, y buscamos versiones antiguas del recurso. A veces, ocurre que los desarrolladores lanzaron, digamos, mail2.yandex.net, y una versión antigua, mail.yandex.net, quedó. Este mail.yandex.net deja de ser mantenido, no se asignan recursos para su desarrollo, pero sigue consumiendo la base de datos. Por lo tanto, con la versión antigua se pueden utilizar eficazmente los recursos del backend y todo lo que está detrás del diseño. Claro, esto no sucede siempre, pero nos encontramos con algo similar con bastante frecuencia.
Por supuesto, analizamos todos los parámetros de la solicitud, la estructura de las cookies. Se podría, por ejemplo, inyectar un valor en un array JSON dentro de una cookie, crear una gran anidación y hacer que el recurso funcione de manera ineficaz durante mucho tiempo.
Carga en la búsqueda
Lo primero que se me ocurre al investigar un sitio web es cargar la base de datos, ya que casi todos tienen una función de búsqueda, y desafortunadamente, en muchos casos está mal protegida. Por alguna razón, los desarrolladores no prestan suficiente atención a la búsqueda. Pero hay una recomendación: no se deben hacer consultas homogéneas, porque se puede encontrar con problemas de almacenamiento en caché, como en el caso de un ataque por inundación HTTP.
Hacer consultas aleatorias en la base de datos tampoco siempre es efectivo. Es mucho mejor crear una lista de palabras clave relacionadas con la búsqueda. Volviendo al ejemplo de una tienda en línea: supongamos que el sitio vende neumáticos para automóviles y permite ajustar el radio de las llantas, el tipo de coche y otros parámetros. Por lo tanto, las combinaciones de palabras relevantes harán que la base de datos funcione en condiciones mucho más complejas.
Además, vale la pena utilizar paginación: es mucho más complicado para una búsqueda devolver la penúltima página de resultados que la primera. Es decir, mediante la paginación se puede diversificar un poco la carga.
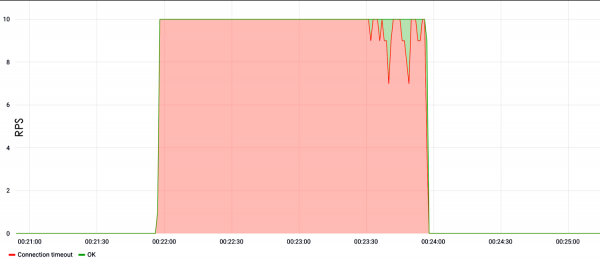
En el ejemplo a continuación mostramos la carga en la búsqueda. Se puede ver que desde el primer segundo de la prueba, a diez solicitudes por segundo, el sitio colapsó y no respondió.
¿Y si no hay búsqueda?
Si no hay búsqueda, no significa que el sitio no contenga otros campos de entrada vulnerables. Un campo de este tipo puede ser la autenticación. Hoy en día a los desarrolladores les gusta crear hashes complejos para proteger la base de datos de nombres de usuario de ataques de tablas arcoíris. Esto es bueno, pero tales hashes consumen muchos recursos de CPU. Un gran flujo de intentos de autenticación falsos puede llevar a la sobrecarga del procesador, lo que resulta en que el sitio deje de funcionar.
La presencia en el sitio de todo tipo de formularios para comentarios y retroalimentación es una razón para enviar textos muy grandes o simplemente crear un gran spam. A veces, los sitios aceptan archivos adjuntos, incluidos aquellos en formato gzip. En tal caso, tomamos un archivo de 1TB, lo comprimimos a través de gzip a unos pocos bytes o kilobytes y lo enviamos al sitio. Luego se descomprime y se obtiene un efecto muy interesante.
Rest API
Me gustaría dedicar un poco de atención a servicios tan populares hoy en día como el Rest API. Proteger un Rest API es mucho más complicado que proteger un sitio web ordinario. Incluso los métodos básicos de protección contra ataques de fuerza bruta y otras actividades ilegítimas no funcionan para un Rest API.
Es muy fácil romper un Rest API porque se conecta directamente a la base de datos. Además, la interrupción de este servicio puede tener consecuencias bastante graves para el negocio. Esto se debe a que el Rest API no solo está vinculado al sitio principal, sino también a aplicaciones móviles y a ciertos recursos internos del negocio. Si todo esto falla, el efecto es mucho más fuerte que en el caso de un simple sitio web que deja de funcionar.
Carga de contenido pesado
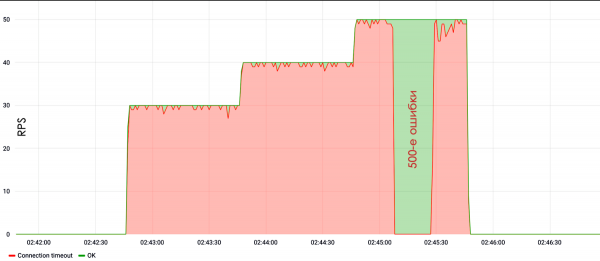
Si nos proponen probar una aplicación de una sola página, una página de aterrizaje o una tarjeta de visita con funcionalidad sencilla, buscamos contenido pesado. Por ejemplo, grandes imágenes que proporciona el servidor, archivos binarios, documentación en PDF; intentamos descargar todo esto. Estas pruebas sobrecargan bien el sistema de archivos y saturan los canales, por lo que son efectivas. Es decir, incluso si no haces caer el servidor al descargar un archivo grande a velocidades bajas, simplemente saturarás el canal del servidor objetivo y entonces ocurrirá una denegación de servicio.
En el ejemplo de esta prueba, se puede ver que a una velocidad de 30 RPS el sitio dejó de responder o dio errores de servidor 500.
No debemos olvidar la configuración de los servidores. A menudo se puede ver que una persona compró una máquina virtual, instaló Apache, lo configuró todo por defecto, colocó una aplicación PHP y abajo se puede ver el resultado.
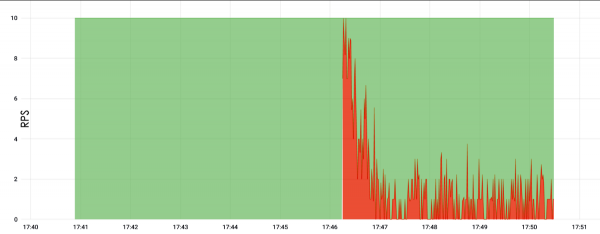
Aquí la carga fue al raíz y alcanzó solo 10 RPS. Esperamos 5 minutos y el servidor falló. Aunque no se sabe con certeza por qué falló, se sospecha que simplemente se quedó sin memoria y por eso dejó de responder.
Basado en ondas
En los últimos uno o dos años, los ataques basados en ondas se han vuelto bastante populares. Esto se debe a que muchas organizaciones compran ciertos equipos para protegerse contra DDoS, los cuales requieren un tiempo específico para acumular estadísticas antes de empezar a filtrar el ataque. Es decir, no filtran el ataque en los primeros 30-40 segundos, ya que están acumulando datos y aprendiendo. Por lo tanto, durante esos 30-40 segundos se puede lanzar tal cantidad de tráfico al sitio que el recurso estará caído durante un tiempo prolongado, hasta que se procesen todas las solicitudes.
En el caso del ataque a continuación, hubo un intervalo de 10 minutos, después del cual llegó una nueva porción de ataque, modificada.
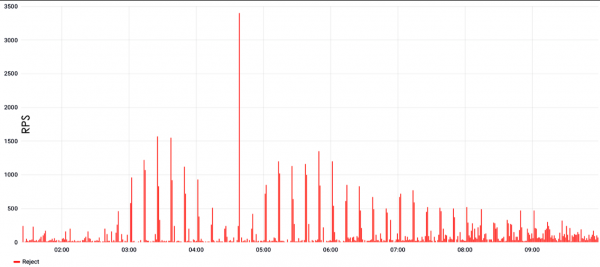
Es decir, la protección aprendió, activó la filtración, pero llegó una nueva porción de ataque completamente diferente, y la protección comenzó a aprender de nuevo. De hecho, la filtración deja de funcionar, la protección se vuelve ineficaz y el sitio no está disponible.
Los ataques basados en ondas se caracterizan por valores muy altos en el pico; pueden alcanzar hasta cien mil o un millón de solicitudes por segundo en el caso de L7. Si hablamos de L3&4, puede haber cientos de gigabits de tráfico, o, en consecuencia, cientos de mpps, si los contamos en paquetes.
El problema de estos ataques está en la sincronización. Los ataques provienen de un botnet, y para crear un pico muy grande en un solo momento, se requiere un alto grado de sincronización. Y esta coordinación no siempre se logra: a veces, el resultado es un pico parabólico que se ve bastante pobre.
No solo HTTP
Además de HTTP en el nivel L7, nos gusta explotar otros protocolos. Por lo general, un sitio web común, especialmente en un hosting estándar, expone protocolos de correo y MySQL. Los protocolos de correo son menos susceptibles a la carga que las bases de datos, pero también se pueden sobrecargar de manera bastante efectiva, resultando en un CPU sobrecargado en el servidor.
Logramos tener éxito utilizando la vulnerabilidad SSH de 2016. Ahora esta vulnerabilidad ha sido prácticamente corregida por todos, pero eso no significa que no se pueda cargar SSH. Se puede. Simplemente se genera una carga enorme de autorizaciones, SSH consume casi toda la CPU del servidor y el sitio web comienza a fallar con solo una o dos solicitudes por segundo. Por lo tanto, estas una o dos solicitudes no se pueden distinguir de la carga legítima en los registros.
Siguen siendo relevantes muchas conexiones que abrimos en los servidores. Antes, esto era un problema en Apache, y ahora también lo es en nginx, ya que a menudo se configura por defecto. El número de conexiones que nginx puede mantener abiertas está limitado, por lo que si alcanzamos este número de conexiones, nginx no aceptará una nueva conexión y, como resultado, el sitio web deja de funcionar.
Nuestro clúster de prueba tiene suficiente CPU para atacar el SSL handshake. En principio, como muestra la práctica, los botnets también a veces les gusta hacer esto. Por un lado, está claro que sin SSL no se puede evitar, debido a la presentación en Google, el ranking y la seguridad. Por otro lado, el SSL, lamentablemente, tiene un problema con la CPU.
L3&4
Cuando hablamos de un ataque en niveles L3&4, generalmente nos referimos a un ataque a nivel de canal. Esta carga es casi siempre distinguible de la carga legítima, a menos que se trate de un ataque SYN-flood. El problema de los ataques SYN-flood para los medios de protección radica en su gran volumen. El máximo registrado en L3&4 fue de 1.5-2 Tbps. Este tipo de tráfico es muy difícil de manejar incluso para grandes empresas, incluyendo Oracle y Google.
SYN y SYN-ACK son paquetes que se utilizan para establecer una conexión. Por lo tanto, es difícil distinguir un SYN-flood de una carga legítima: no está claro si es un SYN que llegó para establecer una conexión o parte de un flood.
UDP-flood
Normalmente, los atacantes no tienen la capacidad que tenemos nosotros, por lo que pueden usar amplificación para llevar a cabo ataques. Es decir, el atacante escanea internet y encuentra servidores vulnerables o mal configurados que, por ejemplo, responden con tres SYN-ACK a un solo paquete SYN. Al falsificar la dirección de origen desde la dirección del servidor objetivo, se puede aumentar la capacidad, digamos, hasta tres veces, redirigiendo el tráfico hacia la víctima.
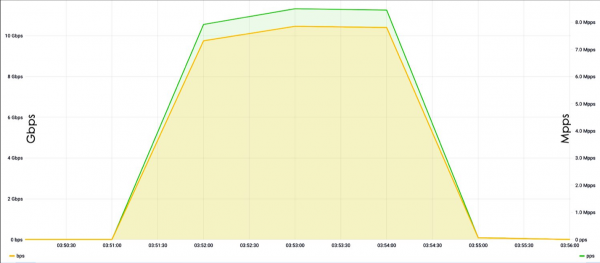
El problema de las amplificaciones radica en su difícil detección. Un ejemplo reciente es el conocido caso con memcached vulnerable. Además, ahora hay muchos dispositivos IoT y cámaras IP, que a menudo están configurados por defecto y, en su mayoría, de manera incorrecta, por lo que los atacantes utilizan estos dispositivos para realizar ataques con mayor frecuencia.
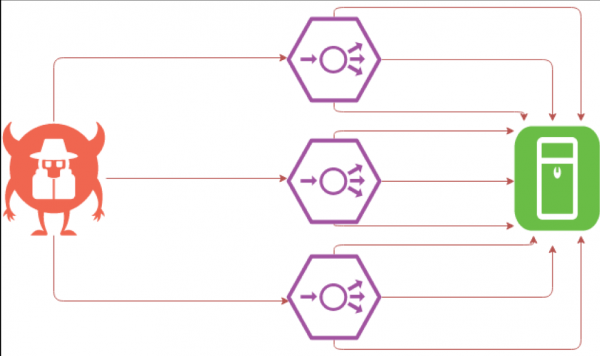
SYN-flood complicado
El SYN-flood es probablemente el tipo de ataque más interesante para los desarrolladores. El problema es que a menudo los administradores de sistemas utilizan el bloqueo por IP como medida de protección. De hecho, no solo los administradores que actúan siguiendo guías se ven afectados por el bloqueo por IP, sino que, lamentablemente, también ciertas soluciones de seguridad que se compran a un alto costo.
Este método puede resultar en un desastre, ya que si los atacantes suplantan IP, la empresa bloqueará su propia subred. Cuando el firewall bloquea su propio clúster, las interacciones externas colapsarán y el recurso fallará.
Además, lograr bloquear la propia red no es complicado. Si en la oficina del cliente hay una red Wi-Fi, o si el rendimiento de los recursos se mide mediante diversos monitoreos, tomamos la dirección IP de ese sistema de monitoreo o del cliente de Wi-Fi de la oficina y la utilizamos como fuente. Aparentemente, el recurso está disponible, pero las direcciones IP dirigidas están bloqueadas. Así, una red Wi-Fi de una conferencia como HighLoad, donde se presenta un nuevo producto de la empresa, puede quedar bloqueada, lo que implica ciertos costos empresariales y económicos.
Durante la prueba, no podemos utilizar amplificación a través de memcached con recursos externos, porque hay acuerdos para enviar tráfico solo a direcciones IP permitidas. Por lo tanto, utilizamos amplificación a través de SYN y SYN-ACK, cuando al enviar un SYN, el sistema responde con dos o tres SYN-ACK, multiplicando así el ataque por dos o tres.
Herramientas
Una de las principales herramientas que utilizamos para carga en el nivel L7 es Yandex-tank. En particular, se utiliza un fantasma como cañón, además de varios scripts para generar municiones y analizar resultados.
Para analizar el tráfico de red se utiliza Tcpdump y para el análisis del servidor Nmap. Para crear carga en los niveles L3&4 se utilizan OpenSSL y un poco de magia propia con la biblioteca DPDK. DPDK es una biblioteca de Intel que permite trabajar con la interfaz de red, omitiendo el stack de Linux, aumentando así la eficiencia. Por supuesto, no usamos DPDK solo en los niveles L3&4, sino también en el nivel L7, ya que permite generar un flujo de carga muy alto, de varios millones de solicitudes por segundo desde una sola máquina.
También utilizamos ciertos generadores de tráfico y herramientas especiales que desarrollamos para pruebas específicas. Si recordamos la vulnerabilidad bajo SSH, el conjunto mencionado anteriormente no puede ser explotado. Si atacamos un protocolo de correo, utilizamos utilidades de correo o simplemente escribimos scripts para ellas.
Conclusiones
Como conclusión, me gustaría decir:
- Además de las pruebas de carga clásicas, también es fundamental realizar pruebas de estrés. Tenemos un ejemplo real en el que un subcontratista del socio solo llevó a cabo pruebas de carga. Esto mostró que el recurso soporta una carga normal. Pero luego apareció una carga anormal, los visitantes del sitio comenzaron a utilizar el recurso de manera diferente, y al final el subcontratista colapsó. Por lo tanto, vale la pena buscar vulnerabilidades, incluso si ya está protegido contra ataques DDoS.
- Es necesario aislar algunas partes del sistema de otras. Si tiene búsqueda, debe trasladarla a máquinas separadas, es decir, ni siquiera en Docker. Porque si falla la búsqueda o la autorización, al menos algo seguirá funcionando. En el caso de una tienda en línea, los usuarios seguirán encontrando productos en el catálogo, accediendo desde un agregador, comprando si ya están autorizados o autorizándose a través de OAuth2.
- No hay que despreciar todos los servicios en la nube.
- Utilice CDN no solo para optimizar la latencia de red, sino también como un medio de protección contra ataques de agotamiento de canal y simplemente inundaciones en estática.
- Es necesario utilizar servicios de protección especializados. No podrá protegerse solo contra ataques L3&4 a nivel de canal, porque probablemente no tiene suficiente ancho de banda. Tampoco podrá defenderse de los ataques L7, ya que suelen ser muy grandes. Además, la búsqueda de pequeños ataques sigue siendo el privilegio de servicios especiales y algoritmos especializados.
- Actualícese regularmente. Esto se aplica no solo al núcleo, sino también al daemon SSH, especialmente si están abiertos al exterior. En general, debe actualizar todo, porque es poco probable que pueda rastrear usted mismo ciertas vulnerabilidades.
Fuente: habr.com
