

Transcripción del informe de 2015 de Alexey Lesovski "Un análisis profundo de las estadísticas internas de PostgreSQL"
Aviso del autor del informe: Cabe mencionar que este informe está fechado en noviembre de 2015; han pasado más de 4 años y ha transcurrido mucho tiempo. La versión discutida en el informe, 9.4, ya no es compatible. En los últimos 4 años, se han lanzado 5 nuevas versiones que han traído una gran cantidad de innovaciones, mejoras y cambios en lo que respecta a las estadísticas, y parte del material se ha vuelto obsoleto y no es relevante. Durante la revisión, traté de señalar esos lugares para no confundir al lector. Sin embargo, no reescribí esas secciones, ya que son demasiadas y acabaría resultando en un informe completamente diferente.
La base de datos PostgreSQL es un mecanismo enorme, compuesto por múltiples subsistemas, de cuya interacción depende directamente el rendimiento de la base de datos. Durante su uso, se recopila estadísticas e información sobre el funcionamiento de los componentes, lo que permite evaluar la eficiencia de PostgreSQL y tomar medidas para mejorar el rendimiento. Sin embargo, hay mucha información y se presenta de manera bastante simplificada. Procesar esta información e interpretarla puede ser una tarea bastante no trivial, y el "zoológico" de herramientas y utilidades puede desconcertar incluso a un DBA experimentado.
¡Hola! Me llamo Alexey. Como dijo Ilya, hablaré sobre las estadísticas de PostgreSQL.
Estadísticas de actividad de PostgreSQL. PostgreSQL tiene dos tipos de estadísticas. La estadística de actividad, que será el tema de esta charla, y la estadística del planificador sobre la distribución de datos. Hoy me centraré en la estadística de actividad de PostgreSQL, que nos permite juzgar el rendimiento y cómo mejorarlo.
Voy a contar cómo utilizar eficazmente las estadísticas para resolver una variedad de problemas que se presentan o pueden presentarse.
¿Qué no estará en el informe? En este informe no hablaré sobre las estadísticas del planificador, ya que es un tema separado que merece un informe propio sobre cómo se almacenan los datos en la base y cómo el planificador de consultas adquiere una visión de las características cualitativas y cuantitativas de esos datos.
Tampoco habrá revisión de herramientas, no compararé un producto con otro. No habrá publicidad. Dejemos eso de lado.
Quiero mostrarles que usar estadísticas es útil. Es necesario. No da miedo utilizarlas. Solo necesitaremos SQL básico y conocimientos fundamentales de SQL.
Hablaremos sobre qué estadísticas elegir para resolver problemas.
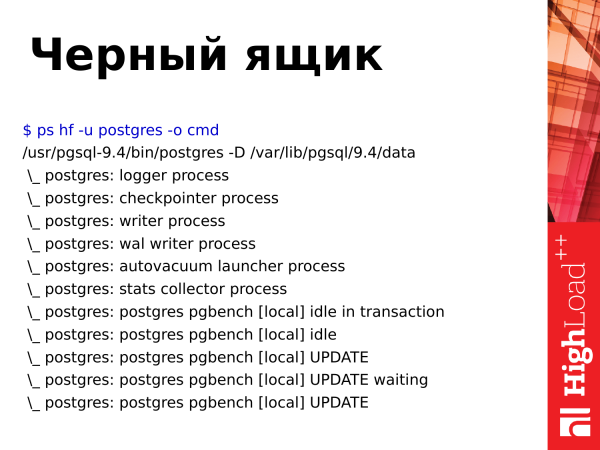
Si miramos PostgreSQL y ejecutamos un comando en el sistema operativo para ver los procesos, veremos una "caja negra". Veremos algunos procesos que están haciendo algo, y por su nombre podemos suponer aproximadamente qué están haciendo. Pero, en esencia, es una caja negra, no podemos mirar dentro.
Podemos observar la carga del procesador en top, podemos ver la utilización de la memoria con algunas utilidades del sistema, pero no podremos ver dentro de PostgreSQL. Para eso necesitamos otras herramientas.
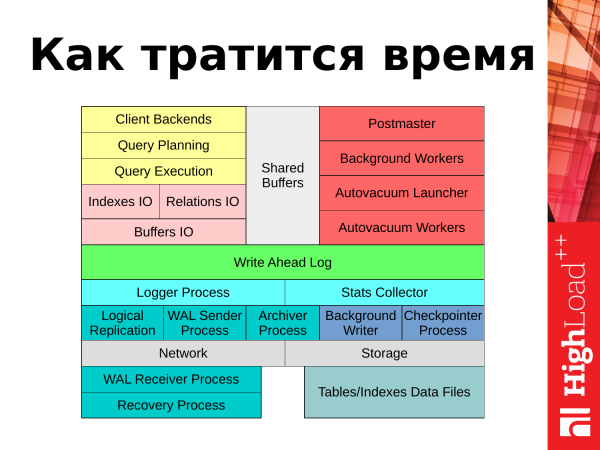
Siguiendo adelante, hablaré sobre a dónde se va el tiempo. Si imaginamos PostgreSQL como un diagrama, podremos responder a dónde se va el tiempo. Hay dos cosas: el procesamiento de las solicitudes de los clientes de las aplicaciones y las tareas en segundo plano que PostgreSQL realiza para mantener su funcionamiento.
Si comenzamos a considerar desde la esquina superior izquierda, podemos rastrear cómo se procesan las solicitudes de los clientes. La solicitud llega de la aplicación y para continuar, se abre una sesión de cliente. La solicitud se pasa al planificador. El planificador crea un plan para la solicitud. Lo envía para su ejecución. Se produce algún tipo de entrada/salida de bloques de datos relacionados con las tablas y los índices. Los datos necesarios se leen desde los discos a la memoria en un área especial llamada "shared buffers". Los resultados de la solicitud, si son actualizaciones, eliminaciones, se registran en el diario de transacciones en el WAL. Parte de la información estadística se guarda en el registro o en el colector de estadísticas. Y el resultado de la solicitud se devuelve al cliente. Después de lo cual el cliente puede repetir todo desde el principio con una nueva solicitud.
¿Qué sucede con las tareas en segundo plano y los procesos en segundo plano? Hay varios procesos que aseguran el funcionamiento y mantienen la base de datos en un estado operativo normal. Estos procesos también se abordarán en la presentación: son autovacuum, checkpointer, procesos relacionados con la replicación y el escritor en segundo plano. Cada uno de ellos lo discutiré a medida que avance la presentación.
¿Qué problemas hay con las estadísticas?
- Hay mucha información. PostgreSQL 9.4 proporciona 109 métricas para visualizar datos estadísticos. Sin embargo, si en la base de datos se almacenan muchas tablas, esquemas y bases, entonces todas estas métricas deben multiplicarse por el número correspondiente de tablas y bases. Es decir, la información se vuelve aún más abundante. Y es muy fácil ahogarse en ella.
- El siguiente problema es que las estadísticas se presentan en forma de contadores. Si miramos estas estadísticas, veremos contadores que aumentan constantemente. Y si ha pasado mucho tiempo desde que se restablecieron las estadísticas, veremos valores de miles de millones. Y eso no nos dice nada.
- No hay historial. Si ocurre alguna falla, si algo falló hace 15-30 minutos, no podrás usar las estadísticas para ver lo que pasó en ese tiempo. Ese es un problema.
- La ausencia de una herramienta integrada en PostgreSQL es un problema. Los desarrolladores del núcleo no proporcionan ninguna utilidad. No tienen nada de eso. Simplemente ofrecen estadísticas en la base. Úsala, haz consultas, lo que quieras, hazlo.
- Como no hay una herramienta integrada en PostgreSQL, eso causa otro problema. Muchos herramientas de terceros. Cada empresa con ciertas habilidades intenta escribir su propio programa. Y al final, hay muchas herramientas en la comunidad que se pueden usar para trabajar con estadísticas. En algunas herramientas hay ciertas capacidades, otras carecen de ellas o tienen nuevas funciones. Y surge la situación de que necesitas utilizar dos, tres o cuatro herramientas que se superponen entre sí y tienen diferentes funciones. Es muy incómodo.
¿Qué se deduce de esto? Es importante poder obtener estadísticas directamente, para no depender de programas, o de alguna manera mejorar estos programas: agregar algunas funciones para obtener beneficios.
Y se necesitan conocimientos básicos de SQL. Para obtener datos de las estadísticas, es necesario redactar consultas SQL, es decir, necesitas saber cómo se forman los select, join.
Las estadísticas nos ofrecen varias cosas. Se pueden dividir en categorías.
- La primera categoría son los eventos que ocurren en la base. Es cuando se produce algún evento en la base: una consulta, una llamada a una tabla, un autovacuum, confirmaciones, todos estos son eventos. Los contadores correspondientes a estos eventos se incrementan. Y podemos rastrear estos eventos.
- La segunda categoría son las propiedades de los objetos, como tablas y bases. Tienen propiedades. Es el tamaño de las tablas. Podemos rastrear el crecimiento de las tablas, el crecimiento de los índices. Podemos observar cambios en la dinámica.
- Y la tercera categoría es el tiempo dedicado a un evento. Una consulta es un evento. Tiene una medida específica de duración. Aquí comenzó, aquí terminó. Podemos rastrearlo. Ya sea el tiempo de lectura de un bloque desde el disco o escritura. También se rastrean esas cosas.
Las fuentes de estadísticas se presentan de la siguiente manera:
- En la memoria compartida (shared buffers) hay un segmento para almacenar datos estadísticos, allí están esos contadores que se incrementan constantemente cuando ocurren ciertos eventos o surgen momentos en el funcionamiento de la base.
- Todos estos contadores no son accesibles para el usuario e incluso para el administrador. Son cosas de bajo nivel. Para acceder a ellos, PostgreSQL proporciona una interfaz en forma de funciones SQL. Podemos hacer selecciones usando estas funciones y obtener alguna métrica (o conjunto de métricas).
- Sin embargo, utilizar estas funciones no siempre es conveniente, por lo que las funciones son la base para las vistas (VIEWs). Estas son tablas virtuales que proporcionan estadísticas sobre un subsistema específico o sobre un conjunto de eventos en la base de datos.
- Estas vistas incorporadas (VIEWs) son la interfaz principal para el usuario para trabajar con estadísticas. Están disponibles por defecto sin necesidad de configuración adicional, puedes usarlas de inmediato, ver y extraer información de ellas. También existen contribuciones. Las contribuciones son oficiales. Puedes instalar el paquete postgresql-contrib (por ejemplo, postgresql94-contrib), cargar el módulo necesario en la configuración, especificar parámetros para él, reiniciar PostgreSQL y puedes usarlo. (Nota. Dependiendo de la distribución, en las últimas versiones el paquete contrib es parte del paquete principal.).
- Y existen contribuciones no oficiales. No vienen en la instalación estándar de PostgreSQL. Deben ser compiladas o instaladas como una biblioteca. Las opciones pueden ser muy variadas, dependiendo de lo que haya desarrollado el creador de esta contribución no oficial.
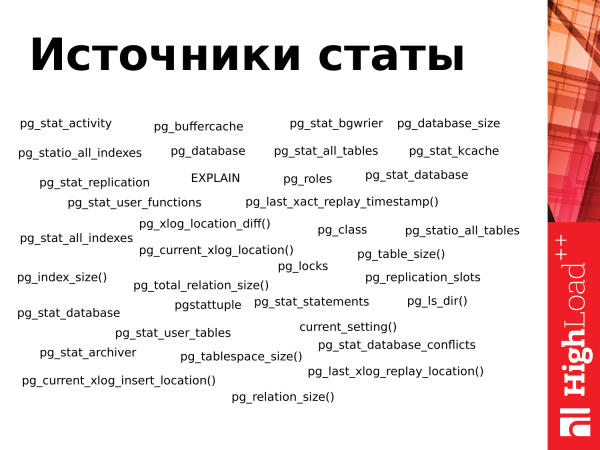
En esta diapositiva se presentan todas las vistas (VIEWs) y algunas de las funciones disponibles en PostgreSQL 9.4. Como podemos ver, hay muchas. Y es bastante fácil confundirse si te encuentras con esto por primera vez.
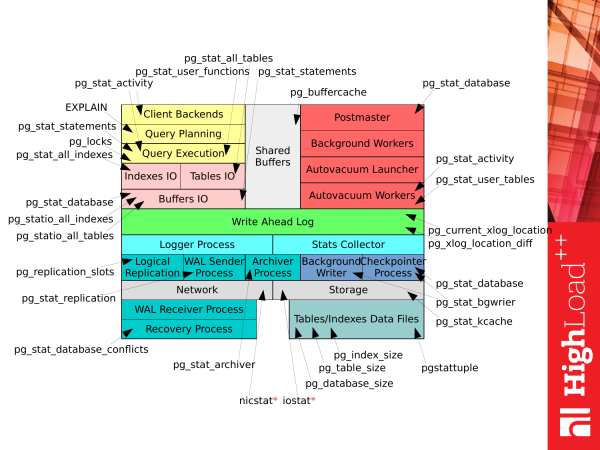
Sin embargo, si tomamos la imagen anterior Cómo se distribuye el tiempo en PostgreSQL y lo comparamos con esta lista, obtendremos esta imagen. Cada vista (VIEWs) o función la podemos utilizar con diferentes propósitos para obtener estadísticas correspondientes, cuando PostgreSQL está en funcionamiento. Y podemos obtener ya alguna información sobre el funcionamiento del subsistema.
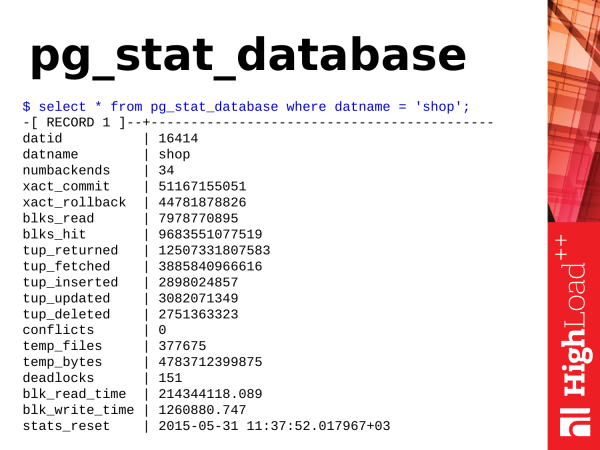
Lo primero que vamos a considerar es pg_stat_database. Como podemos ver, esta vista tiene mucha información. Una información muy variada. Y proporciona un conocimiento muy útil sobre lo que está ocurriendo en la base de datos.
¿Qué podemos obtener útil de ahí? Comencemos con las cosas más simples.
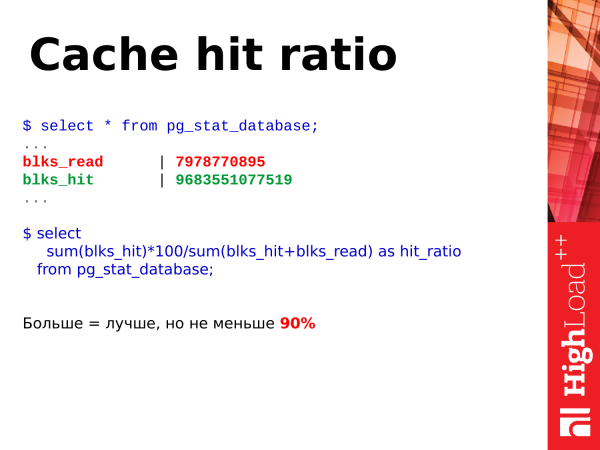
select
sum(blks_hit)*100/sum(blks_hit+blks_read) as hit_ratio
from pg_stat_database;
Lo primero que podemos revisar es el porcentaje de aciertos en la caché. El porcentaje de aciertos en la caché es una métrica útil. Permite evaluar qué volumen de datos se trae de las cachés de buffers compartidos y qué volumen se lee desde el disco.
Es evidente que cuanto mayor sea nuestro acierto en la caché, mejor será. Evaluamos esta métrica como un porcentaje. Y, por ejemplo, si nuestro porcentaje de estos aciertos en la caché supera el 90 %, esto es bueno. Si cae por debajo del 90 %, significa que no tenemos suficiente memoria para mantener en memoria la 'cabeza' caliente de datos. Y para utilizar esos datos, PostgreSQL se ve obligado a acceder al disco, lo cual es más lento que si los datos se leyeran de la memoria. Y ya hay que pensar en aumentar la memoria: ya sea aumentando los buffers compartidos o incrementando la memoria del hardware (RAM).
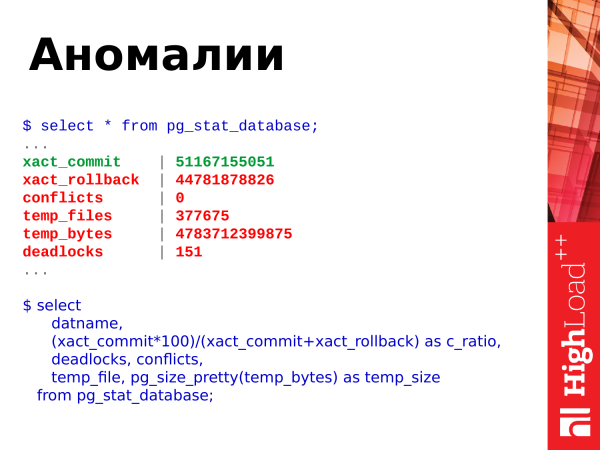
select
datname,
(xact_commit*100)/(xact_commit+xact_rollback) as c_ratio,
deadlocks, conflicts,
temp_file, pg_size_pretty(temp_bytes) as temp_size
from pg_stat_database;
¿Qué más se puede obtener de esta vista? Se pueden observar anomalías que ocurren en la base de datos. ¿Qué se muestra aquí? Aquí hay commits, rollbacks, creación de archivos temporales, su volumen, deadlocks y conflictos.
Podemos usar esta consulta. Este SQL es bastante simple. Y podemos ver estos datos en nuestro lado.
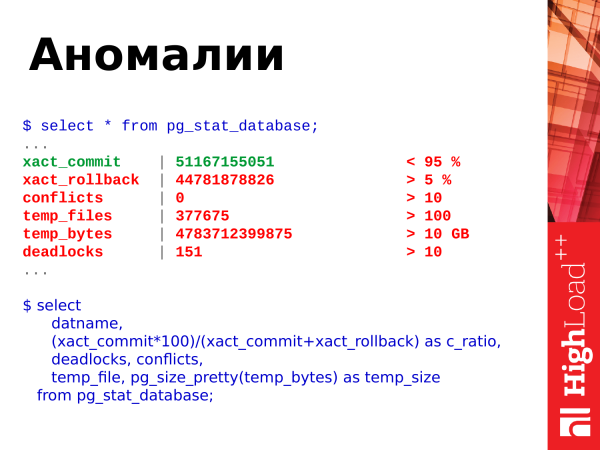
Y aquí están los valores umbral. Observamos la relación entre commits y rollbacks. Commits son la confirmación exitosa de una transacción. Rollbacks son un retroceso, es decir, la transacción realizó algún trabajo, ocupó la base de datos, calculó algo, y luego ocurrió un fallo, y los resultados de la transacción se descartan. Es decir, el aumento constante en la cantidad de rollbacks es malo. Debemos evitar esto y ajustar el código para que no suceda.
Los conflictos están relacionados con la replicación. También deben ser evitados. Si tiene consultas que se ejecutan en la réplica y surgen conflictos, es necesario analizar esos conflictos y ver qué sucede. Los detalles se pueden encontrar en los registros. Y resolver las situaciones conflictivas para que las consultas de la aplicación funcionen sin errores.
Los deadlocks también son una mala situación. Cuando las consultas pelean por recursos, una consulta accede a un recurso y lo bloquea, la segunda consulta accede a un segundo recurso y también lo bloquea, y luego ambas consultas intentan acceder a los recursos de la otra y se bloquean esperando a que el vecino libere el bloqueo. Esto también es problemático. Es necesario resolverlo a través de la reescritura de las aplicaciones y la serialización del acceso a los recursos. Y si ve que sus deadlocks están aumentando constantemente, debe revisar los detalles en los registros, analizar las situaciones que surgen y ver cuál es el problema.
Los archivos temporales también son un problema. Cuando a la consulta del usuario le falta memoria para almacenar los datos temporales, crea un archivo en el disco. Y todas las operaciones que podría realizar en el buffer temporal en memoria, ahora las comienza a realizar en el disco. Esto es lento. Esto aumenta el tiempo de ejecución de la consulta. Y el cliente que envió la consulta a PostgreSQL recibirá una respuesta un poco más tarde. Si todas estas operaciones se realizan en memoria, PostgreSQL responderá mucho más rápido y el cliente esperará menos.
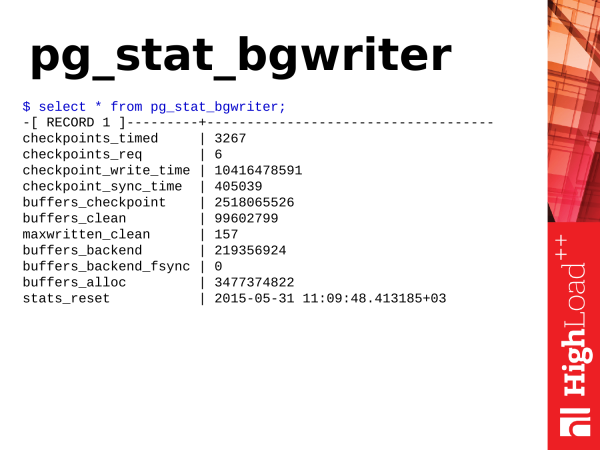
Pg_stat_bgwriter es una vista que describe el funcionamiento de dos subsistemas en segundo plano de PostgreSQL: son checkpointer y background writer.
Primero, analicemos los puntos de control, es decir, checkpoints. ¿Qué son los puntos de control? Un punto de control es una posición en el registro de transacciones que indica que todos los cambios de datos registrados en el log se han sincronizado correctamente con los datos en el disco. El proceso puede ser prolongado dependiendo de la carga de trabajo y la configuración, y consiste principalmente en la sincronización de páginas sucias en los buffers compartidos con los archivos de datos en el disco. ¿Para qué sirve esto? Si PostgreSQL accediera al disco cada vez para obtener datos y grabar datos en cada acceso, sería lento. Por eso, PostgreSQL tiene un segmento de memoria, cuyo tamaño depende de los parámetros de configuración. Postgres coloca en esta memoria datos en tiempo real para su posterior procesamiento o entrega en respuesta a consultas. En caso de solicitudes de modificación de datos, estos se modifican. Así, obtenemos dos versiones de los datos. Una está en la memoria y la otra en el disco. Y periódicamente, es necesario sincronizar estos datos. Necesitamos sincronizar lo que ha cambiado en la memoria con el disco. Para esto, se necesitan los checkpoints.
El checkpoint recorre los buffers compartidos, marcando las páginas sucias como necesarias para el checkpoint. Luego, realiza un segundo recorrido por los buffers compartidos. Y las páginas que están marcadas para el checkpoint, se sincronizan. Así es como se realiza la sincronización de datos con el disco.
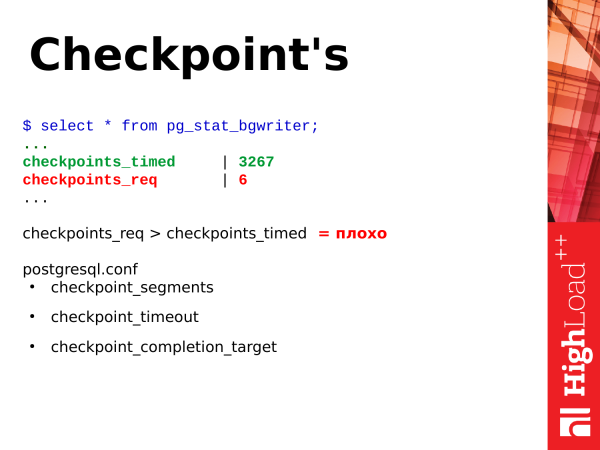
Hay dos tipos de checkpoints. Un checkpoint se ejecuta por tiempo de espera. Este checkpoint es útil y bueno – checkpoint_timed. Y hay checkpoints bajo demanda – checkpoint required. Este tipo de checkpoint ocurre cuando hay una gran cantidad de registros de datos. Hemos grabado muchos logs de transacciones. Y PostgreSQL considera que necesita sincronizar todo lo más rápido posible, crear un checkpoint y continuar.
Y si has mirado las estadísticas pg_stat_bgwriter y has visto que tienes checkpoint_req mucho más alto que checkpoint_timed, entonces eso es malo. ¿Por qué es malo? Significa que PostgreSQL está en una situación de estrés constante, donde necesita escribir datos en el disco. El checkpoint por tiempo de espera es menos estresante y se ejecuta de acuerdo con un horario interno, y se distribuye a lo largo del tiempo. PostgreSQL tiene la capacidad de hacer pausas en el funcionamiento y no sobrecargar el subsistema de disco. Esto es beneficioso para PostgreSQL. Y las consultas que se realizan durante un checkpoint no experimentarán estrés por el hecho de que el subsistema de disco está ocupado.
Y para la regulación del checkpoint hay tres parámetros:
checkpoint_segments.checkpoint_timeout.checkpoint_completion_target.
Estos permiten regular el funcionamiento de los puntos de control. Pero no me detendré en ellos. Su influencia es un tema aparte.
Atención: La versión 9.4, considerada en el informe, ya no es relevante. En las versiones modernas de PostgreSQL, el parámetro checkpoint_segments ha sido reemplazado por los parámetros min_wal_size y max_wal_size.
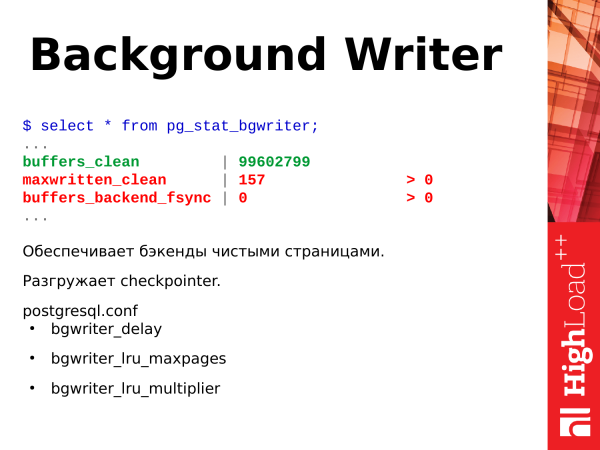
El siguiente subsistema es el escritor en segundo plano — background writer. ¿Qué hace? Trabaja constantemente en un bucle infinito. Escanea las páginas en los buffers compartidos y las páginas sucias que encuentra, las vuelca en el disco. De esta manera, ayuda al checkpointer a realizar menos trabajo durante la ejecución de los puntos de control.
¿Para qué más es necesario? Asegura la necesidad de páginas limpias en los buffers compartidos si por alguna razón se requieren (en gran cantidad y de inmediato) para almacenar datos. Supongamos que surge una situación en la que se requieren páginas limpias para ejecutar una consulta y ya están en los buffers compartidos. PostgreSQL backend simplemente las toma y las utiliza, no necesita limpiar nada por sí mismo. Pero si de repente no hay tales páginas, el backend detiene su trabajo y comienza a buscar páginas para volcar en el disco y tomar para sus necesidades, lo que afecta negativamente al tiempo de la consulta que se está ejecutando en ese momento. Si ves que tu parámetro maxwritten_clean es alto, significa que el background writer no está cumpliendo con su trabajo y es necesario aumentar los parámetros bgwriter_lru_maxpages, para que pueda hacer más trabajo en un solo ciclo y limpiar más páginas.
Y otro indicador muy útil es buffers_backend_fsync. Los backends no realizan fsync, porque es lento. Trasladan fsync al checkpointer en la pila de IO. El checkpointer tiene su propia cola, procesa fsync periódicamente y sincroniza las páginas en memoria con los archivos en disco. Si la cola está grande y llena para el checkpointer, el backend se ve obligado a realizar fsync por sí mismo, lo que ralentiza su operación, es decir, el cliente recibirá una respuesta más tarde de lo que podría. Si ves que este valor es mayor que cero, ya es un problema ydebes prestar atención a la configuración del background writer y también evaluar el rendimiento del subsistema de disco. es necesario prestar atención a la configuración del escritor de fondo y también evaluar el rendimiento del subsistema de disco.
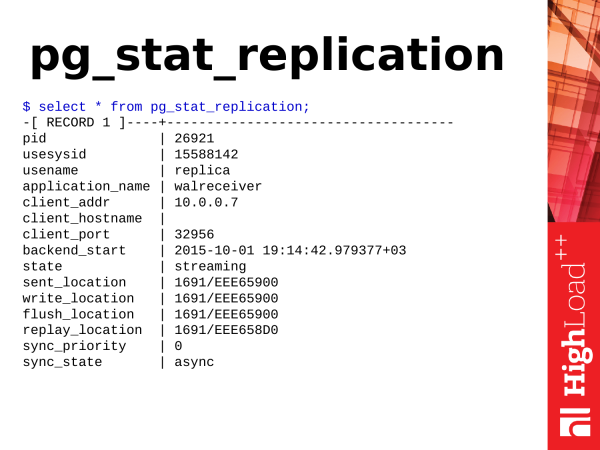
Atención: _El siguiente texto describe las representaciones estadísticas relacionadas con la replicación. La mayoría de los nombres de las vistas y funciones fueron renombrados en Postgres 10. La esencia de los renombres se reduce a reemplazar xlog en wal y ubicación en lsn en los nombres de funciones/vistas, etc. Un ejemplo específico es la función pg_xlog_location_diff() que fue renombrada a pg_wal_lsn_diff()._
Aquí también tenemos mucho contenido. Pero solo necesitaremos los puntos relacionados con la ubicación.
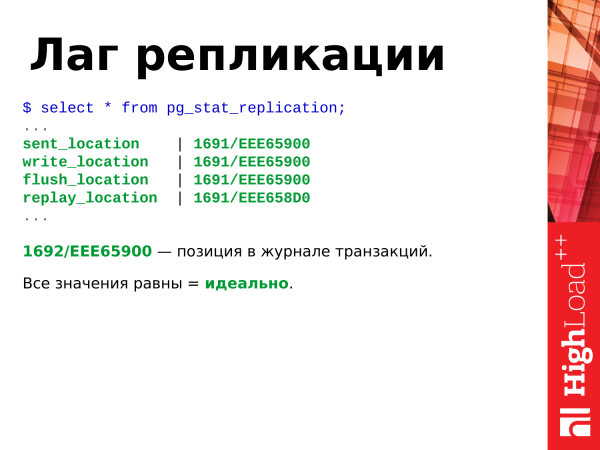
Si vemos que todos los valores son iguales, esa es la opción ideal y la réplica no se está quedando atrás del maestro.
Esta posición hexadecimal es la posición en el registro de transacciones. Aumenta constantemente si hay alguna actividad en la base: inserciones, eliminaciones, etc.
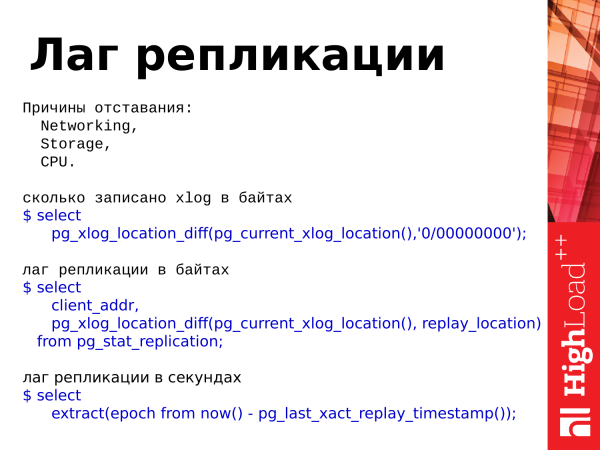
cuánto xlog se ha registrado en bytes
$ select
pg_xlog_location_diff(pg_current_xlog_location(),'0/00000000');
retraso de replicación en bytes
$ select
client_addr,
pg_xlog_location_diff(pg_current_xlog_location(), replay_location)
from pg_stat_replication;
retraso de replicación en segundos
$ select
extract(epoch from now() - pg_last_xact_replay_timestamp());
Si estas cosas difieren, significa que hay algún tipo de retraso. El retraso es la desincronización de la réplica con el maestro, es decir, los datos son diferentes entre los servidores.
Hay tres razones para el retraso:
- Es que el subsistema de disco no está manejando la escritura de sincronización de archivos.
- Posibles errores de red, o sobrecarga de la red, donde los datos no llegan a la réplica a tiempo y esta no puede reproducirlos.
- Y el procesador. El procesador es un caso muy raro. Yo he visto esto dos o tres veces, pero también puede suceder.
Y aquí hay tres consultas que nos permiten utilizar la estadística. Podemos evaluar cuánto se ha registrado en nuestro registro de transacciones. Hay una función pg_xlog_location_diff y podemos evaluar el retraso de replicación en bytes y segundos. También usamos el valor de esta vista (VIEWs) para esto.
Nota: _En lugar de pg_xlog_locationdiff(), se puede usar el operador de resta y restar una ubicación de otra. Es conveniente.
Hay una cosa sobre el retraso que está en segundos. Si no hay ninguna actividad en el maestro, y la transacción ocurrió hace aproximadamente 15 minutos sin actividad alguna, y si miramos este retraso en la réplica, veremos un retraso de 15 minutos. Hay que tenerlo en cuenta. Esto puede causar confusión al observar este retraso.
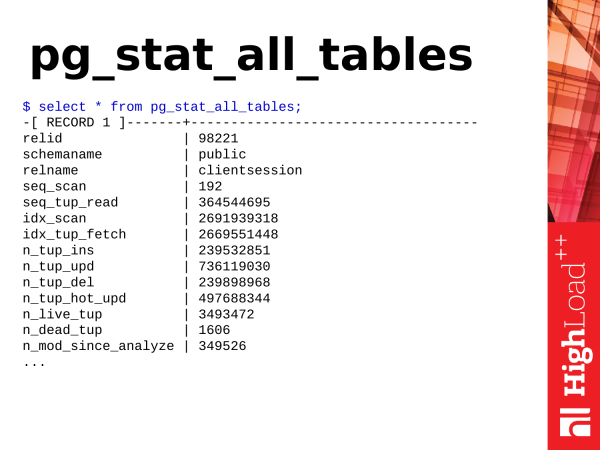
Pg_stat_all_tables – otra vista útil. Muestra estadísticas sobre las tablas. Cuando tenemos tablas en nuestra base de datos con alguna actividad, algunas acciones, podemos obtener esta información de esta vista.
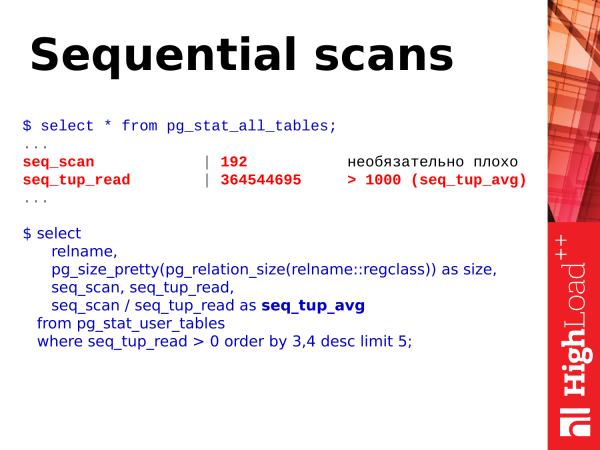
select
relname,
pg_size_pretty(pg_relation_size(relname::regclass)) as size,
seq_scan, seq_tup_read,
seq_scan / seq_tup_read as seq_tup_avg
from pg_stat_user_tables
where seq_tup_read > 0 order by 3,4 desc limit 5;
Lo primero que podemos ver son los escaneos secuenciales de la tabla. El número en sí después de estos pasos no necesariamente indica que tengamos que actuar de inmediato.
Sin embargo, hay una segunda métrica: seq_tup_read. Esto es la cantidad de filas devueltas como resultado de un escaneo secuencial. Si el número promedio supera 1,000, 10,000, 50,000, 100,000, eso ya es un indicativo de que puede que necesite construir un índice para acceder a través del índice, o posiblemente optimizar las consultas que utilizan tales escaneos secuenciales.
Un ejemplo simple: supongamos que una consulta con un gran OFFSET y LIMIT está presente. Por ejemplo, se escanean 100,000 filas en la tabla y luego se seleccionan 50,000 filas necesarias, mientras que las filas escaneadas anteriormente se descartan. Este también es un caso problemático. Y tales consultas deben ser optimizadas. Aquí hay una consulta SQL sencilla donde se puede observar y evaluar los números obtenidos.
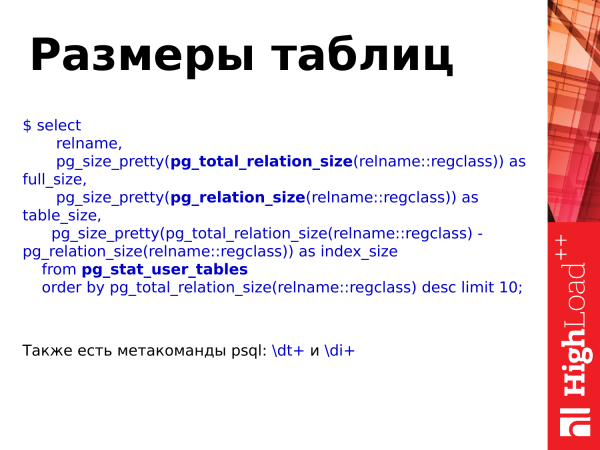
select
relname,
pg_size_pretty(pg_total_relation_size(relname::regclass)) as
full_size,
pg_size_pretty(pg_relation_size(relname::regclass)) as
table_size,
pg_size_pretty(pg_total_relation_size(relname::regclass) -
pg_relation_size(relname::regclass)) as index_size
from pg_stat_user_tables
order by pg_total_relation_size(relname::regclass) desc limit 10;
Los tamaños de las tablas también se pueden obtener con esta tabla y mediante funciones adicionales. pg_total_relation_size(), pg_relation_size().
En general, hay metacomandos dt y di, que se pueden utilizar en PSQL y también ver los tamaños de las tablas e índices.
Sin embargo, el uso de funciones nos ayuda a ver los tamaños de las tablas también considerando los índices, o sin tener en cuenta los índices, y a partir de ahí hacer algunas evaluaciones sobre el crecimiento de la base de datos, es decir, cómo está creciendo, con qué intensidad y ya hacer algunas conclusiones sobre la optimización de tamaños.
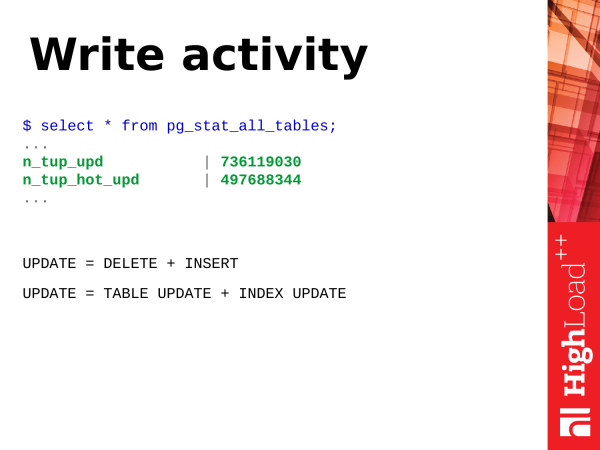
Actividad de escritura. ¿Qué es una escritura? Vamos a considerar la operación. ACTUALIZAR – operación de actualización de filas en la tabla. En esencia, update consiste en dos operaciones (o incluso más). Es una inserción de una nueva versión de la fila y la marcación de la versión antigua de la fila como obsoleta. Posteriormente, vendrá el autovacuum que limpiará estas versiones obsoletas de las filas y marcará ese espacio como disponible para reutilización.
Además, update no solo es una actualización de la tabla. También implica la actualización de índices. Si tiene muchos índices en la tabla, al realizar un update, todos los índices que contienen los campos actualizados en la consulta también deberán actualizarse. En estos índices también habrá versiones obsoletas de las filas que deberán ser limpiadas.
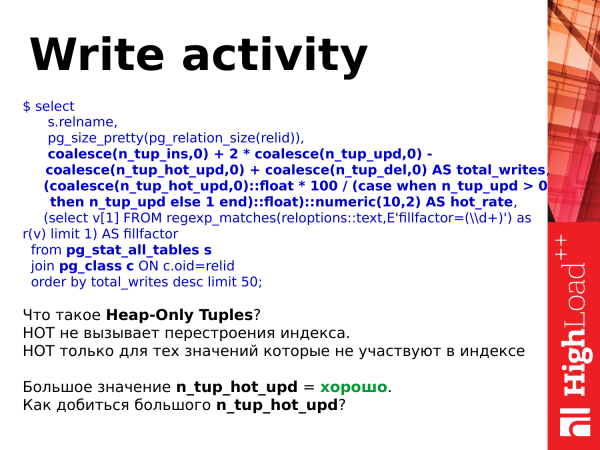
select
s.relname,
pg_size_pretty(pg_relation_size(relid)),
coalesce(n_tup_ins,0) + 2 * coalesce(n_tup_upd,0) -
coalesce(n_tup_hot_upd,0) + coalesce(n_tup_del,0) AS total_writes,
(coalesce(n_tup_hot_upd,0)::float * 100 / (case when n_tup_upd > 0
then n_tup_upd else 1 end)::float)::numeric(10,2) AS hot_rate,
(select v[1] FROM regexp_matches(reloptions::text,E'fillfactor=(\d+)') as
r(v) limit 1) AS fillfactor
from pg_stat_all_tables s
join pg_class c ON c.oid=relid
order by total_writes desc limit 50;
Y debido a su diseño, UPDATE son operaciones pesadas. Pero se pueden aligerar. Hay actualizaciones livianas. Aparecieron en PostgreSQL versión 8.3. ¿Y qué son? Son un update ligero que no causa la reconstrucción de índices. Es decir, hemos actualizado un registro, pero en este caso solo se actualiza el registro en la página (que pertenece a la tabla), mientras que los índices siguen apuntando al mismo registro en la página. Hay una lógica de funcionamiento interesante, cuando llega el vacuum, él reconstruye estas cadenas hot y todo sigue funcionando sin volver a construir los índices, y todo ocurre con un menor gasto de recursos.
Y cuando tienes n_tup_hot_upd grande, eso es muy bueno. Significa que las actualizaciones livianas predominan y que esto nos resulta más económico en términos de recursos y todo va de maravilla.
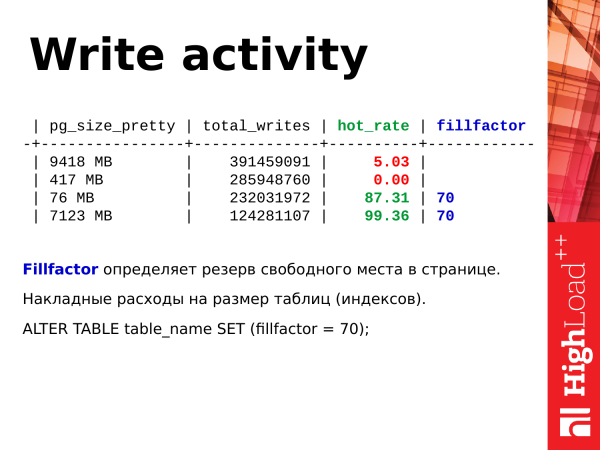
ALTER TABLE table_name SET (fillfactor = 70);¿Cómo aumentar el volumen de actualizaciones livianas?Podemos utilizar fillfactor. Este parámetro determina el tamaño del espacio libre reservado al llenar una página en la tabla con INSERTs. Cuando se realizan inserts en la tabla, llenan completamente la página, sin dejar espacio vacío. Luego se asigna una nueva página. Nuevamente, se llenan los datos. Este comportamiento es por defecto, fillfactor = 100 %.
Podemos establecer el fillfactor en un 70%. Es decir, al realizar inserciones, se reserva una nueva página, pero solo se llena el 70% de la página. El 30% queda disponible como reserva. Cuando se necesite realizar una actualización, es muy probable que ocurra en la misma página, y la nueva versión de la fila se colocará en esa misma página. Se realizará una actualización en caliente. De este modo, se facilita la escritura en las tablas.
select c.relname,
current_setting('autovacuum_vacuum_threshold') as av_base_thresh,
current_setting('autovacuum_vacuum_scale_factor') as av_scale_factor,
(current_setting('autovacuum_vacuum_threshold')::int +
(current_setting('autovacuum_vacuum_scale_factor')::float * c.reltuples))
as av_thresh,
s.n_dead_tup
from pg_stat_user_tables s join pg_class c ON s.relname = c.relname
where s.n_dead_tup > (current_setting('autovacuum_vacuum_threshold')::int
+ (current_setting('autovacuum_vacuum_scale_factor')::float * c.reltuples));
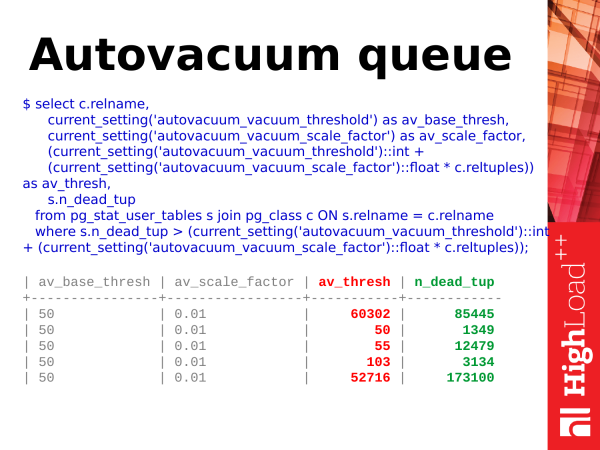
Cola de autovacuum. El autovacuum es un subsistema sobre el cual hay muy poca estadística en PostgreSQL. Solo podemos ver en las tablas de pg_stat_activity cuántos vacuums están ocurriendo en este momento. Sin embargo, es muy difícil saber cuántas tablas tiene en cola.
Nota: _Desde la versión Postgres 10, la situación de seguimiento del autovacuum ha mejorado considerablemente — apareció la vista pg_stat_progressvacuum, que simplifica enormemente el monitoreo del autovacuum.
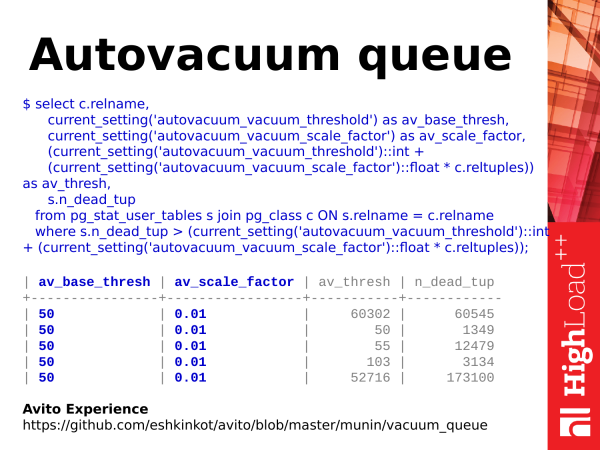
Podemos utilizar esta consulta simplificada. Y podemos ver cuándo debe ejecutarse el vacuum. Pero, ¿cuándo y cómo debe comenzar el vacuum? Estas son las versiones obsoletas de las filas de las que hablaba antes. Se realizó una actualización, se insertó una nueva versión de la fila. Ahora hay una versión obsoleta de la fila. En la tabla pg_stat_user_tables hay un parámetro llamado n_dead_tup. Este parámetro muestra la cantidad de filas "muertas". Tan pronto como la cantidad de filas muertas supere un umbral determinado, el autovacuum se activará en la tabla.
¿Y cómo se calcula este umbral? Es una relación porcentual específica del número total de filas en la tabla. Hay un parámetro llamado autovacuum_vacuum_scale_factor, que define esta relación porcentual. Supongamos que es del 10% más un umbral base adicional de 50 filas. ¿Y qué sucede? Cuando tenemos más de "10 % + 50" filas muertas de todas las filas en la tabla, activamos el autovacuum en la tabla.
select c.relname,
current_setting('autovacuum_vacuum_threshold') as av_base_thresh,
current_setting('autovacuum_vacuum_scale_factor') as av_scale_factor,
(current_setting('autovacuum_vacuum_threshold')::int +
(current_setting('autovacuum_vacuum_scale_factor')::float * c.reltuples))
as av_thresh,
s.n_dead_tup
from pg_stat_user_tables s join pg_class c ON s.relname = c.relname
where s.n_dead_tup > (current_setting('autovacuum_vacuum_threshold')::int
+ (current_setting('autovacuum_vacuum_scale_factor')::float * c.reltuples));
Sin embargo, hay un detalle. Los umbrales base de los parámetros av_base_thresh y y av_scale_factor pueden ser asignados individualmente. Por lo tanto, el umbral no será global, sino individual para la tabla. Así que, para calcularlo, es necesario utilizar trucos y artimañas. Y si te interesa, puedes observar la experiencia de nuestros colegas de Avito (el enlace en la diapositiva no es válido y se ha actualizado en el texto).
Ellos escribieron para , que tiene en cuenta estas cosas. Hay un documento de dos páginas. Pero calcula correctamente y permite evaluar de manera bastante eficiente, dónde requerimos más vacío para las tablas, y dónde menos.
¿Qué podemos hacer al respecto? Si tenemos una cola grande y el autovacío no funciona, podemos aumentar la cantidad de trabajadores del vacío, o simplemente hacer el vacío más agresivo, para que se dispare antes y procese la tabla en pequeños trozos. Y de esta manera la cola se reducirá. — Lo principal aquí es vigilar la carga en los discos, ya que el vacío no es gratis, aunque con la llegada de dispositivos SSD/NVMe el problema se ha vuelto menos notable.
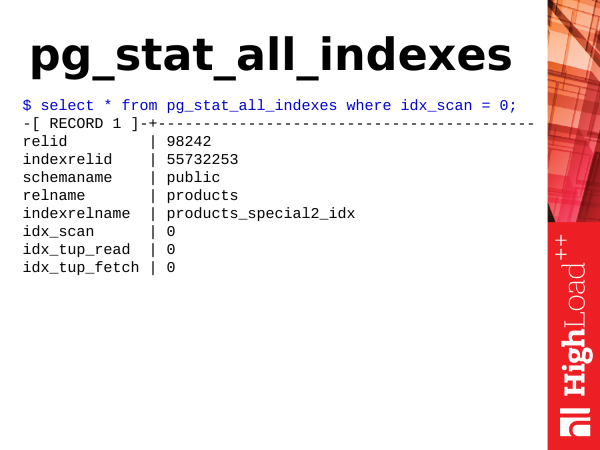
Pg_stat_all_indexes es la estadística de índices. Es pequeña. Y podemos obtener información sobre el uso de índices a partir de ella. Por ejemplo, podemos determinar cuáles índices son innecesarios.
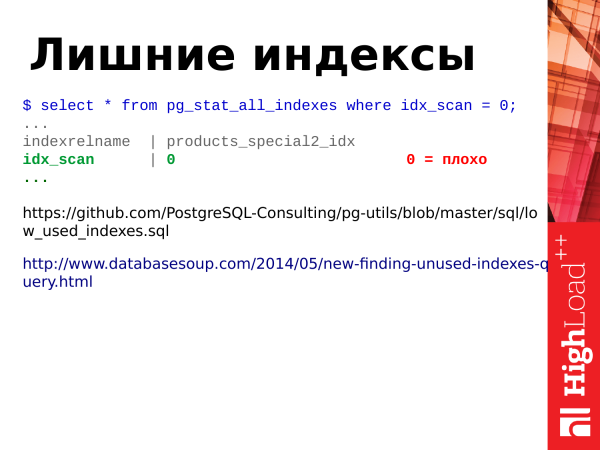
Como ya mencioné, el update no solo implica actualizar tablas, también implica actualizar índices. Por lo tanto, si tenemos muchos índices en una tabla, al actualizar filas en la tabla, también es necesario actualizar los índices de los campos indexados, y si tenemos índices no utilizados, que no tienen escaneos de índices, son un lastre innecesario. Y debemos deshacernos de ellos. Para esto necesitamos el campo idx_scan. Solo miramos la cantidad de escaneos de índices. Si los índices tienen cero escaneos durante un período relativamente largo de almacenamiento de estadísticas (no menos de 2-3 semanas), lo más probable es que sean índices defectuosos, y debemos deshacernos de ellos.
Nota: Al buscar índices no utilizados en caso de clústeres de replicación en flujo, es necesario comprobar todos los nodos del clúster, ya que las estadísticas no son globales, y si un índice no se usa en el maestro, puede estar en uso en las réplicas (si hay carga allí).
Dos enlaces:
Estos son ejemplos más avanzados de consultas sobre cómo buscar índices no utilizados.
El segundo enlace es una consulta bastante interesante. Tiene una lógica no trivial detrás. Lo recomiendo para su revisión.
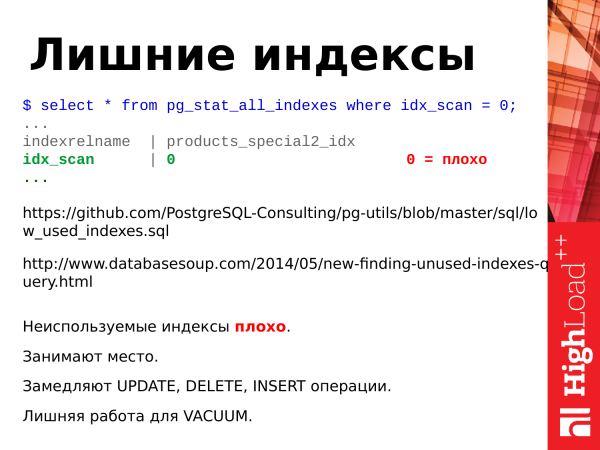
¿Qué más se debe resumir sobre los índices?
Los índices no utilizados son perjudiciales.
Ocupana espacio.
Retrasan las operaciones de actualización.
Trabajo extra para el vacío.
Si eliminamos los índices no utilizados, mejoraremos la base de datos.
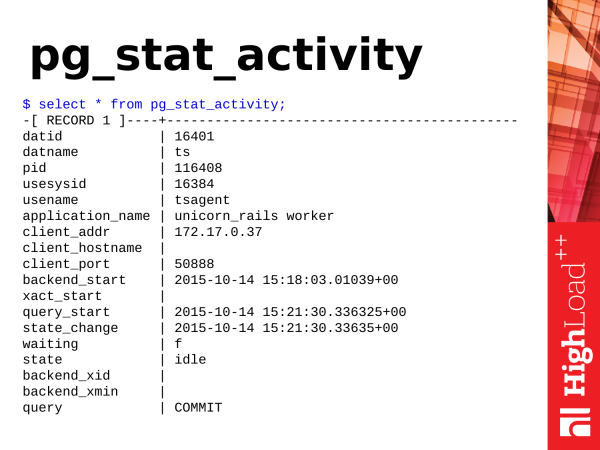
La siguiente vista es pg_stat_activity. Es análoga a la herramienta ps, solo que en PostgreSQL. Si psestás viendo procesos en el sistema operativo, entonces pg_stat_activity te mostrará la actividad dentro de PostgreSQL.
¿Qué información útil podemos obtener de ahí?
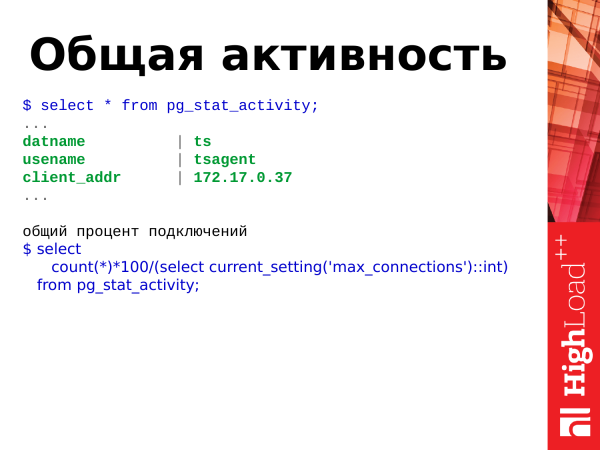
select
count(*)*100/(select current_setting('max_connections')::int)
from pg_stat_activity;
Podemos ver la actividad general, qué está sucediendo en la base. Podemos hacer un nuevo despliegue. Allí todo se ha colapsado, no se aceptan nuevas conexiones, se generan errores en la aplicación.
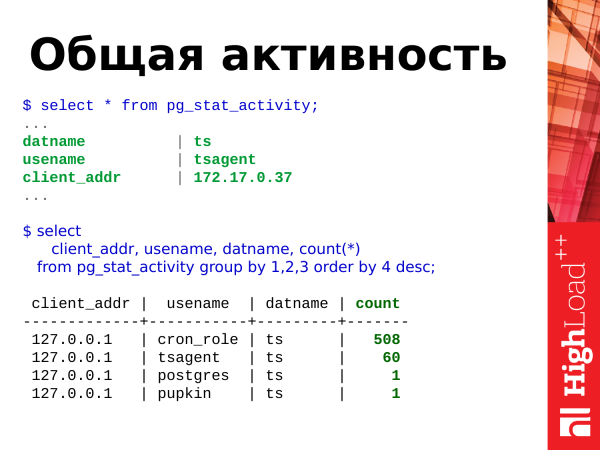
select
client_addr, usename, datname, count(*)
from pg_stat_activity group by 1,2,3 order by 4 desc;
Podemos ejecutar esta consulta y ver el porcentaje total de conexiones en relación con el límite máximo de conexiones y observar quién está utilizando más conexiones. Y en el caso presentado, vemos que el usuario cron_role abrió 508 conexiones. Y sucede que algo le ha ocurrido. Necesitamos investigarlo. Es muy posible que se trate de un número anómalo de conexiones.
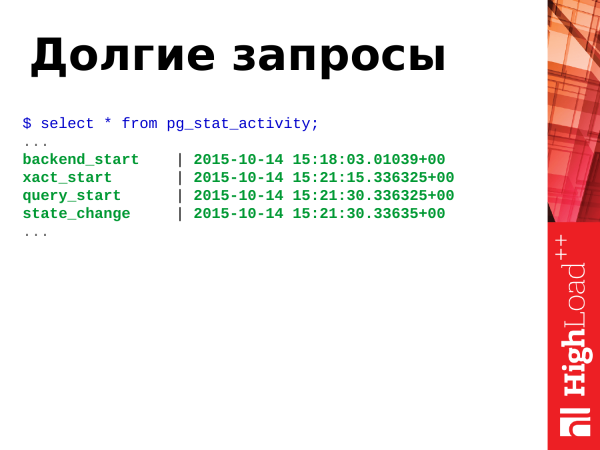
Si tenemos una carga OLTP, las consultas deben ejecutarse rápidamente, muy rápido y no debe haber consultas prolongadas. Sin embargo, si surgen consultas prolongadas, a corto plazo no hay nada terrible, pero a largo plazo, las consultas prolongadas perjudican a la base, aumentan el efecto de bloat en las tablas, cuando hay fragmentación en las tablas. Hay que deshacerse tanto del bloat como de las consultas prolongadas.
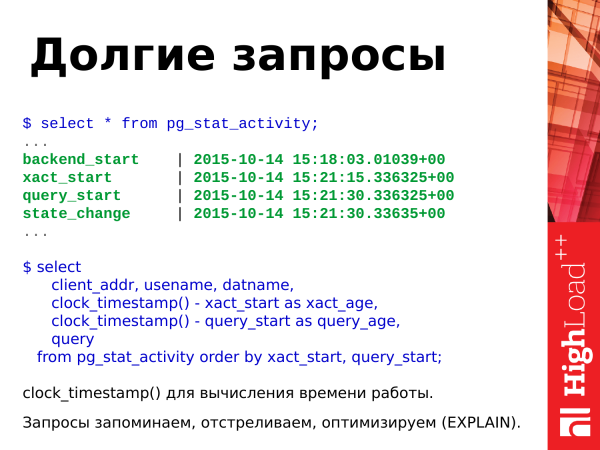
select
client_addr, usename, datname,
clock_timestamp() - xact_start as xact_age,
clock_timestamp() - query_start as query_age,
query
from pg_stat_activity order by xact_start, query_start;
Atención: con esta consulta podemos identificar consultas y transacciones prolongadas. Usamos la función clock_timestamp() para determinar el tiempo de ejecución. Podemos recordar las consultas prolongadas que encontramos, ejecutar explain, ver los planes y optimizar de alguna manera. Las consultas largas actuales las cortamos y seguimos adelante.
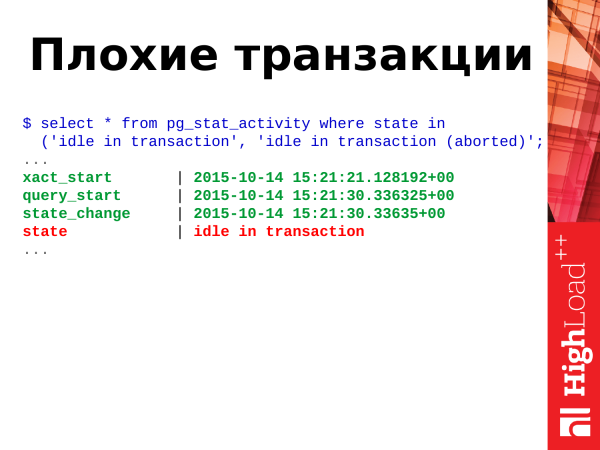
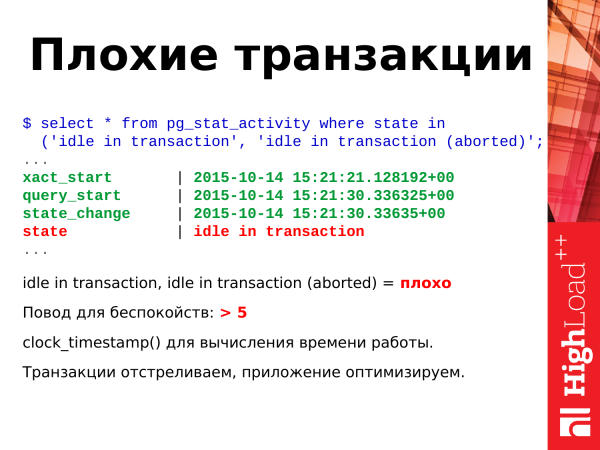
select * from pg_stat_activity where state in
('idle in transaction', 'idle in transaction (aborted)';
Las transacciones problemáticas son las que están en estado idle in transaction y idle in transaction (aborted).
¿Qué significa esto? Las transacciones tienen varios estados. Y uno de estos estados puede adoptar en cualquier momento. Para determinar los estados, hay un campo state en esta representación. Y lo usamos para definir el estado.
select * from pg_stat_activity where state in
('idle in transaction', 'idle in transaction (aborted)';
Y, como mencioné anteriormente, estos dos estados idle in transaction e idle in transaction (aborted) son problemáticos. ¿Qué son? Es cuando la aplicación ha abierto una transacción, ha realizado algunas acciones y se ha ido a hacer otras cosas. La transacción permanece abierta. Está en espera, no sucede nada en ella, ocupa la conexión, bloquea las filas modificadas y potencialmente también aumenta el bloat de otras tablas, debido a la arquitectura del motor transaccional de PostgreSQL. Y esas transacciones también deben ser eliminadas, porque son perjudiciales en cualquier circunstancia.
Si ves que tienes más de 5-10-20 de ellas en tu base de datos, ya deberías preocuparte y comenzar a hacer algo al respecto.
Aquí también usamos el tiempo de cálculo clock_timestamp(). Eliminamos transacciones, optimizamos la aplicación.
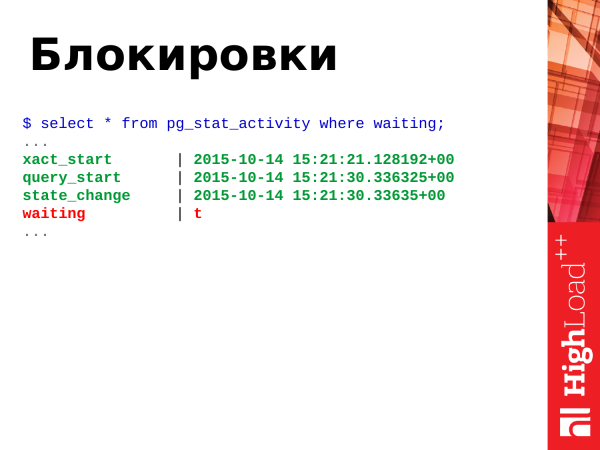
Como mencioné antes, los bloqueos son cuando dos o más transacciones compiten por un recurso o grupo de recursos. Para eso tenemos el campo waiting con un valor booleano true o false.
True, significa que el proceso está en espera, se necesita hacer algo. Cuando el proceso está en espera, significa que el cliente que inició este proceso también está esperando. El cliente en el navegador está sentado y también espera.
Atención: _Desde la versión 9.6 de Postgres, el campo waiting ha sido eliminado y en su lugar se añadieron dos campos más informativos wait_event_type y wait_event._
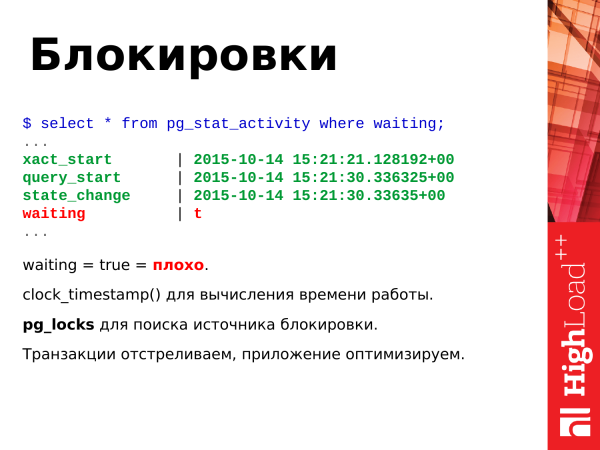
¿Qué hacer? Si ves true durante mucho tiempo, significa que hay que deshacerse de tales consultas. Simplemente eliminamos esas transacciones. Informamos a los desarrolladores que necesitan optimizar de alguna manera para evitar la competencia por los recursos. Y luego los desarrolladores optimizan la aplicación para que no surjan tales situaciones.
Y el caso extremo, pero potencialmente no fatal, es el surgimiento de deadlocks. Dos transacciones actualizan dos recursos, luego intentan acceder a ellos nuevamente, y ya a los recursos opuestos. PostgreSQL en este caso selecciona y elimina una transacción para que la otra pueda continuar trabajando. Esta es una situación de punto muerto y no se arregla sola. Por eso PostgreSQL se ve obligado a tomar medidas extremas.
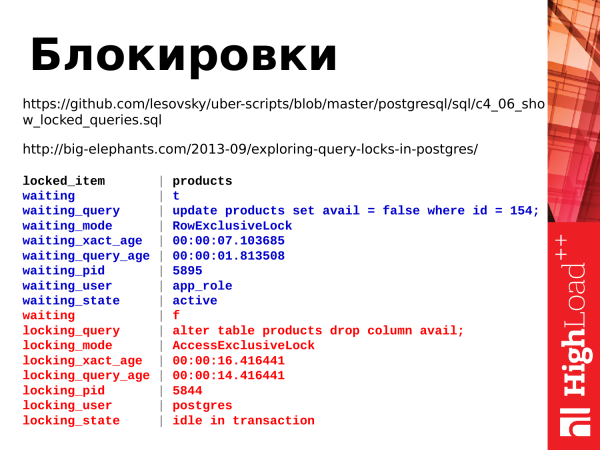
Y aquí hay dos consultas que permiten rastrear bloqueos. Usamos la vista pg_locks, que permite rastrear bloqueos pesados.
Y el primer enlace es el texto de la consulta. Es bastante largo.
Y el segundo enlace es un artículo sobre locks. Es útil leerlo, es muy interesante.
Entonces, ¿qué vemos? Vemos dos consultas. Una transacción con ALTER TABLE – es una transacción bloqueadora. Se inició, pero no se completó, y la aplicación que ejecutó esta transacción está ocupada con otras cosas. Y la segunda consulta es un update. Está esperando a que termine el alter table para continuar su trabajo.
Así es como podemos averiguar quién bloqueó a quién, y podemos profundizar en esto.
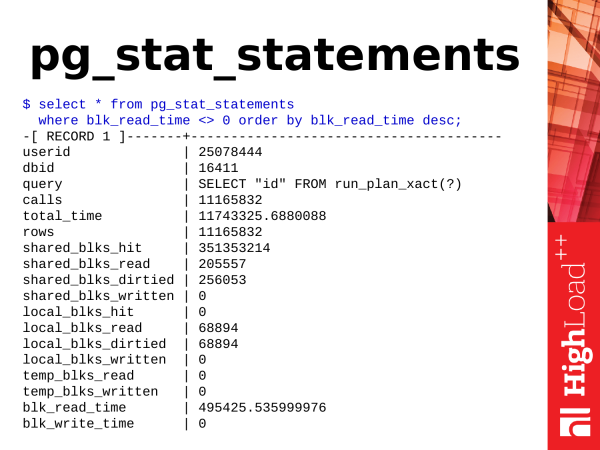
El siguiente módulo es pg_stat_statements. Como ya mencioné, es un módulo. Para utilizarlo, necesitas cargar su biblioteca en la configuración, reiniciar PostgreSQL, instalar el módulo (con un solo comando) y luego tendremos una nueva vista.
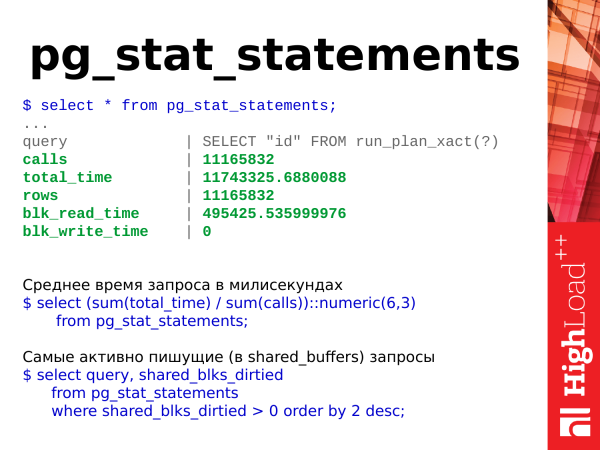
Tiempo promedio de consulta en milisegundos
$ select (sum(total_time) / sum(calls))::numeric(6,3)
from pg_stat_statements;

Las consultas más activas que escriben (en shared_buffers)
$ select query, shared_blks_dirtied
from pg_stat_statements
where shared_blks_dirtied > 0 order by 2 desc;
¿Qué podemos obtener de allí? Si hablamos de cosas simples, podemos obtener el tiempo promedio de ejecución de la consulta. Si el tiempo aumenta, significa que PostgreSQL responde lentamente y necesitamos tomar medidas.
Podemos ver las transacciones de escritura más activas en la base de datos que están cambiando datos en shared buffers. Ver quién está actualizando o eliminando datos.
Y simplemente podemos ver diversas estadísticas sobre estas consultas.
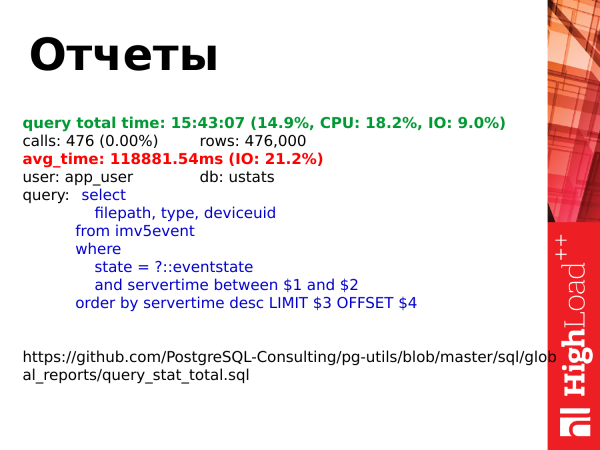
Nosotros pg_stat_statements que utilizamos para generar informes. Reiniciamos las estadísticas una vez al día. Las acumulamos. Antes de reiniciar las estadísticas la próxima vez, generamos un informe. Aquí está el enlace al informe. Puedes verlo.
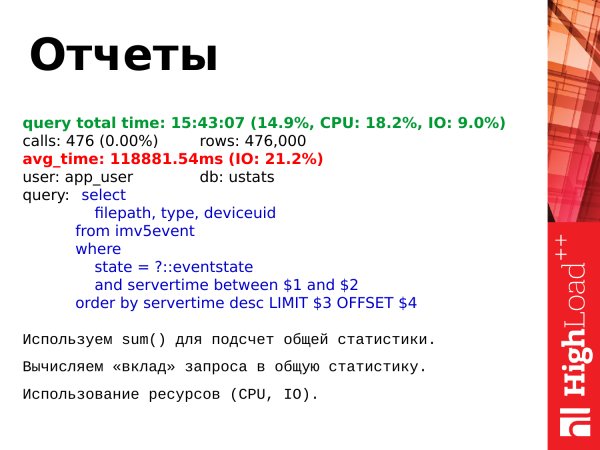
¿Qué hacemos? Contamos la estadística total de todas las consultas. Luego, para cada consulta, calculamos su aporte individual a esta estadística total.
¿Y qué podemos revisar? Podemos ver el tiempo total de ejecución de todas las consultas de un tipo específico en el contexto de todas las demás consultas. Podemos observar el uso de recursos del procesador y de E/S en relación con el panorama general. Y luego optimizar estas consultas. Generamos un top de consultas a partir de este informe y ya tenemos información para reflexionar sobre lo que se debe optimizar.
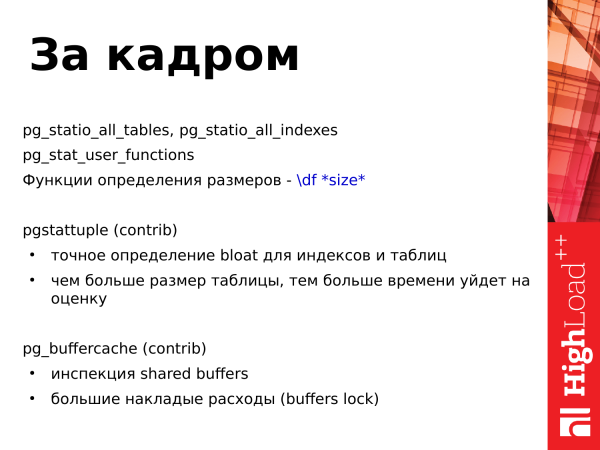
¿Qué nos quedó fuera de cámara? Quedaron algunas presentaciones más que no consideré, porque el tiempo es limitado.
Hay pgstattuple es también un módulo adicional del paquete estándar contribs. Permite evaluar bloat de la tabla, es decir, la fragmentación de la tabla. Y si la fragmentación es grande, hay que eliminarla, utilizando diferentes herramientas. Y la función pgstattuple tarda mucho. Y cuanto más grandes son las tablas, más tiempo tardará.
El siguiente contrib es pg_buffercache. Permite inspeccionar los buffers compartidos: cuán intensamente y para qué tablas se utilizan las páginas del buffer. Y simplemente permite echar un vistazo a los buffers compartidos y evaluar lo que sucede allí.
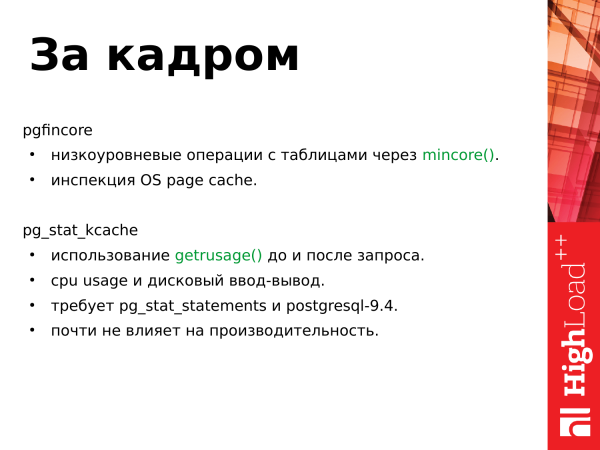
El siguiente módulo es pgfincore. Permite realizar operaciones de bajo nivel con las tablas a través de la llamada del sistema mincore(), es decir, permite cargar una tabla en los buffers compartidos o descargarla. Y además permite inspeccionar el caché de páginas del sistema operativo, es decir, en qué volumen ocupa nuestra tabla en el caché de páginas, en los buffers compartidos y simplemente permite evaluar la carga de la tabla.
El siguiente módulo es pg_stat_kcache. También utiliza la llamada del sistema getrusage(). Y la ejecuta antes y después de realizar la consulta. Y en la estadística obtenida permite evaluar cuánto tiempo consumió la consulta en realizar operaciones de entrada/salida en disco, es decir, operaciones con el sistema de archivos y observa el uso del procesador. Sin embargo, el módulo es nuevo (eh-eh) y para su funcionamiento requiere PostgreSQL 9.4 y pg_stat_statements, del cual hablé anteriormente.
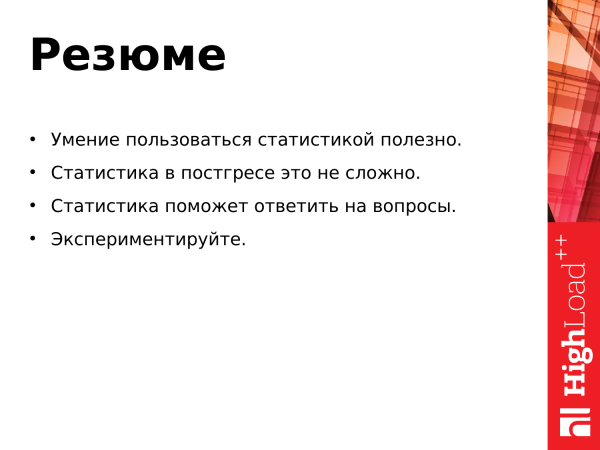
Saber usar la estadística es útil. No necesita programas externos. Puede mirar por su cuenta, ver algo, hacer algo, ejecutar.
Usar la estadística no es difícil, es SQL común. Se prepara la consulta, se envía, se revisa.
La estadística ayuda a responder preguntas. Si tiene dudas, se consulta la estadística: ve, saca conclusiones, analiza los resultados.
Y experimente. Hay muchas consultas, muchos datos. Siempre se puede optimizar alguna consulta existente. Se puede crear su propia versión de la consulta que se ajuste más a sus necesidades que el original y usarla.
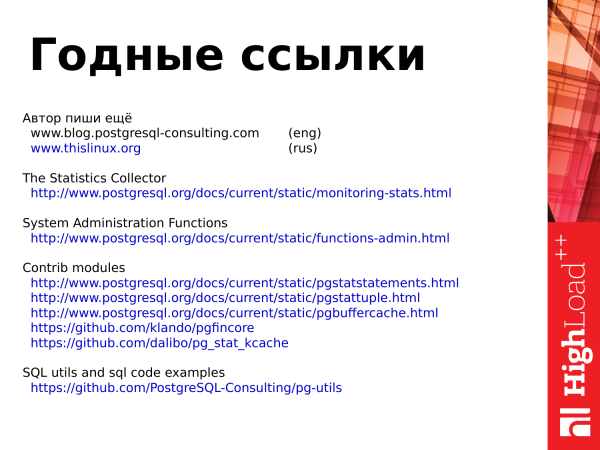
Enlaces
Los enlaces útiles mencionados en el artículo, que fueron la base de la presentación.
El autor sigue escribiendo
(eng)
El Coleccionista de Estadísticas
Funciones de Administración del Sistema
Módulos Contrib
Utilidades SQL y ejemplos de código SQL
¡Gracias a todos por su atención!
Fuente: habr.com
