

Siempre me ha interesado cómo organizar mejor los libros en mi biblioteca electrónica. Al final, llegué a esta opción con un conteo automático de páginas y otras ventajas. A todos los interesados, les pido que sigan leyendo.
Parte 1. Dropbox
Todos mis libros están en Dropbox. Existen 4 categorías en las que los he dividido: Texto de estudio, Referencia, Ficción, No ficción. Pero no añado los libros de referencia a la tabla.
La mayoría de los libros son .epub, los demás son .pdf. Así que la solución final debe cubrir ambas opciones.
Las rutas hacia los libros son aproximadamente las siguientes:
/Книги/Нехудожественное/Новое/Дизайн/Юрий Гордон/Книга про буквы от А до Я.epub Si el libro es de ficción, se elimina la categoría (es decir, 'Diseño' en el caso anterior).
Decidí no complicarme con la API de Dropbox, ya que tengo su aplicación, que sincroniza la carpeta. Así que el plan es: tomamos los libros de la carpeta, cada libro pasa por el contador de palabras, y luego lo añadimos a Notion.
Parte 2. Añadir una fila
La tabla debe verse aproximadamente de la siguiente manera. ATENCIÓN: es mejor que los nombres de las columnas sean en latín.
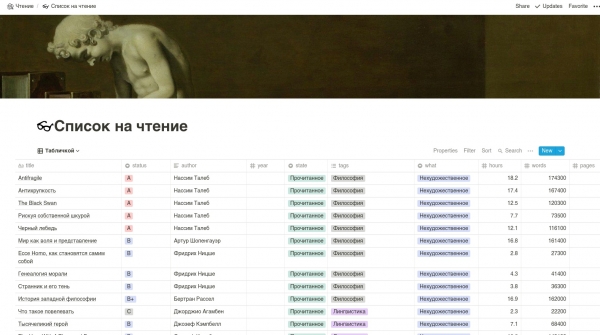
Usaremos una API no oficial de Notion, porque la oficial aún no ha sido lanzada.

Vamos a Notion, presionamos Ctrl + Shift + J, vamos a Aplicación -> Cookies, copiamos token_v2 y lo llamamos TOKEN. Luego vamos a la página correspondiente de la tabla de la biblioteca y copiamos el enlace. Lo llamamos NOTION.
Luego escribimos el código para conectarnos a Notion.
database = client.get_collection_view(NOTION)
current_rows = database.default_query().execute()
Luego escribimos una función para añadir una fila a la tabla.
def add_row(path, file, words_count, pages_count, hours):
    row = database.collection.add_row()
    row.title = file

    tags = path.split("/")

    if len(tags) >= 1:
        row.what = tags[0]

    if len(tags) >= 2:
        row.state = tags[1]

    if len(tags) >= 3:
        if tags[0] == "Ficción":
            row.author = tags[2]

        elif tags[0] == "No ficción":
            row.tags = tags[2]

        elif tags[0] == "Textos de estudio":
            row.tags = tags[2]

    if len(tags) >= 4:
        row.author = tags[3]

    row.hours = hours
    row.pages = pages_count
    row.words = words_count
Lo que está sucediendo aquí. Estamos tomando y añadiendo una nueva fila a la tabla en la primera línea. Luego, dividimos nuestro camino por '/' y obtenemos las etiquetas. Las etiquetas son en el sentido de 'Ficción', 'Diseño', quién es el autor, etc. Luego asignamos todos los campos necesarios de la tabla.
Parte 3. Contamos palabras, horas y otras maravillas
Este es un problema un poco más complicado. Como sabemos, tenemos dos formatos: ePub y PDF. Si con ePub está claro — probablemente haya palabras allí, lo que pasa con PDF no es tan sencillo: puede consistir simplemente en imágenes unidas.
Así que la función para contar palabras en PDF se verá de la siguiente manera: tomamos el número de páginas y lo multiplicamos por una constante determinada (el número promedio de palabras por página).
Aquí está:
def get_words_count(pages_number):
    return pages_number * WORDS_PER_PAGE
La palabra WORDS_PER_PAGE para una página A4 es aproximadamente 300.
Ahora escribamos una función para contar páginas. Usaremos .
def get_pdf_pages_number(path, filename):
    pdf = PdfFileReader(open(os.path.join(path, filename), 'rb'))
    return pdf.getNumPages()
A continuación, escribiremos algo para contar las páginas en ePub. Usaremos . Aquí tomamos el libro, lo convertimos en líneas, y para cada línea contamos las palabras.
def get_epub_pages_number(path, filename):
    book = open_book(os.path.join(path, filename))
    lines = convert_epub_to_lines(book)
    words_count = 0

    for line in lines:
        words_count += len(line.split(" "))

    return round(words_count / WORDS_PER_PAGE)
Ahora haremos la cuenta del tiempo. Tomamos nuestra cantidad favorita de palabras y la dividimos por tu velocidad de lectura.
def get_reading_time(words_count):
    return round(((words_count / WORDS_PER_MINUTE) / 60) * 10) / 10
Parte 4. Uniendo todas las partes
Necesitamos recorrer todos los posibles caminos en nuestra carpeta de libros. Verificar si ya hay un libro en Notion: si lo hay, ya no necesitamos crear la línea.
Luego necesitamos determinar el tipo de archivo, y dependiendo de eso contar el número de palabras. Al final, añadir el libro.
Así que nuestro código resulta ser:
for root, subdirs, files in os.walk(BOOKS_DIR):
    if len(files) > 0 and check_for_excusion(root):
        for file in files:
            array = file.split(".")
            filetype = file.split(".")[len(array) - 1]
            filename = file.replace("." + filetype, "")
            local_root = root.replace(BOOKS_DIR, "")

            print("Dir: {}, file: {}".format(local_root, file))

            if not check_for_existence(filename):
                print("Dir: {}, file: {}".format(local_root, file))

                if filetype == "pdf":
                    count = get_pdf_pages_number(root, file)

                else:
                    count = get_epub_pages_number(root, file)

                words_count = get_words_count(count)
                hours = get_reading_time(words_count)
                print("Pages: {}, Words: {}, Hours: {}".format(count, words_count, hours))
                add_row(local_root, filename, words_count, count, hours)
Y la función para verificar si el libro ha sido añadido se ve así:
def check_for_existence(filename):
    for row in current_rows:
        if row.title in filename:
            return True

        elif filename in row.title:
            return True

    return False
Conclusión
Gracias a todos los que leyeron este artículo. Espero que les ayude a leer más 🙂
Fuente: habr.com
