

Con el lanzamiento de un nuevo ciclo del curso preparamos la traducción de un material interesante.
Reseña
Hablaremos sobre un patrón bastante popular, mediante el cual las aplicaciones utilizan varios almacenes de datos, donde cada almacén se utiliza para sus propios fines, por ejemplo, para almacenar la forma canónica de los datos (MySQL, etc.), proporcionar capacidades de búsqueda avanzadas (ElasticSearch, etc.), almacenamiento en caché (Memcached, etc.) y otros. Normalmente, al utilizar múltiples almacenes de datos, uno de ellos funciona como el almacén principal, mientras que los demás son almacenes secundarios. El único problema es cómo sincronizar estos almacenes de datos.
Hemos revisado una serie de diferentes patrones que intentaban resolver el problema de la sincronización de múltiples almacenes, como la doble escritura, transacciones distribuidas, etc. Sin embargo, estos enfoques tienen limitaciones sustanciales en términos de uso en la vida real, confiabilidad y mantenimiento técnico. Además de la sincronización de datos, algunas aplicaciones también necesitan enriquecer los datos, llamando a servicios externos.
Para abordar estos problemas, se desarrolló Delta. Delta es, en última instancia, una plataforma coherente y gestionada por eventos para la sincronización y enriquecimiento de datos.
Soluciones existentes
Doble escritura
Para sincronizar dos almacenes de datos, se puede utilizar la doble escritura, que realiza una escritura en un almacén, y luego inmediatamente después, hace una escritura en el otro. La primera escritura puede repetirse, y la segunda puede interrumpirse si la primera falla después de agotar el número de intentos. Sin embargo, los dos almacenes de datos pueden dejar de sincronizarse si la escritura en el segundo almacén falla. Este problema se resuelve generalmente creando un procedimiento de recuperación que puede trasladar periódicamente datos del primer almacén al segundo o hacerlo solo si se detectan diferencias en los datos.
Problemas:
La ejecución del procedimiento de recuperación es una tarea específica que no se puede reutilizar. Además, los datos entre los almacenes permanecen desincronizados hasta que se complete el procedimiento de recuperación. La situación se complica si se utilizan más de dos almacenes de datos. Y, por último, el proceso de recuperación puede añadir carga al origen de datos original.
Tabla de registros de cambios
Cuando se producen cambios en un conjunto de tablas (por ejemplo, inserciones, actualizaciones y eliminaciones de registros), los registros de cambios se añaden a la tabla de registros como parte de la misma transacción. Otro flujo o proceso solicita constantemente eventos de la tabla de registros y los escribe en uno o varios almacenes de datos, eliminando eventos de la tabla de registros después de que todos los almacenes confirmen la escritura.
Problemas:
Este patrón debe implementarse como una biblioteca y, en ideal, sin modificar el código de la aplicación que la utiliza. En un entorno poliglota, la implementación de dicha biblioteca debe existir en cualquier lenguaje necesario, pero garantizar la coherencia del funcionamiento y el comportamiento entre lenguajes es muy complicado.
Otro problema radica en la obtención de cambios de esquema en aquellos sistemas que no admiten cambios de esquema transaccionales [1][2], como MySQL. Por lo tanto, el patrón para realizar cambios (por ejemplo, cambios de esquema) y registrar de forma transaccional esos cambios en la tabla de registros no siempre funcionará.
Transacciones Distribuidas
Las transacciones distribuidas se pueden utilizar para dividir una transacción entre varios almacenes de datos heterogéneos de tal manera que la operación se confirme en todos los almacenes utilizados o no se confirme en ninguno.
Problemas:
Las transacciones distribuidas son un gran problema para los almacenes de datos heterogéneos. Por su naturaleza, solo pueden depender del menor común denominador de los sistemas involucrados. Por ejemplo, las transacciones XA bloquean la ejecución si ocurre un fallo en la fase de preparación del proceso de la aplicación. Además, XA no proporciona detección de bloqueos y no admite esquemas optimistas de control de paralelismo. Aparte de esto, algunos sistemas como ElasticSearch no soportan XA ni ningún otro modelo de transacciones heterogéneas. Por lo tanto, garantizar la atomicidad de la escritura en varias tecnologías de almacenamiento de datos sigue siendo un desafío considerable para las aplicaciones [3].
Delta
Delta fue desarrollado para eliminar las limitaciones de las soluciones existentes de sincronización de datos, y también permite enriquecer los datos en tiempo real. Nuestro objetivo era abstraer todos estos aspectos complejos de los desarrolladores de aplicaciones, para que pudieran concentrarse completamente en implementar la funcionalidad comercial. A continuación, describiremos 'Movie Search', un caso de uso real de Delta por Netflix.
Netflix utiliza ampliamente una arquitectura de microservicios, y cada microservicio generalmente atiende un solo tipo de datos. La información básica sobre las películas se gestiona en un microservicio llamado Movie Service, y los datos relacionados, como la información sobre productores, actores, proveedores, etc., son gestionados por otros microservicios (específicamente Deal Service, Talent Service y Vendor Service).
Los usuarios comerciales en Netflix Studios a menudo necesitan buscar películas según diversos criterios, por lo que es muy importante para ellos tener la capacidad de buscar todos los datos relacionados con las películas.
Antes de Delta, el equipo de búsqueda de películas necesitaba obtener datos de varios microservicios antes de indexar los datos de las películas. Además, el equipo tenía que desarrollar un sistema que actualizara periódicamente el índice de búsqueda, solicitando cambios a otros microservicios, incluso si no había cambios en absoluto. Este sistema se volvió rápidamente complejo y difícil de mantener.
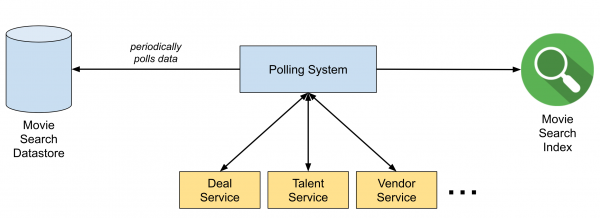
Figura 1. Sistema de sondeo antes de Delta
Después de comenzar a usar Delta, el sistema se simplificó a un sistema controlado por eventos, como se muestra en la imagen siguiente. Los eventos CDC (Change-Data-Capture) se envían a los temas de Keystone Kafka a través del Delta-Connector. La aplicación Delta, construida utilizando el Delta Stream Processing Framework (basado en Flink), recibe los eventos CDC del tema, los enriquece llamando a otros microservicios y, finalmente, transmite los datos enriquecidos al índice de búsqueda en Elasticsearch. Todo el proceso ocurre casi en tiempo real, es decir, tan pronto como se registran los cambios en el almacén de datos, se actualizan los índices de búsqueda.
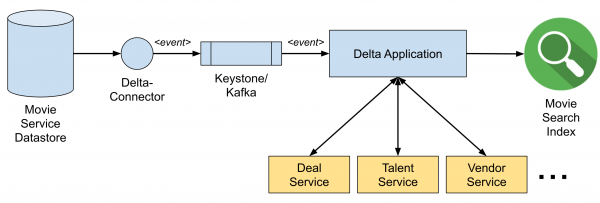
Figura 2. Pipeline de datos al usar Delta
En las siguientes secciones, describiremos el funcionamiento de Delta-Connector, que se conecta al almacén y publica eventos CDC en el nivel de transporte, el cual es la infraestructura de transmisión de datos en tiempo real que dirige los eventos CDC a los temas de Kafka. Y al final, hablaremos sobre la estructura de procesamiento de flujos de Delta que los desarrolladores de aplicaciones pueden usar para la lógica de procesamiento y enriquecimiento de datos.
CDC (Change-Data-Capture)
Desarrollamos un servicio CDC llamado Delta-Connector, que puede capturar cambios confirmados del almacén de datos en tiempo real y escribirlos en un flujo. Los cambios en tiempo real se obtienen del registro de transacciones y volcados del almacén. Se utilizan volcados porque los registros de transacciones generalmente no almacenan toda la historia de cambios. Los cambios suelen serializarse como eventos Delta, de modo que el destinatario no necesita preocuparse de dónde proviene el cambio.
Delta-Connector admite varias funciones adicionales, tales como:
- La capacidad de escribir en salidas personalizadas fuera de Kafka.
- La posibilidad de activar volcados manuales en cualquier momento para todas las tablas, una tabla específica o para determinadas claves primarias.
- Los volcados se pueden recuperar en partes, por lo que no es necesario empezar desde el principio en caso de fallo.
- No es necesario poner bloqueos en las tablas, lo cual es muy importante para que el tráfico de escritura en la base de datos nunca se bloquee por nuestro servicio.
- Alta disponibilidad debido a instancias de respaldo en las Zonas de Disponibilidad de AWS.
Ahora soportamos MySQL y Postgres, incluyendo implementaciones en AWS RDS y Aurora. También soportamos Cassandra (multi-maestro). Puede obtener más detalles sobre Delta-Connector en este .
Kafka y nivel de transporte
El nivel de transporte de eventos Delta se basa en el servicio de mensajería de la plataforma .
Históricamente, la publicación de mensajes en Netflix se optimizó para aumentar la disponibilidad en lugar de la durabilidad (ver ). El compromiso fue el potencial desajuste de los datos del corredor en varios escenarios extremos. Por ejemplo, elección de líder no limpia pero puede hacer que el receptor duplique o pierda eventos.
Con Delta, queríamos obtener garantías más sólidas de durabilidad para asegurar la entrega de eventos CDC en almacenes derivados. Para esto, propusimos un clúster Kafka diseñado específicamente como un objeto de primera clase. Puede ver algunas configuraciones del corredor en la tabla a continuación:
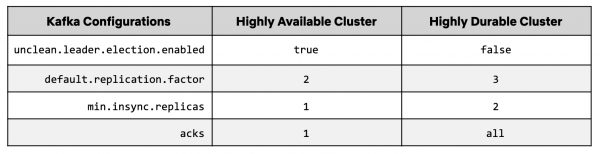
En los clústeres Keystone Kafka, elección de líder no limpia por lo general está habilitado para garantizar la disponibilidad del publicador. Esto puede llevar a la pérdida de mensajes si una réplica no sincronizada es elegida como líder. Para un nuevo clúster Kafka altamente confiable, la opción elección de líder no limpia está desactivada para prevenir la pérdida de mensajes.
También aumentamos el factor de replicación de 2 a 3 y réplicas mínimas en sincronización de 1 a 2. Los publicadores que escriben en este clúster requieren acks de todos los demás, asegurando que 2 de 3 réplicas tengan los mensajes más recientes enviados por el publicador.
Cuando una instancia de broker deja de funcionar, una nueva instancia reemplaza a la anterior. Sin embargo, el nuevo broker necesitará alcanzar las réplicas no sincronizadas, lo que puede llevar varias horas. Para reducir el tiempo de recuperación en este escenario, comenzamos a utilizar almacenamiento en bloque de datos (Amazon Elastic Block Store) en lugar de discos locales de los brokers. Cuando una nueva instancia reemplaza a una instancia de broker que ha terminado, se adjunta al volumen de EBS que tenía la instancia finalizada y comienza a ponerse al día con los nuevos mensajes. Este proceso reduce el tiempo de eliminación de atrasos de varias horas a varios minutos, ya que la nueva instancia ya no necesita replicar desde un estado vacío. En general, los ciclos de vida separados del almacenamiento y del broker reducen significativamente el impacto del cambio de broker.
Para aumentar aún más la garantía de entrega de datos, utilizamos para detectar cualquier pérdida de mensajes en condiciones extremas (por ejemplo, desincronización de relojes en el líder de la partición).
Marco de Procesamiento de Flujos
El nivel de procesamiento en Delta está basado en la plataforma Netflix SPaaS, que proporciona la integración de Apache Flink con el ecosistema de Netflix. La plataforma ofrece una interfaz de usuario que gestiona la implementación de trabajos de Flink y la orquestación de clústeres de Flink sobre nuestra plataforma de gestión de contenedores Titus. La interfaz también gestiona las configuraciones de trabajos y permite a los usuarios realizar cambios en la configuración de manera dinámica sin necesidad de recompilar los trabajos de Flink.
Delta proporciona un marco de procesamiento de flujos (stream processing framework) de datos basado en Flink y SPaaS, que utiliza basado en anotaciones DSL (Lenguaje Específico del Dominio), para abstraer los detalles técnicos. Por ejemplo, para definir el paso con el que se enriquecerán los eventos al llamar a servicios externos, los usuarios deben escribir el siguiente DSL, y el marco generará un modelo basado en él, que se ejecutará en Flink.
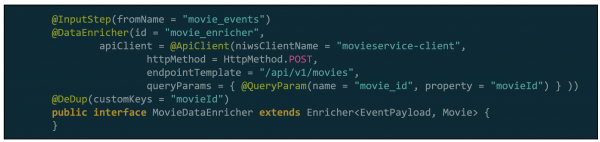
Figura 3. Ejemplo de enriquecimiento en DSL en Delta
El marco de procesamiento no solo acorta la curva de aprendizaje, sino que también proporciona funciones generales de procesamiento de flujos, como deduplicación, esquematización, así como flexibilidad y tolerancia a fallos para abordar problemas comunes en la operación.
El marco Delta Stream Processing consta de dos módulos clave: el módulo DSL & API y el módulo Runtime. El módulo DSL & API proporciona una API de DSL y UDF (Función Definida por el Usuario) para que los usuarios puedan escribir su propia lógica de procesamiento (por ejemplo, filtrado o transformaciones). El módulo Runtime proporciona la implementación de un analizador DSL que construye una representación interna de los pasos de procesamiento en modelos DAG. El componente de Ejecución interpreta los modelos DAG para inicializar los operadores de Flink y, en última instancia, ejecutar la aplicación Flink. La arquitectura del marco se ilustra en la siguiente figura.
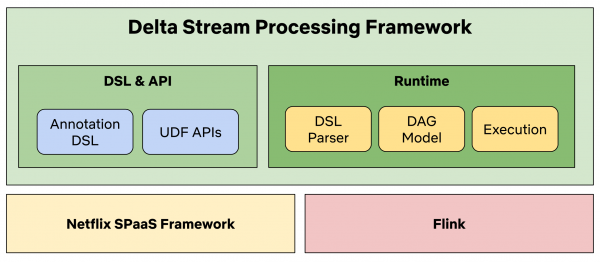
Figura 4. Arquitectura del marco Delta Stream Processing
Este enfoque tiene varias ventajas:
- Los usuarios pueden centrarse en su lógica de negocio sin necesidad de profundizar en la especificidad de Flink o la estructura de SPaaS.
- La optimización puede llevarse a cabo de manera transparente para los usuarios, y los errores pueden corregirse sin necesidad de realizar cambios en el código del usuario (UDF).
- El trabajo de las aplicaciones Delta se simplifica para los usuarios, ya que la plataforma proporciona flexibilidad y resiliencia desde el principio y recopila numerosas métricas detalladas que se pueden utilizar para alertas.
Uso en producción
Delta ha estado en producción durante más de un año y juega un papel clave en muchas aplicaciones de Netflix Studio. Ha ayudado a los equipos a implementar casos de uso como búsqueda indexada, almacenamiento de datos y flujos de trabajo impulsados por eventos. A continuación se presenta un resumen de la arquitectura de alto nivel de la plataforma Delta.
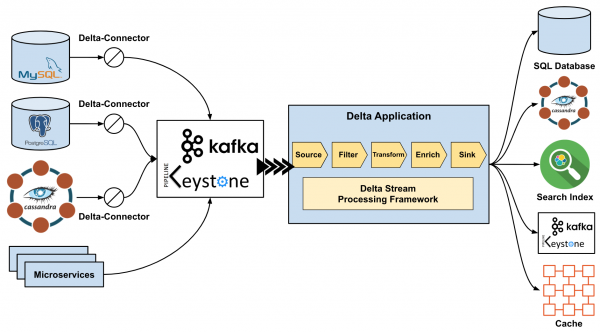
Figura 5. Arquitectura de alto nivel de Delta.
Agradecimientos
Nos gustaría agradecer a las siguientes personas que participaron en la creación y desarrollo de Delta en Netflix: Allen Wang, Charles Zhao, Jaebin Yoon, Josh Snyder, Kasturi Chatterjee, Mark Cho, Olof Johansson, Piyush Goyal, Prashanth Ramdas, Raghuram Onti Srinivasan, Sandeep Gupta, Steven Wu, Tharanga Gamaethige, Yun Wang y Zhenzhong Xu.
Fuentes
- Martin Kleppmann, Alastair R. Beresford, Boerge Svingen: Procesamiento de eventos en línea. Commun. ACM 62(5): 43–49 (2019). DOI:
: «Data Build Tool para el almacenamiento Amazon Redshift».
Fuente: habr.com
