

¡Hola a todos! Me llamo Pavel Agaletsky. Trabajo como líder de equipo en el grupo que desarrolla el sistema de entrega de Lamoda. En 2018, hablé en la conferencia HighLoad++, y hoy quiero presentar la transcripción de mi presentación.
Mi tema se centra en la experiencia de nuestra empresa en el despliegue de sistemas y servicios en diferentes entornos. Desde nuestros tiempos prehistóricos, cuando desplegábamos todos los sistemas en servidores virtuales comunes, hasta la transición gradual de Nomad al despliegue en Kubernetes. Hablaré sobre por qué lo hicimos y cuáles fueron los problemas que enfrentamos durante el proceso.

Despliegue de aplicaciones en VM
Comencemos por el hecho de que hace 3 años todos los sistemas y servicios de la empresa se desplegaban en servidores virtuales comunes. Técnicamente, se organizaba de tal manera que todo el código de nuestros sistemas se almacenaba y se construía mediante un sistema de compilación automática con Jenkins. A través de Ansible, se desplegaba desde nuestro sistema de control de versiones a los servidores virtuales. Cada sistema en nuestra empresa se desplegaba, al menos, en 2 servidores: uno en head y el otro en tail. Estos dos sistemas eran absolutamente idénticos en todas sus configuraciones, capacidades y demás. La única diferencia entre ellos era que head recibía el tráfico de los usuarios, mientras que tail nunca recibía dicho tráfico.
¿Por qué se hizo esto?
Cuando desplegábamos nuevas versiones de nuestra aplicación, queríamos asegurar un despliegue sin costuras, es decir, sin consecuencias notables para los usuarios. Esto se lograba al desplegar la nueva versión construida con Ansible en tail. Allí, las personas encargadas del despliegue podían verificar y asegurarse de que todo funcionara bien: todas las métricas, secciones y aplicaciones estaban operativas; se ejecutaban los scripts necesarios. Solo después de asegurarse de que todo estaba bien, el tráfico se redirigía. Comenzaba a dirigir el tráfico al servidor que anteriormente era tail. Y aquel que había sido head permanecía sin tráfico de usuarios, continuando con la versión anterior de nuestra aplicación.
De esta manera, para los usuarios fue sin interrupciones. Porque el cambio es instantáneo, ya que solo es un cambio del equilibrador de carga. Es muy fácil volver a la versión anterior simplemente cambiando el equilibrador de carga de nuevo. También pudimos verificar la capacidad de la aplicación en producción antes de que el tráfico de usuarios comenzara a fluir, lo que resultó ser bastante conveniente.
¿Cuáles fueron las ventajas que vimos en todo esto?
- Primero que nada, funciona suficientemente bien. Todo el mundo entiende cómo funciona tal esquema de despliegue, porque la mayoría de las personas ha desplegado en servidores virtuales convencionales alguna vez.
- Es bastantefiable, ya que la tecnología de despliegue es sencilla, probada por miles de empresas. Millones de servidores se despliegan de esta manera. Es difícil romper algo.
- Y finalmente, pudimos lograr despliegues atómicos.Despliegues que, para los usuarios, ocurren instantáneamente, sin una etapa de transición notable entre la versión antigua y la nueva.
Pero en todo esto también vimos algunas desventajas:
- Además del entorno de producción y el entorno de desarrollo, hay otros entornos. Por ejemplo, QA y preproducción. En ese momento teníamos muchos servidores y alrededor de 60 servicios. Por esta razón, teníamos que mantener la versión correspondiente de la máquina virtual para cada servicio. Además, si deseas actualizar bibliotecas o instalar nuevas dependencias, debes hacerlo en todos los entornos. También es necesario sincronizar el momento en que planeas desplegar la próxima versión de tu aplicación con el tiempo en que DevOps realizará las configuraciones necesarias del entorno. En ese caso, es fácil encontrarse en una situación en la que el entorno varíe ligeramente en todos los entornos seguidos. Por ejemplo, en el entorno de QA habrá ciertas versiones de bibliotecas, mientras que en producción habrá otras, lo que generará problemas.
- La dificultad en la actualización de las dependencias de tu aplicación. Esto no depende de ti, sino de otro equipo. A saber, del equipo de DevOps, que mantiene los servidores. Debes establecer una tarea adecuada para ellos y proporcionar una descripción de lo que deseas hacer.
- En ese momento, también queríamos dividir los grandes monolitos que teníamos en pequeños servicios, ya que entendíamos que seguirían aumentando. En ese entonces, ya teníamos más de 100. Era necesario crear una nueva máquina virtual separada para cada nuevo servicio, que también debía ser administrada y desplegada. Además, se necesitaban al menos dos máquinas. A todo esto se añadía el entorno de QA. Esto genera problemas y hace que la creación y el despliegue de nuevos sistemas sea más complejo, costoso y largo.
Por eso decidimos que sería más conveniente pasar del despliegue de máquinas virtuales normales al despliegue de nuestras aplicaciones en un contenedor Docker. Con Docker, se necesita un sistema que pueda ejecutar la aplicación en un clúster, ya que no puedes simplemente levantar un contenedor. Generalmente, quieres monitorear cuántos contenedores están activos para que se levanten automáticamente. Por esta razón, necesitábamos elegir un sistema de gestión.
Reflexionamos mucho sobre cuál podríamos elegir. La cuestión es que en ese momento este stack de despliegue en servidores virtuales comunes estaba algo desactualizado, ya que no contaba con las versiones más recientes de los sistemas operativos. En algún momento, incluso había FreeBSD, que no era muy cómodo de mantener. Entendíamos que era necesario migrar a Docker lo más rápido posible. Nuestros DevOps revisaron su experiencia con diferentes soluciones y eligieron un sistema llamado Nomad.
Migración a Nomad
Nomad es un producto de la empresa “HashiCorp”. También son conocidos por otras soluciones:
«Consul» — es una herramienta para descubrimiento de servicios.
«Terraform» — es un sistema para gestionar servidores, permitiéndote configurarlos a través de una configuración conocida como infrastructure-as-code.
«Vagrant» te permite desplegar máquinas virtuales localmente o en la nube mediante archivos de configuración determinados.
En ese momento, Nomad nos pareció una solución bastante sencilla, a la que podríamos migrar rápidamente sin cambiar toda la infraestructura. Además, es bastante fácil de aprender. Por eso lo elegimos como el sistema para gestionar nuestro contenedor.
¿Qué se necesita para desplegar tu sistema en Nomad?
- Primero que todo, necesitas una imagen de docker de su aplicación. Es necesario compilarla y almacenarla en un repositorio de imágenes de Docker. En nuestro caso, se trata de Artifactory, un sistema que permite enviar diversos artefactos de diferentes tipos. Puede almacenar archivos comprimidos, imágenes de Docker, paquetes de Composer PHP, paquetes NPM y más.
- También es necesario archivo de configuración, que le dirá a Nomad qué, dónde y en qué cantidad desea desplegar.
Cuando hablamos de Nomad, utiliza el lenguaje HCL como formato de archivo informático, que se desglosa como HashiCorp Configuration Language. Es un superconjunto de YAML que le permite describir su servicio en términos de Nomad.
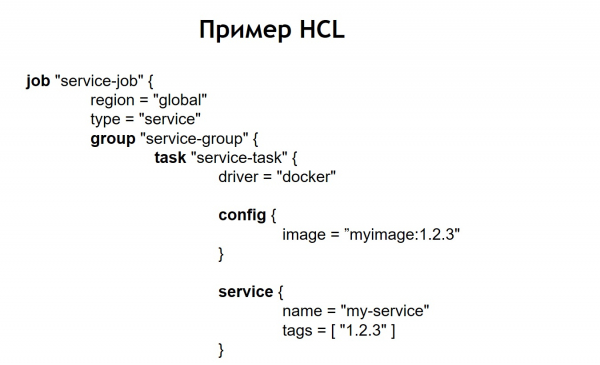
Le permite especificar cuántos contenedores desea desplegar, de qué imágenes, y pasarles varios parámetros durante la implementación. Así, le proporciona este archivo a Nomad, y él ejecuta contenedores de acuerdo a este.
En nuestro caso, entendimos que simplemente escribir archivos HCL idénticos para cada servicio no sería muy conveniente, ya que hay muchos servicios y a veces se desea actualizarlos. A veces, un servicio no se implementa en una sola instancia, sino en varias. Por ejemplo, uno de los sistemas que tenemos en producción tiene más de 100 instancias en producción. Se inician a partir de las mismas imágenes, pero difieren en configuraciones y archivos de configuración.
Por lo tanto, decidimos que sería conveniente almacenar todos nuestros archivos de configuración para la implementación en un único repositorio común. De esta manera, se volvieron auditables: eran fáciles de mantener y se podía ver qué sistemas teníamos. En caso de necesidad, también era fácil actualizar o cambiar algo. Agregar un nuevo sistema tampoco sería difícil: simplemente hay que crear un archivo de configuración dentro de un nuevo directorio. Dentro de él se encuentran los archivos: service.hcl, que contiene la descripción de nuestro servicio, y algunos archivos env que permiten configurar ese servicio cuando se despliega en producción.
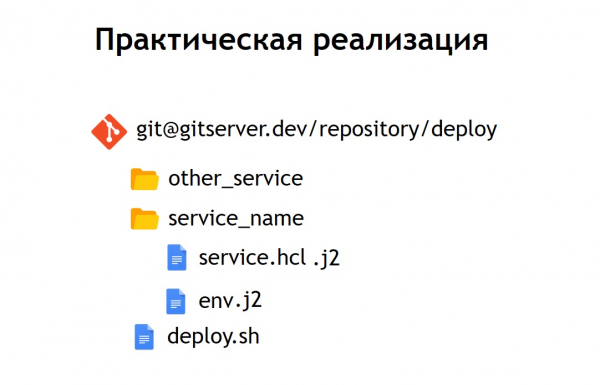
Sin embargo, algunos de nuestros sistemas están desplegados en producción no en una sola instancia, sino en varias a la vez. Por lo tanto, decidimos que sería más conveniente almacenar no las configuraciones en su forma pura, sino su versión plantillada. Y para el lenguaje de plantillas elegimos jinja 2En este formato almacenamos tanto las configuraciones del propio servicio como los archivos env necesarios para él.
Además, colocamos en el repositorio un script de despliegue común para todos los proyectos, que permite iniciar y desplegar su servicio en producción, en el entorno deseado, en el objetivo adecuado. En el caso de que convirtamos nuestra configuración HCL en una plantilla, el archivo HCL que anteriormente era una configuración normal de Nomad, en este caso, se verá un poco diferente.
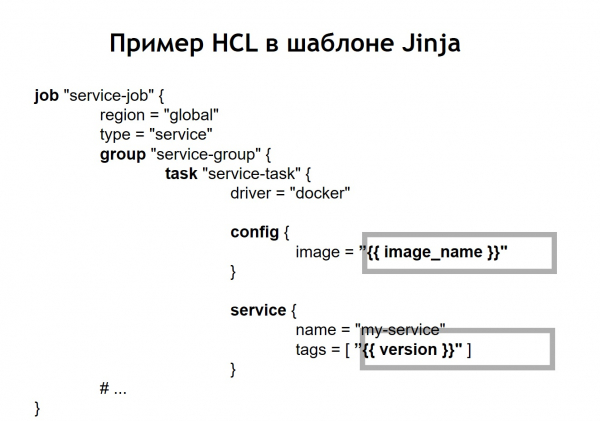
Es decir, hemos reemplazado algunas variables en la configuración por insertos de variables que se toman de archivos env o de otras fuentes. Además, obtuvimos la opción de construir archivos HCL de manera dinámica, es decir, podemos aplicar no solo los insertos de variables comunes. Dado que jinja soporta ciclos y condiciones, también se pueden crear archivos de configuración que cambian dependiendo de a dónde despliegue sus aplicaciones.
Por ejemplo, desea desplegar su servicio en preproducción y en producción. Supongamos que en preproducción no desea ejecutar scripts de cron, sino que simplemente quiere ver el servicio en un dominio separado para verificar que está funcionando. Para cualquiera que despliegue un servicio, el proceso se ve muy simple y transparente. Solo necesita ejecutar el archivo deploy.sh, indicando qué servicio desea desplegar y en qué objetivo. Por ejemplo, quiere desplegar un sistema en Rusia, Bielorrusia o Kazajistán. Para esto, basta con cambiar uno de los parámetros, y se generará el archivo de configuración correcto.
Cuando el servicio Nomad ya está desplegado en su clúster, se ve de la siguiente manera.
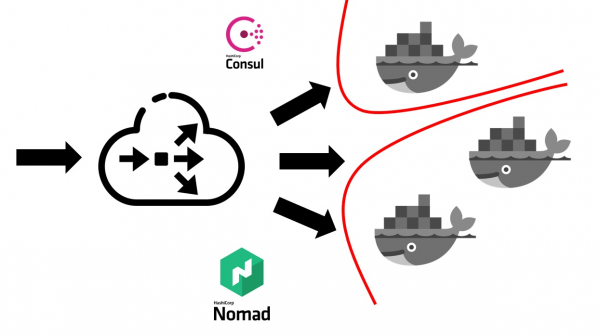
Para comenzar, necesita algún balanceador externo que reciba todo el tráfico de usuario. Este trabajará junto con Consul y le preguntará dónde, en qué nodo, por qué IP está ubicado el servicio específico que corresponde a un determinado nombre de dominio. Los servicios en Consul aparecen desde Nomad. Como son productos de la misma empresa, están bien interconectados. Se puede decir que Nomad puede registrar, por defecto, todos los servicios que se ejecutan en él dentro de Consul.
Después de que su balanceador de carga externo determina a qué servicio redirigir el tráfico, lo dirige al contenedor correspondiente o a varios contenedores que corresponden a su aplicación. Por supuesto, también es necesario considerar la seguridad. A pesar de que todos los servicios se ejecutan en las mismas máquinas virtuales dentro de contenedores, generalmente se requiere restringir el acceso libre entre servicios. Esto se logra mediante segmentación. Cada servicio se ejecuta en su propia red virtual, donde se definen las reglas de enrutamiento y las políticas de permiso/prohibición de acceso a otros sistemas y servicios, que pueden estar dentro o fuera de este clúster. Por ejemplo, si desea prohibir que un servicio se conecte a una base de datos específica, esto se puede hacer mediante la segmentación a nivel de red. Es decir, ni siquiera por error puede conectarse desde un ambiente de prueba a su base de datos de producción.
¿Cuál fue el costo del proceso de transición en términos de recursos humanos?
La transición de toda la empresa a Nomad tomó aproximadamente 5-6 meses. Nos cambiamos por servicio, pero a un ritmo bastante rápido. Cada equipo debía crear sus propios contenedores para los servicios.
Hemos adoptado el enfoque de que cada equipo es responsable de las imágenes de docker de sus propios sistemas. El equipo de DevOps proporciona la infraestructura general necesaria para el despliegue, es decir, el soporte del clúster, el soporte del sistema de CI, etc. Y en ese momento, más de 60 sistemas se habían trasladado a Nomad, lo que resultó en alrededor de 2,000 contenedores.
DevOps se encarga de la infraestructura general relacionada con el despliegue y los servidores. Por su parte, cada equipo de desarrollo es responsable de la implementación de contenedores para su sistema específico, ya que el equipo sabe exactamente qué necesita en cada contenedor.
Razones para abandonar Nomad
¿Qué ventajas obtuvimos al pasar al despliegue utilizando Nomad y docker, entre otros?
- Nosotros aseguramos condiciones iguales para todos los entornos. En desarrollo, entorno de QA, preproducción y producción se utilizan las mismas imágenes de contenedores, con las mismas dependencias. En consecuencia, prácticamente no hay posibilidad de que en producción termine algo diferente a lo que antes testeaste localmente o en un entorno de pruebas.
- También descubrimos que es suficiente agregar un nuevo servicio. Cualquier nuevo sistema, desde el punto de vista del despliegue, se lanza muy fácilmente. Solo hay que ir al repositorio que almacena los configs, agregar allí un nuevo config para tu sistema y todo está listo. Puedes desplegar tu sistema en producción sin esfuerzos adicionales por parte de DevOps.
- Todos archivos de configuración en un solo repositorio común resultaron ser observables. En el momento en que desplegamos nuestros sistemas usando servidores virtuales, utilizamos Ansible, en el que los configs estaban en un mismo repositorio. Sin embargo, para la mayoría de los desarrolladores, trabajar con esto era algo más complicado. Aquí, el volumen de configs y código que necesitas agregar para desplegar el servicio se volvió mucho menor. Además, para DevOps es muy fácil corregirlo o cambiarlo. En casos de migraciones, por ejemplo, a una nueva versión de Nomad, pueden tomar y actualizar masivamente todos los archivos operativos que están en el mismo lugar.
Pero también nos enfrentamos a algunas desventajas:
Resultó que no pudimos lograr un despliegue sin interrupciones en el caso de Nomad. Al lanzar contenedores desde diferentes condiciones, podía suceder que se estén ejecutando, y Nomad lo percibiera como un contenedor listo para aceptar tráfico. Esto ocurría incluso antes de que la aplicación dentro de él hubiera tenido tiempo de iniciarse. Por esta razón, el sistema comenzaba a emitir errores 500 durante un corto período de tiempo, porque el tráfico empezaba a dirigirse a un contenedor que aún no estaba listo para aceptarlo.
Nos encontramos con algunos errores. El error más significativo es que Nomad no maneja muy bien un clúster grande si tiene muchos sistemas y contenedores. Cuando desea sacar uno de los servidores que forman parte del clúster Nomad para mantenimiento, hay una probabilidad bastante alta de que el clúster no funcione bien y se desmorone. Parte de los contenedores puede, por ejemplo, caer y no volver a levantarse, lo que le costará muy caro si todos sus sistemas de producción están en ese clúster gestionado por Nomad.
Por eso decidimos pensar en a dónde ir a continuación. En ese momento comprendimos mucho mejor lo que queríamos lograr. Específicamente: queremos fiabilidad, un poco más de funciones de las que ofrece Nomad y un sistema más maduro y estable.
En este sentido, nuestra elección recayó en Kubernetes como la plataforma más popular para implementar clústeres. Especialmente considerando que el tamaño y la cantidad de nuestros contenedores eran bastante grandes. Para estos fines, Kubernetes parecía ser el sistema más adecuado entre los que podíamos explorar.
Transición a Kubernetes
Voy a contar un poco sobre cuáles son los conceptos básicos de Kubernetes y en qué se diferencian de Nomad.
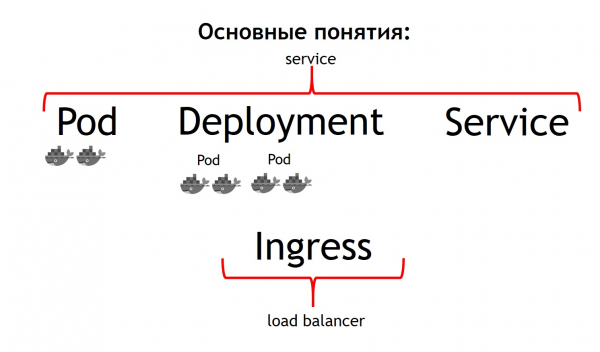
En primer lugar, el concepto más básico en Kubernetes es el de pod. Pod — es un grupo de uno o varios contenedores que siempre se ejecutan juntos. Y funcionan como si estuvieran siempre estrictamente en una sola máquina virtual. Se pueden comunicar entre sí a través de la dirección IP 127.0.0.1 en diferentes puertos.
Supongamos que tiene una aplicación PHP que consiste en nginx y php-fpm: un esquema clásico. Es probable que desee que tanto los contenedores de nginx como de php-fpm estén siempre juntos. Kubernetes permite lograr esto describiéndolos como un pod común. Esto era exactamente lo que no podíamos lograr con Nomad.
El segundo concepto es deployment. El hecho es que un pod por sí solo es una entidad efímera, se inicia y desaparece. Ya sea que quiera eliminar todos sus contenedores anteriores y luego iniciar de inmediato nuevas versiones o si desea implementarlos gradualmente, es precisamente para este proceso que se encarga el concepto de deployment. Describe cómo implementa sus pods, en qué cantidad y cómo actualizarlos.
El tercer concepto es el servicio. Su servicio es, de hecho, su sistema, que recibe cierto tráfico y luego lo dirige a uno o varios pods que corresponden a su servicio. Es decir, permite que todo el tráfico entrante a un servicio con un nombre específico se envíe a esos pods en particular. Y al mismo tiempo, le proporciona balanceo de carga. Esto significa que puede ejecutar dos pods de su aplicación y todo el tráfico entrante se equilibrará uniformemente entre los pods relacionados con ese servicio.
Y el cuarto concepto principal es Ingress. Es un servicio que se ejecuta en un clúster de Kubernetes. Actúa como un balanceador de carga externo que recibe todas las solicitudes. Gracias a la API de Kubernetes, Ingress puede determinar a dónde enviar esas solicitudes. Además, lo hace de manera muy flexible. Puede especificar que todas las solicitudes a este host y a esta URL se envían a este servicio. Y esas solicitudes que llegan a este host y a otra URL se envían a otro servicio.
Lo más genial desde la perspectiva de quien desarrolla la aplicación es que puede gestionar todo esto de manera independiente. Al configurar Ingress, puede enviar todo el tráfico que llega a una API específica a contenedores separados, escritos, por ejemplo, en Go. Y este tráfico, que llega al mismo dominio, pero a otra URL, se envía a contenedores escritos en PHP, donde hay mucha lógica, pero no son muy rápidos.
Si comparamos todos estos conceptos con Nomad, se puede decir que los primeros tres conceptos constituyen el Servicio en conjunto. Y el último concepto no existe en Nomad. En su lugar, utilizamos un balanceador de carga externo: puede ser haproxy, nginx, nginx+ y así sucesivamente. En el caso de Kubernetes, no necesita introducir este concepto adicional por separado. Sin embargo, al observar Ingress internamente, se trata ya sea de nginx, haproxy o traefik, pero incorporado en Kubernetes.
Todos los conceptos que he descrito son, en esencia, recursos que existen dentro del clúster de Kubernetes. Para describirlos en kubectl, se utiliza el formato yaml, que es más legible y familiar que los archivos HCL en el caso de Nomad. Pero estructuralmente describen lo mismo en el caso, por ejemplo, de un pod. Dicen: quiero desplegar ciertos pods allí, con estas imágenes, en esta cantidad.
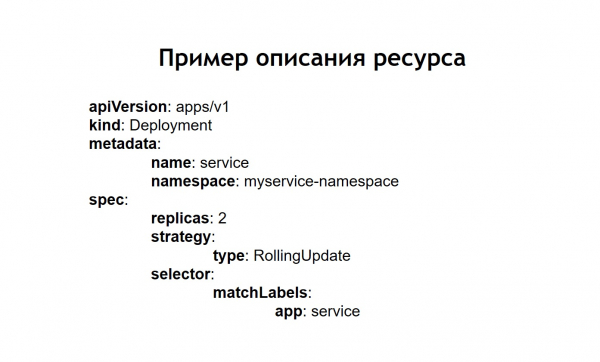
Además de esto, nos dimos cuenta de que no queríamos crear cada recurso por separado: deployment, servicios, Ingress y demás. En lugar de eso, queríamos describir cada sistema que tenemos en términos de Kubernetes durante el despliegue, para no tener que recrear manualmente todas las dependencias necesarias en el orden correcto. Para eso, elegimos Helm como el sistema que nos permite hacerlo.
Conceptos Clave en Helm
Helm es un gestor de paquetes para Kubernetes. Es muy similar a cómo funcionan los gestores de paquetes en los lenguajes de programación. Te permiten almacenar un servicio que consiste, por ejemplo, en un deployment de nginx, un deployment de php-fpm, una configuración para Ingress, configmaps (que es una entidad que te permite establecer env y otros parámetros para tu sistema) en forma de lo que se conoce como charts. Mientras tanto, Helm funciona sobre Kubernetes. Es decir, no es un sistema independiente, sino simplemente otro servicio que se ejecuta dentro de la esfera. Te interactúas con él a través de su API mediante un comando de consola. Su conveniencia y atractivo radican en que, incluso si helm falla o lo eliminas del clúster, tus servicios no desaparecerán, ya que helm sirve esencialmente solo para iniciar el sistema. La operatividad y estado de los servicios son considerados por Kubernetes.
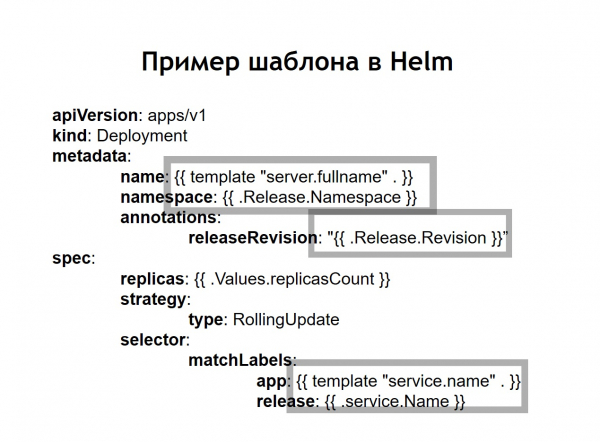
También entendimos que la plantillización, que antes teníamos que hacer manualmente mediante la implementación de jinja en nuestras configuraciones, es una de las principales capacidades de helm. Todas las configuraciones que creas para tus sistemas se almacenan en helm como plantillas, que son un poco similares a jinja, pero que, en realidad, utilizan la plantillización del lenguaje Go, en el que está escrito helm, al igual que Kubernetes.
Helm nos agrega algunos conceptos adicionales.
Gráfico — es la descripción de tu servicio. En otros gestores de paquetes se le llamaría paquete, bundle o algo similar. Aquí se llama chart.
Values – son las variables que deseas utilizar para construir tus configuraciones a partir de las plantillas.
ReleaseCada vez que un servicio se despliega usando helm, recibe una versión incremental del lanzamiento. Helm recuerda cuál era la configuración del servicio en el lanzamiento anterior, en el antepenúltimo y así sucesivamente. Por lo tanto, si es necesario revertir, basta con ejecutar el comando helm callback, especificando la versión anterior del lanzamiento. Incluso si en el momento de la reversión la configuración correspondiente no está disponible en su repositorio, helm aún recuerda cuál era y revertirá su sistema al estado en que se encontraba en el lanzamiento anterior.
En el caso de que estemos utilizando helm, las configuraciones normales para Kubernetes también se convierten en plantillas, en las que es posible usar variables, funciones y aplicar operadores condicionales. De esta forma, puede construir la configuración de su servicio en función del entorno.
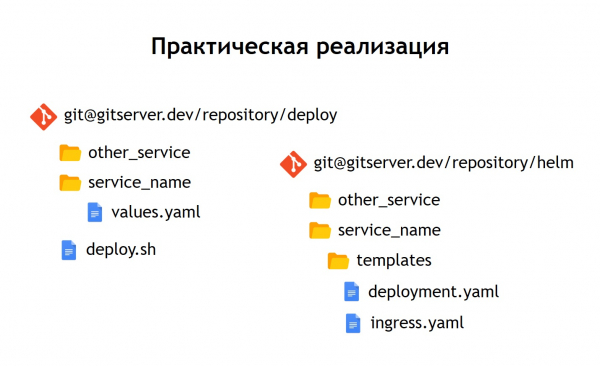
En la práctica, decidimos actuar un poco diferente a como lo hicimos con Nomad. Si en Nomad se almacenaban tanto las configuraciones para el despliegue como las n-variables necesarias para desplegar nuestro servicio en un mismo repositorio, aquí decidimos separarlas en dos repositorios distintos. En el repositorio 'deploy' se almacenan solo las n-variables necesarias para el despliegue, mientras que en el repositorio 'helm' se almacenan configuraciones o gráficos.
¿Qué nos ha dado esto?
A pesar de que en los propios archivos de configuración no almacenamos datos realmente sensibles, como contraseñas de bases de datos, las cuales se guardan como secretos en Kubernetes, aún así hay cosas específicas a las que no queremos dar acceso a todos. Por lo tanto, el acceso al repositorio 'deploy' es más restringido, mientras que el repositorio 'helm' contiene simplemente la descripción del servicio. Por esta razón, se puede otorgar acceso de manera segura a un público más amplio.
Dado que tenemos no solo producción sino también otros entornos, gracias a esta separación podemos reutilizar nuestros gráficos de helm para desplegar servicios no solo en producción, sino también, por ejemplo, en entornos de QA. Incluso para desplegarlos localmente, usando Minikube — es una herramienta para el lanzamiento local de Kubernetes.
Dentro de cada repositorio hemos mantenido una separación en directorios individuales para cada servicio. Es decir, dentro de cada directorio se encuentran las plantillas que pertenecen a la carta correspondiente y que describen los recursos que deben ser desplegados para poner en marcha nuestro sistema. En el repositorio 'deploy' hemos dejado únicamente los entornos. En este caso, no utilizamos la templating con jinja, porque helm proporciona templating por sí mismo, siendo esta una de sus principales funciones.
Hemos dejado un script para el despliegue – deploy.sh, que simplifica y estandariza el lanzamiento para el despliegue con helm. Por lo tanto, para cualquiera que desee desplegar, la interfaz de despliegue se ve exactamente igual a como era en el caso del despliegue a través de Nomad. El mismo deploy.sh, el nombre de tu servicio y a dónde deseas desplegarlo. Esto provoca que dentro se active helm. A su vez, reúne las configuraciones de las plantillas, inserta los archivos de valores necesarios y luego despliega, enviándolos a Kubernetes.
Conclusiones
El servicio de Kubernetes parece más complejo que Nomad.
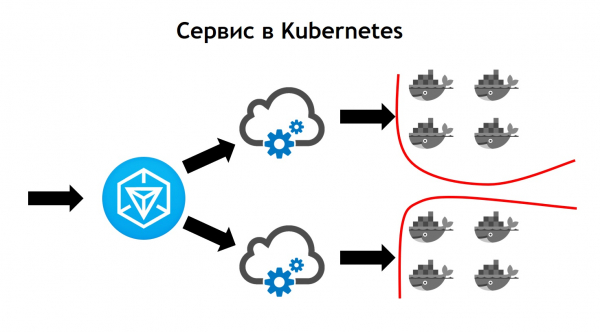
Aquí, el tráfico saliente llega a Ingress. Este es el controlador frontal que recibe todas las solicitudes y posteriormente las envía a los servicios correspondientes según los datos de la solicitud. Los determina basándose en las configuraciones que son parte de la descripción de tu aplicación en helm y que los desarrolladores establecen por sí mismos. El servicio a su vez envía solicitudes a sus pods, es decir, contenedores específicos, equilibrando el tráfico entrante entre todos los contenedores que pertenecen a este servicio. Y, por supuesto, no debemos olvidar que la seguridad a nivel de red no puede ser descuidada. Por lo tanto, en el clúster de Kubernetes se aplica segmentación, basada en etiquetado. Todos los servicios tienen etiquetas específicas a las cuales se vinculan los permisos de acceso de los servicios a determinados recursos externos/internos dentro o fuera del clúster.
Al hacer la transición, notamos que Kubernetes tiene todas las capacidades de Nomad, que utilizamos anteriormente, y además agrega muchas nuevas. Se puede extender a través de plugins, y en realidad a través de tipos de recursos personalizados. Es decir, no solo tienes la opción de utilizar algo que viene en Kubernetes por defecto, sino que puedes crear tu propio recurso y servicio que leerá su recurso. Esto ofrece oportunidades adicionales para ampliar tu sistema sin necesidad de reinstalar Kubernetes y sin requerir cambios.
Un ejemplo de este tipo de uso es Prometheus, que se ejecuta dentro de nuestro clúster de Kubernetes. Para que comience a recopilar métricas de un servicio en particular, necesitamos agregar un tipo de recurso adicional en la descripción del servicio, llamado monitor de servicio. Prometheus, al poder leer un tipo de recursos personalizados cuando se ejecuta en Kubernetes, comienza automáticamente a recopilar métricas del nuevo sistema. Esto resulta bastante conveniente.
El primer despliegue que hicimos en Kubernetes fue en marzo de 2018. Y durante este tiempo, nunca hemos tenido problemas con él. Funciona de manera bastante estable sin errores significativos. Además, podemos extenderlo aún más. Hasta la fecha, tenemos suficientes capacidades disponibles en él, y nos gusta mucho el ritmo de desarrollo de Kubernetes. Actualmente, hay más de 3000 contenedores en Kubernetes. El clúster ocupa varios nodos. Aun así, es manejable, estable y muy controlable.
Fuente: habr.com
