

¡Hola a todos! En el marco de mi trabajo de curso, he estado investigando las capacidades de una plataforma de nube nacional como . La plataforma ofrece diversos servicios para resolver tareas prácticas. Sin embargo, en ocasiones es necesario configurar una aplicación en la nube basada en estos servicios, con una infraestructura bastante compleja. En este artículo, quiero compartir mi experiencia en el despliegue de una aplicación así.
¿Qué se desea obtener?
— una poderosa herramienta para resolver tareas analíticas o de monitoreo de sistemas. En su configuración básica, esto es una máquina virtual con un servidor web de Grafana, así como una base de datos (ClickHouse, InfluxDB, etc.) con un conjunto de datos sobre el cual se generará el análisis.
Una vez que se haya lanzado la máquina virtual con el servidor web, se podrá acceder a su host y obtener una interfaz de usuario atractiva, especificar las bases de datos como fuentes para el trabajo posterior, crear tableros y gráficos.
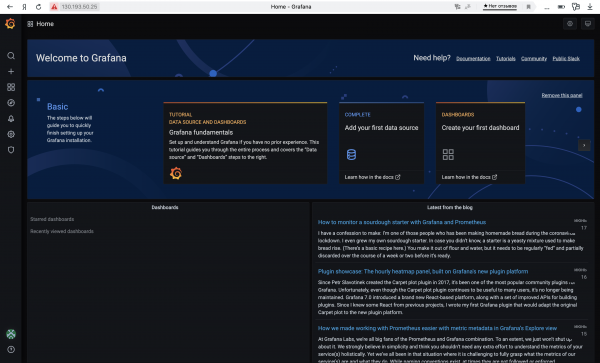
La versión básica tiene un inconveniente significativo: no es tolerante a fallos. Es decir, toda la operatividad de la aplicación depende de la viabilidad de una única máquina virtual. Si falla o si 10 personas abren la interfaz de usuario al mismo tiempo, surgirán problemas.
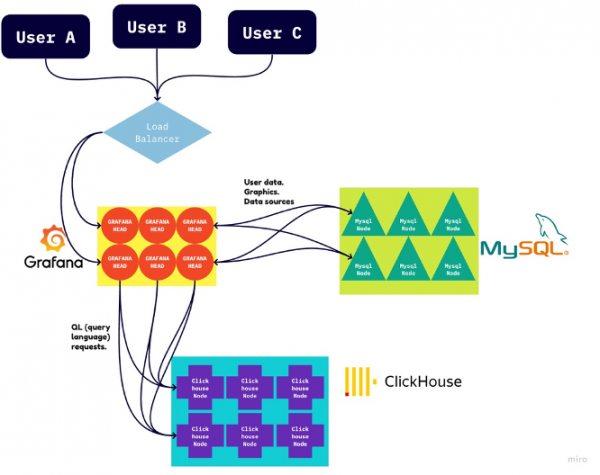
Se resuelven fácilmente: solo hay que… desplegar múltiples máquinas virtuales idénticas con el servidor web y colocarlas bajo un balanceador L3. Pero aquí las cosas no son tan simples. Grafana almacena la configuración del usuario (rutas a las bases de datos, tableros, gráficos, etc.) directamente en el disco de su máquina virtual. Por lo tanto, si se modifican algunas configuraciones en la interfaz de usuario, esos cambios solo se reflejarán en la máquina virtual a la que nos envió el balanceador. Esto conducirá a configuraciones inconsistentes de nuestra aplicación, y surgirán problemas al iniciarla y usarla.
Aquí es donde entra en juego otra base de datos, como MySQL o su equivalente. Le decimos a Grafana que debe almacenar la configuración del usuario precisamente en esta base de datos "de respaldo". Después, solo será necesario indicar una vez el camino a esta base de datos en cada máquina, y todas las demás configuraciones del usuario se pueden editar en cualquiera de las máquinas virtuales; se propagarán a las demás.
Este es el esquema de la infraestructura final de la aplicación:
Aprendamos a levantar con las manos
MySQL y ClickHouse
Antes de desplegar una aplicación así con solo pulsar un botón, había que aprender a levantar cada uno de sus componentes manualmente e integrarlos entre sí.
Aquí nos ayudará Yandex.Cloud, que ofrece balanceadores L3, ClickHouse y MySQL como servicios gestionados. El usuario solo necesita especificar los parámetros y esperar a que la plataforma lo ponga todo en funcionamiento.
Me registré, creé un cloud y una cuenta de pago. Después, entré en el cloud y levanté clústeres de MySQL y ClickHouse con configuraciones mínimas. Esperé a que se activaran.
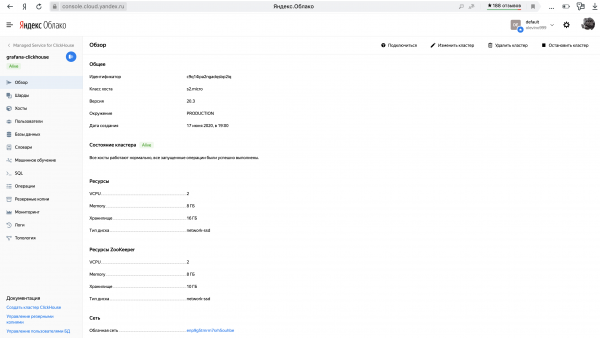
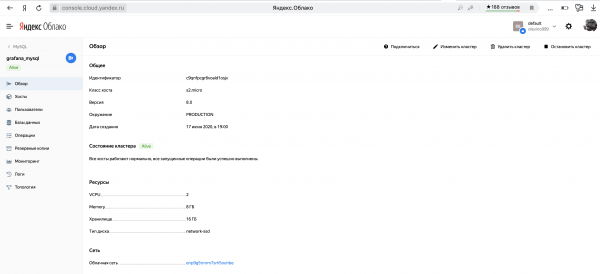
También hay que recordar crear una base de datos en cada clúster y configurar el acceso a ella mediante nombre de usuario y contraseña. No entraré en detalles aquí; en la interfaz es todo bastante evidente.
Un detalle no tan obvio era que estas bases de datos tenían muchos hosts que garantizan su alta disponibilidad. Sin embargo, Grafana requiere exactamente un host para cada base de datos con la que trabaja. Lectura prolongada La nube me llevó a la solución. Resulta que el host del tipo c-<cluster_id>.rw.mdb.yandexcloud.net se mapea al maestro activo actual del clúster con el identificador correspondiente. Justo eso le daremos a Grafana.
Servidor web
Ahora solo falta el servidor web. Levantemos una máquina virtual normal con Linux y configuremos Grafana manualmente en ella.
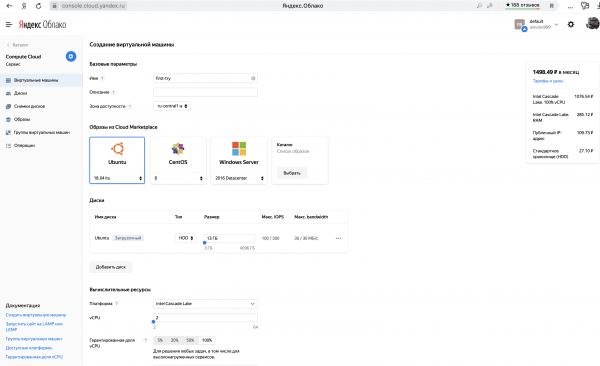
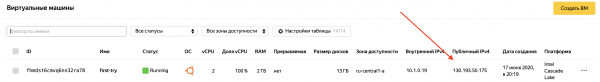
Nos conectamos por ssh e instalamos los paquetes necesarios.
sudo apt-get install -y apt-transport-https software-properties-common wget
wget -q -O - https://packages.grafana.com/gpg.key | sudo apt-key add -
sudo add-apt-repository "deb https://packages.grafana.com/enterprise/deb stable main"
sudo apt-get update
sudo apt-get install -y grafana-enterprise
Después de esto, iniciaremos Grafana con systemctl e instalaremos el plugin para trabajar con ClickHouse (sí, no viene incluido en la configuración básica).
sudo systemctl start grafana-server
sudo systemctl enable grafana-server
sudo grafana-cli plugins install vertamedia-clickhouse-datasource
Listo, después de esto, con el simple comando
sudo service grafana-server startiniciaremos el servidor web. Ahora se podrá introducir la dirección IP externa de la máquina virtual en el navegador, especificar el puerto 3000 y ver la hermosa interfaz de Grafana.
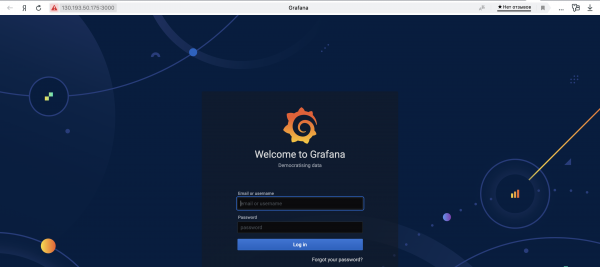
Pero no hay que apresurarse, antes de configurar Grafana, no olvidemos indicarle la ruta a MySQL para almacenar ahí las configuraciones.
Toda la configuración del servidor web de Grafana se encuentra en el archivo /etc/grafana/grafana.ini. La línea necesaria se ve así:
;url =Establecemos el host para el clúster MySQL. En este mismo archivo se encuentran el nombre de usuario y la contraseña para acceder a Grafana en la imagen anterior, los cuales por defecto son iguales. admin.
Se pueden utilizar comandos sed:
sudo sed -i "s#.*;url =.*#url = mysql://[${MYSQL_USERNAME}:${MYSQL_PASSWORD}@${MYSQL_CLUSTER_URI}#" /etc/grafana/grafana.ini
sudo sed -i "s#.*;admin_user =.*#admin_user = ${GRAFANA_USERNAME}#" /etc/grafana/grafana.ini
sudo sed -i "s#.*;admin_password =.*#admin_password = ${GRAFANA_PASSWORD}#" /etc/grafana/grafana.ini
¡Es momento de reiniciar el servidor web!
sudo service grafana-server restartAhora en la UI de Grafana indicaremos ClickHouse como DataSource.
Logré obtener una configuración funcional con las siguientes configuraciones:
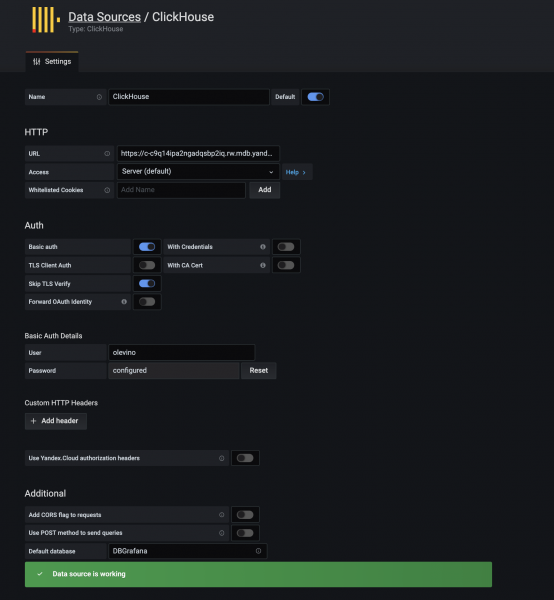
Como URL, he indicado https://c-.rw.mdb.yandexcloud.net:8443
¡Todo listo! Tenemos una máquina virtual operativa con un servidor web, conectado a CH y MySQL. Ya se puede cargar un conjunto de datos en ClickHouse y crear tableros. Sin embargo, aún no hemos alcanzado nuestro objetivo y no hemos desplegado una infraestructura completa.
Packer
Yandex.Cloud permite crear una imagen de disco de una máquina virtual existente, y sobre su base, tantas máquinas idénticas como se desee. Justamente esto es lo que vamos a utilizar. Para facilitar la creación de la imagen, tomaremos la herramienta de HashiCorp. Acepta como entrada un archivo json con instrucciones para construir la imagen.
Nuestro archivo json constará de dos bloques: builders y provisioners. El primer bloque describe los parámetros de la imagen como entidad, y el segundo, las instrucciones para llenarla con el contenido necesario.
Builders
{
"builders": [
    {
      "type": "yandex",
      "endpoint": "{{user `endpoint`}}",
      "folder_id": "",
      "subnet_id": "{{user `subnet_id`}}",
      "zone": "{{user `zone`}}",
      "labels": {},
      "use_ipv4_nat": true,
      "use_internal_ip": false,
      "service_account_key_file": "",
      "image_name": "grafana-{{timestamp}}",
      "image_family": "grafana",
      "image_labels": {},
      "image_description": "GRAFANA",
      "source_image_family": "ubuntu-1804-lts",
      "disk_size_gb": 3,
      "disk_type": "network-hdd",
      "ssh_username": "ubuntu"
    }
  ],
...
}
En esta plantilla tienes que establecer el identificador de la sección en la nube donde deseas crear la imagen, así como la ruta al archivo con las claves de la cuenta de servicio previamente creada en esta sección. Puedes leer más sobre cómo crear cuentas de servicio y claves en formato de archivo en la sección correspondiente. .
Esta configuración indica que la imagen de disco se construirá sobre la base de la plataforma ubuntu-1804-lts, guardada en la sección correspondiente del usuario en la familia de imágenes GRAFANA con el nombre grafana-{{timestamp}}.
Provisioners
Ahora viene la parte más interesante de la configuración. Aquí se describirá la secuencia de acciones que se deben realizar en la máquina virtual antes de congelar su estado en una imagen de disco.
{
...,
"provisioners": [
    {
            "type": "shell",
            "pause_before": "5s",
            "scripts": [
                "prepare-ctg.sh"
            ]
        },
    {
            "type": "file",
            "source": "setup.sh",
            "destination": "\/opt\/grafana\/setup.sh"
        },
        {
            "type": "shell",
        "execute_command": "sudo {{ .Vars }} bash '{{ .Path }}'",
            "pause_before": "5s",
            "scripts": [
                "install-packages.sh",
                "grafana-setup.sh",
                "run-setup-at-reboot.sh"
        ]
        }
  ]
}
Todas las acciones se dividen en 3 etapas. En la primera etapa, se ejecuta un simple script que crea un directorio auxiliar.
prepare-ctg.sh:
#!/bin/bash
sudo mkdir -p /opt/grafana
sudo chown -R ubuntu:ubuntu /opt/grafana
En la siguiente etapa, colocamos en este directorio el script que se debe ejecutar inmediatamente después de iniciar la máquina virtual. Este script configurará las variables de usuario que deben estar establecidas en la configuración de Grafana y reiniciará el servidor web.
setup.sh:
#!/bin/bash
CLUSTER_ID="<cluster_id>"
USERNAME="<username>"
PASSWORD="<password>"
sudo sed -i "s#.*;url =.*#url = mysql://${USERNAME}:${PASSWORD}@c-${CLUSTER_ID}.rw.mdb.yandexcloud.net#" /etc/grafana/grafana.ini
sudo sed -i "s#.*;admin_user =.*#admin_user = ${USERNAME}#" /etc/grafana/grafana.ini
sudo sed -i "s#.*;admin_password =.*#admin_password = ${PASSWORD}#" /etc/grafana/grafana.ini
sudo service grafana-server restart
Después de esto, hay 3 cosas por hacer:
1) instalar paquetes
2) iniciar Grafana con systemctl e instalar el plugin ClickHouse
3) colocar el script setup.sh en la cola para que se ejecute inmediatamente después de encender la máquina virtual.
install-packages.sh:
#!/bin/bash
sudo systemd-run --property='After=apt-daily.service apt-daily-upgrade.service' --wait /bin/true
sudo apt-get install -y apt-transport-https
sudo apt-get install -y software-properties-common wget
wget -q -O - https://packages.grafana.com/gpg.key | sudo apt-key add -
sudo add-apt-repository "deb https://packages.grafana.com/enterprise/deb stable main"
sudo apt-get update
sudo apt-get install -y grafana-enterprise
grafana-setup.sh:
#!/bin/bash
sudo systemctl start grafana-server
sudo systemctl enable grafana-server
sudo grafana-cli plugins install vertamedia-clickhouse-datasource
run-setup-at-reboot.sh:
#!/bin/bash
chmod +x /opt/grafana/setup.sh
cat > /etc/cron.d/first-boot <<EOF
PATH=/usr/local/sbin:/usr/local/bin:/usr/sbin:/usr/bin:/sbin:/bin:/usr/games:/usr/local/games
@reboot root /bin/bash /opt/grafana/setup.sh > /var/log/yc-setup.log 2>&1
EOF
chmod +x /etc/cron.d/first-boot;
Ahora queda ejecutar Packer y obtener como salida una imagen almacenada en la sección especificada. Al crear la máquina virtual, se puede elegir esta imagen como disco de arranque y, después de iniciar, obtener un servidor web Grafana listo.
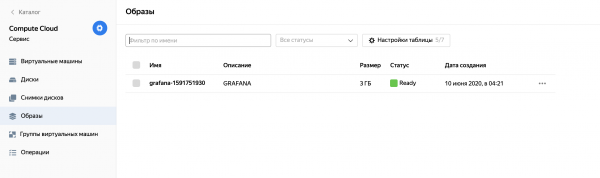
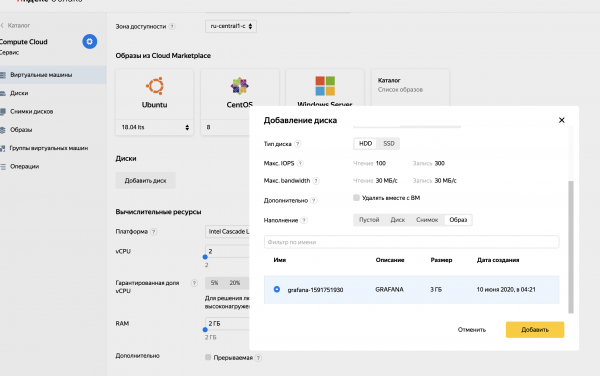
Grupo de instancias y balanceador
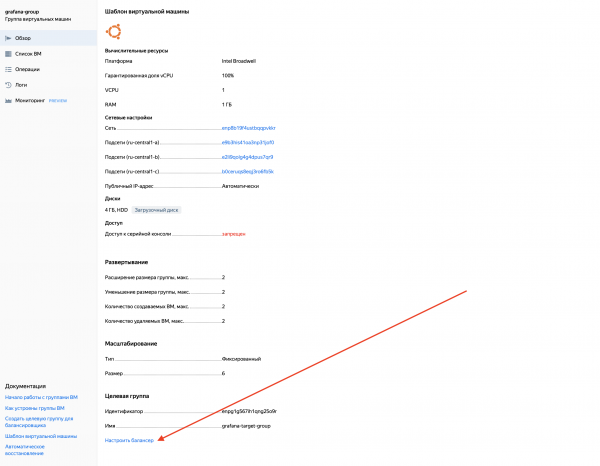
Una vez que se ha creado la imagen de disco que permite crear múltiples servidores web Grafana idénticos, podemos crear un grupo de instancias. En la plataforma Yandex.Cloud, este término se refiere a la agrupación de máquinas virtuales con características idénticas. Al crear un grupo de instancias, se configura el prototipo de todas las máquinas en este grupo, y después las características del propio grupo (por ejemplo, el número mínimo y máximo de máquinas activas). Si el número actual no cumple con estos criterios, el grupo de instancias eliminará automáticamente las máquinas innecesarias o creará nuevas a partir de la imagen.
En el marco de nuestra tarea, crearemos un grupo de instancias de servidores web que se generarán a partir de la imagen de disco creada anteriormente.
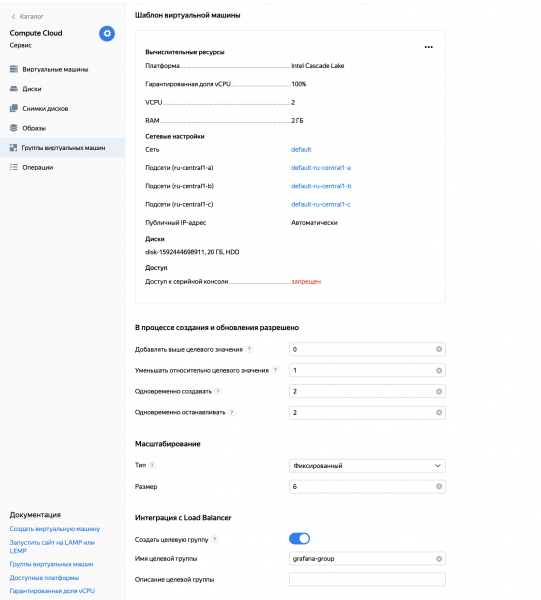
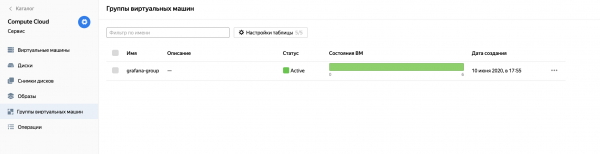
Realmente notable es la última configuración del grupo de instancias. El grupo objetivo, en integración con el Load Balancer, ayudará a configurar el balanceador L3 sobre las máquinas virtuales de este grupo con solo pulsar un par de botones.
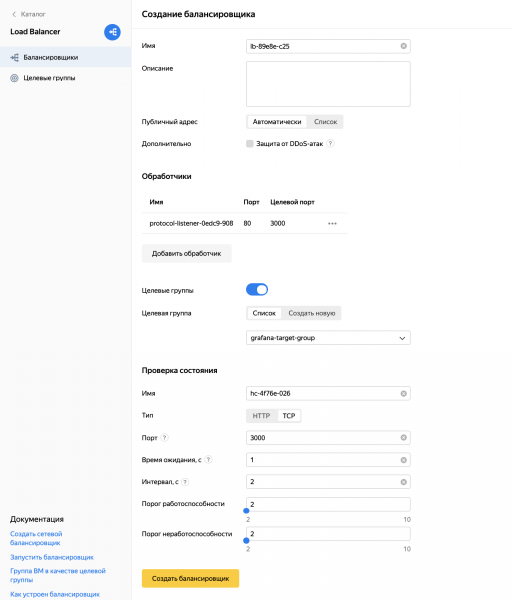
Al configurar el balanceador, implementé dos aspectos importantes:
- Hice que el balanceador aceptara tráfico del usuario en el puerto 80 y lo redirigiera al puerto 3000 de las máquinas virtuales, justo donde reside Grafana.
- Configuré la verificación de la viabilidad de las máquinas, haciendo ping al puerto 3000.
Resumen breve
Finalmente, hemos logrado desplegar manualmente la infraestructura deseada de la aplicación, y ahora tenemos un servicio Grafana de alta disponibilidad. Solo es necesario conocer la dirección IP del balanceador como punto de entrada a la aplicación y el host del clúster ClickHouse para cargar el conjunto de datos en él.
¿Podría parecer una victoria? Sí, una victoria. Pero hay algo que inquieta. Todo el proceso anterior requiere muchas acciones manuales y no es escalable en absoluto; quisiéramos automatizarlo tanto como sea posible. Este será el tema de la siguiente sección.
Integración con Terraform
Nuevamente utilizaremos la herramienta de HashiCorp llamada . Nos ayudará a desplegar toda la infraestructura de la aplicación con solo pulsar un botón, basándose en varias variables proporcionadas por el usuario. Escribamos una receta que se pueda ejecutar varias veces en diferentes secciones de diferentes usuarios.
Todo el trabajo con Terraform consiste en escribir un archivo de configuración (*.tf) y crear la infraestructura en base a él.
Variables
Al principio del archivo, definiremos las variables de las que dependerá dónde y cómo se desplegará la futura infraestructura.
variable "oauth_token" {
    type = string
    default = ""
}
variable "cloud_id" {
    type = string
    default = ""
}
variable "folder_id" {
    type = string
    default = ""
}
variable "service_account_id" {
    type = string
    default = ""
}
variable "image_id" {
    type = string
    default = ""
}
variable "username" {
    type = string
    default = ""
}
variable "password" {
    type = string
    default = ""
}
variable "dbname" {
    type = string
    default = ""
}
variable "public_key_path" {
    type = string
    default = ""
}
Todo el proceso de despliegue de la aplicación se reducirá a compilar la imagen del disco y establecer estas variables. Explicaré para qué sirven:
oauth_token — token para acceder a la nube. Se puede obtener a través de .
cloud_id — identificador de la nube donde desplegaremos la aplicación.
folder_id — identificador de la sección donde desplegaremos la aplicación
service_account_id — identificador de la cuenta de servicio en la sección correspondiente de la nube.
image_id — identificador de la imagen del disco obtenida con Packer
username y password — nombre de usuario y contraseña para acceder a ambas bases de datos y al servidor web de Grafana
dbname — nombre de la base de datos dentro de los clústeres CH y MySQL
public_key_path — ruta al archivo con su clave ssh pública, que permitirá conectar bajo el nombre ubuntu a máquinas virtuales con servidores web
Configuración del proveedor
Ahora necesitamos configurar el proveedor de Terraform, en nuestro caso Yandex:
provider "yandex" {
  token     = var.oauth_token
  cloud_id  = var.cloud_id
  folder_id = var.folder_id
  zone      = "ru-central1-a"
}
Se puede notar que aquí usamos las variables definidas anteriormente.
Redes y clústeres
Ahora crearemos una red en la que se comunicarán los elementos de nuestra infraestructura, tres subredes (una en cada región) y levantaremos los clústeres CH y MySQL.
recurso "yandex_vpc_network" "grafana_network" {}

recurso "yandex_vpc_subnet" "subnet_a" {
  zona           = "ru-central1-a"
  network_id     = yandex_vpc_network.grafana_network.id
  v4_cidr_blocks = ["10.1.0.0/24"]
}

recurso "yandex_vpc_subnet" "subnet_b" {
  zona           = "ru-central1-b"
  network_id     = yandex_vpc_network.grafana_network.id
  v4_cidr_blocks = ["10.2.0.0/24"]
}

recurso "yandex_vpc_subnet" "subnet_c" {
  zona           = "ru-central1-c"
  network_id     = yandex_vpc_network.grafana_network.id
  v4_cidr_blocks = ["10.3.0.0/24"]
}

recurso "yandex_mdb_clickhouse_cluster" "ch_cluster" {
  nombre        = "grafana-clickhouse"
  entorno = "PRODUCCIÓN"
  network_id  = yandex_vpc_network.grafana_network.id

  clickhouse {
    recursos {
      resource_preset_id = "s2.micro"
      disk_type_id       = "network-ssd"
      disk_size          = 16
    }
  }

  zookeeper {
    recursos {
      resource_preset_id = "s2.micro"
      disk_type_id       = "network-ssd"
      disk_size          = 10
    }
  }

  base de datos {
    nombre = var.dbname
  }

  usuario {
    nombre     = var.username
    contraseña = var.password
    permiso {
      database_name = var.dbname
    }
  }

  host {
    tipo      = "CLICKHOUSE"
    zona      = "ru-central1-a"
    subnet_id = yandex_vpc_subnet.subnet_a.id
  }

  host {
    tipo      = "CLICKHOUSE"
    zona      = "ru-central1-b"
    subnet_id = yandex_vpc_subnet.subnet_b.id
  }

  host {
    tipo      = "CLICKHOUSE"
    zona      = "ru-central1-c"
    subnet_id = yandex_vpc_subnet.subnet_c.id
  }

  host {
    tipo      = "ZOOKEEPER"
    zona      = "ru-central1-a"
    subnet_id = yandex_vpc_subnet.subnet_a.id
  }

  host {
    tipo      = "ZOOKEEPER"
    zona      = "ru-central1-b"
    subnet_id = yandex_vpc_subnet.subnet_b.id
  }

  host {
    tipo      = "ZOOKEEPER"
    zona      = "ru-central1-c"
    subnet_id = yandex_vpc_subnet.subnet_c.id
  }
}

recurso "yandex_mdb_mysql_cluster" "mysql_cluster" {
  nombre        = "grafana_mysql"
  entorno = "PRODUCCIÓN"
  network_id  = yandex_vpc_network.grafana_network.id
  versión     = "8.0"

  recursos {
    resource_preset_id = "s2.micro"
    disk_type_id       = "network-ssd"
    disk_size          = 16
  }

  base de datos {
    nombre = var.dbname
  }

  usuario {
    nombre     = var.username
    contraseña = var.password
    permiso {
      database_name = var.dbname
      roles         = ["TODOS"]
    }
  }

  host {
    zona      = "ru-central1-a"
    subnet_id = yandex_vpc_subnet.subnet_a.id
  }
  host {
    zona      = "ru-central1-b"
    subnet_id = yandex_vpc_subnet.subnet_b.id
  }
  host {
    zona      = "ru-central1-c"
    subnet_id = yandex_vpc_subnet.subnet_c.id
  }
}
Como se puede notar, cada uno de los dos clústeres se ha creado con suficiente tolerancia a fallos al estar distribuidos en tres zonas de disponibilidad.
Servidores web
Podría parecer que se podría continuar de la misma manera, pero me encontré con una dificultad. Hasta ahora, primero levantaba el clúster de MySQL y solo después, conociendo su ID, creaba la imagen del disco con la configuración necesaria, donde indicaba el host al clúster. Pero ahora no conocemos el ID del clúster antes de iniciar Terraform, incluidas las etapas de creación de la imagen. Así que tuve que recurrir al siguiente .
Usando el servicio de metadatos de Amazon, transmitiremos a la máquina virtual algunos parámetros que ella aceptará y procesará. Necesitamos que, después de iniciarse, la máquina consulte los metadatos para el host del clúster MySQL y para el nombre de usuario y contraseña que el usuario especificó en el archivo Terraform. Modificaremos ligeramente el contenido del archivo. setup.sh, que se ejecuta al encender la máquina virtual.
setup.sh:
#!/bin/bash
CLUSTER_URI="$(curl -H 'Metadata-Flavor:Google' http://169.254.169.254/computeMetadata/v1/instance/attributes/mysql_cluster_uri)"
USERNAME="$(curl -H 'Metadata-Flavor:Google' http://169.254.169.254/computeMetadata/v1/instance/attributes/username)"
PASSWORD="$(curl -H 'Metadata-Flavor:Google' http://169.254.169.254/computeMetadata/v1/instance/attributes/password)"
sudo sed -i "s#.*;url =.*#url = mysql://${USERNAME}:${PASSWORD}@${CLUSTER_URI}#" /etc/grafana/grafana.ini
sudo sed -i "s#.*;admin_user =.*#admin_user = ${USERNAME}#" /etc/grafana/grafana.ini
sudo sed -i "s#.*;admin_password =.*#admin_password = ${PASSWORD}#" /etc/grafana/grafana.ini
sudo service grafana-server restart
Grupo de instancias y equilibrador
Al reconstruir la nueva imagen del disco, finalmente podemos escribir nuestro archivo para Terraform.
Especificaremos que queremos usar una imagen de disco existente:
data "yandex_compute_image" "grafana_image" {
  image_id = var.image_id
}
Ahora crearemos el grupo de instancias:
resource "yandex_compute_instance_group" "grafana_group" {
  name               = "grafana-group"
  folder_id          = var.folder_id
  service_account_id = var.service_account_id
  instance_template {
    platform_id = "standard-v1"
    resources {
      memory = 1
      cores  = 1
    }
    boot_disk {
      mode = "READ_WRITE"
      initialize_params {
        image_id = data.yandex_compute_image.grafana_image.id
        size     = 4
      }
    }
    network_interface {
      network_id = yandex_vpc_network.grafana_network.id
      subnet_ids = [yandex_vpc_subnet.subnet_a.id, yandex_vpc_subnet.subnet_b.id, yandex_vpc_subnet.subnet_c.id]
      nat = "true"
    }
    metadata = {
      mysql_cluster_uri = "c-${yandex_mdb_mysql_cluster.mysql_cluster.id}.rw.mdb.yandexcloud.net:3306/${var.dbname}"
      username = var.username
      password = var.password
      ssh-keys = "ubuntu:${file("${var.public_key_path}")}"
    }
    network_settings {
      type = "STANDARD"
    }
  }

  scale_policy {
    fixed_scale {
      size = 6
    }
  }

  allocation_policy {
    zones = ["ru-central1-a", "ru-central1-b", "ru-central1-c"]
  }

  deploy_policy {
    max_unavailable = 2
    max_creating    = 2
    max_expansion   = 2
    max_deleting    = 2
  }

  load_balancer {
    target_group_name = "grafana-target-group"
  }
}
Es importante notar cómo hemos pasado a los metadatos cluster_uri, username y password. Esos serán los que la máquina virtual obtenga al iniciar y los coloque en la configuración de Grafana.
Todo depende del equilibrador.
resource "yandex_lb_network_load_balancer" "grafana_balancer" {
  name = "grafana-balancer"

  listener {
    name = "grafana-listener"
    port = 80
    target_port = 3000
    external_address_spec {
      ip_version = "ipv4"
    }
  }

  attached_target_group {
    target_group_id = yandex_compute_instance_group.grafana_group.load_balancer.0.target_group_id

    healthcheck {
      name = "healthcheck"
      tcp_options {
        port = 3000
      }
    }
  }
}
Un poco de azúcar
Queda sólo una pequeña parte. Después de que la infraestructura se despliegue, será necesario ir a la interfaz de usuario de Grafana y agregar manualmente el clúster CH (ID que aún hay que obtener) como fuente de datos. Pero Terraform conoce el ID del clúster. Le encomendaremos que finalice el trabajo.
Añadiremos un nuevo proveedor: Grafana, y como host le asignaremos la dirección IP del balanceador. Todos los cambios que Terraform realice en la máquina a la que designe el balanceador se reflejarán en MySQL, lo que significa que también afectarán a las demás máquinas.
provider "grafana" {
  url  = "http://${[for s in yandex_lb_network_load_balancer.grafana_balancer.listener: s.external_address_spec.0.address].0}"
  auth = "${var.username}:${var.password}"
}

resource "grafana_data_source" "ch_data_source" {
  type          = "vertamedia-clickhouse-datasource"
  name          = "grafana"
  url           = "https://c-${yandex_mdb_clickhouse_cluster.ch_cluster.id}.rw.mdb.yandexcloud.net:8443"
  basic_auth_enabled = "true"
  basic_auth_username = var.username
  basic_auth_password = var.password
  is_default = "true"
  access_mode = "proxy"
}
Peinaremos
Mostraremos la dirección IP del balanceador y el host del clúster ClickHouse
output "grafana_balancer_ip_address" {
  value = [for s in yandex_lb_network_load_balancer.grafana_balancer.listener: s.external_address_spec.0.address].0
}

output "clickhouse_cluster_host" {
  value = "https://c-${yandex_mdb_clickhouse_cluster.ch_cluster.id}.rw.mdb.yandexcloud.net:8443"
}
Se puede iniciar
¡Eso es todo! Nuestro archivo de configuración está listo y, al establecer las variables, podemos indicarle a Terraform que levante todo lo que hemos descrito anteriormente. Todo el proceso me tomó alrededor de 15 minutos.
Al final, se puede ver un bonito mensaje:
¡Aplicación completa! Recursos: 9 añadidos, 0 cambiados, 0 destruidos.
Salidas:

clickhouse_cluster_host = https://c-c9q14ipa2ngadqsbp2iq.rw.mdb.yandexcloud.net:8443
grafana_balancer_ip_address = 130.193.50.25
Y en la nube se podrán ver los elementos de la infraestructura levantada:
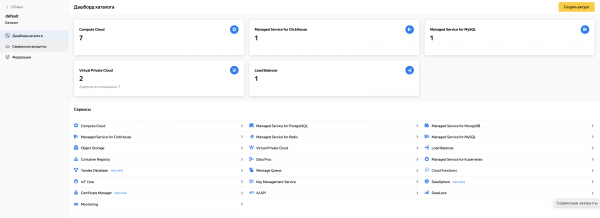
Resumiendo
Ahora, usando el ejemplo de Grafana, cada uno de ustedes sabe cómo desplegar aplicaciones con una arquitectura en la nube en la plataforma Yandex.Cloud. Herramientas útiles de HashiCorp, como Packer y Terraform, pueden ayudar en esto. Espero que este artículo sea útil para alguien 🙂
P.D. A continuación, adjunto un enlace al repositorio donde se pueden encontrar recetas listas para Packer y Terraform, fragmentos de las cuales mencioné en este artículo.
Fuente: habr.com
