

Parte 1: Web / Android
Nota: este artículo es una traducción al español del artículo original. Sin embargo, todas las ilustraciones, enlaces, citas y términos se mantienen en el idioma original para evitar distorsiones en el significado al traducir al español. ¡Les deseo un buen aprendizaje!
Actualmente, la profesión de DevOps es una de las más demandadas en la industria de TI. Si abres sitios web populares de búsqueda de empleo y aplicas un filtro por salarios, verás que las ofertas de trabajo relacionadas con DevOps están al principio de la lista. Sin embargo, es importante entender que esto se refiere principalmente a la posición de 'Senior', lo que implica que el candidato tiene un alto nivel de habilidades, conocimiento de tecnologías y herramientas. Esto también conlleva un alto grado de responsabilidad relacionado con el funcionamiento ininterrumpido de la producción. Sin embargo, hemos empezado a olvidar qué es DevOps. Originalmente, no era una persona específica o un departamento. Si buscamos definiciones de este término, encontraremos muchos sustantivos hermosos y correctos, como metodología, prácticas, filosofía cultural, grupo de conceptos, etc.
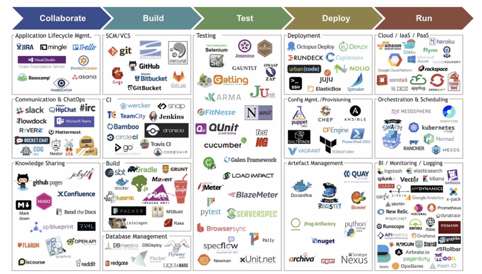
Mi especialización es ingeniero de automatización de pruebas (QA automation engineer), pero creo que no debería estar relacionada solo con la escritura de pruebas automáticas o el desarrollo de la arquitectura del framework de pruebas. En 2020, el conocimiento de la infraestructura de automatización también es necesario. Esto permite organizar el proceso de automatización por cuenta propia, desde la ejecución de pruebas hasta la presentación de resultados a todas las partes interesadas de acuerdo a los objetivos establecidos. Como resultado, las habilidades de DevOps son un factor obligatorio para realizar este trabajo. Y todo esto está bien, pero, lamentablemente, hay un problema (spoiler: este artículo intenta simplificar este problema.). Se trata de que DevOps es complejo. Y es obvio, ya que las empresas no pagarán mucho por algo que es fácil de hacer… En el mundo de DevOps hay una gran cantidad de herramientas, términos y prácticas que se deben dominar. Especialmente al inicio de la carrera, esto puede ser muy difícil y depende de la experiencia técnica acumulada.
Fuente:
Aquí, probablemente, concluiríamos la parte introductoria y nos centraríamos en el objetivo de este artículo.
Sobre qué trata este artículo
En este artículo, compartiré mi experiencia en la construcción de infraestructura para la automatización de pruebas. En internet se pueden encontrar muchas fuentes de información sobre diversas herramientas y cómo utilizarlas, pero me gustaría analizarlas exclusivamente en el contexto de la automatización. Creo que a muchos ingenieros de automatización les resultará familiar la situación en la que las pruebas desarrolladas, además de ustedes mismos, nadie más las ejecuta ni se preocupa por su mantenimiento. Como resultado, las pruebas se vuelven obsoletas y se debe invertir tiempo en actualizarlas. Nuevamente, al comienzo de la carrera, esto puede ser una tarea bastante complicada: decidir acertadamente qué herramientas deben ayudar a resolver este problema, cómo elegirlas, configurarlas y mantenerlas. Algunos testers recurren a la ayuda de DevOps (personas) y, seamos sinceros, este enfoque funciona. En muchos casos, puede ser la única opción, ya que no tenemos visibilidad de todas las dependencias. Pero, como sabemos, DevOps son personas muy ocupadas, ya que deben pensar en la infraestructura de toda la empresa, el deployment, la monitorización, los microservicios y otras tareas similares según la organización/equipo. Como suele suceder, la automatización no es una prioridad. En tal caso, debemos intentar hacer todo lo posible de nuestra parte, desde el principio hasta el final. Esto reducirá las dependencias, acelerará el flujo de trabajo, mejorará nuestras habilidades y nos permitirá ver el panorama más amplio de lo que está sucediendo.
Este artículo presenta las herramientas más demandadas y populares, y muestra cómo utilizarlas para construir paso a paso una infraestructura de automatización. Cada grupo está representado por herramientas que han sido probadas en experiencia personal. Pero esto no significa que debas usar lo mismo. Las herramientas en sí no son importantes, aparecen y desaparecen. Nuestra tarea como ingenieros es entender los principios básicos: por qué necesitamos este grupo de herramientas y qué tareas laborales podemos resolver con su ayuda. Por lo tanto, al final de cada sección dejo enlaces a herramientas similares que quizás se utilicen en tu organización.
Lo que no hay en este artículo
Reitero que este artículo no trata sobre herramientas específicas, por lo que no habrá inserciones de código de la documentación ni descripciones de comandos específicos. Pero al final de cada sección dejo enlaces para un estudio más detallado.
Esto se debe a que:
- este material es muy fácil de encontrar en diversas fuentes (documentación, libros, cursos en video);
- si comenzamos a profundizar, tendremos que escribir 10, 20, 30 partes de este artículo (cuando la idea es 2-3);
- simplemente no quiero gastar tu tiempo, ya que posiblemente quieras usar otras herramientas para alcanzar los mismos objetivos.
Práctica
Me gustaría que este material fuera útil para cada lector y no simplemente leído y olvidado. En cualquier aprendizaje, la práctica es un componente muy importante. Para ello, he preparado. También tendrás trabajo en casa para asegurarte de que no has copiado sin pensar líneas de comandos ejecutados.
Plan
Paso
Tecnología
Ejecución local (preparar pruebas de demostración web / android y ejecutarlas localmente)
1
Node.js, Selenium, Appium
Sistemas de control de versiones
2
Contenerización
Git
3
Docker, Selenium grid, Selenoid (Web, Android)
CI / CD
4
Plataformas en la nube
Gitlab CI
5
Google Cloud Platform
Orquestación
6
Infraestructura como código (IaC)
Kubernetes
7
Terraform, Ansible
Estructura de cada sección
Para mantener la narrativa de manera visual, cada sección se describe según el siguiente plan:
una breve descripción de la tecnología,
- el valor para la infraestructura de automatización,
- ilustración del estado actual de la infraestructura,
- enlaces para estudio,
- herramientas similares.
- 1. Ejecutar pruebas localmente
Breve descripción de la tecnología
Descripción breve de la tecnología
Este es solo un paso preparatorio para iniciar pruebas de demostración localmente y verificar que se ejecutan con éxito. En la parte práctica se utiliza Node.js, pero el lenguaje de programación y la plataforma no son relevantes, y se pueden usar aquellos que se utilizan en su empresa.
Sin embargo, como herramientas de automatización, recomiendo usar Selenium WebDriver para plataformas web y Appium para plataformas Android, respectivamente, ya que en los siguientes pasos utilizaremos imágenes de Docker que están diseñadas específicamente para trabajar con estas herramientas. Además, refiriéndome a los requisitos de las ofertas de trabajo, estas herramientas son las más demandadas en el mercado.
Como habrán notado, solo estamos considerando pruebas web y para Android. Desafortunadamente, iOS es una historia completamente diferente (gracias, Apple). Planeo mostrar soluciones y prácticas relacionadas con iOS en próximas partes.
Valor para la infraestructura de automatización
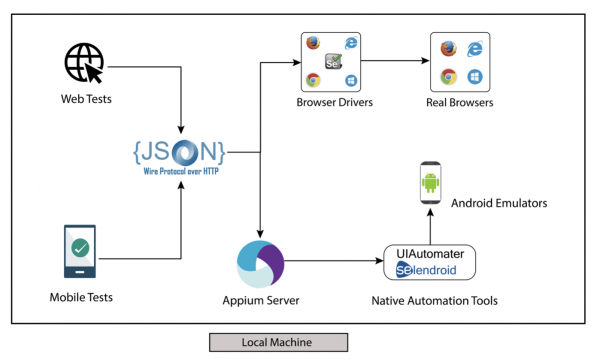
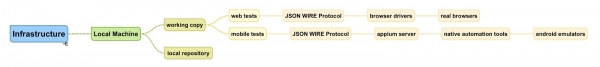
Desde el punto de vista de la infraestructura, la ejecución local no aporta ningún valor. Solo está comprobando que las pruebas funcionan en una máquina local en navegadores y simuladores locales. Pero de todos modos, este es un punto de partida necesario.
Ilustración del estado actual de la infraestructura
Enlaces para estudiar
Herramientas similares
- cualquier lenguaje de programación que te guste, en combinación con Selenium/Appium — pruebas;
- cualquier prueba;
- cualquier corredor de pruebas.
2. Sistemas de control de versiones (Git)
Descripción breve de la tecnología
No será una gran revelación para nadie si digo que un sistema de control de versiones es una parte extremadamente importante del desarrollo, tanto en equipo como individualmente. Basándose en diversas fuentes, se puede afirmar con confianza que Git es el representante más popular. Un sistema de control de versiones ofrece muchas ventajas, como intercambio de código, almacenamiento de versiones, recuperación en ramas anteriores, seguimiento del historial del proyecto y copias de seguridad. No discutiremos cada punto en detalle, ya que estoy seguro de que están bien familiarizados con ello y lo utilizan en su trabajo diario. Pero si por alguna razón no es así, recomiendo interrumpir la lectura de este artículo y llenar esta brecha lo antes posible.
Valor para la infraestructura de automatización
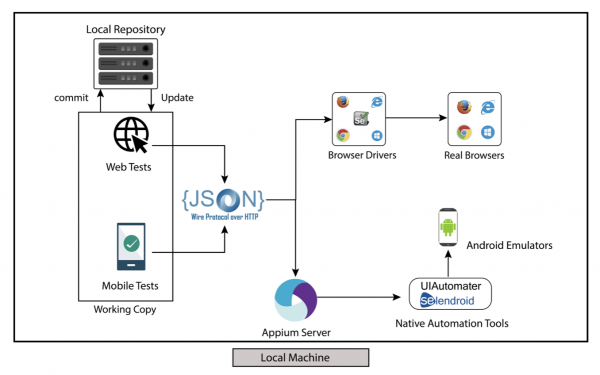
Y aquí pueden hacerse la pregunta razonable: "¿Por qué nos habla de Git? Todos lo conocen y lo utilizan tanto para el desarrollo del código como para el código de pruebas automáticas". Tendrán toda la razón, pero en este artículo hablamos sobre infraestructura y esta sección sirve como un avance para la sección 7: "Infraestructura como código (IaC)". Para nosotros, esto significa que toda la infraestructura, incluida la de prueba, se describe en forma de código, por lo que también podemos aplicar sistemas de control de versiones y obtener ventajas similares a las del desarrollo de código y la automatización.
Analizaremos IaC con más detalle en el paso 7, pero incluso ahora se puede comenzar a usar Git localmente, creando un repositorio local. La vista general se ampliará cuando agreguemos un repositorio remoto a la infraestructura.
Ilustración del estado actual de la infraestructura
Enlaces para estudiar
Herramientas similares
3. Contenerización (Docker)
Descripción breve de la tecnología
Para demostrar cómo la contenerización cambió las reglas del juego, retrocedamos varias décadas. En esos tiempos, las personas adquirían y utilizaban máquinas servidoras para ejecutar aplicaciones. Pero en la mayoría de los casos, los recursos necesarios para la ejecución no eran conocidos de antemano. Como resultado, las empresas gastaban dinero en la compra de servidores potentes y costosos, pero parte de esa capacidad no se utilizaba completamente.
La siguiente etapa de la evolución fueron las máquinas virtuales (VM), que resolvieron el problema de gastar recursos en capacidades no utilizadas. Esta tecnología permitió ejecutar aplicaciones de manera independiente dentro de un servidor, asignando un espacio completamente aislado. Pero, lamentablemente, cualquier tecnología tiene sus inconvenientes. Ejecutar una VM requiere un sistema operativo completo, que consume CPU, RAM, almacenamiento y, dependiendo del sistema operativo, hay que considerar los costos de la licencia. Estos factores afectan la velocidad de arranque y complican la portabilidad.
Y aquí llegamos a la contenerización. De nuevo, esta tecnología resolvió el problema anterior, ya que los contenedores no utilizan un sistema operativo completo, lo que permite liberar una gran cantidad de recursos y proporciona una solución rápida y flexible para la portabilidad.
Por supuesto, la tecnología de contenedorización no es algo nuevo y se presentó por primera vez a finales de los años 70. En ese tiempo se realizaron muchas investigaciones, desarrollos y intentos. Pero fue Docker quien adaptó esta tecnología y la hizo fácilmente accesible para las masas. En la actualidad, cuando hablamos de contenedores, en la mayoría de los casos nos referimos a Docker. Cuando hablamos de contenedores Docker, nos referimos a contenedores de Linux. Podemos usar sistemas Windows y macOS para ejecutar contenedores, pero es importante entender que en este caso aparece una capa adicional. Por ejemplo, Docker en Mac ejecuta contenedores de forma casi imperceptible dentro de una ligera VM de Linux. Regresaremos a este tema cuando discutamos sobre el lanzamiento de emuladores de Android dentro de contenedores, ya que aquí surge un matiz muy importante que debe ser analizado más a fondo.
Valor para la infraestructura de automatización
Hemos determinado que la contenedorización y Docker son geniales. Vamos a mirarlo en el contexto de la automatización, ya que cada herramienta o tecnología debe resolver algún problema. Señalemos los problemas evidentes de la automatización de pruebas en el contexto de las pruebas de UI:
- una gran cantidad de dependencias al instalar Selenium y especialmente Appium;
- problemas de compatibilidad entre versiones de navegadores, simuladores y controladores;
- la falta de un espacio aislado para navegadores/simuladores, lo que es especialmente crítico para la ejecución paralela;
- es difícil de gestionar y mantener si se necesitan ejecutar 10, 50, 100 o incluso 1000 navegadores al mismo tiempo.
Pero dado que Selenium es la herramienta de automatización más popular y Docker es la herramienta de contenedorización más popular, no debería sorprender a nadie que alguien haya intentado combinarlas para obtener una herramienta poderosa que aborde los problemas mencionados. Analicemos estas soluciones más a fondo.
Selenium grid en docker
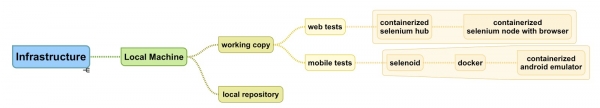
Esta herramienta es la más popular del mundo de Selenium para ejecutar múltiples navegadores en múltiples máquinas y gestionarlos desde un nodo central. Para iniciar, es necesario registrar al menos 2 componentes: Hub y Node(s). Hub es el nodo central que recibe todas las solicitudes de las pruebas y las distribuye entre los Nodes correspondientes. Para cada Node, podemos configurar una configuración específica, como indicar el navegador deseado y su versión. Sin embargo, aún debemos encargarnos de los controladores compatibles para los navegadores e instalarlos en los Nodes necesarios. Por esta razón, Selenium grid no se utiliza en su forma pura, excepto en los casos en que necesitamos trabajar con navegadores que no se pueden instalar en Linux OS. Para todos los demás casos, una solución mucho más flexible y adecuada es utilizar imágenes de Docker para ejecutar el Hub y los Nodes de Selenium grid. Este enfoque facilita enormemente la gestión de los nodos, ya que podemos elegir la imagen que necesitamos con versiones de navegadores y controladores compatibles ya instaladas.
A pesar de las reseñas negativas sobre la estabilidad del funcionamiento, especialmente al ejecutar un gran número de Nodes en paralelo, Selenium grid sigue siendo la herramienta más popular para la ejecución paralela de pruebas Selenium. Es importante destacar que en el código abierto, siempre surgen diversas mejoras y modificaciones de esta herramienta que abordan los diferentes cuellos de botella.
Selenoid para Web
Esta herramienta representa un avance en el mundo de Selenium, ya que funciona nada más sacarla de la caja y ha hecho la vida de muchos ingenieros en automatización significativamente más fácil. Primero que nada, no es una simple modificación de Selenium Grid. En su lugar, los desarrolladores han creado una versión completamente nueva de Selenium Hub en el lenguaje Golang, lo que, combinado con imágenes de Docker ligeras para diferentes navegadores, ha impulsado el desarrollo de la automatización de pruebas. Además, en el caso de Selenium Grid, debemos definir todos los navegadores requeridos y sus versiones por adelantado, lo que no es un problema cuando se trabaja solo con un único navegador. Pero cuando se trata de varios navegadores compatibles, Selenoid se convierte en la solución número uno, gracias a la función de 'navegador bajo demanda'. Todo lo que necesitamos hacer es descargar las imágenes necesarias con los navegadores y actualizar el archivo de configuración con el que interactúa Selenoid. Después de que Selenoid reciba una solicitud de las pruebas, automáticamente iniciará el contenedor requerido con el navegador correspondiente. Cuando la prueba finalice, Selenoid detendrá el contenedor, liberando así recursos para futuras solicitudes. Este enfoque elimina por completo el conocido problema de 'degradación de nodos', que a menudo encontramos en Selenium Grid.
Pero, lamentablemente, Selenoid aún no es la solución mágica. Hemos obtenido la función de 'navegador bajo demanda', pero la función de 'recursos bajo demanda' aún no está disponible. Para utilizar Selenoid, debemos desplegarlo en hardware físico o en una VM, lo que significa que debemos saber de antemano cuántos recursos necesitamos asignar. Creo que esto no es un problema para proyectos pequeños que ejecutan 10, 20 o incluso 30 navegadores en paralelo. Pero, ¿qué pasa si necesitamos 100, 500, 1000 o más? No tiene sentido mantener y pagar por una cantidad tan grande de recursos de forma constante. En las secciones 5 y 6 de este artículo discutiremos soluciones que permiten escalar, reduciendo así significativamente los costos de la empresa.
Selenoid para Android
Después del éxito de Selenoid como herramienta para la automatización web, la gente quería algo similar para Android. Y esto se ha logrado: Selenoid ha sido lanzado con soporte para Android. Desde un punto de vista del usuario de alto nivel, el principio de funcionamiento es similar al de la automatización web. La única diferencia es que, en lugar de contenedores con navegadores, Selenoid inicia contenedores con emuladores de Android. En mi opinión, en este momento, esta es la herramienta gratuita más poderosa para ejecutar pruebas de Android en paralelo.
No me gustaría hablar de los aspectos negativos de esta herramienta, ya que realmente me gusta mucho. Sin embargo, existen las mismas desventajas que se relacionan con la automatización web, relacionadas con la escalabilidad. Además, hay que mencionar otra limitación que puede ser una sorpresa si configuramos la herramienta por primera vez. Para ejecutar imágenes de Android, necesitamos una máquina física o un VM con soporte de virtualización anidada. En la guía práctica, demuestro cómo activarlo en un VM de Linux. Sin embargo, si eres usuario de macOS y deseas desplegar Selenoid localmente, no será posible ejecutar pruebas de Android. Pero siempre puedes ejecutar un VM de Linux localmente con la 'virtualización anidada' configurada y desplegar Selenoid dentro.
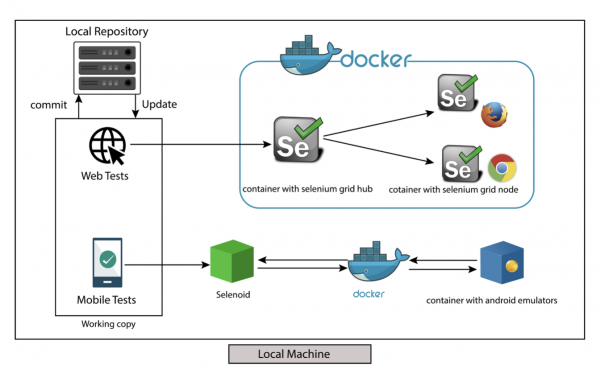
Ilustración del estado actual de la infraestructura
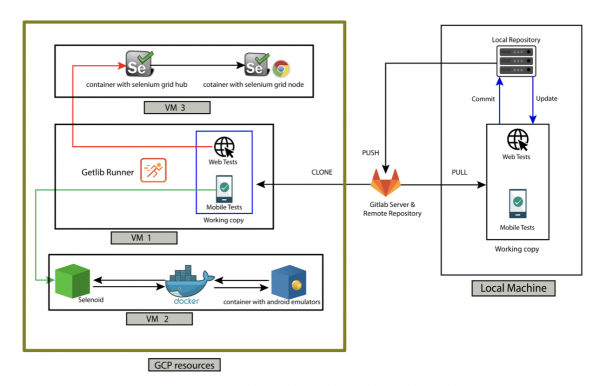
En el contexto de este artículo, añadiremos 2 herramientas para ilustrar la infraestructura. Estas son Selenium Grid para pruebas web y Selenoid para pruebas de Android. En la guía en GitHub, también mostraré cómo usar Selenoid para ejecutar pruebas web.
Enlaces para estudiar
Herramientas similares
- Existen otras herramientas de contenedorización, pero Docker es la más popular. Si deseas probar algo diferente, ten en cuenta que las herramientas que hemos revisado para la ejecución paralela de pruebas de Selenium no funcionarán de inmediato.
- Como se mencionó, hay muchas modificaciones de Selenium Grid, por ejemplo,.
4. CI / CD
Descripción breve de la tecnología
La práctica de la integración continua es bastante popular en el desarrollo y se encuentra a la par con los sistemas de control de versiones. Sin embargo, siento que hay confusión en la terminología. En este párrafo, me gustaría describir tres modificaciones de esta tecnología desde mi punto de vista. En Internet, encontrarás muchos artículos con diversas interpretaciones, y está absolutamente bien si tu opinión difiere. Lo más importante es que estés en sintonía con tus colegas.
Entonces, existen tres términos: CI — Continuous Integration (integración continua), CD — Continuous Delivery (entrega continua) y nuevamente CD — Continuous Deployment (despliegue continuo). (A partir de ahora usaré estos términos en inglés.). Cada modificación añade varios pasos adicionales a tu canal de desarrollo. Pero la palabra continuous (continua) es la más importante. En este contexto, nos referimos a algo que sucede de principio a fin, sin interrupciones o intervención manual. Vamos a revisar CI & CD y CD en este contexto.
- Continuous Integration – es el primer paso de la evolución. Tras enviar nuevo código al servidor, esperamos recibir una rápida retroalimentación de que nuestros cambios son correctos. Por lo general, CI incluye la ejecución de herramientas de análisis estático de código y pruebas de módulos/API internas. Esto permite obtener información sobre nuestro código en cuestión de segundos/minutos.
- Entrega Continua es un paso más avanzado, en el que ejecutamos pruebas de integración/UI. Sin embargo, en esta etapa no obtendremos resultados tan rápidamente como en el caso de CI. En primer lugar, estos tipos de pruebas requieren más tiempo para completarse. En segundo lugar, antes de ejecutar, debemos desplegar nuestros cambios en un entorno de test/staging. Además, si hablamos de desarrollo móvil, hay un paso adicional para crear la compilación de nuestra aplicación.
- Continuous Deployment implica que automáticamente lanzamos (release) nuestros cambios en producción si todas las pruebas de aceptación han pasado en las etapas anteriores. Además, después de la etapa de release, se pueden configurar diferentes etapas, como la ejecución de pruebas smoke en producción y la recopilación de métricas relevantes. El Continuous Deployment es posible solo con una buena cobertura de pruebas automatizadas. Si se requieren intervenciones manuales, incluida la prueba, entonces ya no es Continuo (continuo). Entonces podemos decir que nuestro pipeline solo se ajusta a la práctica de Continuous Delivery.
Valor para la infraestructura de automatización
En esta sección debo aclarar que, cuando hablamos de pruebas de UI de extremo a extremo, implica que debemos desplegar nuestros cambios y servicios relacionados en entornos de prueba. El proceso de Continuous Integration no es aplicable para esta tarea y debemos asegurarnos de implementar al menos prácticas de Continuous Delivery. Continuous Deployment también tiene sentido en el contexto de las pruebas de UI, si planeamos ejecutarlas en producción.
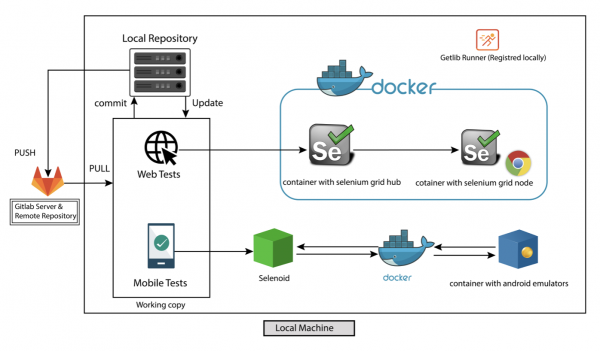
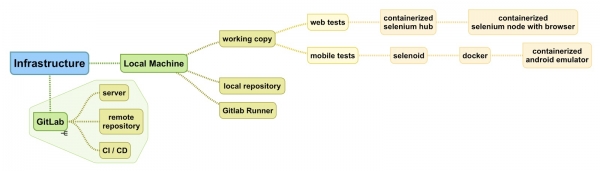
Y antes de que observemos la ilustración del cambio de arquitectura, quiero decir algunas palabras sobre GitLab CI. A diferencia de otras herramientas de CI/CD, GitLab proporciona un repositorio remoto y muchas otras funciones adicionales. Así, GitLab es más que CI. Incluye gestión de código fuente, gestión ágil, pipelines de CI/CD, herramientas de registro y recopilación de métricas. La arquitectura de GitLab consta de GitLab CI/CD y GitLab Runner. A continuación, una breve descripción de su sitio oficial:
Gitlab CI/CD es una aplicación web con una API que almacena su estado en una base de datos, gestiona proyectos/construcciones y proporciona una interfaz de usuario. GitLab Runner es una aplicación que procesa las construcciones. Se puede desplegar de forma independiente y trabaja con GitLab CI/CD a través de una API. Para ejecutar pruebas, se necesita tanto la instancia de Gitlab como el Runner.
Ilustración del estado actual de la infraestructura
Enlaces para estudiar
Herramientas similares
- Y muchos otros
5. Plataformas en la nube
Descripción breve de la tecnología
En esta sección, hablaremos de una tendencia popular llamada ‘nubes públicas’. A pesar de los enormes beneficios que ofrecen las tecnologías de virtualización y contenedorización descritas anteriormente, aún necesitamos recursos computacionales. Las empresas adquieren servidores costosos o alquilan centros de datos, pero en ese caso es necesario hacer cálculos (a veces poco realistas) sobre cuántos recursos necesitaremos, si los utilizaremos 24/7 y para qué fines. Por ejemplo, para producción se requiere un servidor que funcione las 24 horas, pero ¿necesitamos recursos similares para pruebas fuera de horario laboral? Esto también depende del tipo de pruebas que se realicen. Un ejemplo pueden ser las pruebas de carga/estrés, que planeamos ejecutar en horas no laborables para obtener resultados al día siguiente. Sin embargo, definitivamente no se requiere disponibilidad continua de servidores para las pruebas automatizadas end-to-end y especialmente para los entornos de pruebas manuales. Para tales situaciones, sería ideal obtener solo los recursos necesarios bajo demanda, utilizarlos y dejar de pagar cuando ya no se necesiten. Además, sería genial obtenerlos de inmediato, con solo unos clics del mouse o ejecutando un par de scripts. Para eso se utilizan las nubes públicas. Veamos la definición:
«La nube pública se define como servicios de computación ofrecidos por proveedores externos a través de Internet público, haciéndolos disponibles para cualquier persona que desee usarlos o comprarlos. Pueden ser gratuitos o vendidos bajo demanda, permitiendo a los clientes pagar solo por el uso de los ciclos de CPU, almacenamiento o ancho de banda que consumen».
Se dice que las nubes públicas son caras. Pero su idea clave es la reducción de costos para la empresa. Como se mencionó anteriormente, las nubes públicas permiten obtener recursos bajo demanda y pagar solo por el tiempo que se utilizan. Además, a veces olvidamos que los empleados reciben un salario, y los especialistas también son un recurso costoso. Es importante tener en cuenta que las nubes públicas facilitan enormemente el soporte de la infraestructura, lo que permite a los ingenieros concentrarse en tareas más importantes.
Valor para la infraestructura de automatización
¿Qué recursos específicos necesitamos para pruebas de UI end-to-end? Principalmente, se trata de máquinas virtuales o clústeres (hablaremos de Kubernetes en la siguiente sección) para ejecutar navegadores y emuladores. Cuantos más navegadores y emuladores queramos ejecutar simultáneamente, más CPU y memoria se requieren, y más dinero tendremos que pagar por ello. Así, las nubes públicas en el contexto de la automatización de pruebas nos permiten lanzar un gran número (100, 200, 1000…) de navegadores/emuladores bajo demanda, obtener resultados de pruebas lo más rápido posible y dejar de pagar por esas locas capacidades que consumen recursos.
Los proveedores de nube más populares son Amazon Web Services (AWS), Microsoft Azure y Google Cloud Platform (GCP). En la guía práctica se presentan ejemplos de uso de GCP, pero en general no importa qué utilices para tareas de automatización. Todos ofrecen aproximadamente la misma funcionalidad. Normalmente, para elegir un proveedor, la guía se centra en toda la infraestructura de la empresa y los requisitos comerciales, lo cual está fuera del alcance de este artículo. Para los ingenieros de automatización, será más interesante comparar el uso de proveedores de nube con el uso de plataformas en la nube específicamente para propósitos de prueba, como Sauce Labs, BrowserStack, BitBar, etc. ¡Así que hagámoslo! En mi opinión, Sauce Labs es la granja de pruebas en la nube más conocida, por eso la elegí para la comparación.
GCP frente a Sauce Labs para propósitos de automatización:
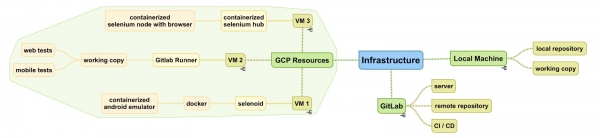
Imaginemos que necesitamos ejecutar simultáneamente 8 pruebas web y 8 pruebas de Android. Para ello, utilizaremos GCP y lanzaremos 2 máquinas virtuales con Selenoid. En la primera levantaremos 8 contenedores con navegadores. En la segunda, 8 contenedores con emuladores. Veamos los precios:
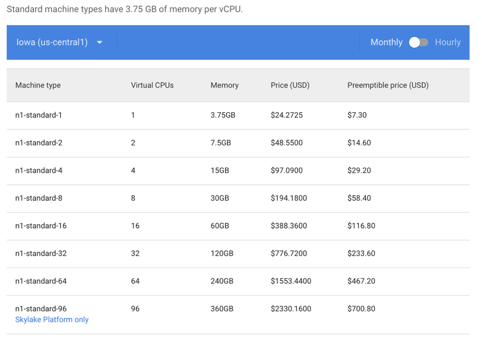
Para ejecutar un contenedor con Chrome, necesitaremos n1-standard-1 máquina. En el caso de Android, será n1-standard-4 por un emulador. En realidad, un método más flexible y económico es asignar valores específicos de usuario para CPU/Memoria, pero en este momento para la comparación con Sauce Labs no es fundamental.
Aquí están las tarifas para el uso de Sauce Labs:
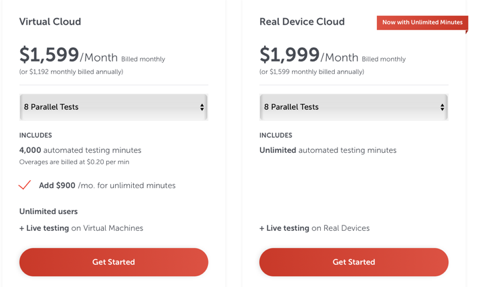
Supongo que ya has notado la diferencia, pero aún así presentaré una tabla con cálculos para nuestra tarea:
Recursos requeridos
Mensual
Horas laborables(8 a.m — 8 p.m)
Horas laborables+ Preemptible
GCP para Web
n1-standard-1 x 8 = n1-standard-8
$194.18
23 días * 12h * 0.38 = 104.88$
23 días * 12h * 0.08 = 22.08$
Sauce Labs para Web
Pruebas paralelas en Virtual Cloud8
$1.559
—
—
GCP para Android
n1-standard-4 x 8: n1-standard-16
$776.72
23 días * 12h * 1.52 = 419.52$
23 días * 12h * 0.32 = 88.32$
Sauce Labs para Android
Pruebas paralelas en Real Device Cloud
$1.999
—
—
Como se puede ver, la diferencia en costos es enorme, especialmente si se ejecutan pruebas solo en un intervalo de trabajo de doce horas. Pero aún se pueden reducir más los gastos si se utilizan instancias preemptibles. ¿Qué son exactamente?
Una VM preemptible es una instancia que puedes crear y ejecutar a un precio mucho más bajo que las instancias normales. Sin embargo, el Compute Engine puede terminar (preemptar) estas instancias si necesita acceso a esos recursos para otras tareas. Las instancias preemptibles son capacidad excedente del Compute Engine, por lo que su disponibilidad varía según el uso.
Si tus aplicaciones son tolerantes a fallos y pueden soportar posibles preemptiones de instancias, entonces las instancias preemptibles pueden reducir significativamente tus costos de Compute Engine. Por ejemplo, los trabajos de procesamiento por lotes pueden ejecutarse en instancias preemptibles. Si algunas de esas instancias se terminan durante el procesamiento, el trabajo se ralentiza pero no se detiene completamente. Las instancias preemptibles completan tus tareas de procesamiento por lotes sin añadir una carga adicional a tus instancias existentes y sin requerir que pagues el precio completo por instancias normales adicionales.
¡Y esto aún no es todo! En realidad, estoy seguro de que nadie ejecuta pruebas durante 12 horas seguidas. Y si es así, puedes iniciar y detener automáticamente las máquinas virtuales cuando no se necesitan. El tiempo real de uso puede reducirse a 6 horas al día. Entonces, el pago en el contexto de nuestra tarea disminuiría hasta 11$ al mes por 8 navegadores. ¿No es maravilloso? Pero con las máquinas preemptibles debemos tener cuidado y estar listos para interrupciones y funcionamiento inestable, aunque estas situaciones pueden prever y manejarse programáticamente. ¡Vale la pena!
Pero de ninguna manera estoy diciendo 'nunca uses granjas de pruebas en la nube'. Tienen varias ventajas. Primero, no es solo una máquina virtual, sino una solución completa para la automatización de pruebas con un conjunto de funcionalidades listas para usar: acceso remoto, registros, capturas de pantalla, grabación de video, diferentes navegadores y dispositivos móviles físicos. En muchas situaciones, esto puede ser una alternativa lujosa e insustituible. Especialmente las plataformas de prueba son útiles para la automatización de IOS, cuando las nubes públicas solo pueden ofrecer sistemas Linux/Windows. Pero la conversación sobre IOS será en próximos artículos. Recomiendo siempre evaluar la situación y basarse en las tareas: en algunos casos es más barato y efectivo utilizar nubes públicas, mientras que en otros las plataformas de prueba definitivamente valen el dinero gastado.
Ilustración del estado actual de la infraestructura
Enlaces para estudiar
Herramientas Similares:
6. Orquestación
Descripción breve de la tecnología
Tengo buenas noticias: ¡estamos casi al final del artículo! En este momento, nuestra infraestructura de automatización consiste en pruebas web y de Android que ejecutamos a través de GitLab CI en paralelo, utilizando herramientas que soportan Docker: Selenium grid y Selenoid. Además, utilizamos máquinas virtuales creadas a través de GCP para levantar contenedores con navegadores y emuladores. Para reducir costos, solo ejecutamos estas máquinas virtuales bajo demanda y las detenemos cuando no se realizan pruebas. ¿Hay algo más que pueda mejorar nuestra infraestructura? ¡La respuesta es sí! ¡Damos la bienvenida a Kubernetes (K8s)!
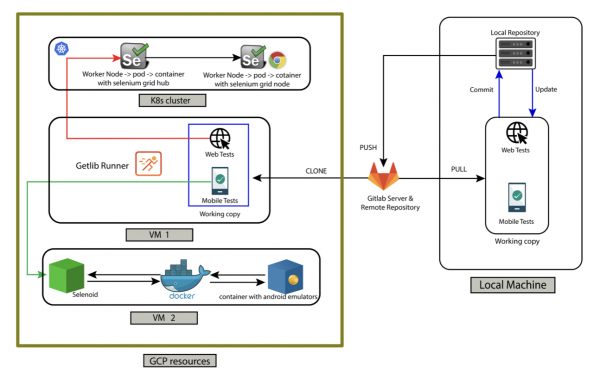
Primero, analicemos cómo las palabras orquestación, clúster y Kubernetes están interrelacionadas. A alto nivel, la orquestación es un sistema que despliega y gestiona aplicaciones. Para la automatización de pruebas, estas aplicaciones contenerizadas son Selenium grid y Selenoid. Docker y K8s se complementan entre sí. Docker se utiliza para desplegar aplicaciones, mientras que K8s es para la orquestación. A su vez, K8s es un clúster. La tarea del clúster es utilizar VMs como nodos, lo que permite instalar diversas funcionalidades, programas y servicios dentro de un mismo servidor (clúster). Si alguna de las nodos falla, otras nodos asumirán, lo que garantiza la operación ininterrumpida de nuestra aplicación. Además, K8s tiene una funcionalidad importante relacionada con el escalado (scaling), permitiendo que automáticamente obtengamos la cantidad óptima de recursos según la carga y las limitaciones establecidas.
La verdad es que desplegar Kubernetes manualmente desde cero es una tarea bastante complicada. Dejaré un enlace a una conocida guía práctica, "Kubernetes The Hard Way", y si te interesa, puedes practicar. Pero, afortunadamente, existen métodos e herramientas alternativas. La más sencilla es usar Google Kubernetes Engine (GKE) en GCP, lo que permitirá obtener un clúster listo después de unos pocos clics. Para comenzar a aprender, recomiendo seguir este enfoque, ya que te permitirá enfocarte en cómo utilizar K8s para tus tareas en lugar de investigar cómo deben integrarse internamente los componentes.
Valor para la infraestructura de automatización
Veamos algunas funciones significativas que ofrece K8s:
- despliegue de la aplicación: uso de un clúster de múltiples nodos, en lugar de VMs;
- escalamiento dinámico: reduce los gastos en recursos que se utilizan solo bajo demanda;
- auto-recuperación (Self-healing): recuperación automática de pods (lo que restaura también los contenedores);
- implementación de actualizaciones y retrocesos sin tiempo de inactividad: la actualización de herramientas, navegadores y emuladores no interrumpe el trabajo de los usuarios actuales.
Pero K8s aún no es una solución milagrosa. Para entender todos los beneficios y limitaciones en el contexto de las herramientas que estamos considerando (Selenium grid, Selenoid), discutamos brevemente la estructura de K8s. El clúster contiene dos tipos de Nodos: Nodos Maestros y Nodos Trabajadores. Los Nodos Maestros son responsables de la gestión, el despliegue y las decisiones de programación. Los Nodos Trabajadores son donde las aplicaciones están en ejecución. Los Nodos también contienen el entorno de ejecución de contenedores. En nuestro caso, es Docker, que se encarga de las operaciones relacionadas con los contenedores. Pero también hay soluciones alternativas, como. Es importante entender que el escalamiento o la auto-recuperación no se aplica directamente a los contenedores. Esto se implementa mediante la adición/reducción del número de pods, que a su vez contienen contenedores (generalmente un contenedor por pod, pero dependiendo de la tarea puede haber más). La jerarquía de alto nivel representa los nodos trabajadores, dentro de los cuales están los pods, y dentro de los cuales se ejecutan los contenedores.
La función de escalado es clave y se puede aplicar tanto a los nodos dentro del grupo de nodos del clúster como a los pods dentro del nodo. Existen dos tipos de escalado que se aplican tanto a los nodos como a los pods. El primer tipo es el escalado horizontal, que se produce mediante el aumento del número de nodos/pods. Este tipo es más preferido. El segundo tipo, por lo tanto, es el escalado vertical. El escalado se lleva a cabo aumentando el tamaño de los nodos/pods en lugar de su cantidad.
Ahora consideremos nuestras herramientas en el contexto de los términos mencionados anteriormente.
Selenium grid
Como se mencionó anteriormente, Selenium grid es una herramienta muy popular, y no es sorprendente que haya sido contenedorizada. Por lo tanto, no sorprende que Selenium grid se pueda implementar en K8s. Un ejemplo de cómo hacerlo se puede encontrar en el repositorio oficial de K8s. Como de costumbre, adjunto enlaces al final de la sección. Además, en la guía práctica se muestra cómo hacerlo a través de Terraform. También hay instrucciones sobre cómo escalar el número de pods que contienen contenedores con navegadores. Pero la función de escalado automático en el contexto de K8s sigue siendo una tarea aún no completamente clara. Cuando comencé a estudiar, no encontré ninguna guía práctica o recomendaciones. Después de varias investigaciones y experimentos con el apoyo del equipo de DevOps, elegimos el enfoque de levantar contenedores con los navegadores necesarios dentro de un pod, que se encuentra dentro de un nodo trabajador. Este método nos permite aplicar la estrategia de escalado horizontal de nodos aumentando su número. Espero que en el futuro la situación cambie y veamos más y más descripciones de los mejores enfoques y soluciones listas, especialmente después del lanzamiento de Selenium grid 4 con la arquitectura interna modificada.
Selenoid:
Actualmente, desplegar Selenoid en K8s es la mayor decepción. No son compatibles. Teóricamente, podemos levantar un contenedor de Selenoid dentro de un pod, pero cuando Selenoid comience a ejecutar contenedores con navegadores, seguirán estando dentro de ese mismo pod. Esto hace imposible el escalado y, como resultado, el funcionamiento de Selenoid dentro del clúster no será diferente del funcionamiento dentro de una máquina virtual. Fin de la historia.
Moon:
Sabiendo esto, los desarrolladores lanzaron una herramienta más potente llamada Moon. Esta herramienta fue concebida originalmente para trabajar con Kubernetes y, como resultado, se puede y debe utilizar la función de autoescalado. Además, diría que en este momento es la única la herramienta más potente en el mundo de Selenium, que viene con soporte nativo para clústeres de K8s (ya no, ver la siguiente herramienta ). La característica clave de Moon, que proporciona este soporte, es la siguiente:
Completamente sin estado. Selenoid almacena en memoria información sobre las sesiones de navegador que se están ejecutando actualmente. Si por alguna razón su proceso se bloquea, se pierden todas las sesiones en ejecución. Moon, en cambio, no tiene estado interno y puede ser replicado en centros de datos. Las sesiones de navegador permanecen activas incluso si una o más réplicas fallan.
Así que Moon es una solución impresionante, pero con un problema: no es gratuita. El precio depende del número de sesiones. Se pueden ejecutar de forma gratuita solo de 0 a 4 sesiones, lo cual no es muy útil. Pero, a partir de la quinta sesión, hay que pagar $5 por cada una. La situación puede variar de una empresa a otra, pero en nuestro caso, el uso de Moon es innecesario. Como describí anteriormente, podemos desplegar VMs con Selenium Grid según sea necesario o aumentar el número de nodos en el clúster. Aproximadamente, para un pipeline activamos 500 navegadores y detenemos todos los recursos después de finalizar las pruebas. Si hubiéramos usado Moon, tendríamos que pagar 500 x 5 = 2500 $ al mes, sin importar cuán frecuentemente ejecutemos las pruebas. Y de nuevo, no estoy diciendo 'no uses Moon'. Para tus necesidades, podría ser una solución invaluable, por ejemplo, si tienes muchos proyectos/equipos en la organización y necesitas un gran clúster común para todos. Como siempre, dejo un enlace al final y recomiendo hacer todos los cálculos necesarios en el contexto de tu tarea.
Callisto: (¡Atención! Esto no está en el artículo original y se encuentra solo en la traducción al ruso)
Como mencioné, Selenium es una herramienta muy popular y el campo de TI está evolucionando rápidamente. Mientras trabajaba en la traducción, apareció una nueva herramienta prometedora llamada Callisto (saludos a Cypress y otros competidores de Selenium). Funciona de manera nativa con K8s y permite ejecutar contenedores Selenoid en pods, distribuidos en Nodes. Todo funciona de inmediato, incluyendo la autoescalabilidad. Fantástico, pero necesita pruebas. Ya he logrado implementar esta herramienta y realizar algunos experimentos. Pero aún es pronto para sacar conclusiones; después de obtener resultados a largo plazo, posiblemente haga una revisión en próximos artículos. Por ahora, solo dejo enlaces para investigaciones personales.
Ilustración del estado actual de la infraestructura
Enlaces para estudiar
Enlaces para estudiar
Herramientas similares
7. Infraestructura como código (IaC)
Descripción breve de la tecnología
Y así llegamos a la última sección. Generalmente, esta tecnología y las tareas relacionadas no están bajo la responsabilidad de los ingenieros de automatización. Y hay razones para esto. En primer lugar, en muchas organizaciones, los problemas de infraestructura están bajo el control del departamento de DevOps, y el equipo de desarrollo no se preocupa mucho por lo que sostiene el pipeline y cómo se debe mantener todo lo relacionado. En segundo lugar, seamos honestos, la práctica de "Infraestructura como código (IaC)" aún no se aplica en muchas empresas. Pero definitivamente se ha convertido en una tendencia popular y es importante intentar estar involucrado en los procesos, enfoques y herramientas relacionados. O, al menos, estar al tanto de lo que sucede.
Empecemos con la motivación para usar este enfoque. Ya hemos discutido que para ejecutar pruebas en GitlabCI necesitamos al menos recursos para ejecutar el Gitlab Runner. Y para iniciar contenedores con navegadores/emuladores, debemos reservar una VM o un clúster. Además de los recursos para pruebas, necesitamos una cantidad significativa de potencia para mantener los entornos de desarrollo, staging, producción, lo que también incluye bases de datos, horarios automáticos, configuraciones de red, balanceadores de carga, permisos de usuarios, etc. El problema clave radica en los esfuerzos requeridos para mantener todo esto. Hay varias maneras en que podemos realizar cambios y desplegar actualizaciones. Por ejemplo, en el contexto de GCP, podemos utilizar la consola de UI en el navegador y realizar todas las acciones haciendo clic en botones. Un método alternativo podría ser el uso de llamadas API para interactuar con entidades en la nube o el uso de la utilidad de línea de comandos gcloud para realizar las manipulaciones necesarias. Pero con una cantidad realmente grande de diferentes entidades y elementos de infraestructura, se vuelve difícil o incluso imposible realizar todas las operaciones manualmente. Además, todas estas acciones manuales son incontroladas. No podemos enviarlas para revisión antes de su ejecución, utilizar un sistema de control de versiones y revertir rápidamente cambios que condujeron a un incidente. Para resolver tales problemas, los ingenieros han creado y siguen creando scripts automáticos en bash/shell, lo que no es mucho mejor que los métodos anteriores, ya que no son tan fáciles de leer, entender, mantener y modificar rápidamente en un estilo procedimental.
En este artículo y guía práctica, utilizo dos herramientas relacionadas con la práctica de IaC. Estas son Terraform y Ansible. Algunos creen que no tiene sentido usarlas al mismo tiempo, ya que sus funcionalidades son similares y son intercambiables. Sin embargo, el hecho es que inicialmente se les asignan tareas completamente diferentes. Y el hecho de que estas herramientas deberían complementarse fue confirmado en una presentación conjunta por desarrolladores de HashiCorp y RedHat. La diferencia conceptual radica en que Terraform es una herramienta de aprovisionamiento para gestionar los propios servidores. Mientras que Ansible es una herramienta de gestión de configuraciones, encargada de instalar, configurar y gestionar el software en esos servidores.
Otra característica clave que distingue a estas herramientas es el estilo de escritura del código. A diferencia de bash y Ansible, Terraform utiliza un estilo declarativo, basado en la descripción del estado final deseado que se debe alcanzar como resultado de su ejecución. Por ejemplo, si estamos a punto de crear 10 VMs y aplicar cambios a través de Terraform, obtendremos 10 VMs. Si aplicamos el script nuevamente, no sucederá nada, ya que ya tenemos 10 VMs, y Terraform lo sabe porque almacena el estado actual de la infraestructura en un archivo de estado. En cambio, Ansible utiliza un enfoque procedural y, si le pedimos que cree 10 VMs, en la primera ejecución obtendremos 10 VMs, de manera similar a Terraform. Pero tras una segunda ejecución, ya tendremos 20 VMs. Esta es la importante diferencia. En el estilo procedural, no almacenamos el estado actual y simplemente describimos la secuencia de pasos que deben llevarse a cabo. Por supuesto, podemos manejar diversas situaciones, agregar algunas comprobaciones sobre la existencia de recursos y su estado actual, pero no tiene sentido gastar nuestro tiempo y esforzarnos en controlar esta lógica. Además, esto aumenta el riesgo de cometer errores.
Resumiendo todo lo anterior, se puede concluir que para el aprovisionamiento de servidores, la herramienta más adecuada es Terraform y la notación declarativa. Por otro lado, el trabajo de gestión de configuraciones es mejor delegarlo a Ansible. Una vez aclarado esto, veamos ejemplos de uso en el contexto de la automatización.
Valor para la infraestructura de automatización
Aquí es importante entender que la infraestructura de automatización de pruebas debe considerarse como parte de toda la infraestructura de la empresa. Eso significa que todas las prácticas de IaC deben aplicarse de manera global a los recursos de toda la organización. Quién es responsable de esto depende de sus procesos. El equipo de DevOps tiene más experiencia en estos temas, ya que ve la situación en su totalidad. Sin embargo, los ingenieros de QA están más involucrados en el proceso de construcción de la automatización y la estructura del pipeline, lo que les permite identificar mejor todos los cambios necesarios y las oportunidades de mejora. La mejor opción es trabajar juntos, intercambiar conocimientos e ideas para lograr el resultado esperado.
Voy a dar algunos ejemplos del uso de Terraform y Ansible en el contexto de la automatización de pruebas y las herramientas que hemos discutido anteriormente:
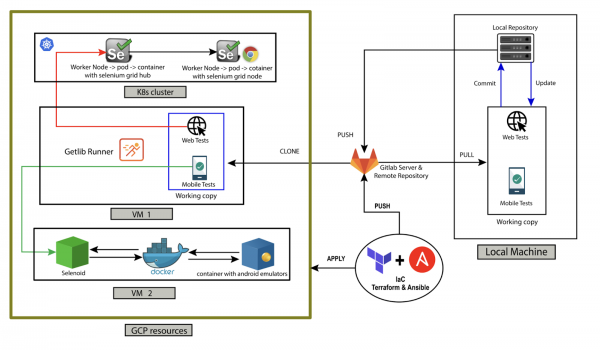
1. Describir a través de Terraform las características y parámetros necesarios de las VMs y clústeres.
2. Instalar con Ansible las herramientas necesarias para la prueba: docker, Selenoid, Selenium Grid y cargar las versiones necesarias de navegadores/emuladores.
3. Describir a través de Terraform las características de la VM en la que se ejecutará GitLab Runner.
4. Instalar con Ansible GitLab Runner y las herramientas auxiliares necesarias, establecer configuraciones y ajustes.
Ilustración del estado actual de la infraestructura
Enlaces para estudiar:
Herramientas similares
¡Hagamos un resumen!
Paso
Tecnología
Ejecución local (preparar pruebas de demostración web / android y ejecutarlas localmente)
Valor para la infraestructura de automatización
1
Ejecución local
Sistemas de control de versiones
- Las herramientas más populares para web y móvil
- Soporte para muchos lenguajes y plataformas (incluyendo Node.js)
2
Contenerización
Git
- Ventajas similares con el código de desarrollo
3
Docker, Selenium grid, Selenoid (Web, Android)
CI / CD
- Ejecución paralela de pruebas
- Entornos aislados
- Actualización de versiones simple y flexible
- Detención dinámica de recursos no utilizados
- Fácil de configurar
4
Plataformas en la nube
Gitlab CI
- Las pruebas son parte del pipeline
- Retroalimentación rápida
- Visibilidad para toda la empresa/equipo
5
Google Cloud Platform
Orquestación
- Recursos bajo demanda (pagamos solo cuando son necesarios)
- Fácil de administrar y actualizar
- Visibilidad y control de todos los recursos
6
Infraestructura como código (IaC)
Kubernetes
En el contexto de contenedores con navegadores/emuladores dentro de pods:
- Escalamiento / escalado automático
- Auto-recuperación
- Actualizaciones y retrocesos sin interrupciones
7
Terraform, Ansible
Estructura de cada sección
- Ventajas similares con la infraestructura de desarrollo
- Todas las ventajas del versionado del código
- Fácil de realizar cambios y mantener
- Totalmente automatizado
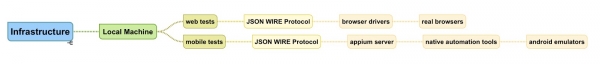
Diagramas de mapas mentales: la evolución de la infraestructura
paso1: Local
paso2: VCS
paso3: Contenerización
paso4: CI/CD
paso5: Plataformas en la nube
paso6: Orquestación
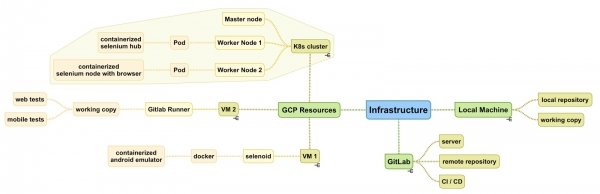
paso7: IaC
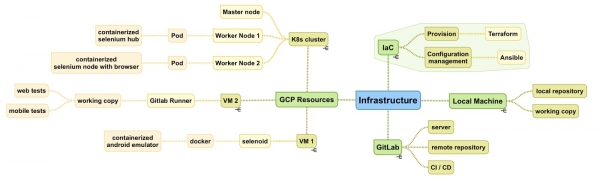
¿Qué sigue?
Así que este es el final del artículo. Pero en conclusión, me gustaría establecer algunos acuerdos con usted.
De su parte
Como se mencionó al principio, me gustaría que el artículo fuera de utilidad práctica y le ayudara a aplicar los conocimientos adquiridos en el trabajo real. Agrego nuevamente.
Pero incluso después de esto, no se detenga, practique, explore los enlaces relevantes y libros, descubra cómo esto funciona en su empresa, encuentre áreas que se puedan mejorar y participe en ello. ¡Buena suerte!
De mi parte
Del título se puede ver que esta fue solo la primera parte. A pesar de que fue bastante extensa, aún hay temas importantes que no se han abordado aquí. En la segunda parte, planeo discutir la infraestructura de automatización en el contexto de iOS. Debido a las restricciones de Apple en relación al lanzamiento de simuladores de iOS solo en sistemas macOS, nuestras soluciones se ven limitadas. Por ejemplo, no tenemos la posibilidad de usar Docker para ejecutar simuladores o nubes públicas para ejecutar máquinas virtuales. Pero eso no significa que no existan otras alternativas. ¡Intentaré mantenerlos informados sobre soluciones avanzadas y herramientas modernas!
Tampoco mencioné temas bastante grandes relacionados con la supervisión. En la parte 3, planeo revisar las herramientas más populares para la supervisión de infraestructura, así como qué datos y métricas deben tenerse en cuenta.
Y por último. En el futuro planeo lanzar un curso en video sobre la creación de infraestructura de prueba y herramientas populares. Actualmente, hay muchos cursos y conferencias sobre DevOps en Internet, pero todo el material se presenta en el contexto del desarrollo, no de la automatización de pruebas. En este asunto, realmente necesito comentarios, si a la comunidad de testers y automatizadores les interesaría y sería valioso tal curso. ¡Gracias de antemano!
Fuente: habr.com
