

Kubernetes es una excelente herramienta para ejecutar contenedores Docker en un entorno de producción clusterizado. Sin embargo, existen tareas que Kubernetes no puede resolver. Con implementaciones frecuentes en el entorno laboral, necesitamos un despliegue automático Blue/Green completamente integrado, para evitar tiempos de inactividad en este proceso, donde también es necesario manejar solicitudes HTTP externas y gestionar la carga de SSL. Esto requiere integración con un balanceador de carga, como ha-proxy. Otra tarea es el escalado semi-automático del propio clúster de Kubernetes mientras trabaja en un entorno de nube, por ejemplo, reduciendo parcialmente el tamaño del clúster por la noche.
Aunque Kubernetes no posee estas funciones directamente 'de serie', proporciona una API que se puede utilizar para abordar tales tareas. Se han desarrollado herramientas para el despliegue Blue/Green automatizado y el escalado del clúster de Kubernetes en el marco del proyecto Cloud RTI, el cual fue creado sobre bases open-source.
En este artículo, la transcripción del video, se describe cómo configurar Kubernetes junto con otros componentes de código abierto para obtener un entorno listo para producción que recibe el código de un commit de git sin tiempos de inactividad en producción.
Entonces, una vez que ha accedido a sus aplicaciones desde el mundo externo, puede proceder a la configuración completa de la automatización, es decir, llevarla a un punto en el que se pueda ejecutar un commit de git y asegurarse de que ese commit finaliza en producción. Es evidente que, al implementar estos pasos y realizar el despliegue, no queremos enfrentar tiempos de inactividad. Por lo tanto, toda automatización en Kubernetes comienza con la API.
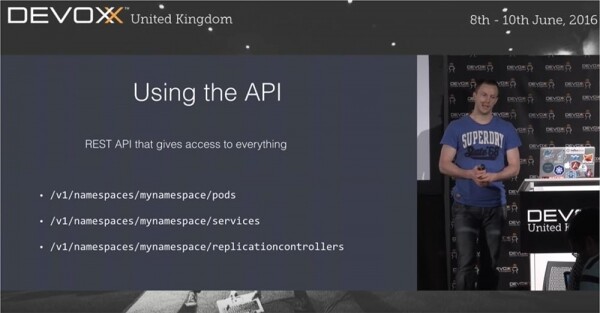
Kubernetes no es una herramienta que se pueda utilizar productivamente 'directamente de la caja'. Por supuesto, puede hacerlo, usar kubectl y demás, pero aún así, la API es lo más interesante y útil de esta plataforma. Usando la API como un conjunto de funciones, puede acceder a prácticamente todo lo que desee hacer en Kubernetes. El propio kubectl también utiliza la REST API.
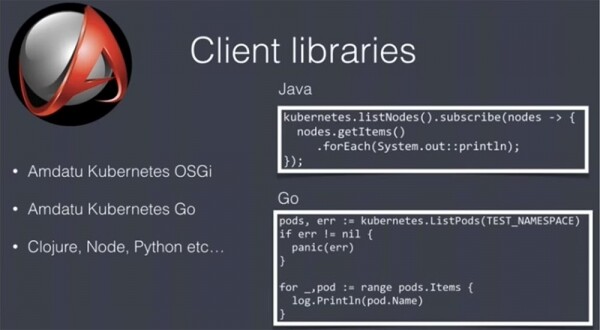
Este es un REST, así que puedes usar cualquier lenguaje y herramienta para interactuar con esta API, pero las bibliotecas de usuario facilitarán mucho tu vida. Mi equipo ha escrito 2 de estas bibliotecas: una para Java / OSGi y otra para Go. La segunda se utiliza con menos frecuencia, pero de todos modos, tienes estas herramientas útiles a tu disposición. Son un proyecto open-source parcialmente licenciado. Hay muchas bibliotecas de este tipo para diferentes lenguajes, así que puedes elegir las más adecuadas.
Así que, antes de comenzar con la automatización del despliegue, es necesario asegurarse de que este proceso no sufra ningún tiempo de inactividad. Por ejemplo, nuestro equipo realiza el despliegue de producción a media jornada, cuando la gente usa las aplicaciones al máximo, por lo que es muy importante evitar retrasos en este proceso. Para evitar los tiempos de inactividad, se utilizan 2 métodos: el despliegue blue/green o las actualizaciones progresivas. En este último caso, si tienes 5 réplicas de la aplicación en funcionamiento, se actualizan secuencialmente una tras otra. Este método funciona muy bien, pero no es adecuado si en el proceso de despliegue tienes distintas versiones de la aplicación en ejecución. En ese caso, puedes actualizar la interfaz de usuario mientras el backend sigue funcionando con la versión anterior, lo que interrumpirá el funcionamiento de la aplicación. Por lo tanto, desde el punto de vista de la programación, trabajar en tales condiciones es bastante complicado.
Esa es una de las razones por las que preferimos utilizar el despliegue blue/green para la automatización del despliegue de nuestras aplicaciones. Con este método, debes asegurarte de que en un momento dado, solo una versión de la aplicación esté activa.
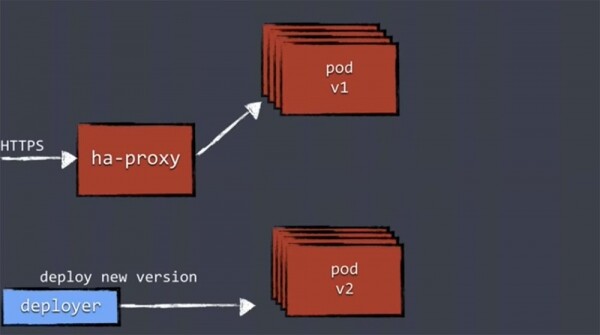
El mecanismo de despliegue blue/green funciona de la siguiente manera. Recibimos el tráfico para nuestras aplicaciones a través de ha-proxy, que redirige a las réplicas en funcionamiento de la aplicación de la misma versión.
Cuando se realiza un nuevo despliegue, utilizamos Deployer, al que se le proporcionan los nuevos componentes, y él lleva a cabo el despliegue de la nueva versión. El despliegue de una nueva versión de la aplicación significa que se 'levantan' un nuevo conjunto de réplicas, y luego estas réplicas de la nueva versión se inician en un nuevo pod separado. Sin embargo, ha-proxy no sabe nada de ellas y, por el momento, no dirige ninguna carga de trabajo hacia ellas.
Por lo tanto, en primer lugar, es necesario realizar una verificación de la funcionalidad de las nuevas versiones mediante health checking, para asegurarse de que las réplicas estén listas para manejar la carga.
Todos los componentes del despliegue deben soportar algún tipo de health check. Esto puede ser una verificación HTTP sencilla, donde se recibe un código con estado 200, o una verificación más profunda, en la que se comprueba la conexión de las réplicas con la base de datos y otros servicios, la resistencia de las conexiones en el entorno dinámico, y si todo se inicia y funciona correctamente. Este proceso puede ser bastante complicado.
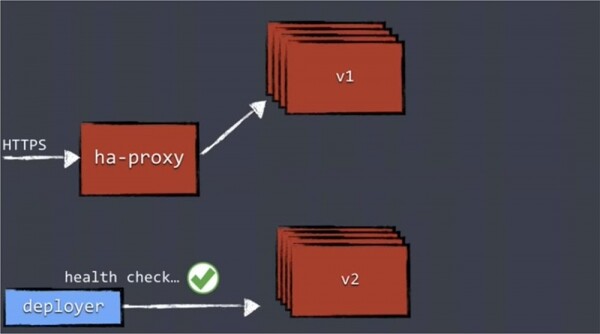
Una vez que el sistema verifique la funcionalidad de todas las réplicas actualizadas, Deployer actualizará la configuración y pasará el confd correcto, que reconfigurará ha-proxy.
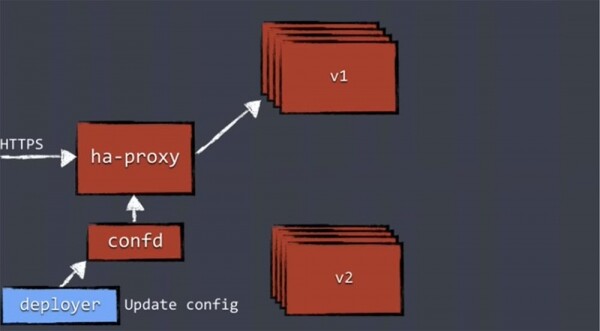
Solo después de eso, el tráfico se dirigirá al pod con las réplicas de la nueva versión y el antiguo pod desaparecerá.
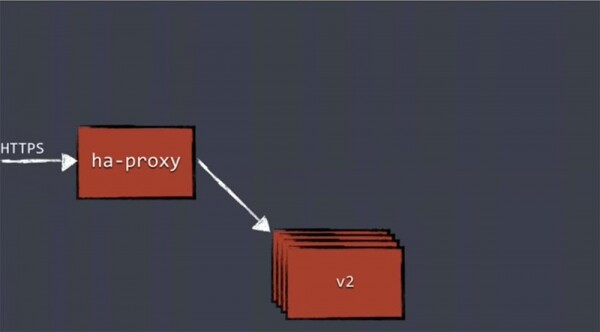
Este mecanismo no es exclusivo de Kubernetes. El concepto de Blue/green deployment ha existido durante bastante tiempo, y siempre ha utilizado un balanceador de carga. Primero, se dirige todo el tráfico a la versión antigua de la aplicación y, después de la actualización, se redirige completamente a la nueva versión. Este principio se utiliza no solo en Kubernetes.
Ahora les presentaré un nuevo componente de despliegue: Deployer, que realiza la verificación de funcionalidad, reconfigura el proxy, etc. Este es un concepto que no se relaciona con el mundo exterior y existe dentro de Kubernetes. Les mostraré cómo se puede crear su propio concepto de Deployer utilizando herramientas open-source.
Entonces, lo primero que hace Deployer es crear un controlador de replicación RC utilizando la API de Kubernetes. Esta API crea pods y servicios para futuros despliegues, es decir, crea un clúster completamente nuevo para nuestras aplicaciones. Una vez que el RC asegura que las réplicas han iniciado, realizará una verificación de su funcionamiento, el Health check. Para esto, Deployer utiliza el comando GET /health. Este comando inicia los componentes de verificación correspondientes y comprueba todos los elementos que garantizan el funcionamiento del clúster.
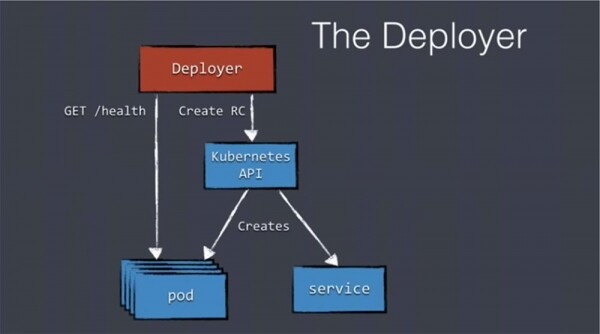
Después de que todos los pods informen sobre su "salud", Deployer crea un nuevo elemento de configuración: un almacenamiento distribuido etcd, que se utiliza dentro de Kubernetes, incluyendo el almacenamiento de la configuración del equilibrador de carga. Escribimos los datos en etcd, y una pequeña herramienta llamada confd monitorea etcd en busca de nuevos datos.
Si detecta cambios en la configuración original, genera un nuevo archivo de configuración y lo pasa a ha-proxy. En este caso, ha-proxy se reinicia sin perder ninguna conexión y dirige la carga a los nuevos services, que aseguran el funcionamiento de la nueva versión de nuestras aplicaciones.
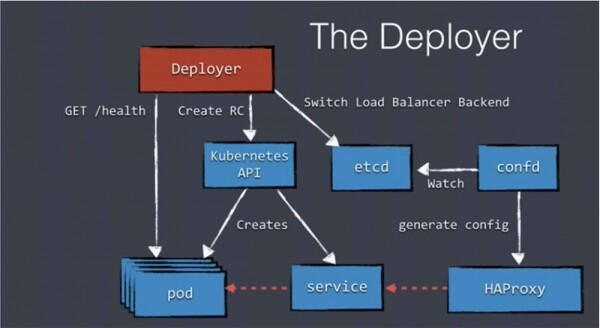
Como pueden ver, a pesar de la abundancia de componentes, aquí no hay nada complicado. Solo necesitan prestar un poco más de atención a la API y a etcd. Quiero hablarles sobre un desplegador de código abierto que nosotros mismos utilizamos: Amdatu Kubernetes Deployer.
Es una herramienta para orquestar despliegues en Kubernetes, que tiene las siguientes funciones:
- despliegue Blue/Green;
- configuración de un equilibrador de carga externo;
- gestión de descriptores de despliegue;
- gestión del despliegue real;
- verificaciones de salud durante el despliegue;
- inserción de variables de entorno en los pods.
Este Deployer se crea sobre la API de Kubernetes y proporciona una API REST para gestionar descriptores y despliegues, así como una API Websocket para el streaming de logs durante el despliegue.
Coloca los datos de configuración del equilibrador de carga en etcd, por lo que no es necesario utilizar ha-proxy con soporte "directo desde la caja", sino que puedes usar fácilmente tu propio archivo de configuración del equilibrador. Amdatu Deployer está escrito en Go, al igual que Kubernetes, y tiene licencia Apache.
Antes de comenzar a utilizar esta versión del desplegador, utilicé el siguiente descriptor de despliegue, que especifica los parámetros que necesito.
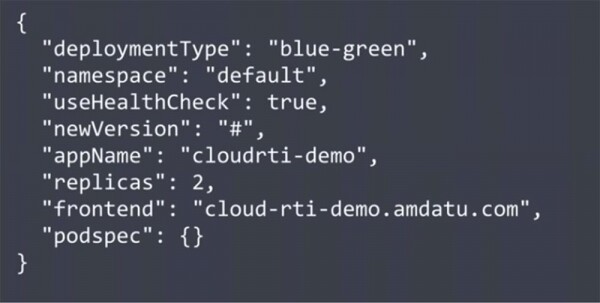
Uno de los parámetros importantes de este código es la inclusión de la bandera "useHealthCheck". Necesitamos especificar que durante el proceso de despliegue se debe realizar una verificación de la operatividad. Este parámetro puede desactivarse cuando se utilizan contenedores de terceros que no necesitan ser verificados. En este descriptor también se indica el número de réplicas y la URL del frontend que necesita ha-proxy. Al final se menciona la bandera de especificación de pod "podspec", que se comunica con Kubernetes para obtener información sobre la configuración de puertos, imágenes, etc. Este es un descriptor bastante simple en formato JSON.
Otra herramienta que forma parte del proyecto de código abierto Amdatu es Deploymentctl. Tiene una interfaz de usuario (UI) para configurar el despliegue, almacena el historial de despliegue y contiene webhooks para callbacks de usuarios y desarrolladores externos. No es obligatorio utilizar la UI, ya que el mismo Amdatu Deployer es un REST API, pero esta interfaz puede facilitar mucho el despliegue sin necesidad de recurrir a ninguna API. Deploymentctl está escrito en OSGi/Vertx utilizando Angular 2.
Ahora demostraré lo anteriormente mencionado en la pantalla, utilizando una grabación previa, así que no tendrás que esperar. Vamos a desplegar una aplicación simple en Go. No te preocupes si no has trabajado con Go antes, es una aplicación muy sencilla, así que todo debería ser claro para ti.
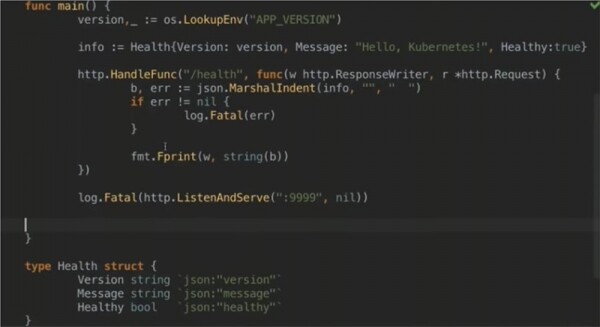
Aquí estamos creando un servidor HTTP que solo responde a /health, por lo que esta aplicación solo comprueba la operatividad del health check y nada más. Si la verificación es exitosa, se activa la estructura JSON mostrada a continuación. Esta contiene la versión de la aplicación que será desplegada, un mensaje que ves en la parte superior del archivo y un valor booleano que indica si nuestra aplicación está operativa o no.
Con la última línea he sido un poco astuto, porque puse un valor booleano fijo al principio del archivo, que me ayudará a desplegar incluso una aplicación "no saludable". Más adelante nos ocuparemos de esto.
Empecemos. Primero, comprobamos si hay pods en ejecución utilizando el comando ~ kubectl get pods y, al no recibir respuesta del URL del frontend, confirmamos que no se están realizando despliegues en este momento.
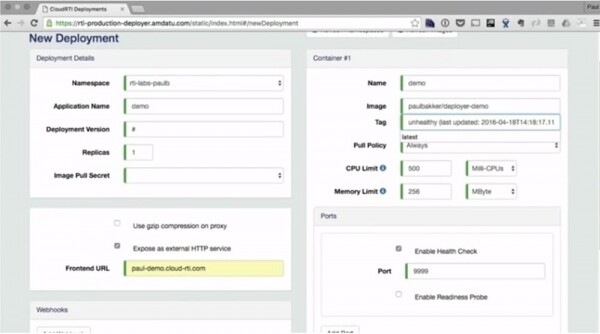
A continuación, en la pantalla ves la interfaz Deploymentctl que mencioné, donde se configuran los parámetros del despliegue: espacio de nombres, nombre de la aplicación, versión del despliegue, número de réplicas, URL del frontend, nombre del contenedor, imagen, límites de recursos, número de puerto para health check, etc. Los límites de recursos son muy importantes, ya que permiten utilizar la máxima capacidad de hardware posible. También puedes ver el registro de despliegue, Deployment log.
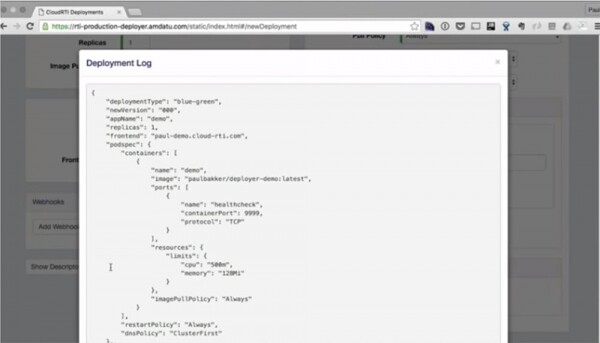
Si repites ahora el comando ~ kubectl get pods, verás que el sistema 'se congela' durante 20 segundos, durante los cuales se realiza la reconfiguración de ha-proxy. Después de eso, el pod se inicia y nuestra réplica puede ser vista en el registro de despliegue.
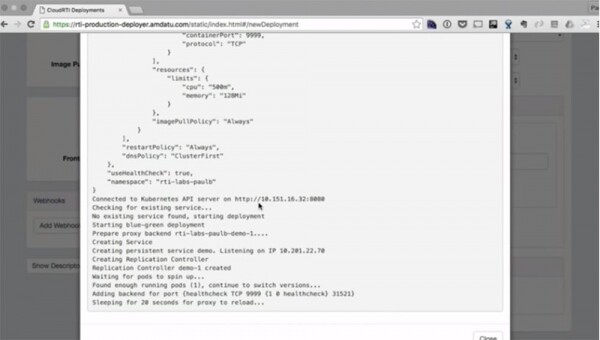
He cortado del video la espera de 20 segundos, y ahora puedes ver en la pantalla que la primera versión de la aplicación está desplegada. Todo esto se hizo solo con la ayuda de la interfaz gráfica.
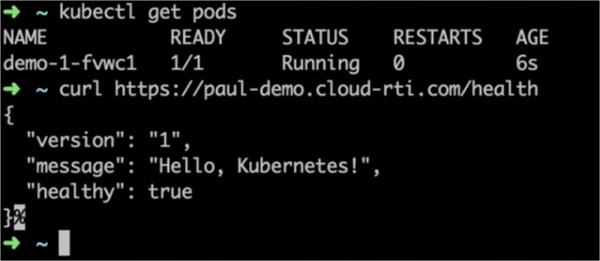
Ahora intentemos la segunda versión. Para ello, voy a cambiar el mensaje de la aplicación de '¡Hola, Kubernetes!' a '¡Hola, Deployer!', el sistema crea esta imagen y la coloca en el registro de Docker, después de lo cual simplemente presionamos nuevamente el botón 'Deploy' en la ventana de Deploymentctl. De esta manera, se inicia automáticamente el registro de despliegue, de la misma manera que ocurrió durante el despliegue de la primera versión de la aplicación.
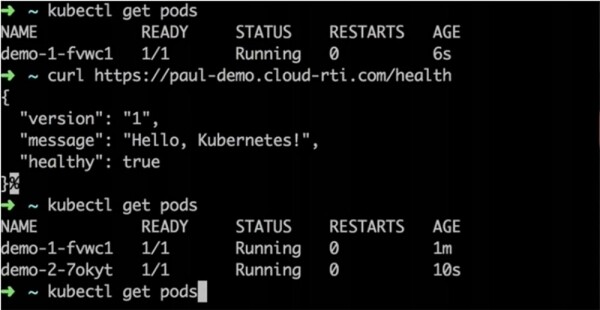
El comando ~ kubectl get pods muestra que actualmente hay 2 versiones de la aplicación en ejecución, sin embargo, el frontend indica que todavía estamos utilizando la versión 1.
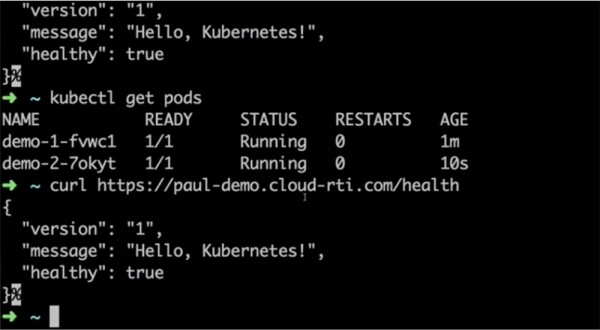
El balanceador de carga espera a que se realice la verificación de estado, después de lo cual redirigirá el tráfico a la nueva versión. Después de 20 segundos, cambiamos a curl y vemos que ahora tenemos la versión 2 de la aplicación desplegada, mientras que la primera ha sido eliminada.
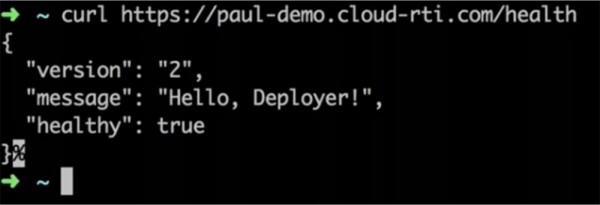
Este fue el despliegue de una aplicación 'saludable' — healthy. Veamos qué sucede si cambio el valor del parámetro Healthy de true a false para la nueva versión de la aplicación, es decir, intento desplegar una aplicación no saludable, que no ha pasado la verificación de funcionamiento. Esto puede suceder si en la etapa de desarrollo se cometieron algunos errores de configuración en la aplicación, y se envió así a producción.
Como puede ver, el despliegue sigue todos los pasos mencionados anteriormente, y ~ kubectl get pods muestra que ambos pods están en funcionamiento. Pero a diferencia del despliegue anterior, el registro muestra un estado de timeout. Esto significa que, debido a que la verificación de health check no pasó, la nueva versión de la aplicación no puede desplegarse. Como resultado, verá que el sistema ha vuelto a utilizar la versión antigua de la aplicación, y la nueva versión ha sido simplemente eliminada.
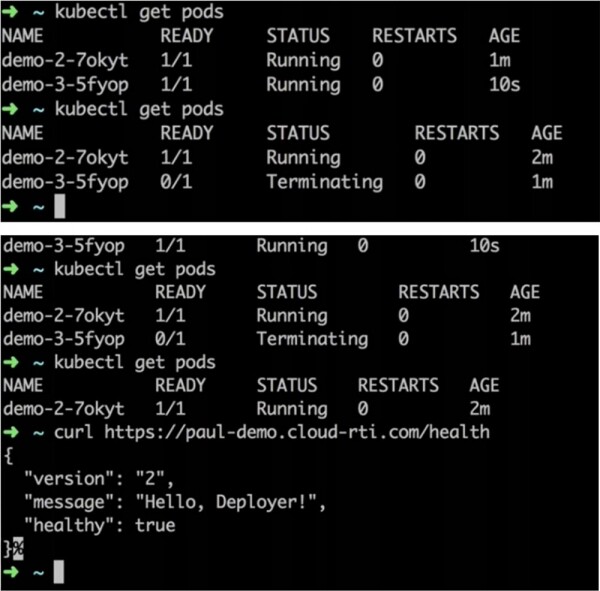
La ventaja de esto es que incluso si tiene una gran cantidad de solicitudes simultáneas que llegan a la aplicación, ni siquiera notarán la inactividad durante el procedimiento de despliegue. Si prueba esta aplicación utilizando el marco Gatling, que le envía la mayor cantidad posible de solicitudes, ninguna de estas solicitudes será rechazada. Esto significa que nuestros usuarios ni siquiera notarán la actualización de versiones en tiempo real. Si falla, el trabajo continuará con la versión antigua; si tiene éxito, los usuarios cambiarán a la nueva versión.
Solo hay una cosa que puede llevar al fracaso: si la verificación de health check pasó exitosamente y la aplicación falló tan pronto como recibió la carga de trabajo, es decir, el colapso ocurrirá solo después de completar el despliegue. En este caso, tendrá que revertir manualmente a la versión anterior. Así que hemos visto cómo usar Kubernetes con herramientas de código abierto diseñadas para ello. El procedimiento de despliegue será mucho más sencillo si incorpora estas herramientas en los pipelines de creación/despliegue. Para iniciar el despliegue, puede usar tanto la interfaz de usuario como automatizar completamente este proceso, aplicando, por ejemplo, el commit a master.
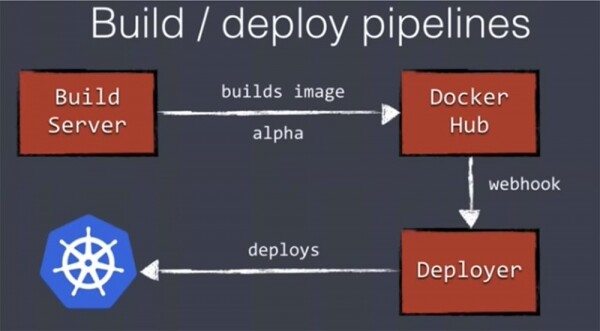
Nuestro servidor de compilación Build Server creará la imagen de Docker, la insertará en Docker Hub o en cualquier otro registro que utilice. Docker Hub admite webhook, por lo que podemos iniciar un despliegue remoto a través de Deployer de la manera mostrada anteriormente. De esta manera, se puede automatizar completamente el despliegue de la aplicación en el entorno de producción potencial.
Pasemos a considerar el siguiente tema: la escalabilidad del clúster de Kubernetes. Cabe destacar que el comando kubectl es un comando de escalado. Además, con él es fácil aumentar el número de réplicas en nuestro clúster existente. Sin embargo, en la práctica, generalmente queremos aumentar la cantidad de no pods, sino de nodos.
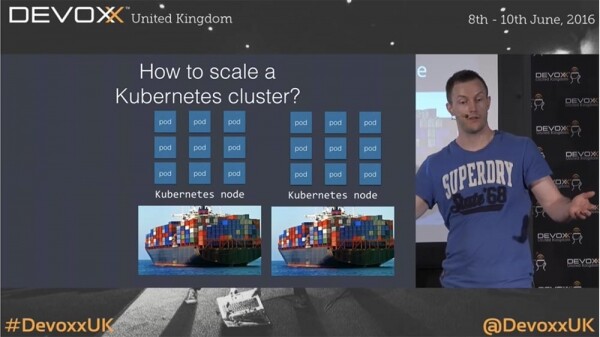
En este sentido, es posible que necesite un aumento durante el horario laboral, mientras que por la noche, para reducir el costo de los servicios de Amazon, puede requerir una disminución en la cantidad de instancias de aplicación en ejecución. Esto no significa que sea suficiente escalar solo la cantidad de pods, ya que incluso si uno de los nodos no está ocupado, aún tendrá que pagar por él a Amazon. Es decir, además de escalar los pods, también necesitará escalar el número de máquinas utilizadas.
Esto puede causar complicaciones, porque independientemente de si estamos usando Amazon o otro servicio en la nube, Kubernetes no tiene conocimiento del número de máquinas utilizadas. No dispone de una herramienta para escalar el sistema a nivel de nodos.
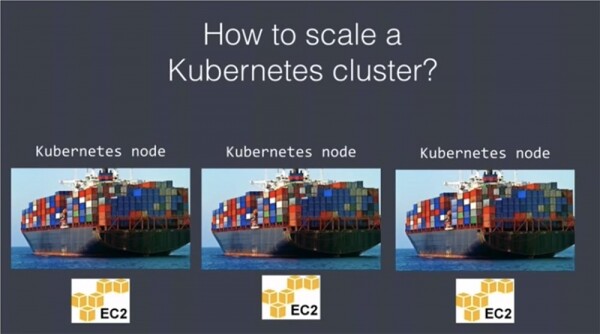
Por lo tanto, tendremos que preocuparnos tanto por los nodos como por los pods. Podemos escalar fácilmente el lanzamiento de nuevos nodos utilizando la API de AWS y grupos de escalado para ajustar la cantidad de nodos de trabajo en Kubernetes. También se puede usar cloud-init o un script similar para registrar nodos en el clúster de Kubernetes.
Una nueva máquina se inicia en el grupo de escalado, se registra como un nodo, se inscribe en el registro del maestro y comienza a funcionar. Después de esto, se puede aumentar el número de réplicas para usar en los nodos recién creados. La reducción de escala requiere más esfuerzo, ya que es necesario asegurarse de que este paso no lleve a la destrucción de aplicaciones ya en funcionamiento tras deshabilitar las máquinas "innecesarias". Para evitar tal escenario, es necesario llevar los nodos a un estado "unschedulable". Esto significa que el programador por defecto ignorará estos nodos al programar pods DaemonSet. El programador no eliminará nada de estos servidores, pero tampoco iniciará nuevos contenedores allí. El siguiente paso es drenar el nodo, es decir, transferir los pods en funcionamiento a otra máquina o a otros nodos que tengan suficiente capacidad para ello. Una vez que se asegure que no quedan contenedores en estos nodos, se pueden eliminar de Kubernetes. Después de esto, simplemente dejarán de existir para Kubernetes. Luego se debe utilizar la API de AWS para desactivar los nodos innecesarios, o máquinas.
Puedes usar Amdatu Scalerd, otra herramienta open-source para escalado, similar a la API de AWS. Proporciona una CLI para agregar o eliminar nodos en el clúster. Una de sus características interesantes es la posibilidad de configurar el programador utilizando el siguiente archivo json.
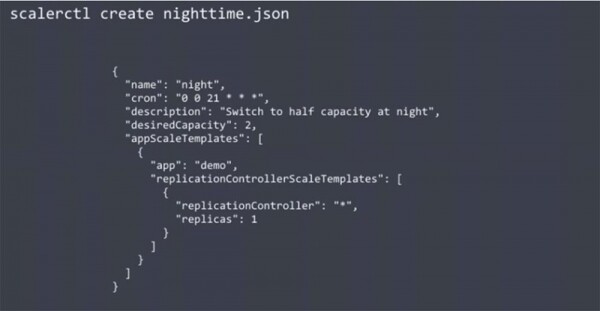
El código representado reduce a la mitad la capacidad del clúster durante la noche. Está configurado tanto para el número de réplicas existentes como para la capacidad deseada del clúster de Amazon. Usar este programador reducirá automáticamente el número de nodos durante la noche y los aumentará por la mañana, permitiendo ahorrar en el costo de uso de nodos de un servicio en la nube como Amazon. Esta función no está integrada en Kubernetes, pero usar Scalerd te permitirá escalar esta plataforma como desees.
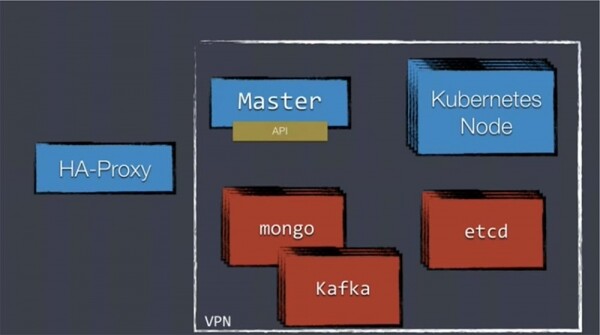
Quiero llamar su atención sobre el hecho de que muchas personas me dicen: «Todo esto está bien, pero ¿qué pasa con mi base de datos, que normalmente permanece en un estado estático?» ¿Cómo se puede ejecutar algo así en un entorno dinámico como Kubernetes? En mi opinión, no deberías hacerlo, no deberías intentar organizar el funcionamiento de un almacén de datos en Kubernetes. Técnicamente es posible, y hay guías en Internet al respecto, sin embargo, complicará seriamente tu vida.
Sí, en Kubernetes existe el concepto de almacenamiento persistente, y puedes intentar ejecutar almacenes de datos como Mongo o MySQL, pero es una tarea bastante ardua. Esto se debe a que los almacenes de datos no admiten completamente la interacción con un entorno dinámico. La mayoría de las bases de datos requieren una configuración significativa, incluyendo la configuración manual del clúster, no les gusta el escalado automático y otras cosas similares.
Por lo tanto, no compliques tu vida tratando de ejecutar un almacén de datos en Kubernetes. Organiza su funcionamiento de manera tradicional utilizando servicios familiares y simplemente permite que Kubernetes los utilice.
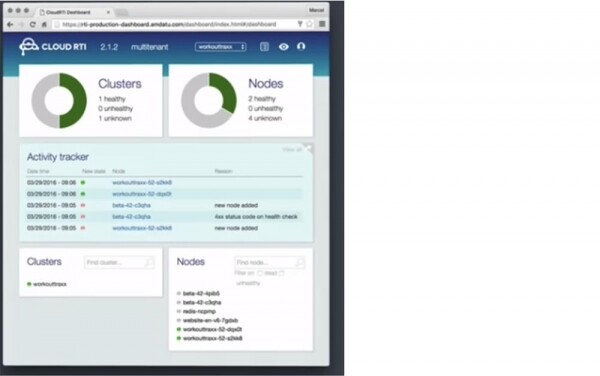
Para concluir el tema, quiero presentarte la plataforma Cloud RTI basada en Kubernetes en la que trabaja mi equipo. Proporciona un registro centralizado, monitoreo de aplicaciones y clústeres, y cuenta con muchas otras funciones útiles que te serán de ayuda. Utiliza diversas herramientas de código abierto, como Grafana para la visualización del monitoreo.
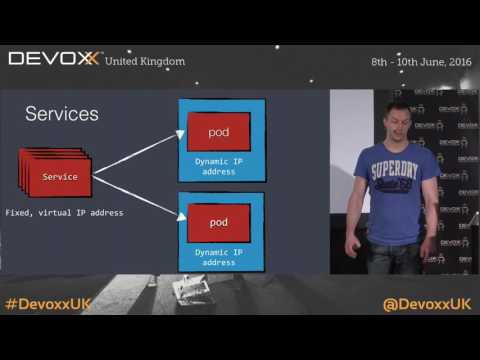
Se planteó la pregunta de por qué usar un balanceador de carga ha-proxy con Kubernetes. Buena pregunta, porque actualmente existen dos niveles de balanceo de carga. Los servicios de Kubernetes todavía están en direcciones IP virtuales. No puedes usarlos para puertos de máquinas anfitrionas externas, porque si Amazon sobrecarga su hospedaje en la nube, la dirección cambiará. Por eso colocamos ha-proxy frente a los servicios, para crear una estructura más estática para la interacción ininterrumpida del tráfico con Kubernetes.
Otra buena pregunta: ¿cómo se puede gestionar el cambio en el esquema de la base de datos durante un despliegue blue/green? El hecho es que, independientemente del uso de Kubernetes, cambiar el esquema de la base de datos es una tarea compleja. Necesitas asegurar la compatibilidad entre el esquema antiguo y el nuevo, después de lo cual podrás actualizar la base de datos y luego actualizar las aplicaciones. Puedes realizar un «cambio en caliente» de la base de datos y luego actualizar las aplicaciones. Conozco personas que han cargado un clúster de base de datos completamente nuevo con un nuevo esquema, esa es una opción si tienes una base de datos sin esquema como Mongo, pero en cualquier caso no es una tarea sencilla. Si no hay más preguntas, ¡gracias por su atención!
Un poco de publicidad 🙂
Gracias por permanecer con nosotros. ¿Te gustan nuestros artículos? ¿Quieres ver más contenido interesante? Apóyanos haciendo un pedido o recomendando a tus conocidos, , un análogo único de servidores entry-level que hemos diseñado para Ti: (disponibles opciones con RAID1 y RAID10, hasta 24 núcleos y hasta 40GB DDR4).
¿Dell R730xd a mitad de precio en el centro de datos Equinix Tier IV en Ámsterdam? Solo aquí ¡en los Países Bajos! Dell R420 — 2x E5-2430 2.2Ghz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — ¡desde $99! Lee sobre cómo
Fuente: habr.com
