

¡Hola a todos! Tenemos excelentes noticias, en junio OTUS lanza nuevamente un curso , por lo que tradicionalmente compartimos con ustedes material útil.
Si te has encontrado con toda esta historia sobre microservicios sin ningún contexto, es comprensible que la encuentres un poco extraña. Dividir una aplicación en fragmentos interconectados a través de la red necesariamente implica añadir modos complejos de tolerancia a fallos en el sistema distribuido resultante.
A pesar de que este enfoque implica dividirse en numerosos servicios independientes, el objetivo final es mucho más grande que simplemente hacer que estos servicios funcionen en diferentes máquinas. Se trata de interactuar con el mundo circundante, que en su esencia también es distribuido. No en un sentido técnico, sino más bien en el de un ecosistema que consiste en muchas personas, equipos y programas, y cada una de estas partes de una u otra forma debe cumplir su función.
Las empresas, por ejemplo, se componen de un conjunto de sistemas distribuidos que en conjunto contribuyen a alcanzar un objetivo. Ignoramos este hecho durante décadas, tratando de lograr la integración, transfiriendo archivos por FTP o utilizando herramientas de integración empresarial, mientras nos enfocábamos en nuestros propios objetivos individuales. Pero con la llegada de los servicios, todo cambió. Los servicios nos ayudaron a ver más allá del horizonte y a observar un mundo de programas interdependientes que trabajan juntos. Sin embargo, para operar con éxito, es necesario entender y diseñar dos mundos fundamentalmente diferentes: el mundo exterior, donde existimos en un ecosistema de muchos otros servicios, y nuestro propio mundo interno, donde gobernamos en soledad.
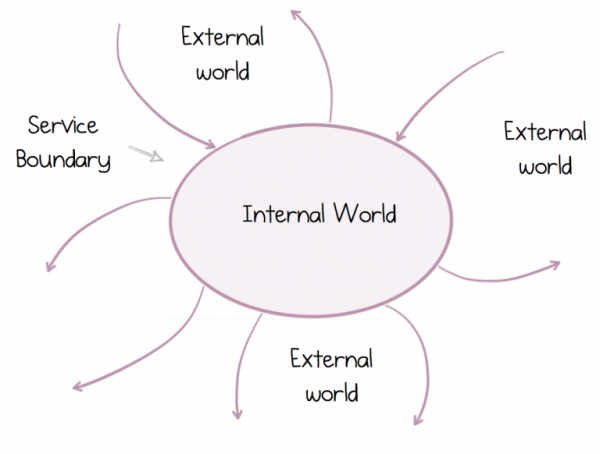
Este mundo distribuido es diferente del que hemos crecido y al que estamos acostumbrados. Los principios de construcción de una arquitectura monolítica tradicional no soportan ningún tipo de crítica. Por lo tanto, entender correctamente tales sistemas es algo más que crear un esquema atractivo en una pizarra blanca o una impresionante prueba de concepto. Se trata de hacer que dicho sistema funcione correctamente durante un largo periodo. Afortunadamente, los servicios han existido durante bastante tiempo, aunque se presentan de diferentes maneras. siguen siendo relevantes, incluso condimentados con Docker, Kubernetes y ligeramente desgastados por barbas hipster.
Así que hoy veremos cómo han cambiado las reglas, por qué necesitamos repensar nuestro enfoque hacia los servicios y los datos que se transmiten entre ellos, y por qué necesitaremos herramientas completamente diferentes para ello.
La encapsulación no siempre será tu amiga
Los microservicios pueden operar de manera independiente entre sí. Esta propiedad les confiere su mayor valor. Esta misma característica permite que los servicios se escalen y crezcan. No tanto en el sentido de escalar a cuatrillones de usuarios o petabytes de datos (aunque aquí también pueden ayudar), sino en términos de escalar desde la perspectiva de las personas, a medida que los equipos y las organizaciones crecen continuamente.
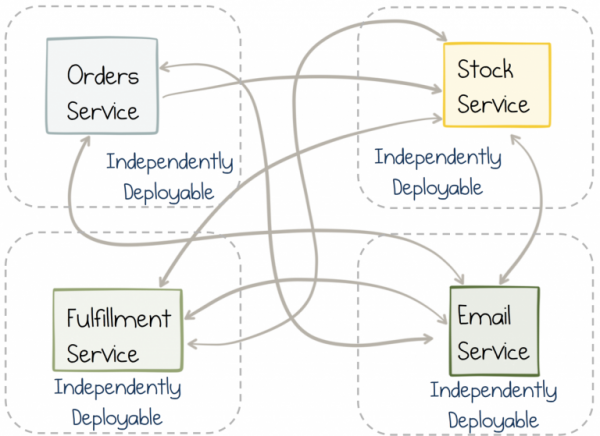
Sin embargo, la independencia es un arma de doble filo. Es decir, un servicio por sí solo puede funcionar fácilmente y sin complicaciones. Pero si dentro de un servicio se implementa una función que requiere la interacción con otro servicio, al final tenemos que hacer cambios en ambos servicios casi simultáneamente. En un monolito, esto es fácil, simplemente haces el cambio y lo envías a producción, pero en el caso de la sincronización de servicios independientes, habrá más problemas. La coordinación entre equipos y ciclos de lanzamiento desafía la flexibilidad.
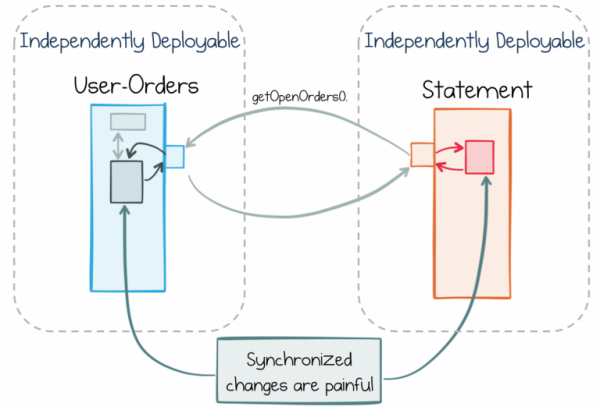
En el enfoque estándar, se intenta simplemente evitar dolorosos cambios transversales, separando claramente la funcionalidad entre los servicios. Un servicio de entrada única al sistema puede ser un buen ejemplo aquí. Tiene un rol claramente definido que lo diferencia de otros servicios. Este claro desglose significa que, en un mundo de requisitos cambiantes para los servicios que lo rodean, es poco probable que el servicio de entrada única al sistema cambie. Existe dentro de un contexto estrictamente limitado.
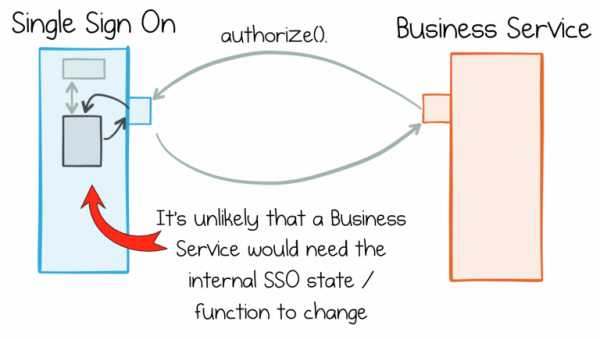
El problema radica en que en el mundo real, los servicios de negocios no pueden mantener una separación de roles perfectamente limpia de manera constante. Por ejemplo, esos mismos servicios de negocios operan en gran medida con datos que provienen de otros servicios similares. Si te dedicas al comercio minorista en línea, el procesamiento de pedidos, el catálogo de productos o la información de los usuarios se convertirá en un requisito para muchos de tus servicios. Cada uno de estos servicios necesitará acceso a esos datos para funcionar.
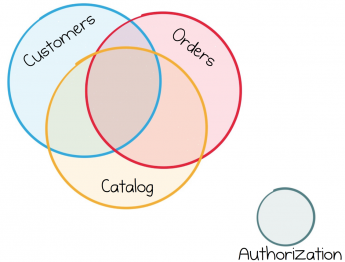
La mayoría de los servicios de negocios utilizan el mismo flujo de datos, por lo que su funcionamiento está invariablemente entrelazado.
Así llegamos a un punto importante sobre el cual vale la pena hablar. Mientras que los servicios funcionan bien para los componentes de infraestructura que operan en gran medida de manera aislada, la mayoría de los servicios de negocios tienden a estar entrelazados de una manera mucho más cercana.
Dicotomía de datos
Los enfoques centrados en servicios pueden que ya existan, pero aún hay poca información sobre cómo intercambiar grandes volúmenes de datos entre servicios.
El problema principal es que los datos y los servicios son inseparables. Por un lado, la encapsulación nos insta a ocultar los datos para que los servicios puedan separarse unos de otros, facilitando su crecimiento y cambios futuros. Por el otro lado, necesitamos tener la capacidad de compartir y controlar libremente los datos comunes, al igual que con cualquier otro. Se trata de poder comenzar a trabajar de inmediato, tan libremente como en cualquier otro sistema de información.
Sin embargo, los sistemas de información tienen poco que ver con la encapsulación. De hecho, es todo lo contrario. Las bases de datos hacen todo lo posible para proporcionar acceso a los datos almacenados en ellas. Vienen equipadas con una poderosa interfaz declarativa que permite modificar los datos como necesites. Esta funcionalidad es importante en la fase de investigación preliminar, pero no para gestionar la creciente complejidad de un servicio en constante evolución.
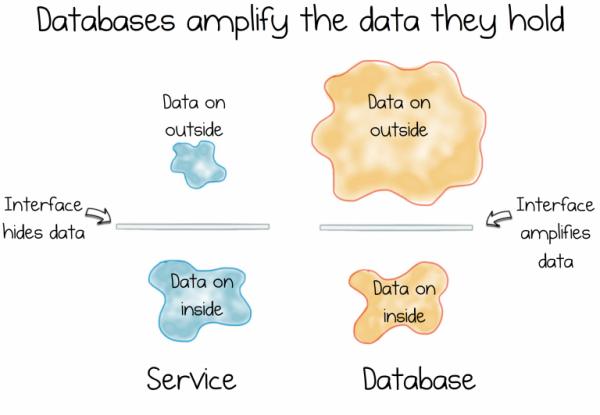
Y aquí surge la dilema. Una contradicción. Una dicotomía. Los sistemas de información se tratan de proporcionar datos, mientras que los servicios se centran en ocultar.
Estas dos fuerzas son fundamentales. Se encuentran en la base de gran parte de nuestro trabajo, luchando constantemente por la supremacía en los sistemas que creamos.
A medida que los sistemas de servicios crecen y evolucionan, vemos diversas manifestaciones de las consecuencias de la dicotomía de los datos. O bien la interfaz del servicio crecerá, ofreciendo un conjunto cada vez más amplio de funciones y comenzará a parecerse a una extraña base de datos casera, o nos enfrentaremos a la frustración y implementaremos algún método para extraer o mover grandes conjuntos de datos de un servicio a otro.
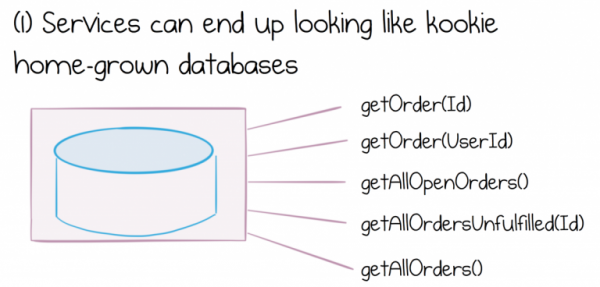
A su vez, crear algo que se asemeje a una extraña base de datos casera llevará a una serie de problemas. No entraremos en detalles sobre lo que es peligroso el shared database, solo diremos que representa considerables dificultades de ingeniería y operacionales costosas Peor aún, los volúmenes de datos multiplican los problemas con los límites de los servicios. Cuantos más datos compartidos haya dentro del servicio, más complicada se volverá la interfaz y más difícil será combinar conjuntos de datos provenientes de diferentes servicios.
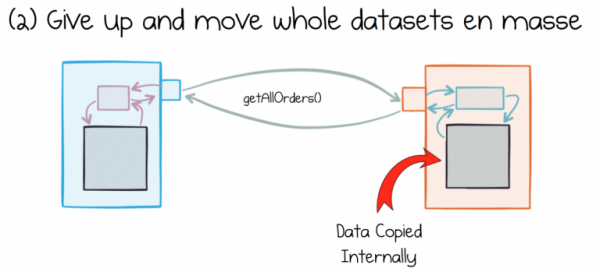
Un enfoque alternativo de extracción y movimiento de grandes conjuntos de datos también tiene sus problemas. El enfoque común a este respecto parece ser simplemente extraer y almacenar un conjunto de datos completo, y luego mantenerlo localmente en cada servicio consumidor.
El problema es que diferentes servicios interpretan los datos que consumen de manera diferente. Estos datos están siempre a mano. Se modifican y procesan localmente. Con bastante rapidez dejan de tener algo en común con los datos en la fuente.
Cuanto más mutables sean las copias, más diferirán los datos con el tiempo.
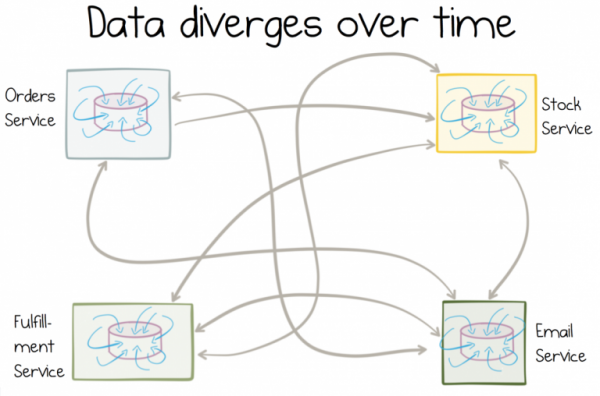
Para colmo, esos datos son difíciles de corregir en retrospectiva (
y aquí es donde realmente puede ayudar). De hecho, algunos de los problemas tecnológicos intratables que enfrenta el negocio surgen de datos heterogéneos, que se multiplican de una aplicación a otra. Para encontrar una solución a este problema de los datos compartidos, debemos pensar de manera diferente. Deben convertirse en objetos de primera clase en las arquitecturas que construimos.
Pat Helland denomina estos datos como «externos», y esta es una característica muy importante. Necesitamos encapsulación para no revelar el funcionamiento interno del servicio, pero debemos facilitar el acceso de los servicios a los datos compartidos para que puedan realizar su trabajo correctamente.
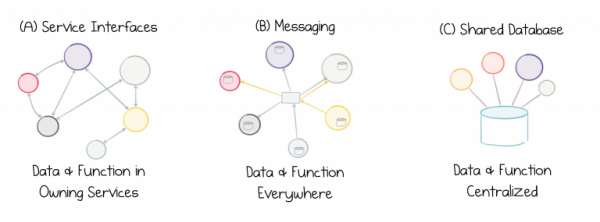
El problema es que ninguno de los enfoques actuales es relevante, ya que ni las interfaces de servicio, ni la mensajería, ni las bases de datos compartidas ofrecen una buena solución para trabajar con datos externos. Las interfaces de servicio son poco adecuadas para el intercambio de datos a cualquier escala. La mensajería mueve los datos, pero no conserva su historial, por lo tanto, los datos se deterioran con el tiempo. Las bases de datos compartidas se concentran demasiado en un solo punto, lo que limita el progreso. Inequívocamente nos quedamos atrapados en un ciclo de insolvencia de datos:
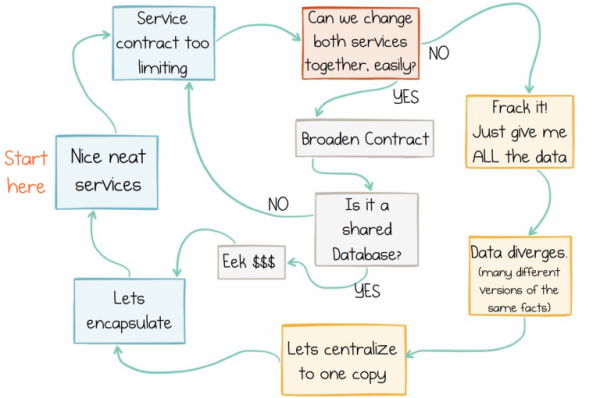
Ciclo de insolvencia de datos
Flujos: un enfoque descentralizado para datos y servicios
En ideal, necesitamos cambiar el enfoque sobre cómo los servicios trabajan con datos comunes. En este momento, cualquier enfoque enfrenta la dicotomía mencionada anteriormente, ya que no hay ninguna varita mágica que se pueda esparcir generosamente para hacer desaparecer el problema. Sin embargo, podemos repensar el problema y llegar a un compromiso.
Este compromiso implica cierto grado de centralización. Podemos aprovechar el mecanismo de registros distribuidos, ya que proporciona flujos escalables y fiables. Ahora necesitamos que los servicios puedan unirse y trabajar con estos flujos comunes, sin embargo, queremos evitar servicios centralizados complejos que realicen dicho procesamiento. Por lo tanto, la mejor opción es integrar el procesamiento de flujos en cada servicio consumidor. Así, los servicios podrán combinar conjuntos de datos de diferentes fuentes y trabajar con ellos según lo necesiten.
Una de las formas de lograr este enfoque es utilizando una plataforma de streaming. Hay muchas opciones, pero hoy nos enfocaremos en Kafka, ya que su procesamiento de flujos con estado permite abordar eficazmente el problema planteado.
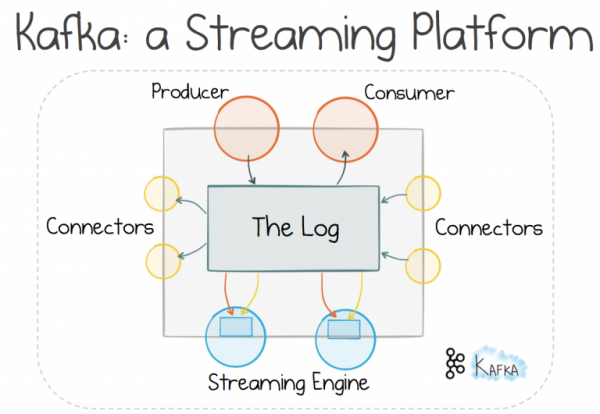
La utilización de un mecanismo de registro distribuido nos permite seguir un camino establecido y usar mensajería para trabajar con . Se considera que este enfoque proporciona una mejor escalabilidad y separación que el mecanismo de "solicitud-respuesta", ya que otorga el control del flujo al receptor y no al remitente. Sin embargo, todo tiene un precio en esta vida, y aquí necesitarás un broker. Pero para sistemas grandes, esta compensación vale la pena (a diferencia de tus aplicaciones web promedio).
Si el registro distribuido es gestionado por un broker en lugar de un sistema de mensajería tradicional, se pueden aprovechar características adicionales. El transporte puede escalar linealmente casi tan bien como un sistema de archivos distribuido. Los datos pueden almacenarse en logs durante un período significativo, por lo que no solo obtenemos mensajería, sino también un almacenamiento de información. Almacenamiento escalable sin miedo a obtener un estado compartido mutable.
Luego, se puede utilizar un mecanismo de procesamiento de flujo con estado (stateful stream processing) para agregar herramientas de base de datos declarativas a los servicios consumidores. Esta es una idea muy importante. Mientras los datos se almacenan en flujos compartidos, a los cuales todos los servicios pueden acceder, la combinación y procesamiento que realiza el servicio son privados. Están aislados dentro de un contexto estrictamente limitado.
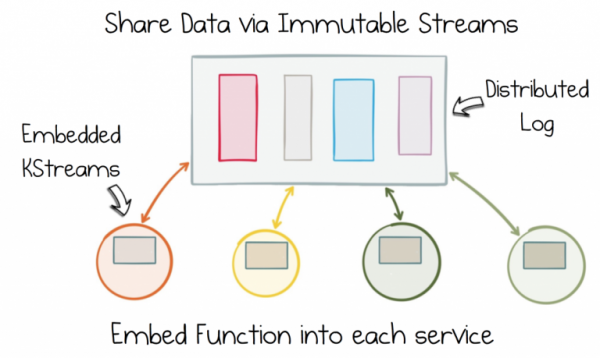
Elimina la dicotomía de datos separando el flujo de estados inmutables. Luego, agrega esta función a cada servicio a través del procesamiento de flujo con estado.
De este modo, si tu servicio necesita trabajar con pedidos, catálogo de productos, almacén, tendrá acceso completo: solo tú decidirás qué datos combinar, dónde procesarlos y cómo deben cambiar con el tiempo. A pesar de que los datos son compartidos, la operación sobre ellos es completamente descentralizada. Se realiza dentro de cada servicio, en un mundo donde todo sigue tus reglas.
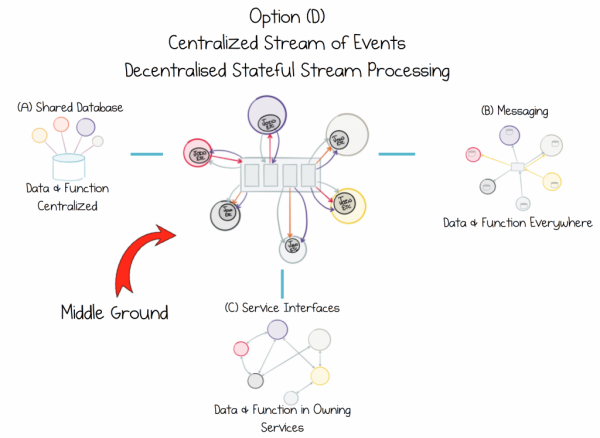
Comparte datos de manera que no se comprometa su integridad. Encapsula la función, no la fuente, en cada servicio que la necesite.
A veces es necesario mover datos masivamente. En ocasiones, el servicio requiere un conjunto histórico local de datos en el motor de base de datos seleccionado. La clave es que se puede garantizar que, si es necesario, una copia puede ser restaurada desde la fuente mediante la utilización del mecanismo de registro distribuido. Los conectores en Kafka manejan esta tarea de manera excelente.
Así que el enfoque que hemos revisado hoy tiene varias ventajas:
- Los datos se utilizan en forma de flujos compartidos, que pueden ser almacenados durante mucho tiempo en los registros, y el propio mecanismo para trabajar con datos compartidos está integrado en cada contexto individual, lo que permite a los servicios operar de forma ágil y rápida. De esta manera, se puede equilibrar la dicotomía de datos.
- Los datos que provienen de diversos servicios pueden ser fácilmente combinados en conjuntos. Así, se simplifica la interacción con datos compartidos y se elimina la necesidad de mantener conjuntos de datos locales en la base de datos.
- El procesamiento de flujos con estado solo almacena datos en caché, siendo los registros compartidos la fuente de verdad, por lo que el problema de la corrupción de datos con el tiempo no es tan agudo.
- Por su naturaleza, los servicios son impulsados por datos, es decir, a pesar del crecimiento constante en el volumen de datos, los servicios aún pueden reaccionar rápidamente a los eventos del negocio.
- Los problemas de escalabilidad recaen en el corredor, no en los servicios. De esta manera, se reduce significativamente la complejidad de escribir servicios, ya que no es necesario preocuparse por la escalabilidad.
- Agregar nuevos servicios no requiere modificar los antiguos, por lo que la integración de nuevos servicios se vuelve más sencilla.
Como pueden ver, esto es más que simplemente REST. Hemos obtenido un conjunto de herramientas que permite trabajar con datos compartidos de forma descentralizada.
En el artículo de hoy no se han explorado todos los aspectos. Aún necesitamos averiguar cómo equilibrar entre la paradoja de la "solicitud-respuesta" y la paradigma orientado a eventos. Pero esto lo abordaremos la próxima vez. Hay temas con los que deberíamos familiarizarnos mejor, como por qué el procesamiento de flujos con estado es tan bueno. Sobre eso hablaremos en el tercer artículo. También existen otras construcciones poderosas que podemos aprovechar si decidimos utilizarlas, como . Con ella se transforman las reglas del juego para los sistemas empresariales distribuidos, ya que esta construcción proporciona garantías transaccionales para de manera escalable. De esto se hablará en el cuarto artículo. Y, por último, necesitaremos repasar los detalles de la implementación de estos principios.
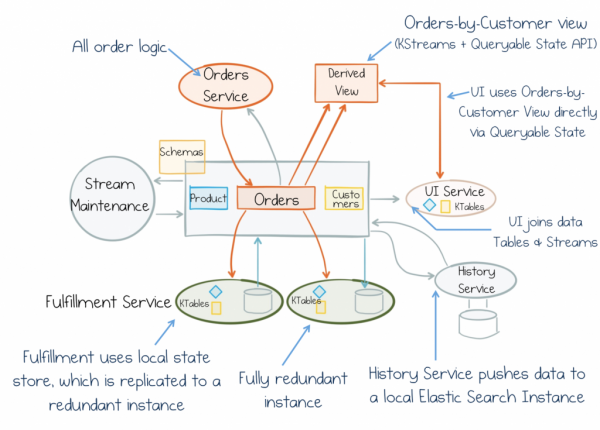
Pero por ahora simplemente recuerden lo siguiente: la dicotomía de los datos es la fuerza con la que nos enfrentamos al crear servicios empresariales. Y debemos tener esto en cuenta. El enfoque está en voltear todo de cabeza y comenzar a considerar los datos generales como objetos de primera clase. El Procesamiento de Flujos con Estado proporciona un compromiso único para ello. Evita los “Componentes Dios” centralizados que limitan el progreso. Además, garantiza la inmediatez, escalabilidad y resiliencia de los pipelines de streaming de datos y los integra en cada servicio. Por lo tanto, podemos centrarnos en el flujo común de conciencia al que cualquier servicio puede conectarse y trabajar con sus datos. Así, los servicios se vuelven más escalables, intercambiables y autónomos. Por lo tanto, no solo lucirán bien en las pizarras de planificación y al verificar hipótesis, sino que también funcionarán y se desarrollarán durante décadas.
Fuente: habr.com
