

Introducción
El sistema de información desde el punto de vista del usuario se define bien en la norma ГОСТ РВ 51987 como «un sistema automatizado, cuyo resultado del funcionamiento es la presentación de información de salida para su uso posterior». Si consideramos la estructura interna, cualquier SI es en esencia un sistema de algoritmos interrelacionados implementados en código. En un sentido amplio, el teorema de Turing-Church establece que un algoritmo (y, por lo tanto, el SI) transforma un conjunto de datos de entrada en un conjunto de datos de salida.
Se podría incluso decir que el sentido de existencia de un sistema de información radica en la transformación de los datos de entrada. En consecuencia, el valor del SI y de todo el conjunto de SIs se determina a través del valor de los datos de entrada y salida.
A partir de esto, el diseño debe comenzar y basarse en los datos, adaptando la arquitectura y los métodos a la estructura y la importancia de los datos.
Datos almacenados
Una etapa clave en la preparación para el diseño es obtener las características de todos los conjuntos de datos que se planifican para su procesamiento y almacenamiento. Estas características incluyen:
— Volumen de datos;
— Información sobre el ciclo de vida de los datos (crecimiento de nuevos datos, tiempo de vida, procesamiento de datos obsoletos);
— Clasificación de los datos desde la perspectiva de su influencia en el negocio principal de la empresa (la tríada de confidencialidad, integridad, disponibilidad) junto con indicadores financieros (por ejemplo, el costo de la pérdida de datos en la última hora);
— Geografía del procesamiento de datos (ubicación física de los sistemas de procesamiento);
— Requisitos de los reguladores para cada clase de datos (por ejemplo, la Ley Federal 152, PCI DSS).
Sistemas de información
Los datos no solo se almacenan, sino que también son procesados (transformados) por los sistemas de información. El siguiente paso después de obtener las características de los datos es realizar un inventario lo más completo posible de los sistemas de información, sus características arquitectónicas, interdependencias y requisitos de infraestructura en unidades condicionales para cuatro tipos de recursos:
— Potencia de cálculo del procesador;
— Volumen de memoria RAM;
— Requisitos de volumen y rendimiento del sistema de almacenamiento de datos;
— Requisitos para la red de transmisión de datos (canales externos, canales entre componentes del SI).
Los requisitos deben establecerse para cada servicio/microservicio en el sistema de información.
Es importante señalar la necesidad de contar con datos sobre el impacto del sistema de información en el negocio principal de la empresa, en forma de costo de inactividad del sistema de información (rublos por hora).
Modelo de amenazas
Es obligatoria la existencia de un modelo formal de amenazas que proteja los datos/servicios. Este modelo incluye no solo aspectos de confidencialidad, sino también de integridad y disponibilidad. Por ejemplo:
— Fallo de un servidor físico;
— Caída de un conmutador top-of-the-rack;
— Corte de un canal de comunicación óptica entre los centros de datos;
— Fallo total de un sistema de almacenamiento temporal.
En algunos casos, los modelos de amenazas se redactan no solo para componentes de infraestructura, sino también para sistemas de información específicos o sus componentes, como la falla de un sistema de gestión de bases de datos con una destrucción lógica de la estructura de datos.
Cualquier decisión en el proyecto para protegerse contra amenazas no descritas es superflua.
Requisitos de los reguladores
Si los datos procesados están sujetos a reglas especiales establecidas por los reguladores, se necesita obligatoriamente información sobre conjuntos de datos y reglas de procesamiento/almacenamiento.
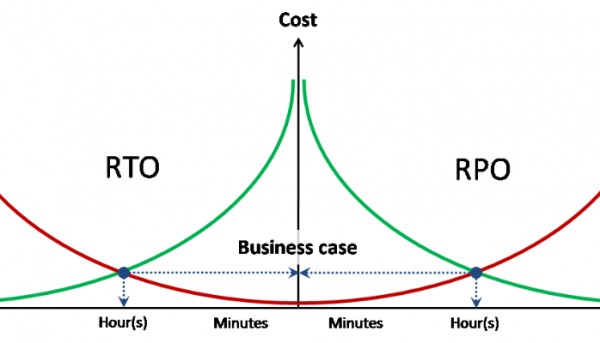
Indicadores objetivos RPO/RTO
El diseño de cualquier tipo de protección requiere la existencia de indicadores de pérdida de datos objetivo y del tiempo de recuperación objetivo del servicio para cada una de las amenazas descritas.
Idealmente, RPO y RTO deben tener costos asociados de pérdida de datos y de inactividad por unidad de tiempo.
División en grupos de recursos
Después de recoger toda la información inicial, el primer paso es agrupar conjuntos de datos y sistemas de información en grupos, basándose en modelos de amenazas y requisitos regulatorios. Se determina la forma de segmentación de los diferentes grupos: programáticamente a nivel de software del sistema o físicamente.
Ejemplos:
— El contorno que procesa datos personales está completamente físicamente separado de los demás sistemas;
— Las copias de seguridad se almacenan en un sistema de almacenamiento separado.
Estos grupos pueden tener independencia parcial, por ejemplo, se definen dos grupos de recursos computacionales (potencia de CPU + memoria RAM) que utilizan un único grupo de almacenamiento de datos y un único grupo de recursos de transmisión de datos.
Potencia de CPU
Las necesidades abstractas de potencia de procesamiento de un centro de datos virtualizado se miden en la cantidad de procesadores virtuales (vCPU) y el coeficiente de consolidación en procesadores físicos (pCPU). En este caso específico, 1 pCPU = 1 núcleo físico del procesador (sin tener en cuenta el Hyper-Threading). La cantidad de vCPU se suma de todos los grupos de recursos definidos (cada uno de los cuales puede tener su propio coeficiente de consolidación).
El coeficiente de consolidación para sistemas cargados se obtiene empíricamente, basándose en la infraestructura existente, o mediante la instalación piloto y pruebas de carga. Para sistemas no cargados, se aplican buenas prácticas. En particular, VMware menciona un coeficiente medio de 8:1.
Memoria RAM
La necesidad total de memoria RAM se obtiene mediante una simple suma. No se recomienda el uso de sobreasignación de memoria RAM.
Recursos de almacenamiento
Los requisitos de recursos de almacenamiento se obtienen sumando todos los grupos en términos de volumen y rendimiento.
Los requisitos de rendimiento se expresan en IOPS en combinación con la relación media de lectura/escritura y, si es necesario, la latencia máxima de respuesta.
Los requisitos de calidad de servicio (QoS) deben especificarse por separado para grupos o sistemas específicos.
Recursos de red de datos
Los requisitos de red de datos se obtienen sumando todos los grupos de ancho de banda.
Los requisitos de calidad de servicio (QoS) y las latencias (RTT) deben especificarse por separado para grupos o sistemas específicos.
En los requisitos de recursos de red de datos también se indican las necesidades de aislamiento y/o cifrado del tráfico de red y los mecanismos preferidos (802.1q, IPSec, etc.).
Selección de arquitectura
En esta guía no se considera ninguna opción más que la arquitectura x86 y la virtualización del 100% de los servidores. Por lo tanto, la selección de la arquitectura del subsistema computacional se limita a elegir la plataforma de virtualización del servidor, el factor de forma de los servidores y los requisitos generales de configuración de los servidores.
Un punto clave en la selección es la claridad en el uso del enfoque clásico con separación de funciones de procesamiento, almacenamiento y transmisión de datos o el enfoque convergente.
Arquitectura clásica implica el uso de subsistemas externos inteligentes para el almacenamiento y la transmisión de datos, mientras que los servidores contribuyen al conjunto común de recursos físicos solo con potencia de CPU y memoria RAM. En el caso extremo, los servidores se vuelven completamente anónimos, sin discos propios ni siquiera un identificador del sistema. En este caso, se utiliza la carga del sistema operativo o del hipervisor desde dispositivos flash integrados o desde un sistema de almacenamiento externo (boot from SAN).
En el marco de la arquitectura clásica, la elección entre blades y servidores en rack se basa principalmente en los siguientes principios:
— Eficiencia económica (en promedio, los servidores en rack son más baratos);
— Densidad computacional (los blades tienen mayor densidad);
— Consumo de energía y generación de calor (los blades tienen mayor consumo específico por unidad);
— Escalabilidad y gestionabilidad (los blades en general requieren menos esfuerzo en instalaciones grandes);
— Uso de tarjetas de expansión (para los blades, la elección es muy limitada).
Arquitectura convergente (también conocida como hiperconvergente) implica la integración de funciones de procesamiento y almacenamiento de datos, lo que lleva al uso de discos locales en los servidores y, como consecuencia, al abandono del factor de forma de los blades clásicos. Para los sistemas convergentes se utilizan servidores en rack o sistemas de clúster que combinan en un solo chasis varios servidores blades y discos locales.
CPU / Memoria
Para calcular correctamente la configuración, es necesario entender el tipo de carga para el entorno o cada uno de los clústeres independientes.
CPU bound – entorno limitado por la capacidad de procesamiento de la CPU. Agregar memoria RAM no cambiará nada en términos de rendimiento (número de VM en el servidor).
Memory bound – entorno limitado por la memoria RAM. Una mayor cantidad de memoria RAM en el servidor permite iniciar un mayor número de VM en el servidor.
GB / MHz (GB / pCPU) – la relación promedio de consumo de memoria RAM y potencia de CPU para esta carga específica. Puede utilizarse para calcular el volumen necesario de memoria dado un rendimiento especificado y viceversa.
Cálculo de la configuración del servidor
Para empezar, es necesario definir todos los tipos de carga y tomar una decisión sobre la combinación o separación de diferentes grupos computacionales en distintos clústeres.
A continuación, para cada uno de los clústeres definidos se determina la relación GB / MHz con una carga conocida de antemano. Si la carga no se conoce de antemano, pero hay una comprensión aproximada del nivel de utilización de la potencia del procesador, se pueden utilizar coeficientes estándar vCPU:pCPU para traducir los requisitos de los grupos en físico.
Para cada clúster, sumamos los requisitos de los grupos vCPU y los dividimos por el coeficiente:
vCPUsum / vCPU:pCPU = pCPUsum – cantidad requerida de núcleos físicos
pCPUsum / 1.25 = pCPUht – cantidad de núcleos con ajuste por Hyper-Threading
Supongamos que es necesario calcular un clúster de 190 núcleos / 3.5 TB de RAM. Tomamos como objetivo una carga del 50% de la potencia del procesador y del 75% de la memoria RAM.
pCPU
190
utilización de CPU
50%
Mem
3500
utilización de Mem
75%
Socket
Core
Srv / CPU
Srv Mem
Srv / Mem
2
6
25,3
128
36,5
2
8
19,0
192
24,3
2
10
15,2
256
18,2
2
14
10,9
384
12,2
2
18
8,4
512
9,1
En este caso, siempre usamos el redondeo hacia el entero más próximo hacia arriba (=REDONDEAR(A1,0)).
De la tabla se hace evidente que las configuraciones de servidores equilibradas según los indicadores objetivo son varias:
— 26 servidores 2*6c / 192 GB
— 19 servidores 2*10c / 256 GB
— 10 servidores 2*18c / 512 GB
La elección entre estas configuraciones debe hacerse considerando factores adicionales, como el paquete térmico y la refrigeración disponible, los servidores ya usados o el costo.
Características de la elección de la configuración del servidor
Máquinas virtuales amplias. Si es necesario alojar máquinas virtuales amplias (comparables a 1 nodo NUMA o más), se recomienda, en la medida de lo posible, elegir un servidor cuya configuración permita que tales VM permanezcan dentro del nodo NUMA. Con un gran número de máquinas virtuales amplias, existe el riesgo de fragmentación de los recursos del clúster, y en este caso se eligen servidores que permiten alojar máquinas virtuales amplias de la manera más compacta posible.
Tamaño del dominio de falla única.
La elección del tamaño del servidor también se basa en el principio de minimizar el dominio de falla única. Por ejemplo, al elegir entre:
— 3 x 4*10c / 512 GB
— 6 x 2*10c / 256 GB
Con igualdad de condiciones, se debe elegir la segunda opción, ya que al fallar un servidor (o durante su mantenimiento) no se pierde el 33% de los recursos del clúster, sino el 17%. De igual manera, se reduce a la mitad el número de VM e IS afectadas por la falla.
Cálculo de almacenamiento de clase clásica según el rendimiento
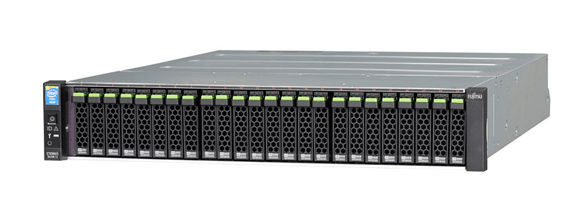
El almacenamiento de clase clásica siempre se calcula según el peor escenario (worst case scenario), excluyendo la influencia de la caché de memoria y la optimización de operaciones.
Como indicadores básicos de rendimiento, tomamos el rendimiento mecánico del disco (IOPSdisk):
— 7.2k – 75 IOPS
— 10k – 125 IOPS
— 15k – 175 IOPS
A continuación, el número de discos en el pool de discos se calcula mediante la siguiente fórmula: = TotalIOPS * ( RW + (1 –RW) * RAIDPen) / IOPSdisk. Donde:
— TotalIOPS – rendimiento total requerido en IOPS del pool de discos
— RW – porcentaje de operaciones de lectura
— RAIDpen – penalización RAID para el nivel RAID seleccionado
Más información sobre el dispositivo RAID y la penalización RAID se describe aquí — y y
A partir del número de discos obtenido, se calculan las opciones posibles que satisfacen los requisitos de capacidad de almacenamiento, incluyendo opciones con almacenamiento jerárquico.
El cálculo de sistemas utilizando SSD como nivel de almacenamiento se considera por separado.
Características del cálculo de sistemas con Flash Cache
Flash Cache – nombre genérico para todas las tecnologías propietarias que utilizan memoria flash como caché de segundo nivel. Al utilizar caché flash, el almacenamiento de clase generalmente se calcula para proporcionar la carga establecida desde discos magnéticos, mientras que el pico es manejado por la caché.
Es necesario comprender el perfil de carga y el grado de localización de los accesos a los bloques de los volúmenes de almacenamiento. Flash Cache es una tecnología para cargas con alta localización de solicitudes y prácticamente no es aplicable para volúmenes cargados uniformemente (como sucede en sistemas analíticos).
Cálculo de sistemas híbridos low-end / mid-range
Los sistemas híbridos de gama baja y media utilizan almacenamiento jerárquico con movimiento de datos entre niveles según un horario. En este caso, el tamaño del bloque de almacenamiento jerárquico en los mejores modelos es de 256 MB. Estas características no permiten considerar la tecnología de almacenamiento jerárquico como una tecnología de aumento de rendimiento, como erróneamente piensan muchos. El almacenamiento jerárquico en sistemas de gama baja y media es una tecnología de optimización de costos de almacenamiento para sistemas con una notable desigualdad de carga.
Para el almacenamiento en múltiples niveles, se calcula principalmente el rendimiento del nivel superior, mientras que el nivel inferior se considera solo para proporcionar la capacidad de almacenamiento faltante. Para un sistema híbrido de múltiples niveles, es imprescindible el uso de tecnología de caché de flash para el grupo de múltiples niveles, con el fin de compensar la caída de rendimiento para los datos que se calientan repentinamente desde el nivel inferior.
Uso de SSD en un grupo de discos de múltiples niveles
El uso de SSD en un grupo de discos de múltiples niveles tiene variaciones, dependiendo de las características de implementación de los algoritmos de caché de flash de ese fabricante.
La práctica general de la política de almacenamiento para un grupo de discos con nivel SSD es SSD first.
Caché de Flash de Solo Lectura. Para un caché de solo lectura, el nivel de almacenamiento en SSD aparece con una significativa localización de las operaciones de escritura independientemente de la caché.
Caché de Flash de Lectura / Escritura. En el caso de un caché de flash en escritura, primero se establece el volumen máximo de la caché, y el nivel de almacenamiento en SSD aparece solo cuando el tamaño de la caché no es suficiente para manejar toda la carga localizada.
El cálculo del rendimiento de SSD y caché se realiza cada vez según las recomendaciones del fabricante, pero siempre para el peor caso.
Fuente: habr.com
