

(Gracias a Sergey G. Brester por la idea del título) )
Colegas, el propósito de este artículo es compartir la experiencia adquirida durante un año de pruebas del nuevo tipo de soluciones IDS basadas en tecnologías de Deception.
Para mantener la coherencia lógica en la exposición del material, creo que es necesario comenzar con las premisas. Así que, la problemática es la siguiente:
- Los ataques dirigidos son el tipo de ataque más peligroso, a pesar de que su peso específico en el total de amenazas es relativamente bajo.
- Aún no se ha inventado ningún medio de protección perimetral (o un conjunto de tales medios) que garantice efectividad.
- Por lo general, los ataques dirigidos se desarrollan en varias etapas. Superar el perímetro es solo una de las etapas iniciales, que (pueden lanzarme piedras) no causa un gran daño a la 'víctima', a menos que se trate de ataques de DEoS (Destruction of service) (ransomware, etc.). El verdadero 'dolor' comienza más adelante, cuando los activos capturados empiezan a ser utilizados para hacer pivoting y profundizar el ataque, y nosotros no nos damos cuenta de ello.
- Dado que comenzamos a sufrir pérdidas reales cuando los delincuentes logran acceder a los objetivos del ataque (servidores de aplicaciones, bases de datos, almacenamiento de datos, repositorios, elementos de infraestructura crítica), es lógico que una de las tareas del servicio de seguridad de la información sea interrumpir los ataques antes de que ocurra este evento desafortunado. Pero para poder interrumpir algo, primero hay que enterarse. Y cuanto antes, mejor.
- Por lo tanto, para una gestión eficaz de riesgos (es decir, para reducir el daño de los ataques dirigidos) es crítico contar con herramientas que aseguren un TTD mínimo (time to detect – tiempo desde la intrusión hasta la detección del ataque). Dependiendo del sector y la región, este período promedia 99 días en EE. UU., 106 días en la región EMEA, 172 días en la región APAC (M-Trends 2017, A View From the Front Lines, Mandiant).
- ¿Qué ofrece el mercado?
- ‘Sandboxing’. Otro control preventivo que está lejos de ser ideal. Existen muchas técnicas efectivas para detectar y eludir los entornos de sandboxing o las soluciones de whitelisting. Los chicos del ‘lado oscuro’ están por delante en este aspecto.
- UEBA (sistemas de perfilado del comportamiento y detección de anomalías) puede ser muy efectivo en teoría. Sin embargo, en mi opinión, eso será en un futuro distante. En la práctica, es aún muy caro, poco confiable y requiere una infraestructura de TI y ciberseguridad muy madura y estable, donde ya existen todas las herramientas que generarán datos para el análisis del comportamiento.
- SIEM es una buena herramienta para investigaciones, pero no puede detectar y mostrar algo nuevo u original a tiempo, porque las reglas de correlación son esencialmente las mismas firmas.
- Por lo tanto, se ha generado la necesidad de una herramienta que:
- funcione exitosamente en un perímetro ya comprometido,
- detecte ataques exitosos en un modo cercano al tiempo real, independientemente de las herramientas y las vulnerabilidades utilizadas,
- no dependa de firmas/reglas/escenarios/políticas/perfiles y otras cosas estáticas,
- no requiera grandes volúmenes de datos y sus fuentes para el análisis,
- permita identificar ataques no como una especie de puntaje de riesgo resultado del trabajo de "la mejor matemática del mundo, patentada y, por lo tanto, cerrada" que requiere de una investigación adicional, sino prácticamente como un evento binario – “Sí, estamos siendo atacados” o “No, todo está bien”,
- sea universal, escalable de manera efectiva y realmente implementable en cualquier entorno heterogéneo, independientemente de la topología física y lógica de la red utilizada.
Las llamadas soluciones de engaño actualmente pretenden ocupar este papel. Es decir, soluciones basadas en el viejo concepto de honeypots, pero con un nivel de implementación completamente diferente. Este tema está, sin duda, en ascenso.
Según los resultados de Las soluciones de engaño se encuentran en el TOP-3 de estrategias y herramientas que se recomienda implementar.
Según el informe El engaño es una de las direcciones clave en el desarrollo de soluciones de IDS (Sistemas de Detección de Intrusiones).
Toda una sección del último , dedicada a SCADA, se basa en datos de uno de los líderes de este mercado, TrapX Security (Israel), cuya solución ha estado funcionando durante un año en nuestra zona de pruebas.
TrapX Deception Grid permite implementar y operar sistemas IDS distribuidos de forma masiva de manera centralizada, sin aumentar la carga de licencias ni los requerimientos de recursos de hardware. De hecho, TrapX es un constructor que permite crear a partir de elementos de la infraestructura de TI existente un gran mecanismo de detección de ataques a nivel empresarial, una especie de 'alarma' distribuida en la red.
Estructura de la Solución
En nuestro laboratorio, estamos constantemente estudiando y probando diversas innovaciones en el campo de la seguridad informática. Actualmente, se han desplegado alrededor de 50 servidores virtuales diferentes, incluidos los componentes de TrapX Deception Grid.
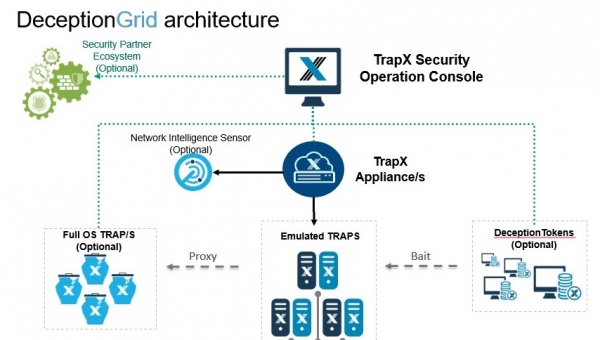
Entonces, de arriba hacia abajo:
- TSOC (TrapX Security Operation Console) es el cerebro del sistema. Esta consola central de gestión permite la configuración, implementación de la solución y todo el trabajo diario. Dado que es un servicio web, puede ser implementada en cualquier lugar: en el perímetro, en la nube o en un proveedor de MSSP.
- TrapX Appliance (TSA) es un servidor virtual que conectamos mediante un puerto trunk a las subredes que queremos incluir en la monitorización. También es aquí donde 'viven' todos nuestros sensores de red.
En nuestro laboratorio hay desplegado un TSA (mwsapp1), pero en realidad pueden existir muchos. Esto puede ser necesario en redes grandes, donde no hay conectividad L2 entre segmentos (un ejemplo típico serían 'Holding y sus filiales' o 'Oficina central del banco y sucursales') o si hay segmentos aislados en la red, como en sistemas de automatización de procesos industriales. En cada una de estas sucursales/segmentos se puede desplegar su propio TSA y conectarlo a un TSOC único, donde toda la información se procesará de manera centralizada. Esta arquitectura permite construir sistemas de monitorización distribuidos sin necesidad de una reestructuración drástica de la red o de interferir en la segmentación existente.
Además, en el TSA podemos enviar una copia del tráfico saliente a través de TAP/SPAN. En caso de detectar conexiones con botnets conocidas, servidores de comando y sesiones TOR, también recibiremos un resultado en la consola. Esto lo gestiona el Sensor de Inteligencia de Red (NIS). En nuestro entorno, esta funcionalidad se implementa en el firewall, por lo que aquí no la hemos utilizado.
- Trampas de Aplicación (Sistema Operativo Completo) – son trampas tradicionales basadas en servidores Windows. No se requieren muchos, ya que la tarea principal de estos servidores es proporcionar servicios de TI al siguiente nivel de sensores o detectar ataques en aplicaciones empresariales que pueden desplegarse en un entorno Windows. En nuestro laboratorio tenemos instalado uno de estos servidores (FOS01)

- Trampas emuladas – son el componente principal de la solución, que nos permite crear un denso 'campo de minas' para los atacantes utilizando una sola máquina virtual, llenando la red de la empresa, todos sus VLAN, con nuestros sensores. Un atacante ve este sensor, o un host fantasma, como un verdadero PC o servidor Windows, un servidor Linux u otro dispositivo que decidimos mostrarle.

Para beneficio de la investigación y por curiosidad, hemos desplegado una 'pareja de cada especie' — PCs y servidores Windows de varias versiones, servidores Linux, un cajero automático con Windows embedded, SWIFT Web Access, una impresora de red, un conmutador Cisco, una cámara IP Axis, un MacBook, un dispositivo PLC e incluso una bombilla inteligente. En total, son 13 hosts. En general, el proveedor recomienda desplegar tales sensores en un número mínimo del 10% del total de hosts reales. El límite superior es el espacio de direcciones disponible.Un aspecto muy importante es que cada uno de estos hosts no es una máquina virtual completa que requiere recursos y licencias. Es un 'engaño', una emulación, un proceso en TSA, que tiene un conjunto de parámetros y una dirección IP. Por lo tanto, con incluso un solo TSA, podemos llenar la red con cientos de tales hosts fantasma, que funcionarán como sensores en el sistema de alarma. Esta tecnología permite escalar de manera económicamente eficiente el concepto de 'trampas' en cualquier gran empresa distribuida.
Estos hosts son atractivos desde el punto de vista del atacante, ya que contienen vulnerabilidades y parecen objetivos relativamente fáciles. El atacante ve los servicios en estos hosts y puede interactuar con ellos, atacarlos utilizando herramientas y protocolos estándar (smb/wmi/ssh/telnet/web/dnp/bonjour/Modbus, etc.). Sin embargo, no es posible usar estos hosts para desarrollar un ataque o ejecutar su propio código.
- La combinación de estas dos tecnologías (FullOS y trampas emuladas) permite alcanzar una alta probabilidad estadística de que un atacante eventualmente se encuentre con algún elemento de nuestra red de señales. Pero, ¿cómo lograr que esta probabilidad se acerque al 100%?
Entra en juego lo que se conoce como tokens (Deception tokens). Gracias a ellos, podemos incluir en nuestro IDS distribuido todas las PC y servidores de la empresa. Los tokens se colocan en los PCs reales de los usuarios. Es importante entender que los tokens no son un agente que consume recursos y puede causar conflictos. Los tokens son elementos informativos pasivos, una especie de "migas de pan" para el atacante, que lo guían hacia una trampa. Por ejemplo, unidades de red conectadas, marcadores en páginas web administrativas falsas en el navegador y credenciales guardadas, sesiones ssh/rdp/winscp guardadas, nuestras trampas con comentarios en archivos hosts, contraseñas almacenadas en memoria, credenciales de usuarios inexistentes, archivos de oficina, cuya apertura activará el sistema, y mucho más. De esta manera, colocamos al atacante en un entorno distorsionado, saturado de vectores de ataque que en realidad no representan una amenaza para nosotros, sino más bien lo contrario. Y no tiene la posibilidad de determinar dónde hay información verdadera y dónde falsa. Así, no solo garantizamos una rápida detección de ataques, sino que también ralentizamos significativamente su progreso.
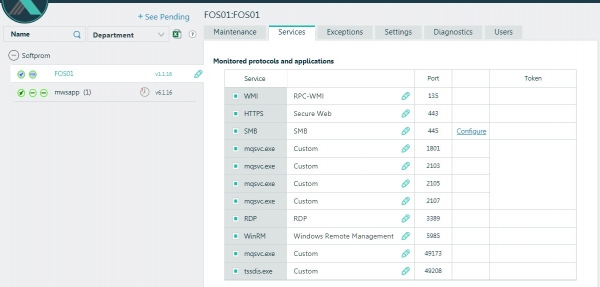
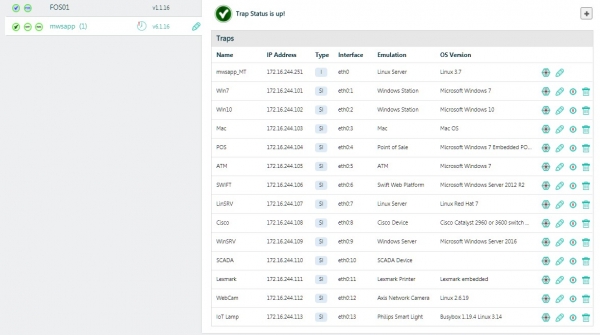
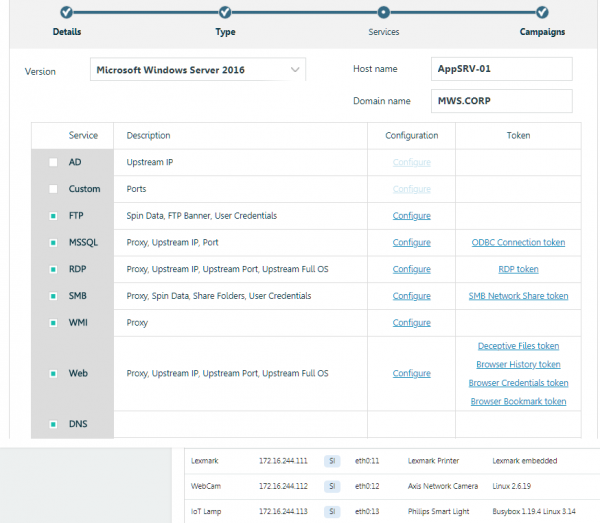
Ejemplo de creación de una trampa de red y configuración de tokens. Interfaz amigable y sin necesidad de ajustar manualmente configuraciones, scripts, etc.
En nuestro entorno, hemos configurado y colocado varios de estos tokens en FOS01 con Windows Server 2012R2 y en una PC de prueba con Windows 7. En estas máquinas se ejecuta RDP y periódicamente "los expuestos" en DMZ, a donde también están nuestros sensores (trampas emuladas). De este modo, obtenemos un flujo constante de incidentes, así a decirlo, de forma natural.
Así que, una breve estadística del año:
56 208 – incidentes registrados,
2 912 – hosts origen de ataques detectados.
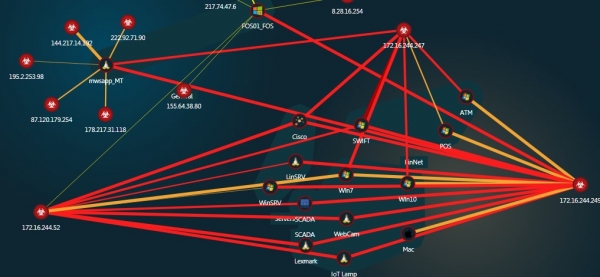
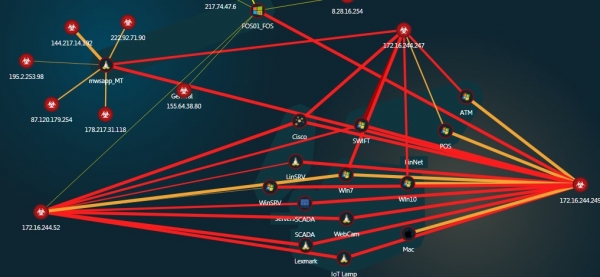
Mapa interactivo y clicable de ataques
Al mismo tiempo, la solución no genera un mega-registro o un flujo de eventos que requiera un análisis prolongado. En lugar de eso, la solución clasifica automáticamente los eventos por tipos, permitiendo que el equipo de seguridad se enfoque primero en los más peligrosos: cuando el atacante intenta establecer sesiones de control (interaction) o cuando hay cargas binarias (infection) en nuestro tráfico.
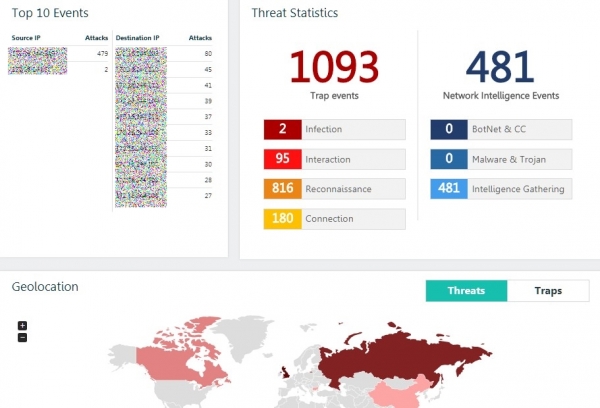
Toda la información sobre los eventos es legible y, en mi opinión, se presenta de una manera fácil de entender incluso para un usuario con conocimientos básicos en seguridad informática.
La mayoría de los incidentes registrados son intentos de escaneo de nuestros hosts o conexiones individuales.
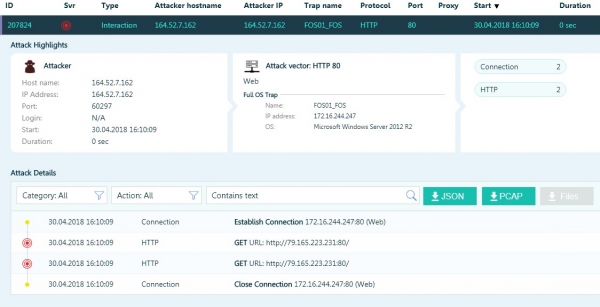
O intentos de fuerza bruta de contraseñas para RDP.
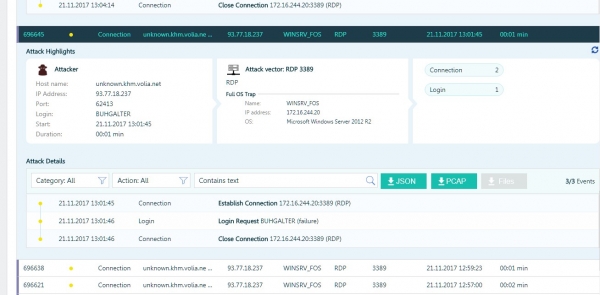
Pero también ha habido casos más interesantes, especialmente cuando los delincuentes 'lograron' adivinar la contraseña para RDP y obtener acceso a la red local.
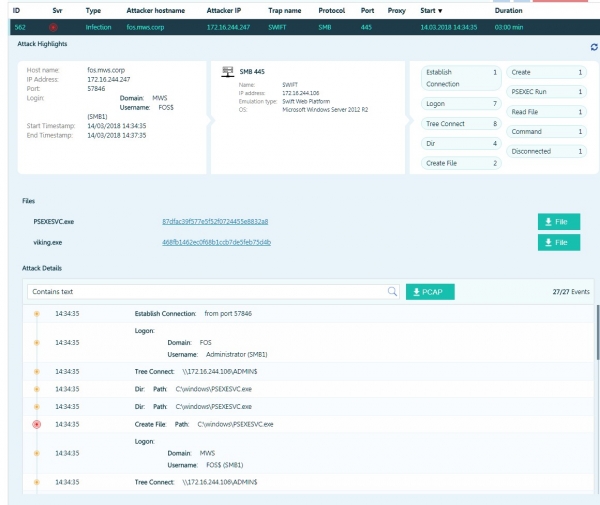
El atacante intenta ejecutar código utilizando psexec.
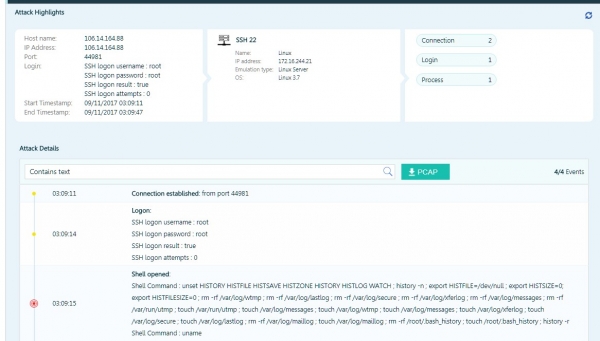
El atacante encontró una sesión guardada que lo llevó a una trampa en forma de servidor Linux. Justo después de conectarse, con un conjunto de comandos predefinidos, intentó eliminar todos los archivos de registro y las variables del sistema correspondientes.
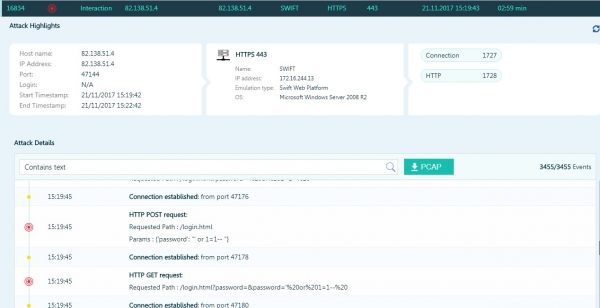
El atacante intenta realizar una inyección SQL en una trampa que simula el acceso web de SWIFT.
Además de esos ataques 'naturales', también realizamos una serie de nuestras propias pruebas. Una de las más ilustrativas es la prueba de tiempo de detección de un gusano de red en la red. Para ello, utilizamos una herramienta de GuardiCore llamada . Es un gusano de red que puede capturar Windows y Linux, pero sin ninguna carga 'útil'.
Desplegamos un centro de comando local, en una de las máquinas lanzamos la primera instancia del gusano y recibimos la primera alerta en la consola TrapX en menos de un minuto y medio. TTD 90 segundos frente a un promedio de 106 días…
Gracias a la posibilidad de integración con otras clases de soluciones, podemos pasar de la detección rápida de amenazas a la respuesta automática a ellas.
Por ejemplo, la integración con sistemas NAC (Control de Acceso a la Red) o con CarbonBlack permitirá desconectar automáticamente los PCs comprometidos de la red.
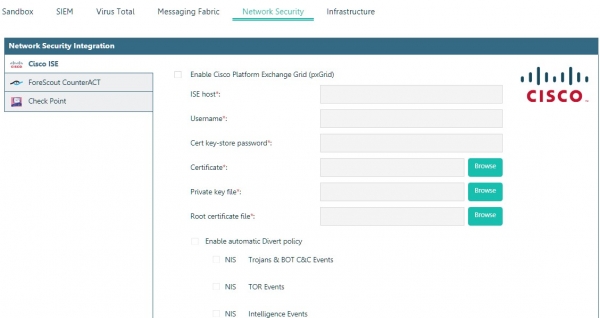
La integración con sandbox permite enviar automáticamente para análisis los archivos involucrados en el ataque.
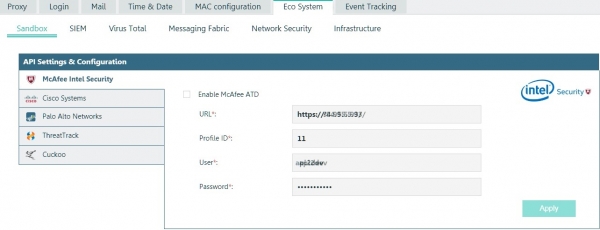
Integración con McAfee
La solución también cuenta con un sistema de correlación de eventos integrado.
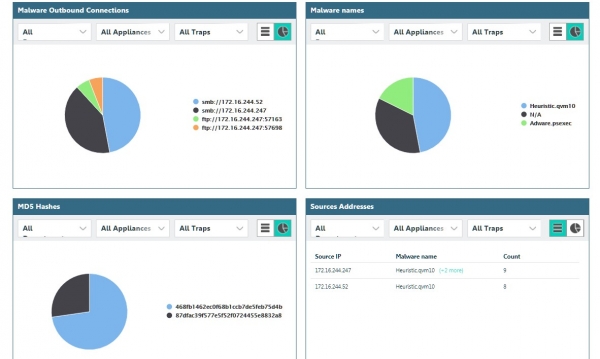
Sin embargo, sus capacidades no nos convencieron, por lo que lo integramos con HP ArcSight.
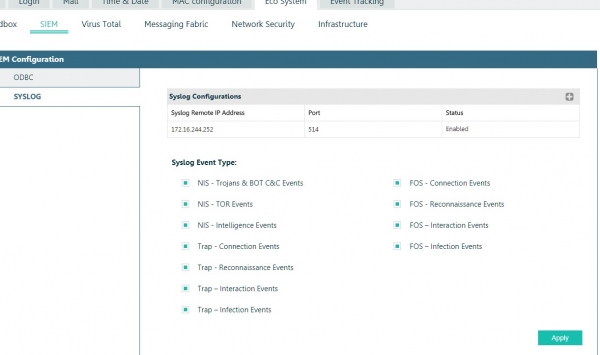
Lidiar con las amenazas detectadas de manera colaborativa se facilita mediante un sistema de tickets integrado.
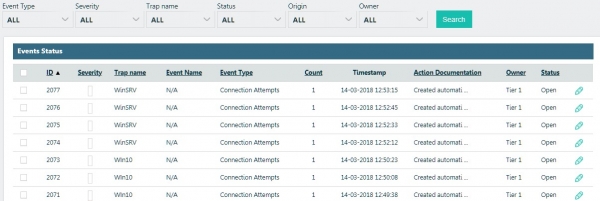
Dado que la solución fue diseñada «desde el principio» para las necesidades de las instituciones gubernamentales y del sector corporativo grande, naturalmente incorpora un modelo de acceso basado en roles, integración con AD, un sistema de informes desarrollado y disparadores (alertas de eventos), así como orquestación para grandes estructuras holding o proveedores MSSP.
En lugar de un resumen
Si existe un sistema de monitoreo que, a modo de decirlo, nos cubre las espaldas, entonces la compromisión del perímetro es solo el comienzo. Lo más importante es que surge una verdadera oportunidad para combatir los incidentes de seguridad de la información, en lugar de ocuparse solo de mitigar sus consecuencias.
Fuente: habr.com
