

Dado que ClickHouse es un sistema especializado, es importante tener en cuenta las características de su arquitectura al utilizarlo. En esta presentación, Alexey abordará ejemplos de errores comunes al usar ClickHouse que pueden llevar a un funcionamiento ineficiente. A través de ejemplos prácticos, se mostrará cómo la elección de un esquema de procesamiento de datos u otro puede alterar la rendimiento por órdenes de magnitud.
¡Hola a todos! Mi nombre es Alexey, y trabajo con ClickHouse.
Primero, me apresuro a alegrarlos, no les contaré hoy qué es ClickHouse. Para ser honesto, estoy cansado de hacerlo. Cada vez que hablo de ello, y probablemente todos ya lo saben.
En lugar de eso, hablaré sobre los posibles escollos, es decir, cómo se puede utilizar incorrectamente ClickHouse. En realidad, no hay razón para tener miedo, porque desarrollamos ClickHouse como un sistema que es simple, conveniente y funciona desde el primer momento. Lo instalas y listo, sin problemas.
Pero aún así, es importante tener en cuenta que este sistema es especializado y se puede fácilmente topar con un escenario de uso inusual que sacará al sistema de su zona de confort.
Entonces, ¿cuáles son esos escollos? En su mayoría, hablaré de cosas obvias. Todos ven lo obvio, todos entienden y pueden alegrarse de ser tan inteligentes, y quienes no entienden aprenderán algo nuevo.
El primer ejemplo más simple, que desafortunadamente ocurre con frecuencia, es un gran número de inserciones con lotes pequeños, es decir, un gran número de pequeñas inserciones.
Si consideramos cómo ClickHouse realiza una inserción, puedes enviar una cantidad de datos en un solo pedido, incluso hasta un terabyte. No hay problema.
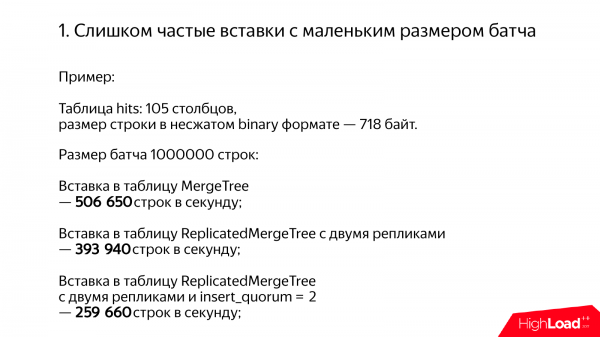
Y veamos cuál sería el rendimiento típico. Por ejemplo, tenemos una tabla con datos de Yandex.Metrica. Hits. 105 columnas. 700 bytes en formato sin comprimir. Y vamos a insertar correctamente en lotes de un millón de filas.
Insertando en una tabla MergeTree, obtenemos medio millón de filas por segundo. Excelente. En la tabla replicada, será un poco menos, alrededor de 400,000 filas por segundo.
Y si activamos la inserción con quórum, obtenemos un poco menos, pero sigue siendo un rendimiento razonable, 250,000 filas por segundo. La inserción con quórum es una característica no documentada en ClickHouse*.
* hasta el año 2020, .
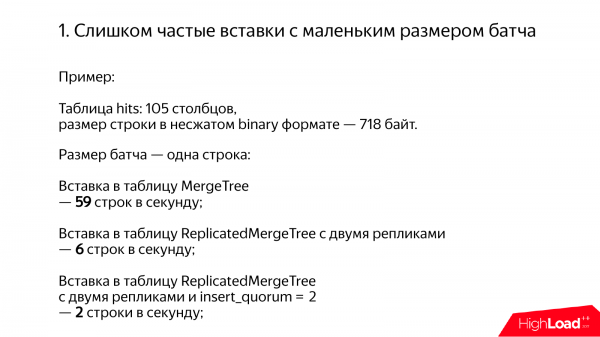
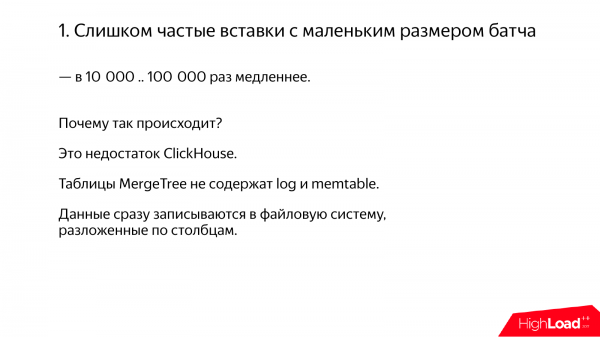
¿Qué pasará si lo hacemos mal? Insertamos una fila a la vez en la tabla MergeTree y obtenemos 59 filas por segundo. Esto es 10,000 veces más lento. En ReplicatedMergeTree, es 6 filas por segundo. Y si además se activa el quórum, entonces obtenemos 2 filas por segundo. En mi opinión, esto es una total decepción. ¿Cómo se puede tener tanto retraso? Incluso en mi camiseta dice que ClickHouse no debe ralentizarse. Pero, a veces, sucede.
De hecho, esta es nuestra falla. Podríamos haber hecho que todo funcionara correctamente, pero no lo hicimos. Y no lo hicimos porque para nuestro escenario no era necesario. Ya teníamos lotes. Simplemente, recibíamos lotes y no había problemas. Insertamos y todo funcionaba correctamente. Pero, por supuesto, podrían surgir varios escenarios. Por ejemplo, cuando tienes un montón de servidores donde se generan datos. Y estos insertan datos no tan frecuentemente, pero aun así se obtienen inserciones frecuentes. Y hay que evitar eso de alguna manera.
Desde un punto de vista técnico, la cuestión es que cuando haces un insert en ClickHouse, los datos no van a ninguna tabla de memoria. Ni siquiera tenemos un log structure MergeTree verdadero, solo un MergeTree, porque no hay log ni memTable. Simplemente, escribimos los datos directamente en el sistema de archivos, ya organizados por columnas. Y si tienes 100 columnas, tendrás que escribir más de 200 archivos en un directorio separado. Todo esto es bastante voluminoso.
Y surge la pregunta: «¿Cómo hacerlo bien?» si la situación es que de alguna manera necesitas registrar datos en ClickHouse.
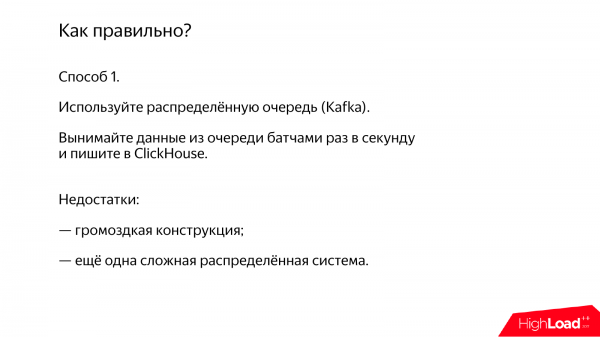
Método 1. Este es el método más sencillo. Utilizar alguna cola distribuida. Por ejemplo, Kafka. Simplemente sacas datos de Kafka, haciendo lotes una vez por segundo. Y todo funcionará bien, registras y todo funciona como se espera.
Las desventajas son que Kafka es otro sistema distribuido voluminoso. Entiendo si ya tienes Kafka en tu empresa. Esto es bueno, es conveniente. Pero si no lo tienes, vale la pena pensarlo dos veces antes de incorporar otro sistema distribuido en tu proyecto. Por lo tanto, se deben considerar alternativas.
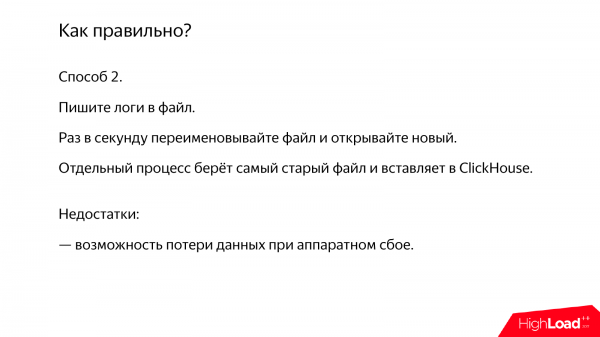
Método 2. Esta es una alternativa de la vieja escuela y, además, muy simple. Tienes un servidor que genera tus registros. Simplemente guarda tus registros en un archivo. Y una vez por segundo, por ejemplo, renombramos ese archivo, abrimos uno nuevo. Y un script separado, ya sea mediante cron o algún demonio, toma el archivo más antiguo y lo escribe en ClickHouse. Si los registros se escriben cada segundo, todo funcionará perfectamente.
Pero la desventaja de este método es que si tu servidor, donde se generan los registros, desaparece, también se perderán los datos.
Método 3. Hay otro método interesante que no utiliza archivos temporales. Por ejemplo, puedes tener algún tipo de servicio de publicidad o algún otro demonio que genera datos. Y puedes acumular un conjunto de datos directamente en la memoria, en el búfer. Y cuando pasa suficiente tiempo, dejas ese búfer a un lado, creas uno nuevo y, en un hilo separado, introduces lo que ya se ha acumulado en ClickHouse.
Por otro lado, los datos también desaparecerán con un kill -9. Si tu servidor falla, perderás esos datos. Y hay otro problema: si no se puede escribir en la base de datos, los datos se seguirán acumulando en la memoria. O se quedará sin memoria, o simplemente perderás datos.
Método 4. Otro método interesante. Tienes un proceso en el servidor. Y puede enviar datos a ClickHouse de inmediato, pero hacerlo en una sola conexión. Por ejemplo, envías una solicitud http con transfer-encoding: chunked con insert. Y genera fragmentos no muy raramente, se puede enviar cada línea, aunque habrá un overhead en el framing de esos datos.
Sin embargo, en este caso, los datos se enviarán a ClickHouse de inmediato. Y ClickHouse los almacenará en búfer.
Pero también surgen problemas. Ahora perderás datos, incluyendo cuando tu proceso se detenga y, si el proceso de ClickHouse se detiene, porque eso será un insert incompleto. Y en ClickHouse los inserts son atómicos hasta un cierto umbral en términos de número de filas. En principio, es un método interesante. También se puede utilizar.
Método 5. Aquí hay otro método interesante. Es un servidor diseñado por la comunidad para el procesamiento de datos por lotes. No lo he revisado yo mismo, así que no puedo garantizar nada. Sin embargo, tampoco se ofrecen garantías para ClickHouse. También es open source, pero por otro lado, podría ser que estés acostumbrado a un cierto estándar de calidad que tratamos de mantener. En cuanto a esta herramienta, no lo sé, visita GitHub y revisa el código. Tal vez hayan escrito algo decente.
* a partir de 2020, también se debe añadir para consideración .
Método 6. Otro método es el uso de tablas Buffer. La ventaja de este método es que es muy fácil de comenzar a usar. Creas una tabla Buffer y la llenas.
La desventaja es que el problema no se resuelve por completo. Si al insertar tipo MergeTree debes agrupar los datos por un lote por segundo, al insertar en una tabla buffer, necesitas agrupar al menos varios miles por segundo. Si hay más de 10,000 por segundo, aún así habrá problemas. Y si insertas en lotes, habrás visto que ahí se obtienen cientos de miles de filas por segundo. Y esto ya con datos bastante pesados.
Además, las tablas buffer no tienen registro. Y si algo va mal con tu servidor, los datos se perderán.
Y como bonificación, recientemente en ClickHouse se ha añadido la posibilidad de extraer datos de Kafka. Existe un motor de tabla – Kafka. Simplemente lo creas. Y se le pueden añadir vistas materializadas. En este caso, extraerá automáticamente los datos de Kafka e insertará en las tablas que necesites.
Y lo que alegra especialmente de esta funcionalidad es que no lo hicimos nosotros. Es una función de la comunidad. Y cuando digo 'función de la comunidad', lo digo sin desdén. Leímos el código, hicimos revisiones, debería funcionar bien.
* a partir de 2020, se añadió soporte similar para .
¿Qué más puede ser incómodo o inesperado al insertar datos? Si realizas una consulta insert values y en values escribes algunas expresiones calculadas. Por ejemplo, now() es también una expresión calculada. Y en este caso, ClickHouse se ve obligado a ejecutar el intérprete de estas expresiones para cada fila, lo que hace que el rendimiento se desplome drásticamente. Es mejor evitarlo.
* En este momento, el problema está completamente solucionado, ya no hay regresiones en el rendimiento al usar expresiones en VALUES.
Otro ejemplo de posibles problemas es cuando en un solo lote los datos corresponden a múltiples particiones. Por defecto, en ClickHouse, las particiones son por meses. Y si insertas un lote de un millón de filas, y esos datos abarcan varios años, tendrás varias decenas de particiones. Esto es equivalente a tener lotes de un tamaño varias decenas de veces menor, ya que dentro de ellos siempre se dividen primero por particiones.
* Recientemente, se ha añadido en ClickHouse, en modo experimental, soporte para el formato compacto de partes y partes en memoria con registro de escritura anticipada, lo que casi resuelve por completo el problema.
Ahora consideremos el segundo tipo de problema: la tipificación de datos.
La tipificación de datos puede ser estricta o de tipo cadena. La de tipo cadena es cuando simplemente declaras que todos tus campos son del tipo string. Eso es un desastre. No se debe hacer así.
Vamos a descubrir cómo hacerlo correctamente en aquellos casos en los que quieras indicar que un campo es una cadena, y que ClickHouse se encargue de ello, mientras tú no te preocupes demasiado. Pero de todos modos, vale la pena hacer algunos esfuerzos.
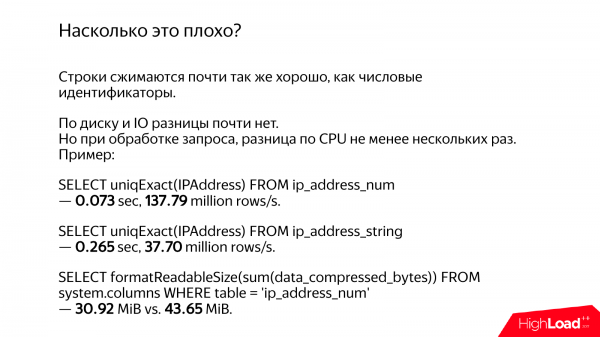
Por ejemplo, tenemos una dirección IP. En un caso, la hemos guardado como una cadena. Por ejemplo, 192.168.1.1. Y en otro caso, será un número de tipo UInt32*. 32 bits son suficientes para una dirección IPv4.
Primero, y aunque parezca extraño, los datos se comprimirán de manera similar. Habrá diferencias, por supuesto, pero no serán tan significativas. Así que no hay problemas especiales con la entrada/salida del disco.
Pero hay una diferencia significativa en el tiempo de CPU y en el tiempo de ejecución de la consulta.
Calculemos la cantidad de direcciones IP únicas, si se almacenan como números. Resulta que hay 137 millones de filas por segundo. Si lo mismo se hace como cadenas, son 37 millones de filas por segundo. No sé por qué hay tal coincidencia. Yo mismo ejecuté estas consultas. Sin embargo, de todos modos, es aproximadamente 4 veces más lento.
Y si calculamos la diferencia en espacio en disco, también hay una diferencia. Y esa diferencia es de aproximadamente una cuarta parte, porque hay un número considerable de direcciones IP únicas. Si aquí hubiera cadenas con una pequeña cantidad de valores diferentes, se habrían comprimido mediante diccionario a un volumen aproximadamente igual.
Y la diferencia de tiempo en la carretera no se desprecia. Puede que te dé igual, pero cuando veo tal diferencia, me entristece.
Consideremos diferentes casos.
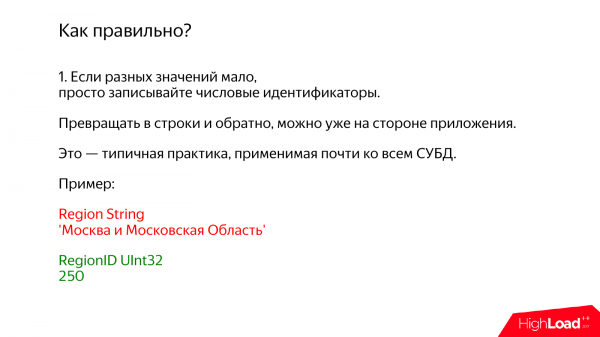
1. Un caso en el que tienes pocos valores únicos. En este caso, utilizamos una práctica simple que probablemente ya conoces y que puedes aplicar a cualquier SGBD. Esto tiene sentido no solo para ClickHouse. Simplemente registras identificadores numéricos en la base de datos. Y convertir a cadenas y viceversa se puede hacer ya en el lado de tu aplicación.
Por ejemplo, tienes una región. Y tratas de guardarla como una cadena. Y ahí podría decir: Moscú y la región de Moscú. Cuando veo que dice 'Moscú', está bien, pero cuando también dice la región de Moscú, me entristece un poco. ¿Cuántos bytes son?
En su lugar, simplemente registramos un número Ulnt32 y 250. En Yandex tenemos 250, y quizás tú tengas un número diferente. Solo para aclarar, ClickHouse tiene una capacidad integrada para trabajar con bases geográficas. Simplemente registras un directorio con las regiones, incluidas las jerárquicas, es decir, ahí estarán Moscú, la región de Moscú y todo lo que necesites. Y se puede convertir a nivel de consulta.
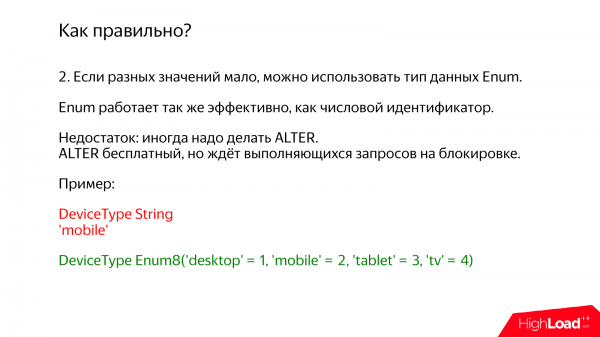
La segunda opción es similar, pero ya con soporte interno en ClickHouse. Este es el tipo de datos Enum. Simplemente dentro de Enum escribes todos los valores que necesitas. Por ejemplo, el tipo de dispositivo, y ahí escribes: escritorio, móvil, tableta, televisor. Solo 4 variantes.
El inconveniente es que hay que alterar periódicamente. Solo se añade una variante. Hacemos alter table. En realidad, hacer alter table en ClickHouse es gratuito. Especialmente es gratuito para Enum, porque los datos en disco no cambian. Sin embargo, alter bloquea la tabla y debe esperar a que se realicen todas las selecciones. Y solo después de eso se ejecutará alter, es decir, todavía hay algunas incomodidades.
* en las versiones recientes de ClickHouse, ALTER se ha hecho completamente no bloqueante.
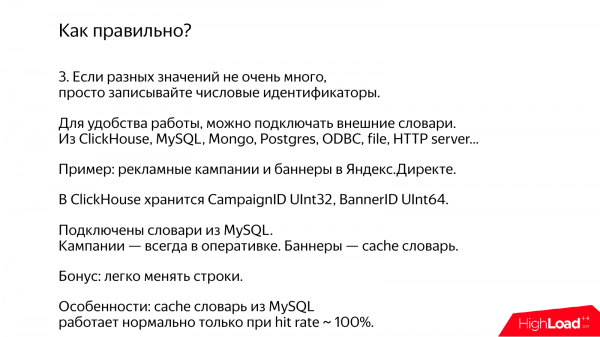
Otra opción bastante única para ClickHouse es la conexión de diccionarios externos. Puedes escribir números en ClickHouse, mientras que tus directorios pueden estar en cualquier sistema que prefieras. Por ejemplo, se puede utilizar: MySQL, Mongo, Postgres. Incluso puedes crear tu propio microservicio que entregue estos datos por http. Y a nivel de ClickHouse, escribes una función que transformará estos datos de números a cadenas.
Este es un método especializado, pero muy eficaz para realizar un join con una tabla externa. Existen dos variantes. En una de ellas, los datos estarán completamente en caché, completamente presentes en memoria y se actualizarán periódicamente. En la otra variante, si los datos no caben en la memoria, se pueden almacenar en caché parcialmente.
Aquí hay un ejemplo. Hay Yandex.Direct. Y allí hay campañas publicitarias y banners. Probablemente haya alrededor de diez millones de campañas publicitarias. Y aproximadamente caben en la memoria. En cuanto a los banners, son miles de millones y no caben. Utilizamos un diccionario almacenable en caché de MySQL.
El único problema es que el diccionario almacenable en caché funcionará correctamente si la tasa de aciertos está cerca del 100%. Si es menor, entonces al procesar las solicitudes para cada lote de datos, realmente tendremos que obtener las claves faltantes y recuperar los datos de MySQL. En cuanto a ClickHouse, puedo asegurar que no se ralentiza; no hablaré de otros sistemas.
Como bonus, los diccionarios son una forma muy sencilla de actualizar datos en ClickHouse retroactivamente. Es decir, si tenía un informe sobre campañas publicitarias y el usuario simplemente cambió la campaña, esos datos también cambian en todos los datos antiguos y en todos los informes. Si se escriben filas directamente en la tabla, su actualización será imposible.
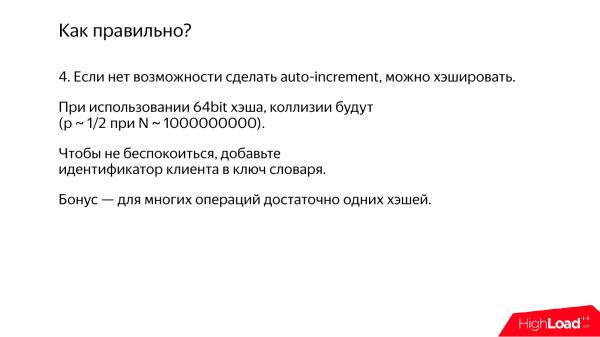
Otro método es cuando no sabe de dónde obtener los identificadores para sus filas. Simplemente puede hacer un hash. Y la manera más sencilla es utilizar un hash de 64 bits.
El único problema es que, si el hash es de 64 bits, habrá colisiones casi seguramente. Porque si hay mil millones de filas, la probabilidad se vuelve significativa.
No sería muy adecuado hacer así el hash de los nombres de las campañas publicitarias. Si las campañas publicitarias de diferentes empresas se confunden, habrá algo confuso.
Y hay un truco simple. Sin embargo, no es muy adecuado para datos serios, pero si se trata de algo no tan grave, simplemente añade el identificador del cliente a la clave del diccionario. Entonces habrá colisiones, pero solo dentro de un mismo cliente. Este método se utiliza en nuestro mapa de enlaces en Yandex.Metrica. Ahí tenemos URLs, almacenamos hashes. Y sabemos que, por supuesto, hay colisiones. Pero cuando se muestra la página, la probabilidad de que en una sola página a un mismo usuario se le agrupen algunas URLs y que se note, se puede ignorar.
Como bonificación, para muchas operaciones solo se necesitan hashes y no es necesario almacenar las cadenas en ningún lugar.
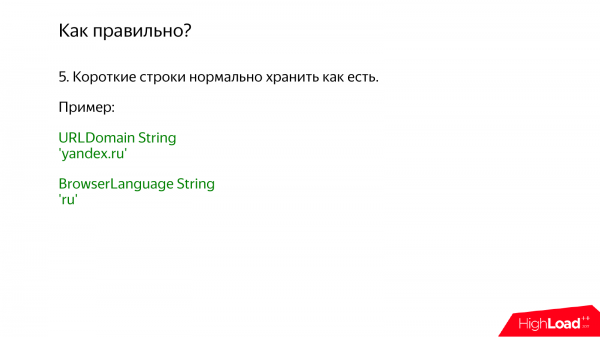
Otro ejemplo, si las cadenas son cortas, por ejemplo, los dominios de los sitios. Se pueden almacenar tal cual. O, por ejemplo, el idioma del navegador ru - 2 bytes. Claro, me da pena los bytes, pero no te preocupes, 2 bytes no son un gran problema. Por favor, almacena tal cual, no te complique.
Otro caso, cuando hay muchas cadenas y además son muy únicas, y hay potencialmente muchas más. Un ejemplo típico son las frases de búsqueda o URLs. Las frases de búsqueda, incluido por errores tipográficos. Veamos cuántas frases de búsqueda únicas hay en un día. Y resulta que son casi la mitad de todos los eventos. En este caso, podrías pensar que se necesita normalizar los datos, contar identificadores, y almacenarlos en una tabla separada. Pero no es necesario hacerlo. Simplemente almacena esas cadenas tal cual.
Mejor no te complicues, porque si se almacenan por separado, se necesitará hacer un join. Y este join, en el mejor de los casos, es acceso aleatorio a la memoria, si es que cabe en la memoria. Si no cabe, entonces habrá problemas.
Y si los datos se almacenan in place, simplemente se leen en el orden necesario desde el sistema de archivos y todo está bien.
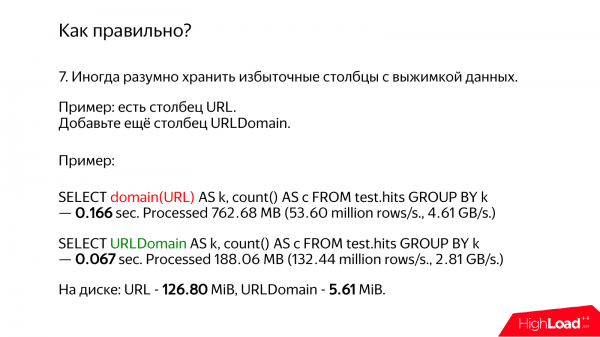
Si tienes URLs o alguna otra cadena larga y complicada, deberías pensar en contar alguna reducción de antemano y registrarla en una columna separada.
Para las URLs, por ejemplo, se puede almacenar el dominio por separado. Y si realmente necesitas el dominio, simplemente usa esa columna, y las URLs quedarán allí, y ni siquiera tendrás que tocarlas.
Veamos cuál es la diferencia. En ClickHouse hay una función especializada que calcula el dominio. Es muy rápida, la hemos optimizado. Y, honestamente, no se ajusta al RFC, pero aun así calcula todo lo que necesitamos.
En un caso, simplemente extraeremos las URLs y calcularemos el dominio. Esto toma 166 milisegundos. Y si tomamos un dominio ya preparado, solo tarda 67 milisegundos, es decir, casi tres veces más rápido. Y esto no se debe a que tenemos que hacer cálculos, sino porque leemos menos datos.
Por alguna razón, una consulta que es más lenta tiene una mayor velocidad de gigabytes por segundo. Porque lee más gigabytes. Estos son datos completamente innecesarios. La consulta parece funcionar más rápido, pero toma más tiempo en completarse.
Si miramos el tamaño de los datos en el disco, vemos que la URL ocupa 126 megabytes, mientras que el dominio solo 5 megabytes. Esto resulta en 25 veces menos. Sin embargo, la consulta se completa solo 4 veces más rápido. Esto se debe a que los datos son 'calientes'. Si fueran 'fríos', seguramente sería 25 veces más rápido debido a la entrada y salida de disco.
A propósito, si evaluamos cuánto más pequeño es el dominio comparado con la URL, resulta que es aproximadamente cuatro veces menor. Pero extrañamente, en el disco, los datos ocupan 25 veces menos. ¿Por qué? Debido a la compresión. Tanto la URL como el dominio se comprimen. Pero a menudo, la URL contiene un montón de basura.
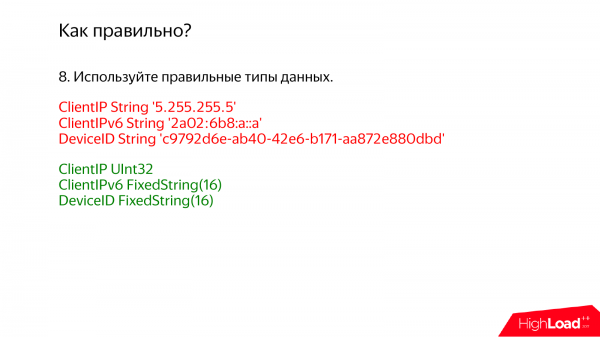
Y, por supuesto, es importante usar los tipos de datos correctos que están diseñados específicamente para los valores necesarios o que son apropiados. Si estás en IPv4, almacena como UInt32*. Si es IPv6, usa FixedString(16), porque la dirección IPv6 son 128 bits, es decir, almacénala directamente en formato binario.
¿Y qué hacer si a veces tienes direcciones IPv4 y a veces IPv6? Sí, puedes almacenar ambos. Una columna para IPv4, otra para IPv6. Claro, hay una opción de mostrar IPv4 en IPv6. Esto también funcionará, pero si a menudo necesitas la dirección IPv4 en las consultas, sería mejor tenerla en una columna separada.
* ahora en ClickHouse hay tipos de datos separados para IPv4, IPv6, que almacenan los datos tan eficientemente como números, pero los representan de manera tan conveniente como cadenas.
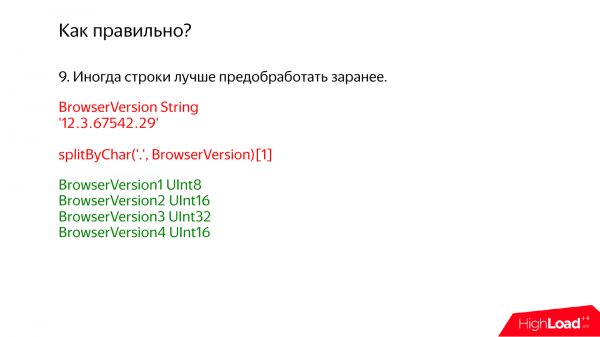
También es importante mencionar que es conveniente preprocesar los datos de antemano. Por ejemplo, si recibes algunos registros en bruto. Y, puede que no debas simplemente volcarlos en ClickHouse, aunque es muy tentador no hacer nada y que todo funcione. Pero aún así, vale la pena realizar los cálculos que se puedan.
Por ejemplo, la versión del navegador. En un departamento cercano, al que no quiero señalar con el dedo, la versión del navegador se almacena de esta manera, es decir, como una cadena: 12.3. Y luego, para hacer un informe, toman esta cadena y la dividen en un array, y luego toman el primer elemento del array. Por supuesto, todo se ralentiza. Les pregunté por qué hacían eso. Me respondieron que no les gusta la optimización prematura. Y a mí no me gusta la pesimización prematura.
Por lo tanto, en este caso será más correcto dividir en 4 columnas. No se asusten, porque esto es ClickHouse. ClickHouse es una base de datos en columnas. Y cuantas más pequeñas y ordenadas columnas haya, mejor será. Si hay 5 versiones del navegador, hagan 5 columnas. Es normal.
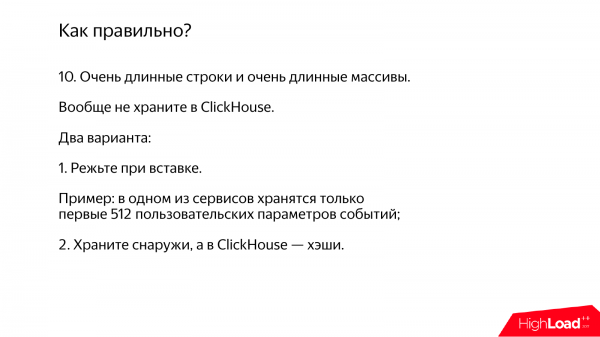
Ahora consideremos qué hacer si tienes muchas cadenas largas, arrays muy largos. No necesitas almacenarlos en ClickHouse en absoluto. En su lugar, puedes guardar en ClickHouse solo algún identificador. Y esas cadenas largas, colócalas en otro sistema.
Por ejemplo, en uno de nuestros servicios analíticos hay ciertos parámetros de eventos. Y si llegan muchos parámetros a los eventos, simplemente guardamos los primeros 512 que encontramos. Porque 512 no es un gran sacrificio.
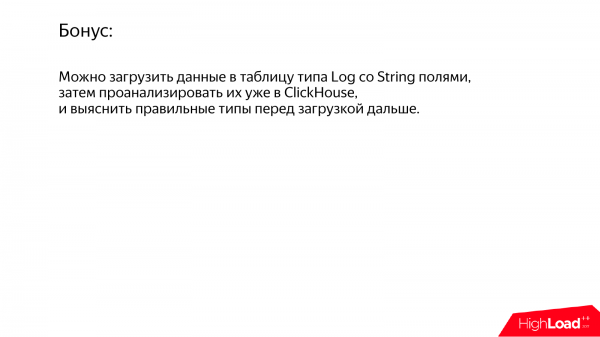
Y si no puedes decidir sobre tus tipos de datos, también puedes grabar los datos en ClickHouse, pero en una tabla temporal de tipo Log, especial para datos temporales. Después de eso, puedes analizar la distribución de valores, qué hay en general y definir los tipos correctos.
* ahora en ClickHouse hay un tipo de dato que permite almacenar cadenas de manera eficiente con menor esfuerzo.
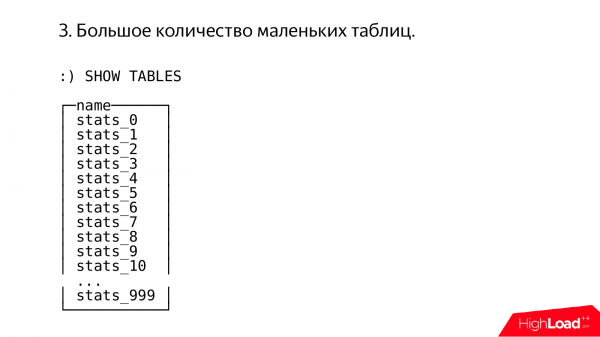
Ahora consideremos otro caso interesante. A veces, las cosas parecen funcionar de manera extraña. Entro y veo esto. Y enseguida se presenta la idea de que esto fue hecho por un administrador muy experimentado e inteligente, con una gran experiencia en la configuración de MySQL versión 3.23.
Aquí vemos mil tablas, cada una de las cuales tiene un residuo de una división de algo indeterminado entre mil.
En principio, respeto la experiencia ajena, también entiendo qué sufrimientos pueden haber dado lugar a esa experiencia.
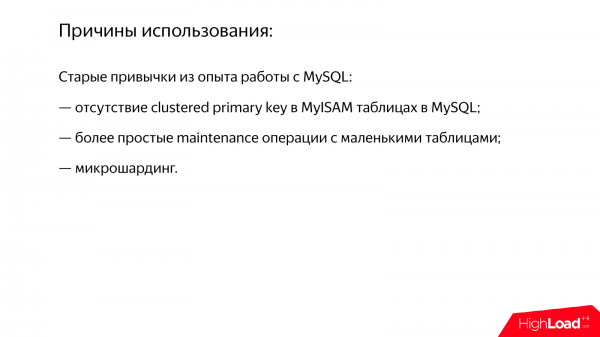
Y las razones son más o menos claras. Son viejos estereotipos que pudieron acumularse al trabajar con otros sistemas. Por ejemplo, en MyISAM las tablas no tienen una clave primaria clustered. Y este método de dividir datos puede ser un intento desesperado de obtener la misma funcionalidad.
Otra razón es que realizar operaciones como alter sobre tablas grandes es difícil. Todo se bloqueará. Aunque en las versiones modernas de MySQL este problema ya no es tan serio.
O, por ejemplo, micrShardering, pero de eso hablaremos un poco más tarde.
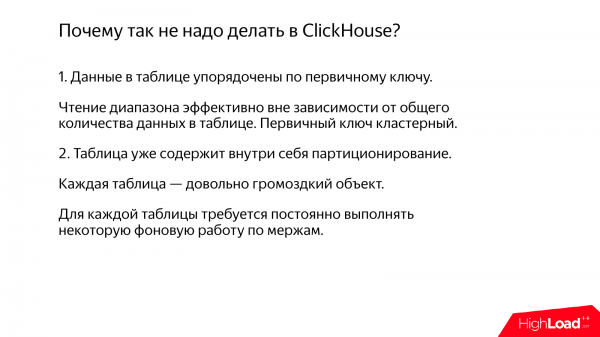
En ClickHouse no hace falta hacer eso, porque, en primer lugar, la clave primaria es clustered, los datos están ordenados por la clave primaria.
Y a veces me preguntan: "¿Cómo cambia el rendimiento de las consultas por rango en ClickHouse en función del tamaño de la tabla?". Yo digo que no cambia en absoluto. Por ejemplo, si tienes una tabla de mil millones de filas y lees un rango de un millón de filas. Todo está bien. Si en la tabla hay un billón de filas y lees un millón de filas, será prácticamente lo mismo.
Y, en segundo lugar, no se requieren cosas como particiones manuales. Si entras y miras lo que hay en el sistema de archivos, verás que la tabla es algo bastante serio. Y dentro hay algo como particiones. Es decir, ClickHouse lo hace todo por ti y no necesitas sufrir.
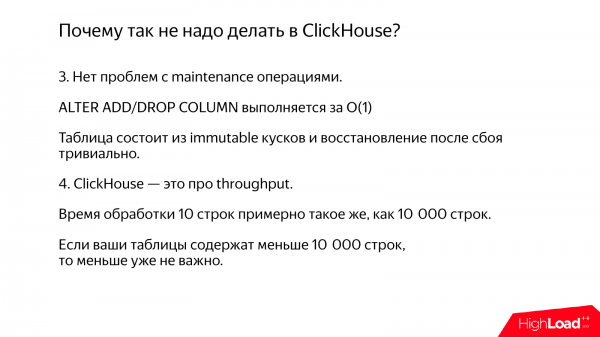
El alter en ClickHouse es gratuito si es alter add/drop column.
Y no vale la pena crear tablas pequeñas, porque si tienes 10 filas o 10,000 filas en la tabla, no importa en absoluto. ClickHouse es un sistema que optimiza el rendimiento, no la latencia, así que procesar 10 filas no tiene sentido.
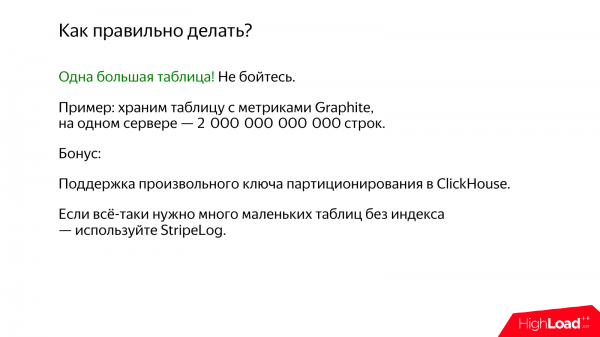
Es correcto usar una tabla grande. Deshazte de los viejos estereotipos, todo estará bien.
Y como bono, en nuestra última versión ha surgido la posibilidad de hacer una clave de particionamiento arbitraria para realizar diversas operaciones de mantenimiento en particiones individuales.
Por ejemplo, necesitas muchas tablas pequeñas, como cuando hay una necesidad de procesar algunos datos intermedios, recibes fragmentos y necesitas realizar transformaciones sobre ellos antes de escribir en la tabla final. Para este caso, hay un motor de tablas excelente: StripeLog. Es similar a TinyLog, pero mejor.
* ahora en ClickHouse también hay .
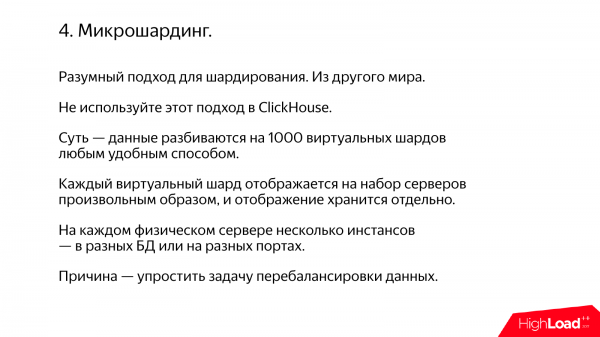
Otro antipatrón es el microsharding. Por ejemplo, necesitas shardear los datos y tienes 5 servidores, pero mañana habrá 6 servidores. Y piensas en cómo equilibrar esos datos. En lugar de eso, divides no en 5 shards, sino en 1,000 shards. Luego, asignas cada uno de estos microshards a un servidor diferente. Así, tendrás en un servidor, por ejemplo, 200 ClickHouse, por ejemplo. Instancias separadas en puertos distintos o bases de datos separadas.
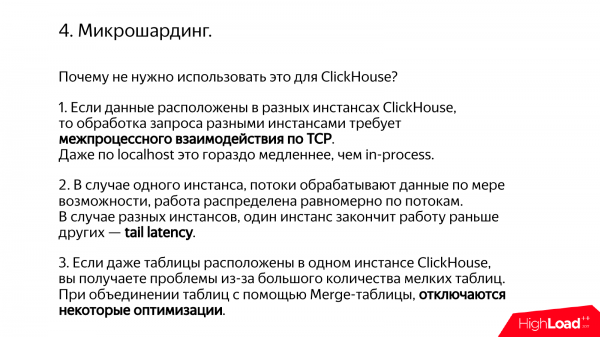
Pero en ClickHouse esto no es muy bueno. Porque incluso una instancia de ClickHouse intenta utilizar todos los recursos disponibles del servidor para procesar una sola consulta. Es decir, tienes un servidor con, por ejemplo, 56 núcleos de procesamiento. Realizas una consulta que tarda un segundo en ejecutarse, y utilizará 56 núcleos. Si colocaste 200 ClickHouse en un solo servidor, resulta que se iniciarán 10,000 hilos. En general, será un desastre.
Otra razón es que la distribución del trabajo entre estas instancias será desigual. Algunas terminarán antes, otras después. Si todo ocurriera en una única instancia, ClickHouse podría manejar cómo distribuir correctamente los datos entre los hilos.
Y otra razón es que habrá interacción interprocesador a través de TCP. Los datos tendrán que ser serializados, deserializados y, con esta enorme cantidad de microshards, simplemente no funcionará de manera eficiente.
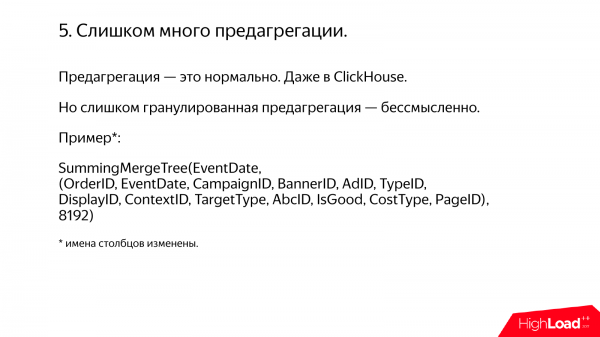
Otro antipatrón, aunque es difícil de clasificar como tal, es una gran cantidad de preagregación.
En general, la preagregación es buena. Tenías mil millones de filas, las agregaste y ahora tienes 1,000 filas, y la consulta se ejecuta al instante. Todo es maravilloso. Se puede hacer así. Y para ello, incluso en ClickHouse hay un tipo especial de tabla, AggregatingMergeTree, que realiza preagregación incremental a medida que se insertan datos.
Pero hay ocasiones en las que piensas que vamos a agregar datos así y también así. Y en algún departamento vecino, tampoco quiero decir cuál, utilizan tablas SummingMergeTree para sumar por la clave primaria, y como clave primaria utilizan unas 20 columnas variadas. He cambiado por si acaso algunos nombres de columnas para la discreción, pero es más o menos así.
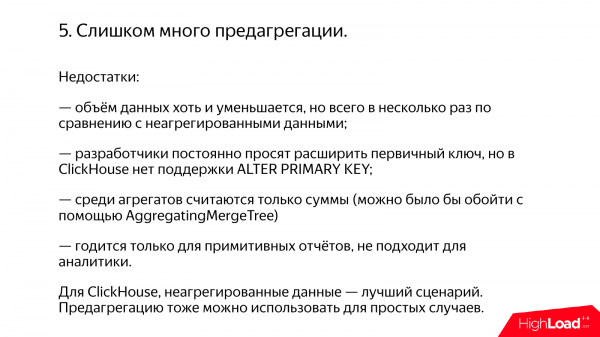
Y surgen problemas así. En primer lugar, el volumen de datos no se reduce mucho. Por ejemplo, se reduce a tres veces. Tres veces sería un buen precio para permitirse posibilidades ilimitadas en análisis, las cuales surgen si los datos no están agregados. Si los datos están agregados, en lugar de análisis obtienes solo estadísticas lamentables.
¿Y qué es lo que realmente molesta? Que estas personas del departamento vecino vienen y a veces piden añadir otra columna a la clave primaria. Es decir, así hemos agregado los datos, y ahora queremos un poco más. Pero en ClickHouse no hay un comando para modificar la clave primaria. Así que hay que escribir algún tipo de scripts en C++. Y no me gustan los scripts, incluso si son en C++.
Y si miras para qué fue creado ClickHouse, los datos no agregados son justo el escenario para el cual nació. Si utilizas ClickHouse para datos no agregados, estás haciendo todo bien. Si agregas, a veces es comprensible.
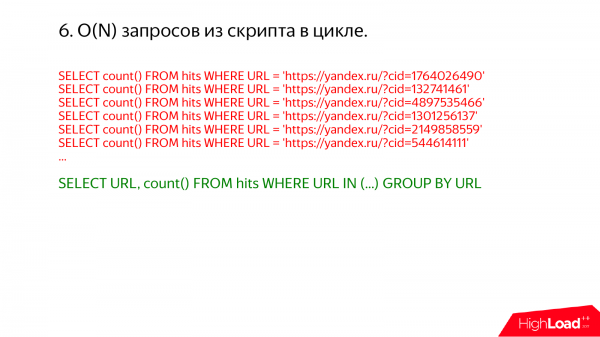
Otro caso interesante son las consultas en un ciclo infinito. A veces accedo a algún servidor de producción y miro el show processlist. Y cada vez descubro que está ocurriendo algo horrible.
Por ejemplo, esto. Aquí está claro que todo podría haberse ejecutado en una sola consulta. Simplemente escribe allí url in y la lista.
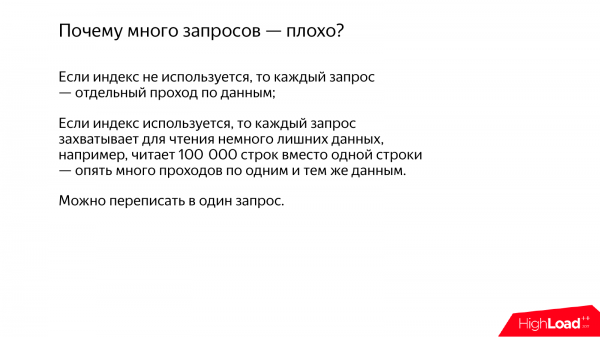
¿Por qué tener muchas consultas en un ciclo infinito es malo? Si no se utiliza un índice, tendrás muchos recorridos por los mismos datos. Pero si se utiliza un índice, por ejemplo, tienes una clave primaria por ru y escribes url = algo. Y piensas que leerá de la tabla un solo url, todo estará bien. Pero en realidad no es así. Porque ClickHouse lo hace todo por lotes.
Cuando necesita leer un rango de datos, lee un poco más porque el índice en ClickHouse es disperso. Este índice no permite encontrar una fila individual en la tabla, solo un rango. Y los datos se comprimen en bloques. Para leer una fila, hay que tomar todo un bloque y descomprimirlo. Y si realiza muchas consultas, tendrá muchas intersecciones de estas, y mucho trabajo se estará realizando una y otra vez.
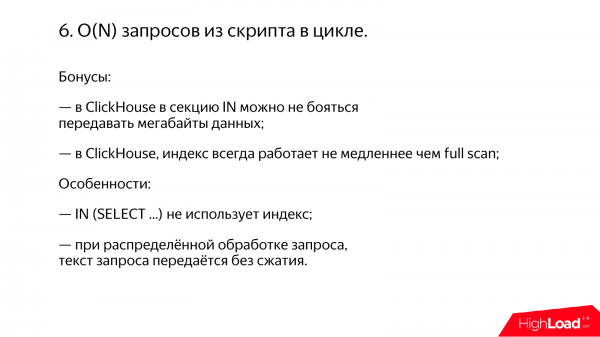
Y como bonus, se puede notar que en ClickHouse no hay que tener miedo de pasar incluso megabytes y hasta cientos de megabytes en la sección IN. Recuerdo de nuestra práctica que si en MySQL pasamos un montón de valores en la sección IN, por ejemplo, pasamos 100 megabytes de algunos números, entonces MySQL consume 10 gigabytes de memoria y no sucede nada más, todo funciona mal.
Y lo segundo es que en ClickHouse, si sus consultas utilizan un índice, nunca será más lento que un escaneo completo, es decir, si se necesita leer casi toda la tabla, lo hará de manera secuencial y leerá toda la tabla. En general, se las arreglará solo.
Sin embargo, hay algunas dificultades. Por ejemplo, el IN con una subconsulta no utiliza el índice. Pero ese es nuestro problema y debemos solucionarlo. No hay nada fundamental aquí. Lo estaremos arreglando.
Y otra cosa interesante es que si tiene una consulta muy larga y el procesamiento de consultas es distribuido, entonces esta consulta muy larga se enviará a cada servidor sin compresión. Por ejemplo, 100 megabytes y 500 servidores. Y, por lo tanto, se transmitirán 50 gigabytes por la red. Se transmitirá y luego todo se ejecutará correctamente.
* ya se está utilizando; todo lo repararon, como se prometió.
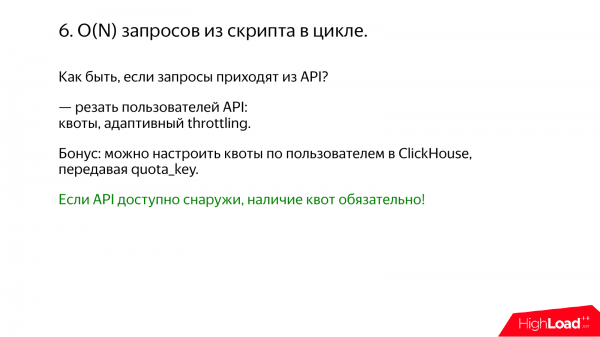
Y es un caso bastante frecuente que las consultas provienen de API. Por ejemplo, creó algún servicio. Y si su servicio es necesario para alguien, abre un API y literalmente en dos días ve que sucede algo incomprensible. Todo está sobrecargado y llegan algunas consultas horrorosas que nunca debieron ser.
Y la solución es una. Si ha abierto un API, tendrá que limitarlo. Por ejemplo, introducir cuotas. No hay otras opciones normales. De lo contrario, inmediatamente escribirán un script y habrá problemas.
En ClickHouse hay una función especial: el conteo de cuotas. Se puede pasar su propia clave de cuota, que puede ser, por ejemplo, un identificador interno de usuario. Las cuotas se calcularán de forma independiente para cada uno de ellos.
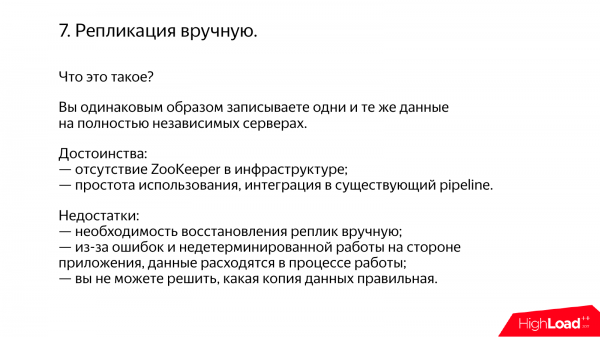
Ahora hay otra cosa interesante. Es la replicación manual.
Conozco muchos casos en los que, a pesar de que ClickHouse tiene soporte incorporado para la replicación, las personas replican ClickHouse manualmente.
¿Cuál es el principio? Tienes un pipeline de procesamiento de datos. Y funciona de manera independiente, por ejemplo, en diferentes centros de datos. Estás escribiendo los mismos datos de la misma manera en ClickHouse. Sin embargo, la práctica muestra que los datos seguirán divergentes debido a algunas peculiaridades en tu código. Espero que en el tuyo no sea así.
Y periódicamente todavía tendrás que sincronizar manualmente. Por ejemplo, una vez al mes, los administradores hacen un rsync.
En realidad, es mucho más fácil utilizar la replicación integrada en ClickHouse. Pero aquí puede haber algunas contraindicaciones, ya que para esto se necesita usar ZooKeeper. No diré nada malo sobre ZooKeeper, en principio, el sistema funciona, pero a veces las personas no lo utilizan por fobia a Java, porque ClickHouse es un excelente sistema escrito en C++ que se puede utilizar y funcionará a la perfección. Y ZooKeeper está en Java. Y de alguna manera no se quiere mirar, pero entonces se puede usar la replicación manual.
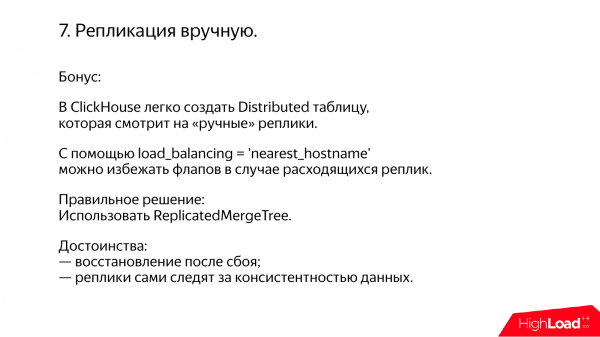
ClickHouse es un sistema práctico. Tiene en cuenta tus necesidades. Si tienes replicación manual, puedes crear una tabla Distributed que observe tus réplicas manuales y realice un failover entre ellas. Y hay incluso una opción especial que permite evitar flaps, incluso si tus réplicas divergen sistemáticamente.
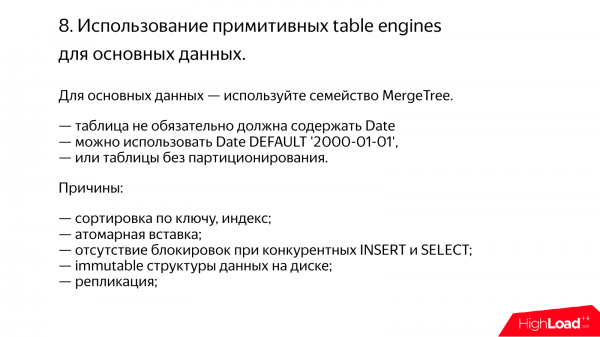
A continuación, pueden surgir problemas si usas motores de tabla primitivos. ClickHouse es como un constructor que tiene un montón de diferentes motores de tablas. Para todos los casos serios, como se indica en la documentación, utiliza tablas de la familia MergeTree. Los demás son así, para casos aislados o para pruebas.
En la tabla MergeTree no es necesario que tengas alguna fecha y hora. Aún así, puedes usarlas. Si no hay fecha y hora, escribe que el default es el año 2000. Esto funcionará y no requerirá recursos.
En la nueva versión del servidor, incluso puede especificar que tenga un particionamiento personalizado sin clave de partición. Será lo mismo.
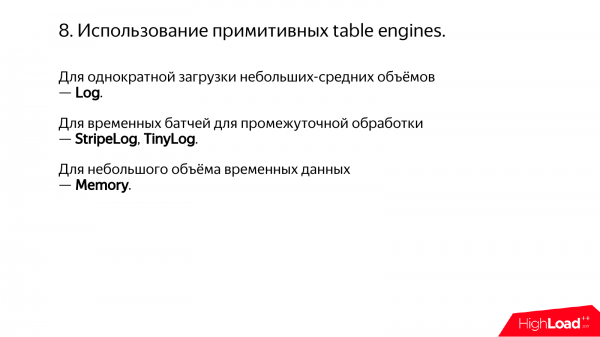
Por otro lado, se pueden utilizar motores de tablas primitivos. Por ejemplo, cargar datos una vez y observar, manipular y eliminar. Puede usar Log.
O almacenar pequeños volúmenes para procesamiento intermedio: eso es StripeLog o TinyLog.
Memory se puede usar si hay un pequeño volumen de datos y simplemente desea manipular algo en la RAM.
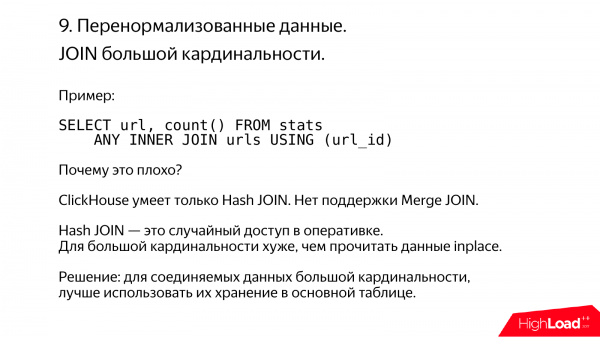
ClickHouse no es muy compatible con datos sobre-normalizados.
Aquí hay un ejemplo típico. Es una gran cantidad de URLs. Las metiste en una tabla secundaria. Y luego decidiste hacer un JOIN, pero eso no funcionará, por lo general, porque ClickHouse solo admite Hash JOIN. Si la RAM no es suficiente para la gran cantidad de datos que se necesitan unir, no podrás realizar el JOIN*.
Si los datos tienen alta cardinalidad, no te preocupes, guárdalos en forma denormalizada, las URLs directamente en la tabla principal.
* Ahora ClickHouse también tiene merge join, y funciona cuando los datos intermedios no caben en la RAM. Pero eso no es eficiente y la recomendación sigue siendo válida.
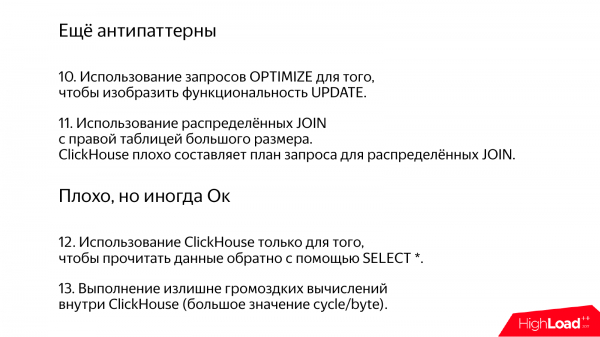
Aquí hay un par de ejemplos más, pero ya empiezo a dudar de si son antipatrón o no.
ClickHouse tiene una desventaja conocida. No puede realizar actualizaciones*. En cierto modo, eso es incluso bueno. Si tienes algún dato importante, por ejemplo, en contabilidad, nadie podrá enviarlo, porque no hay actualizaciones.
* Ya se ha añadido el soporte para actualizaciones y eliminaciones en modo batch.
Pero hay algunos métodos especiales que permiten hacer actualizaciones como si fuera en segundo plano. Por ejemplo, tablas del tipo ReplaceMergeTree. Realizan actualizaciones durante las fusiones en segundo plano. Puedes forzarlo usando optimize table. Pero no lo hagas con demasiada frecuencia, porque eso implicaría una reescritura completa de la partición.
Los JOIN distribuidos en ClickHouse también son mal tratados por el planificador de consultas.
Mal, pero a veces está bien.
Usar ClickHouse solo para leer datos nuevamente mediante select*.
No recomendaría utilizar ClickHouse para cálculos difíciles. Pero no es del todo cierto, porque ya estamos alejándonos de esa recomendación. Y recientemente hemos añadido la posibilidad de aplicar modelos de aprendizaje automático en ClickHouse: Catboost. Y esto me preocupa, porque pienso: '¡Qué horror! ¿Cuántos ciclos por byte obtenemos?'. Me duele desperdiciar ciclos en bytes.
Pero no temas, instala ClickHouse, todo estará bien. Si algo, tenemos una comunidad. Por cierto, la comunidad son ustedes. Y si tienen algún problema, al menos pueden entrar a nuestro chat, y espero que les ayuden.
Preguntas
¡Gracias por la presentación! ¿Dónde puedo quejarme de la caída de ClickHouse?
Pueden quejarse conmigo personalmente ahora mismo.
Recientemente comencé a usar ClickHouse. Caí el cli inmediatamente.
Tienes suerte.
Un poco más tarde caí el servidor con un pequeño select.
Tienes talento.
Abrí un bug en GitHub, pero lo ignoraron.
Veremos.
Aleksey me engañó para que asistiera a la presentación, prometiendo contar cómo presionan los datos internamente.
Es muy sencillo.
Eso ya lo entendí ayer. Más concretamente.
No hay trucos horribles allí. Simplemente compresión por bloques. Por defecto se usa LZ4, se puede activar ZSTD*. Bloques de 64 kilobytes a 1 megabyte.
* también hay soporte para códecs de compresión especializados que se pueden usar en cadena con otros algoritmos.
¿Los bloques simplemente contienen datos en crudo?
No son totalmente crudos. Hay matrices. Si tienes una columna numérica, los números están dispuestos en una matriz.
Entiendo.
Aleksey, el ejemplo que tuvimos con uniqExact sobre direcciones IP, es decir, lo que uniqExact se calcula más lento en cadenas que en números, etc. ¿Y si aplicamos una maniobra y hacemos un casting en el momento de la lectura? Es decir, ustedes dijeron que en el disco no varía mucho. Si leemos las cadenas desde el disco y hacemos casting, ¿entonces nuestros agregados serán más rápidos o no? ¿O de hecho no ganamos significativamente aquí? Me parece que ustedes lo testearon, pero por alguna razón no lo indicaron en el benchmark.
Creo que será más lento que sin el casting. En este caso, hay que analizar la dirección IP de la cadena. Por supuesto, en ClickHouse también optimizamos el análisis de direcciones IP. Hicimos un gran esfuerzo, pero allí los números están registrados en forma de diez milésimas. Es muy incómodo. Por otro lado, la función uniqExact funcionará más lentamente con cadenas, no solo porque son cadenas, sino también porque se elige otra especialización del algoritmo. Las cadenas simplemente se procesan de manera diferente.
¿Y si tomamos un tipo de dato más primitivo? Por ejemplo, escribimos el user id que tenemos en, lo anotamos como cadena, y luego lo casteamos, ¿será más divertido o no?
Dudo. Creo que será incluso más triste, porque analizar números sigue siendo un problema serio. Me parece que este colega incluso tuvo una charla sobre lo difícil que es analizar números en forma de diez milésimas, o tal vez no.
¡Alexey, muchas gracias por la charla! Y también muchas gracias por ClickHouse. Tengo una pregunta sobre los planes. ¿Hay planes para una característica que permita actualizar diccionarios de manera parcial?
Es decir, ¿recarga parcial?
Sí, sí. Como la posibilidad de especificar un campo en MySQL, es decir, actualizar después, para que solo se carguen esos datos si el diccionario es muy grande.
Es una característica muy interesante. Y creo que alguien la propuso en nuestro chat. Podría ser que fuiste tú.
No creo que lo haya hecho.
Excelente, así que ahora hay dos solicitudes. Y se puede empezar a hacerlo sin prisa. Pero quiero advertirte que esta característica es bastante simple de implementar. Es decir, en teoría solo hay que escribir el número de versión en la tabla y luego escribir: versión menor que tal. Y esto significa que, probablemente, le sugeriremos hacerlo a los entusiastas. ¿Eres un entusiasta?
Sí, pero, desafortunadamente, no en C++.
¿Tus colegas saben escribir en C++?
Encontraré a alguien.
Excelente*.
* la posibilidad fue añadida dos meses después de la charla – la desarrolló el autor de la pregunta y la envió. .
¡Gracias!
¡Hola! ¡Gracias por la presentación! Mencionaste que ClickHouse consume muy bien todos los recursos disponibles. Y el presentador de Luxoft hablaba sobre su solución para Correos de Rusia. Dijo que estaban muy satisfechos con ClickHouse, pero no lo usaron en lugar de su principal competidor precisamente porque consumía todo el procesador. Y no pudieron integrarlo en su arquitectura, en su ZooKeeper con Docker. ¿Hay alguna forma de limitar a ClickHouse para que no consuma todo lo que le está disponible?
Sí, se puede y es muy fácil. Si deseas que consuma menos núcleos, simplemente escribe set max_threads = 1. Y listo, la consulta se ejecutará en un núcleo. Además, se puede configurar este ajuste de manera diferente para distintos usuarios. Así que no hay problemas. Y diles a mis colegas de Luxoft que no está bien que no encontraran esta configuración en la documentación.
¡Hola, Alexey! Quería preguntarte sobre algo. Ya no es la primera vez que escucho que muchos comienzan a usar ClickHouse como almacenamiento de logs. En la presentación dijiste que no deberían hacerlo, es decir, no hay que almacenar cadenas largas. ¿Cuál es tu opinión al respecto?
Primero que nada, los logs, por lo general, no son cadenas largas. Por supuesto, hay excepciones. Por ejemplo, algún servicio escrito en Java que lanza una excepción y se registra. Y así en un ciclo infinito, ocupando el espacio en el disco duro. La solución es muy simple. Si las cadenas son muy largas, córtalas. ¿Y qué significa largas? Decenas de kilobytes está mal.
* En las versiones recientes de ClickHouse, se ha incluido la 'granularidad adaptativa del índice', lo que elimina en gran medida el problema del almacenamiento de cadenas largas.
¿Y un kilobyte está bien?
Está bien.
¡Hola! ¡Gracias por la presentación! Ya hice esta pregunta en el chat, pero no recuerdo si recibí respuesta. ¿Se planea expandir la sección WITH a la manera de CTE?
Por ahora no. La sección WITH es algo poco seria. Para nosotros es solo una pequeña característica.
Entiendo. ¡Gracias!
¡Gracias por la presentación! ¡Muy interesante! Una pregunta global. ¿Se planea hacer, quizás, alguna modificación para la eliminación de datos en forma de marcadores?
Sin falta. Esa es nuestra primera tarea en la cola. Actualmente estamos pensando activamente en cómo hacer todo correctamente. Y es el momento de empezar a teclear.
* pulsamos las teclas del teclado y lo hicimos todo.
¿Esto afectará de alguna manera el rendimiento del sistema o no? ¿La inserción seguirá siendo tan rápida como ahora?
Es posible que las eliminaciones y actualizaciones sean muy pesadas, pero esto no afectará el rendimiento de las selecciones ni de las inserciones.
Y otra pequeña pregunta. En la presentación hablaste sobre la clave primaria. Por lo tanto, tenemos particionamiento, que por defecto es mensual, ¿correcto? Y cuando establecemos un rango de fechas que cabe dentro de un mes, solo se lee esa partición, ¿verdad?
Sí.
Una pregunta. Si no podemos identificar ninguna clave primaria, ¿es correcto hacerla por el campo 'Fecha' para que en segundo plano haya menos reestructuración de esos datos, para que estén más ordenados? Si no tienes consultas de rango y no puedes elegir ninguna clave primaria, ¿vale la pena incluir la fecha en la clave primaria?
Sí.
Quizás tenga sentido incluir en la clave primaria un campo que permita que los datos se compriman mejor si están ordenados por ese campo. Por ejemplo, el identificador del usuario. El usuario, por ejemplo, visita el mismo sitio web. En este caso, pones el id del usuario y el tiempo. Así los datos se comprimirán mejor. En cuanto a la fecha, si realmente no tienes y nunca tienes consultas de rango por fechas, entonces no es necesario incluir la fecha en la clave primaria.
¡Bien, muchas gracias!
Fuente: habr.com
