

Continuando con el tema de registrar grandes flujos de datos, planteado , en este exploraremos las maneras en que se puede reducir el tamaño 'físico' del almacenamiento en PostgreSQL y su impacto en el rendimiento del servidor.
Vamos a hablar sobre configuraciones de TOAST y alineación de datos. 'En promedio', estas alternativas permiten ahorrar no demasiado recursos, pero sí — sin modificar el código de la aplicación.
Sin embargo, nuestra experiencia resultó ser bastante productiva en este sentido, dado que el almacenamiento de casi cualquier monitoreo por su naturaleza es en su mayor parte append-only en términos de datos registrados. Y si te interesa cómo se puede enseñar a la base a escribir en disco en lugar de 200MB/s la mitad — te invito a seguir leyendo.
Pequeños secretos de grandes datos
Por el perfil de trabajo , recibe regularmente desde los logs paquetes de texto.
Y dado que , cuyas bases de datos monitoreamos, es un producto multicomponente con estructuras de datos complejas, las consultas para lograr la máxima performance resultan bastante . Así que el tamaño de cada instancia individual de consulta o plan de ejecución resultado en el log que recibimos resulta ser 'en promedio' bastante grande.
Veamos la estructura de una de las tablas en las que escribimos datos 'crudos' — es decir, justo el texto original del registro del log:
CREATE TABLE rawdata_orig(
  pack -- PK
    uuid NOT NULL
, recno -- PK
    smallint NOT NULL
, dt -- clave de sección
    date
, data -- lo más importante
    text
, PRIMARY KEY(pack, recno)
);
Una tabla típica (ya particionada, por supuesto, así que esto es un template de sección), donde lo más importante es el texto. A veces, bastante voluminoso.
Recordemos que el tamaño 'físico' de un registro en PG no puede ocupar más de una página de datos, pero el tamaño 'lógico' es otra historia. Para insertar un valor voluminoso en un campo (varchar/text/bytea) se utiliza :
PostgreSQL utiliza un tamaño de página fijo (generalmente 8 KB) y no permite que las tuplas ocupen varias páginas. Por lo tanto, no es posible almacenar directamente valores de campos muy grandes. Para superar esta limitación, los valores grandes de los campos se comprimen y/o se dividen en varias filas físicas. Esto sucede de manera transparente para el usuario y tiene un impacto insignificante en la mayor parte del código del servidor. Este método se conoce como TOAST …
De hecho, para cada tabla con campos "potencialmente grandes" se crea automáticamente de cada registro "grande" en segmentos de 2KB:
TOAST(
  chunk_id
    integer
, chunk_seq
    integer
, chunk_data
    bytea
, PRIMARY KEY(chunk_id, chunk_seq)
);
Es decir, si tenemos que grabar una fila con un valor "grande" data, la grabación real ocurrirá no solo en la tabla principal y su clave primaria, sino también en TOAST y su clave primaria..
Reduciendo el impacto de TOAST
Pero la mayoría de nuestros registros no son tan grandes, deberían caber en 8KB. ¿Cómo podemos ahorrar en esto?
Aquí entra en juego el atributo de la columna de la tabla:
- EXTENDED permite tanto la compresión como el almacenamiento separado. Esta es la opción estándar para la mayoría de los tipos de datos compatibles con TOAST. Primero se intenta realizar la compresión, luego se guarda fuera de la tabla si la fila sigue siendo demasiado grande.
- MAIN permite compresión, pero no almacenamiento separado. (De hecho, el almacenamiento separado, sin embargo, se llevará a cabo para esas columnas, pero solo como último recurso, cuando no hay otra manera de reducir la fila de manera que quepa en la página.)
De hecho, esto es exactamente lo que necesitamos para el texto — comprimir al máximo, y si no cabe de ninguna manera — sacarlo a TOAST.Esto se puede hacer directamente "sobre la marcha", con un solo comando:
ALTER TABLE rawdata_orig ALTER COLUMN data SET STORAGE MAIN;Cómo evaluar el efecto
Dado que cada día el flujo de datos cambia, no podemos comparar cifras absolutas, pero en relativos, cuanto menor porcentaje hay en TOAST — mejor. Pero aquí hay un peligro: cuanto mayor sea nuestro volumen "físico" de cada registro individual, más "amplio" se vuelve el índice, ya que es necesario cubrir una mayor cantidad de páginas de datos.
Sección antes de los cambios:
heap  = 37GB (39%)
TOAST = 54GB (57%)
PK    =  4GB ( 4%)
Sección después de los cambios:
heap  = 37GB (67%)
TOAST = 16GB (29%)
PK    =  2GB ( 4%)
De hecho, hemos comenzado a escribir en TOAST con el doble de frecuencia., lo que liberó no solo el disco, sino también la CPU:
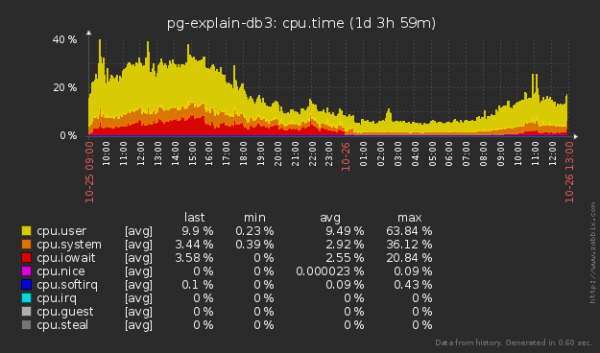
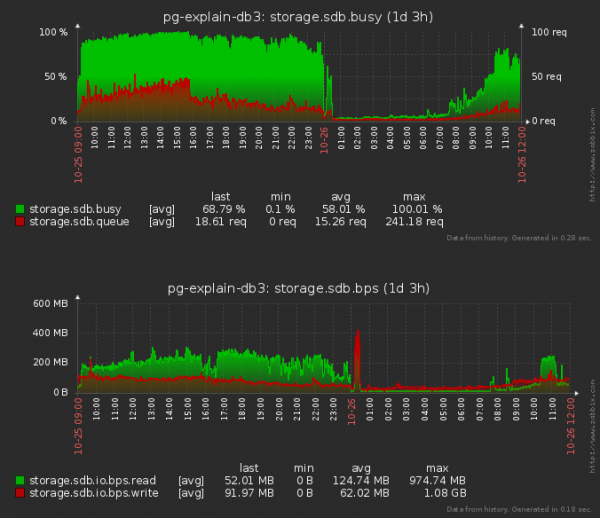
Cabe destacar que ahora ‘leemos’ menos el disco, no solo ‘escribimos’ — ya que al insertar un registro en alguna tabla, hay que ‘leer’ también parte del árbol de cada uno de los índices para determinar su futura posición en ellos.
A quién le va bien vivir en PostgreSQL 11
Después de actualizar a PG11, decidimos continuar con la ‘optimización’ de TOAST y notamos que a partir de esta versión se hizo disponible un parámetro para su configuración :
El código de manejo de TOAST se activa solo cuando el valor de la fila que debe almacenarse en la tabla supera el tamaño de TOAST_TUPLE_THRESHOLD bytes (generalmente son 2 Kb). El código de TOAST comprimirá y/o moverá los valores del campo fuera de la tabla hasta que el valor de la fila sea menor que TOAST_TUPLE_TARGET bytes (un valor variable, que también suele ser 2 Kb) o no se podrá reducir su tamaño.
Decidimos que nuestros datos suelen ser ‘muy cortos’ o ‘muy largos’, así que decidimos limitarnos al valor mínimo posible:
ALTER TABLE rawplan_orig SET (toast_tuple_target = 128);Veamos cómo las nuevas configuraciones han afectado a la carga del disco después de la reconfiguración:
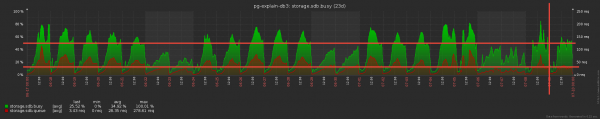
¡No está mal! La cola hacia el disco se redujo aproximadamente en 1.5 veces, y la ‘ocupación’ del disco — un 20% menos. Pero, ¿podría esto haber afectado a la CPU?
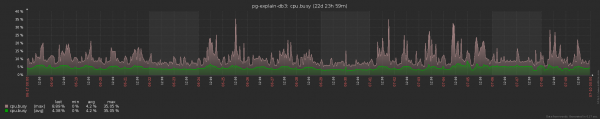
Al menos no ha empeorado. Aunque es difícil opinar, si incluso estos volúmenes no pueden elevar la carga promedio de la CPU por encima de 5%.
¡El cambio de lugar de los sumandos… ¡cambia la suma!
Como es bien sabido, el centavo ahorra el rublo, y con nuestros volúmenes de almacenamiento de aproximadamente 10TB/mes incluso una pequeña optimización puede ofrecer un buen beneficio. Así que prestamos atención a la estructura física de nuestros datos — como específicamente los campos están 'dispuestos' dentro del registro de cada una de las tablas.
Porque debido a esto influye directamente :
Muchas arquitecturas hacen de la alineación de datos un requisito a los límites de palabras de la máquina. Por ejemplo, en un sistema de 32 bits x86, los enteros (tipo integer, que ocupa 4 bytes) estarán alineados a la frontera de palabras de 4 bytes, al igual que los números de punto flotante de doble precisión (tipo double precision, 8 bytes). Y en un sistema de 64 bits, los valores dobles estarán alineados a la frontera de palabras de 8 bytes. Esta es otra razón para la incompatibilidad.
Debido a la alineación, el tamaño de la fila de la tabla depende del orden de los campos. Normalmente, este efecto no es muy notable, pero en algunos casos puede provocar un aumento considerable en el tamaño. Por ejemplo, si se mezclan campos de tipos char(1) e integer, entre ellos, por lo general, se perderán 3 bytes de manera innecesaria.
Comencemos con modelos sintéticos:
SELECT pg_column_size(ROW(
  '0000-0000-0000-0000-0000-0000-0000-0000'::uuid
, 0::smallint
, '2019-01-01'::date
));
-- 48 bytes

SELECT pg_column_size(ROW(
  '2019-01-01'::date
, '0000-0000-0000-0000-0000-0000-0000-0000'::uuid
, 0::smallint
));
-- 46 bytes
¿De dónde provienen un par de bytes adicionales en el primer caso? Es simple — un smallint de 2 bytes se alinea a un límite de 4 bytes antes del siguiente campo, y cuando ocupa la última posición, no hay nada que alinear y no se necesita.
En teoría, todo está bien y se pueden mover los campos de cualquier manera. Verifiquemos con datos reales usando como ejemplo una de las tablas, cuya sección diaria ocupa entre 10-15GB.
Estructura original:
CREATE TABLE public.plan_20190220
(
-- Heredada de la tabla plan:  pack uuid NOT NULL,
-- Heredada de la tabla plan:  recno smallint NOT NULL,
-- Heredada de la tabla plan:  host uuid,
-- Heredada de la tabla plan:  ts timestamp with time zone,
-- Heredada de la tabla plan:  exectime numeric(32,3),
-- Heredada de la tabla plan:  duration numeric(32,3),
-- Heredada de la tabla plan:  bufint bigint,
-- Heredada de la tabla plan:  bufmem bigint,
-- Heredada de la tabla plan:  bufdsk bigint,
-- Heredada de la tabla plan:  apn uuid,
-- Heredada de la tabla plan:  ptr uuid,
-- Heredada de la tabla plan:  dt date,
  CONSTRAINT plan_20190220_pkey PRIMARY KEY (pack, recno),
  CONSTRAINT chck_ptr CHECK (ptr IS NOT NULL),
  CONSTRAINT plan_20190220_dt_check CHECK (dt = '2019-02-20'::date)
)
INHERITS (public.plan)
La sección después de cambiar el orden de las columnas — exactamente los mismos campos, solo en otro orden:
CREATE TABLE public.plan_20190221
(
-- Heredada de la tabla plan:  dt date NOT NULL,
-- Heredada de la tabla plan:  ts timestamp with time zone,
-- Heredada de la tabla plan:  pack uuid NOT NULL,
-- Heredada de la tabla plan:  recno smallint NOT NULL,
-- Heredada de la tabla plan:  host uuid,
-- Heredada de la tabla plan:  apn uuid,
-- Heredada de la tabla plan:  ptr uuid,
-- Heredada de la tabla plan:  bufint bigint,
-- Heredada de la tabla plan:  bufmem bigint,
-- Heredada de la tabla plan:  bufdsk bigint,
-- Heredada de la tabla plan:  exectime numeric(32,3),
-- Heredada de la tabla plan:  duration numeric(32,3),
  CONSTRAINT plan_20190221_pkey PRIMARY KEY (pack, recno),
  CONSTRAINT chck_ptr CHECK (ptr IS NOT NULL),
  CONSTRAINT plan_20190221_dt_check CHECK (dt = '2019-02-21'::date)
)
INHERITS (public.plan)
El volumen total de la sección se determina por la cantidad de "hechos" y depende únicamente de procesos externos, por lo tanto, dividimos el tamaño heap (pg_relation_size) sobre el número de registros en ella — es decir, obtendremos el tamaño medio de un registro almacenado real:
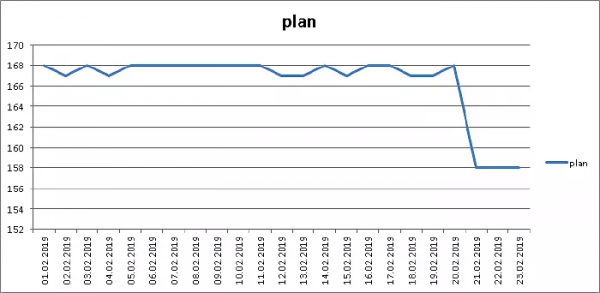
Menos 6% del volumen, ¡excelente!
Pero, por supuesto, no todo es tan color de rosa — porque en los índices no podemos cambiar el orden de los campos, y por lo tanto "en general" (pg_total_relation_size)…
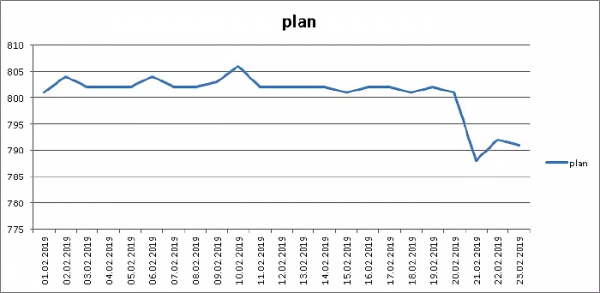
… a pesar de ello aquí también ahorramos un 1.5%, sin cambiar una línea de código. ¡Así es!
Quiero señalar que la disposición de campos mencionada anteriormente no es un hecho de que sea la más óptima. Porque algunos bloques de campos no queremos "romper" ya por razones estéticas — por ejemplo, un par (pack, recno), que es la PK para esta tabla.
En general, la definición de la disposición "mínima" de campos es una tarea de "búsqueda" bastante sencilla. Por lo tanto, puedes obtener resultados en tus propios datos incluso mejores que los nuestros — ¡pruébalo!
Fuente: habr.com
