

Cuando hablamos de esteganografía, la gente imagina a terroristas, pedófilos, espías, o en el mejor de los casos, a criptoanarquistas y otros académicos. Y de hecho, ¿quién más podría necesitar algo de esto? por defecto el subdominio «www» y agregar un mecanismo ¿Qué utilidad puede tener para una persona común alejándose de las miradas externas?
Resulta que sí hay alguna. Es por eso que hoy vamos a comprimir datos utilizando métodos de esteganografía. Al final, el lector incluso podrá utilizar sus preciosos archivos de fotos en JPEG para aumentar la cantidad de gigabytes libres en el sistema de archivos.
¿Qué?
Si el lector recuerda, la esteganografía consiste en extraños algoritmos que permiten ocultar la existencia de una información dentro de otra. Dicho de manera más simple: imagen + archivo = aproximadamente la misma imagen, pero no del todo (en lugar de imágenes, puede ser cualquier cosa, pero generalmente es más claro con ellas). No debe haber una manera sencilla de determinar si hay algo dentro o no.
Pero si no se puede distinguir uno de otro, ¿existe alguna diferencia? Desde el punto de vista del consumidor, al usuario no le importa la precisión matemática (reflejada en un conjunto específico de bits), solo lo que percibe.
Por ejemplo, veamos tres imágenes de un adorable perro:
¡Cuidado con el JPEG!
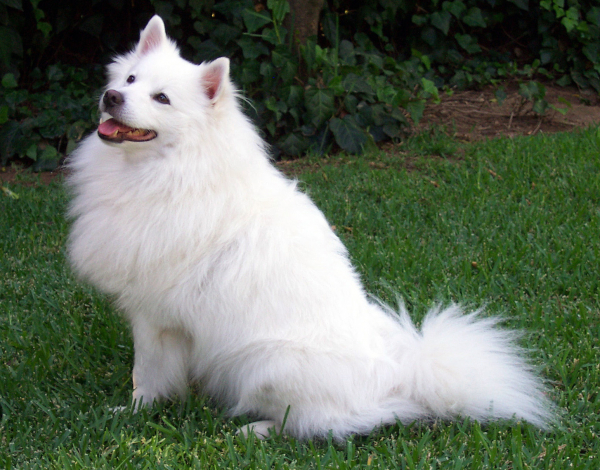
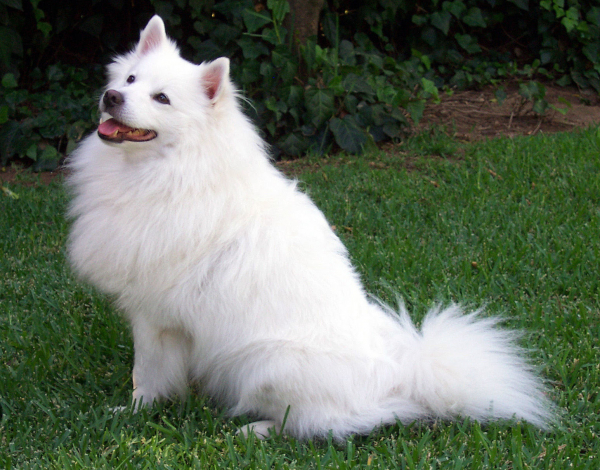
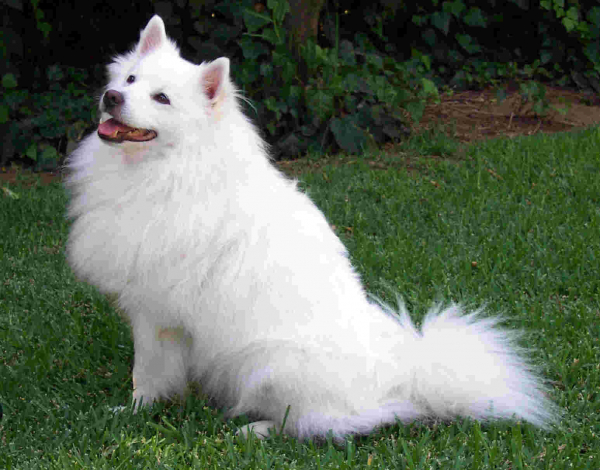
A pesar de la enorme diferencia de tamaño, pocos elegirían la tercera versión. Por otro lado, la diferencia entre las dos primeras fotos no es tan notoria, y la cantidad de información en ellas (desde mi punto de vista) puede considerarse equivalente.
Este principio en sí es antiguo y se ha estado utilizando activamente durante años con métodos de compresión de datos con pérdida. Pero romper no es lo mismo que construir; nos interesa el lado más avanzado de la cuestión. ¿Se puede incrustar información adicional de tamaño N en un archivo de tal manera que su tamaño aumente en M < N, y los cambios no sean perceptibles para el usuario?
Por supuesto que se puede. Pero hay que hacer un par de aclaraciones de inmediato:
- Primero, el método debe ser universal y dar resultados positivos en la mayoría de los datos de entrada. Es decir, en promedio, para una entrada arbitraria, debe haber una reducción real en la cantidad de información almacenada. "En promedio" significa que pueden ocurrir casos opuestos, pero no deben prevalecer.
- En segundo lugar, el tamaño del contenedor comprimido antes de incrustar información debe ser mayor que su modificación comprimida de manera equivalente. Simplemente incrustar un montón de bits en una imagen BMP mediante el método LSB no constituye compresión esteganográfica, ya que, al ser procesada a través de algún DEFLATE, es probable que la imagen original sea visiblemente más pequeña.
- En tercer lugar, es necesario llevar a cabo y comparar el resultado en relación a los datos ya comprimidos por métodos clásicos. Esto permitirá eliminar el efecto probabilístico de la diferencia en su redundancia y realizar una compresión más efectiva en términos generales.
¿Dónde?
El uso de la esteganografía implica que, además de la información a comprimir, necesitaremos contenedores en los cuales se incrustará. La cantidad máxima de información que se puede incrustar depende en gran medida de propiedades individuales, pero se escala más fácilmente con su cantidad. Por lo tanto, el formato de los contenedores debe ser comúnmente utilizado, para que el usuario tenga suficiente cantidad de ellos y obtenga algún beneficio del proceso de "compresión".
En este contexto, los buenos candidatos son archivos gráficos, de audio y de video. Sin embargo, debido a la diversidad de formatos, códecs, etc., en la práctica nos queda una selección no tan numerosa de opciones.
Teniendo todo esto en cuenta, mi elección recayó en JPEG, que está prácticamente en todos lados, es ampliamente utilizado tanto en el ámbito personal como en los negocios, siendo casi el formato de facto para la mayoría de las imágenes.
¿C̶u̶á̶n̶do̶ Cómo?
A continuación, se presentan esquemas y descripciones técnicas y alrededor del tema sin explicaciones especiales, por lo que los interesados pueden saltarse esta sección y avanzar hasta "Altas tecnologías".
Rasgos generales
Para incrustar datos en algún lugar, primero hay que determinar dónde. En el sistema de archivos puede haber tantas fotos diversas como se desee, entre las cuales el usuario podría querer usar solo algunas. Este conjunto deseado de contenedores lo llamaremos biblioteca.
Se forma en dos casos: antes de la compresión y antes de la descompresión. En el primer caso, se puede usar simplemente un conjunto de nombres (o mejor, una expresión regular para ellos) de archivos, pero en el segundo se requiere algo más fiable: el usuario puede copiar y moverlos dentro del sistema de archivos, evitando así que se definan correctamente. Por lo tanto, es necesario almacenar sus hashes (md5 es suficiente) después de realizar todas las modificaciones.
La búsqueda inicial mediante expresión regular no tiene sentido realizarla en todo el sistema de archivos; es suficiente con indicar algún directorio raíz. En este mismo directorio se guardará un archivo-archivador especial, en el que estarán los hashes, junto con otra meta-información necesaria para la posterior recuperación de la información comprimida.
Todo esto es aplicable en igual medida a cualquier implementación de cualquier algoritmo de compresión de datos esteganográfica. Los propios procesos de compresión y recuperación de datos se pueden denominar empaquetado y desempaquetado.
F5
Ahora que ha quedado claro qué hacemos y por qué, solo queda describir el propio algoritmo para alcanzar el objetivo. Recordemos el proceso de codificación de un archivo JPEG (gracias a la wiki de la biblioteca nacional Bauman):
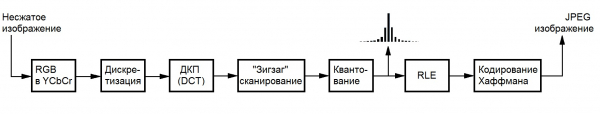
Al observarlo, es mejor hacer algunas observaciones de inmediato:
- El tamaño del archivo JPEG se puede considerar óptimo, incluso sin intentar comprimirlo con algún winrar;
- Se puede modificar únicamente la información almacenada (la que está en la salida de la transformación discreta del coseno, DCT), para asegurar un rendimiento aceptable.
- Para no perder datos a gran escala que sean notorios para el usuario, se requiere hacer un mínimo de modificaciones en cada imagen individual;
Bajo tales condiciones, se ajusta toda una familia de algoritmos, con la que se puede familiarizar . El más avanzado de ellos es el algoritmo del autor Andreas Westfeld, que trabaja con los coeficientes DCT del componente de luminancia (el ojo humano es menos sensible precisamente a sus cambios). Su esquema general al trabajar con un archivo JPEG existente se representa en el siguiente diagrama:
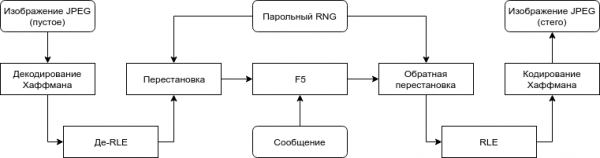
El bloque F5 utiliza una metodología avanzada de inserción, basada en la codificación de matrices. El lector puede familiarizarse con ella y con el algoritmo en sí a través del enlace anterior; lo que nos interesa principalmente es el hecho de que, con su ayuda, se pueden realizar menos cambios al insertar la misma cantidad de información, cuanto mayor sea el tamaño del contenedor utilizado, y para llevar a cabo el algoritmo solo se requieren operaciones simples de (de)codificación Huffman y RLE.
Los cambios en sí se realizan sobre los coeficientes enteros y se reducen a disminuir su valor absoluto en uno, lo que permite, en líneas generales, usar F5 para la compresión de datos. La razón es que un coeficiente reducido en valor absoluto es probable que ocupe menos bits después de la codificación Huffman debido a la distribución estadística de los valores en JPEG.
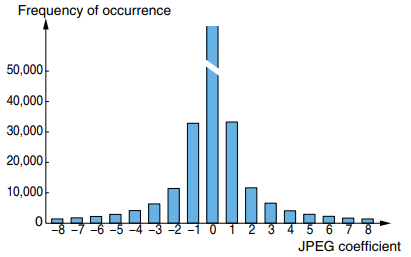
En caso de que se forme un cero (el llamado acortamiento), la cantidad de información almacenada disminuirá en su tamaño, ya que el coeficiente anterior independiente se convertirá en parte de la secuencia RLE de ceros codificada:
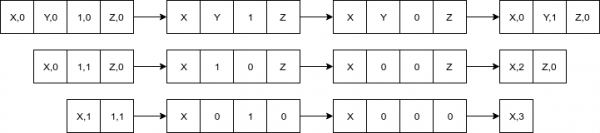
Modificaciones
La protección de datos y su compresión son tareas ortogonales, por lo que se puede prescindir de la permutación secreta de contraseñas del algoritmo original. Más aún, necesitamos saber exactamente cómo extraer los datos; por lo tanto, toda la información necesaria para esto (qué contenedores se utilizaron, en qué orden, etc.) debe registrarse en un archivo separado y estar disponible para lectura libre por parte del archivador.
El algoritmo original está diseñado para la transmisión de mensajes secretos, por lo que trabaja con un solo contenedor a la vez, asumiendo que el usuario lo dividirá en partes según sea necesario, si es que hay necesidad. Además, al insertar de forma independiente en cada contenedor, se debe saber de antemano cuántos bits de datos se colocarán en cada uno. Por ello, los coeficientes de cada elemento de la biblioteca deberían combinarse en uno grande abstracto y trabajarse según el algoritmo original.
Dado que el F5 original permite utilizar hasta el 12% del tamaño del contenedor, esta modificación también aumentará la capacidad máxima: «hasta el 12%» del tamaño de toda la biblioteca es mayor o igual a la suma de «hasta el 12%» de cada uno de sus elementos.
El esquema general codificado es el siguiente:
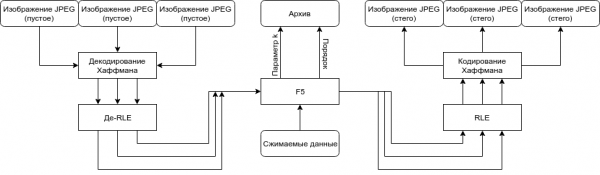
El algoritmo en sí
Ahora es momento de describir el algoritmo de principio a fin, para no mantener al lector en la oscuridad:
- El usuario define los datos binarios comprimibles M y la biblioteca L mediante expresiones regulares y el directorio raíz de búsqueda;
- En el orden en que aparecen en el sistema de archivos, los elementos de la biblioteca forman MC:
- Se decodifica una serie de coeficientes C desde los datos del archivo;
- MC <- MC | C;
- Se define el parámetro k a partir de la aterradora desigualdad:
|M| * 8 / (count_full(MC) + count_ones(MC) * k_rate(k)) < k / ((1 << k) - 1); - Se toma sucesivamente
n = (1 << k) - 1los bits menos significativos de los elementos no nulos de MC y se escribe ena:- Se calcula la función hash mágica
f, que transforma una palabra de n bitsaen k bitss; - Si
s == 0, entonces no se necesita hacer ningún cambio y el algoritmo pasa a los siguientes coeficientes; - Reducir el valor absoluto del coeficiente asociado a
s-ésimo bit en la palabraa; - Si como resultado de la reducción se produce un recorte (el coeficiente se convierte en 0), entonces repetir el paso desde el principio;
- Se calcula la función hash mágica
- Todos los coeficientes se codifican con RLE y Huffman, se escriben en archivos de origen;
- Se escribe el parámetro k en el archivo del archivo;
- Se calcula el hash MD5 de cada archivo L en el orden en que se encuentran originalmente y se graba en el archivo del archivo.
Alta tecnología
La forma naïve del algoritmo y su implementación en otros lenguajes de alto nivel (especialmente aquellos con recolección de basura) darían un rendimiento terrible, por lo que implementé todas estas complejidades en C puro y realicé una serie de optimizaciones tanto en velocidad de ejecución como en memoria (no pueden imaginar cuánto pesan estas imágenes sin compresión, incluso antes de DCT). Pero incluso así, al principio, la velocidad de ejecución dejaba mucho que desear, por lo que no describiré todo el proceso y los métodos utilizados.
La compatibilidad multiplataforma se logró mediante el uso de una combinación de bibliotecas libjpeg, pcre y tinydir, a las cuales agradezco. Por defecto, todo se compila a través de uno común make, por lo que los usuarios de Windows quieren instalar algún Cygwin o lidiar con Visual Studio y bibliotecas por su cuenta.
La implementación está disponible como una utilidad de consola y como una biblioteca. Aquellos interesados en el uso de esta última pueden consultar el README en el repositorio de GitHub, cuya enlace incluiré al final de la publicación. Ahora pasemos a la descripción y demostración del funcionamiento.
¿Cómo usarlo?
Con precaución. Las imágenes utilizadas se pueden mover, renombrar y copiar a voluntad. Sin embargo, es importante ser extremadamente cuidadoso y no modificar su contenido de ninguna manera. Cambiar un solo bit resultará en una violación del hash y la imposibilidad de recuperar la información.
Supongamos que tras la compilación obtuvimos el archivo ejecutable f5ar. Se puede analizar el tamaño de la biblioteca para calcular sus posibilidades de uso utilizando el flag -a: .\/f5ar -a [carpeta de búsqueda] [expresión regular compatible con Perl]. La compresión se realiza con el comando .\/f5ar -p [carpeta de búsqueda] [expresión regular compatible con Perl] [archivo a comprimir] [nombre del archivo de archivo], y la descompresión se lleva a cabo con .\/f5ar -u [archivo de archivo] [nombre del archivo restaurado].
Demostración del funcionamiento
Para mostrar la eficacia del método, cargué una colección de 225 fotos de perros completamente gratuitas del servicio . Cada una de ellas posee una calidad ligeramente superior en comparación con las fotografías de usuario normales, pero aún así. Cada una fue recodificada usando libjpeg, para mitigar la influencia de las características de codificación de la biblioteca sobre el tamaño total. Para ilustrar el peor ejemplo de datos comprimibles, se generó un archivo aleatorio uniformemente distribuido de 36 metros (un poco más del 5% del tamaño total) con dd.
El proceso de prueba es bastante simple:
$ ls
binary_data dogs f5ar
$ du -sh dogs/\
633M dogs/\
$ du -h binary_data
36M binary_data

$ .\/f5ar -p dogs/ .*jpg binary_data dogs.f5ar
Leyendo archivo de compresión... ok
Inicializando el archivo... ok
Analizando la capacidad de la biblioteca... hecho en 16.8s
Capacidad garantizada detectada de 48439359 bytes
Capacidad posible detectada de hasta 102618787 bytes
Comprimiendo... hecho en 32.6s
Guardando el archivo... ok

$ .\/f5ar -u dogs/dogs.f5ar descomprimido
Inicializando el archivo... ok
Leyendo el archivo de archivo... ok
Llenando el archivo con archivos... hecho en 1.2s
Descomprimiendo... hecho en 17.5s
Escribiendo datos extraídos... ok

$ sha1sum binary_data descomprimido
ba7ade4bc77881ab463121e77bbd4d41ee181ae9 binary_data
ba7ade4bc77881ab463121e77bbd4d41ee181ae9 descomprimido
$ du -sh dogs/\
563M dogs/
O con una captura de pantalla para los aficionados
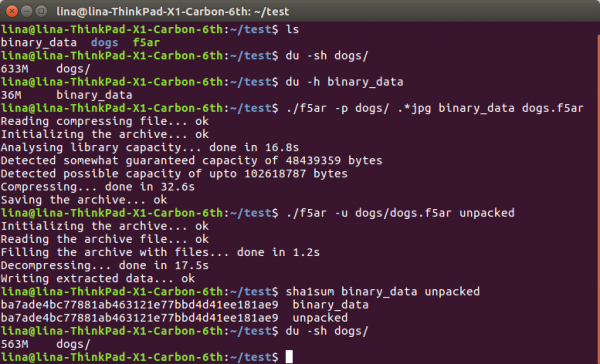
Como se puede ver, de los 633 + 36 == 669 megabytes de datos en el disco duro hemos llegado a unos agradables 563, lo que nos da un coeficiente de compresión de aproximadamente ~1,188. Esta diferencia radical se explica por pérdidas extremadamente pequeñas, similares a las que se obtienen al optimizar archivos JPEG con métodos clásicos (como tinyjpg). Naturalmente, al utilizar la compresión esteganográfica, la información no se 'pierde' simplemente, sino que se utiliza para codificar otros datos. Además, la cantidad de coeficientes 'optimizados' al usar F5 es mucho menor que en la optimización tradicional.
Cualesquiera que sean las modificaciones, para el ojo no son absolutamente visibles. En el spoiler a continuación, el lector puede evaluar la diferencia tanto a simple vista como restando los valores del componente modificado del original (cuanto más apagado es el color, menor es la diferencia):
Enlaces a imágenes que no caben en habrastorage
Original -
Modificado -
Diferencia -
En conclusión
Espero haber convencido al lector de que tales métodos son posibles y tienen derecho a existir. Sin embargo, comprar un disco duro o un canal adicional (para transmisión en red) puede parecer una salida mucho más sencilla que intentar ahorrar de esta manera. Por un lado, es cierto, el desarrollo extensivo a menudo es más simple y confiable. Pero, por otro lado, no hay que olvidar también lo intensivo. No hay garantías de que mañana se pueda ir a la tienda y comprar otro disco duro de mil terabytes, pero siempre se puede utilizar lo que ya se tiene en casa.
->
Fuente: habr.com
