

Hola a todos. Estamos desarrollando un producto para analizar el tráfico offline. En el proyecto hay una tarea relacionada con el análisis estadístico de los caminos que siguen los visitantes a través de las áreas.
En el marco de esta tarea, los usuarios pueden hacer consultas al sistema del siguiente tipo:
- ¿Cuántos visitantes pasaron del área "A" al área "B"?
- ¿Cuántos visitantes pasaron del área "A" al área "B" a través del área "C", y luego a través del área "D"?
- ¿Cuánto tiempo tardó un visitante de un tipo determinado al pasar del área "A" al área "B"?
y una serie de consultas analíticas similares.
El movimiento de un visitante a través de áreas representa un gráfico dirigido. Después de investigar en Internet, descubrí que las bases de datos gráficas se utilizan también para informes analíticos. Me dio curiosidad ver cómo manejarían consultas como estas las bases de datos gráficas (TL;DR; mal).
He elegido usar la base de datos , como un representante destacado de las bases de datos gráficas de código abierto, que se basa en un stack de tecnologías maduras que (en mi opinión) deberían proporcionarle un rendimiento operativo decente:
- back-end de almacenamiento BerkeleyDB, Apache Cassandra, Scylla;
- los índices complejos se pueden almacenar en Lucene, Elasticsearch, Solr.
Los autores de JanusGraph dicen que es adecuada tanto para OLTP como para OLAP.
He trabajado con BerkeleyDB, Apache Cassandra, Scylla y ES, además, estos productos son comúnmente utilizados en nuestros sistemas, por lo que miraba con optimismo la prueba de esta base de datos gráfica. Me pareció extraño elegir BerkeleyDB en lugar de RocksDB, pero probablemente está relacionado con los requisitos de transacciones. En cualquier caso, para un uso escalable y productivo se sugiere usar un back-end con Cassandra o Scylla.
No consideré Neo4j, ya que se requiere una versión comercial para la agrupación, es decir, el producto no es abierto.
Las bases de datos gráficas dicen: "¡Si algo se parece a un gráfico, trátalo como un gráfico!" — ¡hermoso!
Primero dibujé un gráfico que está hecho de acuerdo con los cánones de las bases de datos gráficas:
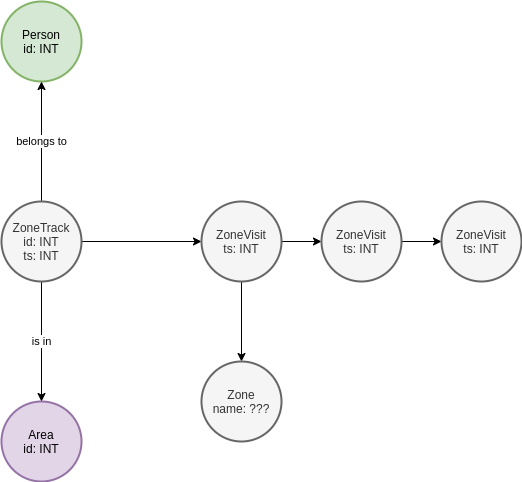
Hay una entidad Zone, que se encarga del área. Si ZoneStep pertenece a esta Zone, entonces hace referencia a ella. No presten atención a las entidades Area, ZoneTrack, Persona , pertenecen al dominio y no se consideran en el marco de la prueba. En total, para tal estructura gráfica, la consulta de búsqueda de cadenas sería como:
g.V().hasLabel('Zone').has('id',0).in_()
       .repeat(__.out()).until(__.out().hasLabel('Zone').has('id',19)).count().next()
En español sería algo así: encuentra Zone con ID=0, toma todos los vértices de los que sale una arista (ZoneStep), avanza sin volver atrás hasta que encuentres esas ZoneStep desde las que sale una arista hacia Zone con ID=19, cuenta la cantidad de esas cadenas.
No pretendo conocer todas las sutilezas de la búsqueda en grafos, pero esta consulta fue generada a partir de este libro ().
Cargué 50,000 pistas con una longitud de entre 3 y 20 puntos en una base de datos de grafos JanusGraph, que utiliza como backend BerkeleyDB, creé índices según .
Script de carga en Python:
from random import random
from time import time

from init import g, graph

if __name__ == '__main__':

    points = []
    max_zones = 19
    zcache = dict()
    for i in range(0, max_zones + 1):
        zcache[i] = g.addV('Zone').property('id', i).next()

    startZ = zcache[0]
    endZ = zcache[max_zones]

    for i in range(0, 10000):

        if not i % 100:
            print(i)

        start = g.addV('ZoneStep').property('time', int(time())).next()
        g.V(start).addE('belongs').to(startZ).iterate()

        while True:
            pt = g.addV('ZoneStep').property('time', int(time())).next()
            end_chain = random()
            if end_chain < 0.3:
                g.V(pt).addE('belongs').to(endZ).iterate()
                g.V(start).addE('goes').to(pt).iterate()
                break
            else:
                zone_id = int(random() * max_zones)
                g.V(pt).addE('belongs').to(zcache[zone_id]).iterate()
                g.V(start).addE('goes').to(pt).iterate()

            start = pt

    count = g.V().count().next()
    print(count)
Se utilizó una VM con 4 núcleos y 16 GB de RAM en SSD. JanusGraph fue desplegado con este comando:
docker run --name janusgraph -p8182:8182 janusgraph/janusgraph:latestEn este caso, los datos y los índices utilizados para la búsqueda por coincidencia exacta se almacenan en BerkeleyDB. Ejecutando la consulta mencionada anteriormente, obtuve un tiempo de varios decenas de segundos.
Ejecutando 4 de los scripts anteriores en paralelo, logré convertir la base de datos en una calabaza con un divertido flujo de trazas de pila de Java (y a todos nos gusta leer trazas de pila de Java) en los logs de Docker.
Reflexionando, decidí simplificar el esquema del grafo a lo siguiente:
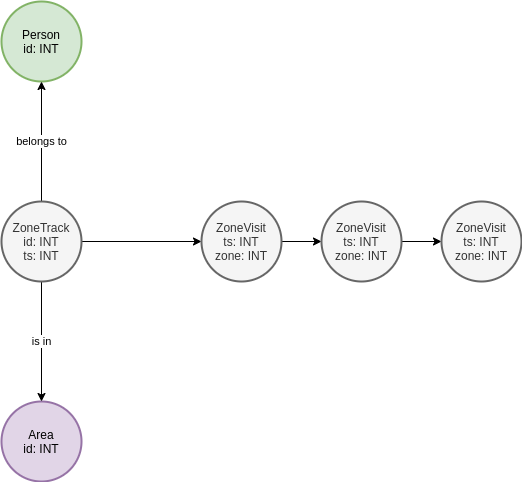
Decidí que buscar por los atributos de la entidad sería más rápido que buscar por las aristas. Al final, mi consulta se convirtió en la siguiente:
g.V().hasLabel('ZoneStep').has('id',0).repeat(__.out().simplePath()).until(__.hasLabel('ZoneStep').has('id',19)).count().next()En español sería algo así: encuentra ZoneStep con ID=0, avanza sin volver atrás hasta que encuentres ZoneStep con ID=19, cuenta el número de tales cadenas.
El script de carga mencionado anteriormente también lo simplifiqué, para no crear relaciones innecesarias, limitándome a los atributos.
La consulta todavía estaba en ejecución durante varios segundos, lo cual era completamente inaceptable para nuestra tarea, ya que para las consultas AdHoc de naturaleza arbitraria esto no era adecuado en absoluto.
Intenté desplegar JanusGraph utilizando Scylla, como la implementación más rápida de Cassandra, pero eso tampoco trajo cambios significativos en el rendimiento.
Así, a pesar de que "esto se ve como un gráfico", no pude hacer que la base de datos gráfica procesara esto rápidamente. Supongo que no sé algo y que se puede hacer que JanusGraph realice esta búsqueda en fracciones de segundo, sin embargo, no lo logré.
Dado que aún era necesario resolver el problema, comencé a pensar en JOINs y tablas PIVOT, lo cual no inspiraba optimismo en términos de elegancia, pero podría ser una opción práctica.
En nuestro proyecto ya se utiliza Apache ClickHouse, así que decidí probar mis investigaciones en esta base de datos analítica.
Desplegué ClickHouse siguiendo una receta simple:
sudo docker run -d --name clickhouse_1
     --ulimit nofile=262144:262144
     -v /opt/clickhouse/log:/var/log/clickhouse-server
     -v /opt/clickhouse/data:/var/lib/clickhouse
     yandex/clickhouse-server
Creé en él una base de datos y una tabla del tipo:
CREATE TABLE
db.steps (`area` Int64, `when` DateTime64(1, 'Europe/Moscow') DEFAULT now64(), `zone` Int64, `person` Int64)
ENGINE = MergeTree() ORDER BY (area, zone, person) SETTINGS index_granularity = 8192
La llené con datos mediante el siguiente script:
from time import time

from clickhouse_driver import Client
from random import random

client = Client('vm-12c2c34c-df68-4a98-b1e5-a4d1cef1acff.domain',
                database='db',
                password='secret')

max = 20

for r in range(0, 100000):

    if r % 1000 == 0:
        print("CNT: {}, TS: {}".format(r, time()))

    data = [{
            'area': 0,
            'zone': 0,
            'person': r
        }]

    while True:
        if random() < 0.3:
            break

        data.append({
                'area': 0,
                'zone': int(random() * (max - 2)) + 1,
                'person': r
            })

    data.append({
            'area': 0,
            'zone': max - 1,
            'person': r
        })

    client.execute(
        'INSERT INTO steps (area, zone, person) VALUES',
        data
    )
Dado que las inserciones se realizan en lotes, el llenado fue mucho más rápido que para JanusGraph.
Construí dos consultas utilizando JOIN. Para el paso de A a B:
SELECT s1.person AS person,
       s1.zone,
       s1.when,
       s2.zone,
       s2.when
FROM
  (SELECT *
   FROM steps
   WHERE (area = 0)
     AND (zone = 0)) AS s1 ANY INNER JOIN
  (SELECT *
   FROM steps AS s2
   WHERE (area = 0)
     AND (zone = 19)) AS s2 USING person
WHERE s1.when <= s2.when
Para el paso a través de 3 puntos:
SELECT s3.person,
       s1z,
       s1w,
       s2z,
       s2w,
       s3.zone,
       s3.when
FROM
  (SELECT s1.person AS person,
          s1.zone AS s1z,
          s1.when AS s1w,
          s2.zone AS s2z,
          s2.when AS s2w
   FROM
     (SELECT *
      FROM steps
      WHERE (area = 0)
        AND (zone = 0)) AS s1 ANY INNER JOIN
     (SELECT *
      FROM steps AS s2
      WHERE (area = 0)
        AND (zone = 3)) AS s2 USING person
   WHERE s1.when <= s2.when) p ANY INNER JOIN
  (SELECT *
   FROM steps
   WHERE (area = 0)
     AND (zone = 19)) AS s3 USING person
WHERE p.s2w <= s3.when
Las consultas, por supuesto, parecen bastante aterradoras; para su uso real, es necesario crear un generador de envoltura programática. Sin embargo, funcionan y lo hacen rápidamente. Ambas consultas se ejecutan en menos de 0.1 segundos. Aquí hay un ejemplo del tiempo de ejecución de la consulta para count(*) en 3 puntos:
SELECT count(*)
FROM
(
    SELECT
        s1.person AS person,
        s1.zone AS s1z,
        s1.when AS s1w,
        s2.zone AS s2z,
        s2.when AS s2w
    FROM
    (
        SELECT *
        FROM steps
        WHERE (area = 0) AND (zone = 0)
    ) AS s1
    ANY INNER JOIN
    (
        SELECT *
        FROM steps AS s2
        WHERE (area = 0) AND (zone = 3)
    ) AS s2 USING (person)
    WHERE s1.when <= s2.when
) AS p
ANY INNER JOIN
(
    SELECT *
    FROM steps
    WHERE (area = 0) AND (zone = 19)
) AS s3 USING (person)
WHERE p.s2w <= s3.when

┌─count()─┐
│   11592 │
└─────────┘
1 filas en el conjunto. Tiempo transcurrido: 0.068 seg. Se procesaron 250.03 mil filas, 8.00 MB (3.69 millones de filas/s, 117.98 MB/s).Nota sobre IOPS. Al llenar los datos, JanusGraph generó una cantidad bastante alta de IOPS (1000-1300 con cuatro hilos de llenado), y el IOWAIT fue bastante alto. Al mismo tiempo, ClickHouse generó una carga mínima en el subsistema de discos.
Conclusión
Decidimos usar ClickHouse para manejar consultas de este tipo. Siempre podemos optimizar aún más las consultas utilizando vistas materializadas y paralelización, realizando un procesamiento previo del flujo de eventos con Apache Flink antes de cargarlos en ClickHouse.
El rendimiento es tan bueno que probablemente ni siquiera tengamos que pensar en pivotar tablas con medios programáticos. Anteriormente, teníamos que hacer pivotes de datos extraídos de Vertica a través de una exportación a Apache Parquet.
Desafortunadamente, otro intento de usar una base de datos gráfica no tuvo éxito. No encontré que JanusGraph tuviera un ecosistema amigable que permitiera familiarizarse rápidamente con el producto. Además, la configuración del servidor utiliza el enfoque tradicional de Java, lo que hará llorar a lágrima viva a aquellos que no estén familiarizados con Java:
host: 0.0.0.0
port: 8182
threadPoolWorker: 1
gremlinPool: 8
scriptEvaluationTimeout: 30000
channelizer: org.janusgraph.channelizers.JanusGraphWsAndHttpChannelizer

graphManager: org.janusgraph.graphdb.management.JanusGraphManager
graphs: {
  ConfigurationManagementGraph: conf/janusgraph-cql-configurationgraph.properties,
  airlines: conf/airlines.properties
}

scriptEngines: {
  gremlin-groovy: {
    plugins: { org.janusgraph.graphdb.tinkerpop.plugin.JanusGraphGremlinPlugin: {},
               org.apache.tinkerpop.gremlin.server.jsr223.GremlinServerGremlinPlugin: {},
               org.apache.tinkerpop.gremlin.tinkergraph.jsr223.TinkerGraphGremlinPlugin: {},
               org.apache.tinkerpop.gremlin.jsr223.ImportGremlinPlugin: {classImports: [java.lang.Math], methodImports: [java.lang.Math#*]},
               org.apache.tinkerpop.gremlin.jsr223.ScriptFileGremlinPlugin: {files: [scripts/airline-sample.groovy]}}}}

serializers:
# GraphBinary está aquí para reemplazar Gryo y Graphson
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphBinaryMessageSerializerV1, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphBinaryMessageSerializerV1, config: { serializeResultToString: true }}
  # Gryo y Graphson, últimas versiones
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GryoMessageSerializerV3d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GryoMessageSerializerV3d0, config: { serializeResultToString: true }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphSONMessageSerializerV3d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  # Versiones de serialización más antiguas para compatibilidad:
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GryoMessageSerializerV1d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GryoMessageSerializerV1d0, config: { serializeResultToString: true }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GryoLiteMessageSerializerV1d0, config: {ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphSONMessageSerializerGremlinV2d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphSONMessageSerializerGremlinV1d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistryV1d0] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphSONMessageSerializerV1d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistryV1d0] }}

processors:
  - { className: org.apache.tinkerpop.gremlin.server.op.session.SessionOpProcessor, config: { sessionTimeout: 28800000 }}
  - { className: org.apache.tinkerpop.gremlin.server.op.traversal.TraversalOpProcessor, config: { cacheExpirationTime: 600000, cacheMaxSize: 1000 }}

metrics: {
  consoleReporter: {enabled: false, interval: 180000},
  csvReporter: {enabled: false, interval: 180000, fileName: /tmp/gremlin-server-metrics.csv},
  jmxReporter: {enabled: false},
  slf4jReporter: {enabled: true, interval: 180000},
  gangliaReporter: {enabled: false, interval: 180000, addressingMode: MULTICAST},
  graphiteReporter: {enabled: false, interval: 180000}}
threadPoolBoss: 1
maxInitialLineLength: 4096
maxHeaderSize: 8192
maxChunkSize: 8192
maxContentLength: 65536
maxAccumulationBufferComponents: 1024
resultIterationBatchSize: 64
writeBufferHighWaterMark: 32768
writeBufferHighWaterMark: 65536
ssl: {
  enabled: false}
Accidentalmente "colapsé" BerkeleyDB versión JanusGraph.
La documentación es bastante confusa en lo que respecta a los índices, ya que la gestión de índices requiere llevar a cabo rituales extraños en Groovy. Por ejemplo, la creación de un índice debe realizarse a través de la escritura de código en la consola de Gremlin (lo cual, por cierto, no funciona de inmediato). De la documentación oficial de JanusGraph:
graph.tx().rollback() \/\/Nunca cree nuevos índices mientras una transacción esté activa
mgmt = graph.openManagement()
name = mgmt.getPropertyKey('name')
age = mgmt.getPropertyKey('age')
mgmt.buildIndex('byNameComposite', Vertex.class).addKey(name).buildCompositeIndex()
mgmt.buildIndex('byNameAndAgeComposite', Vertex.class).addKey(name).addKey(age).buildCompositeIndex()
mgmt.commit()

\/\/Espere a que el índice esté disponible
ManagementSystem.awaitGraphIndexStatus(graph, 'byNameComposite').call()
ManagementSystem.awaitGraphIndexStatus(graph, 'byNameAndAgeComposite').call()
\/\/Reindexe los datos existentes
mgmt = graph.openManagement()
mgmt.updateIndex(mgmt.getGraphIndex("byNameComposite"), SchemaAction.REINDEX).get()
mgmt.updateIndex(mgmt.getGraphIndex("byNameAndAgeComposite"), SchemaAction.REINDEX).get()
mgmt.commit()
Póscrito
En cierto sentido, el experimento anterior es como comparar peras con manzanas. Si se piensa en ello, una base de datos de grafos realiza operaciones diferentes para obtener los mismos resultados. Sin embargo, como parte de las pruebas, realicé un experimento con una consulta del tipo:
g.V().hasLabel('ZoneStep').has('id',0)
    .repeat(__.out().simplePath()).until(__.hasLabel('ZoneStep').has('id',1)).count().next()
que refleja la accesibilidad por pasos. Sin embargo, incluso con estos datos, la base de datos de grafos mostraba un resultado que excedía varios segundos... Esto, por supuesto, está relacionado con el hecho de que había caminos del tipo 0 -> X -> Y ... -> 1, que el motor gráfico también estaba verificando.
Incluso para una consulta del tipo:
g.V().hasLabel('ZoneStep').has('id',0).out().has('id',1)).count().next()no pude obtener una respuesta eficiente con un tiempo de procesamiento inferior a un segundo.
La moraleja de la historia es que una idea atractiva y una modelación paradigmática no conducen al resultado deseado, que se demuestra con una eficiencia significativamente mayor en el caso de ClickHouse. El uso presentado en este artículo es un antipatron claro para bases de datos de grafos, aunque parece adecuado para modelar dentro de su paradigma.
Fuente: habr.com
