

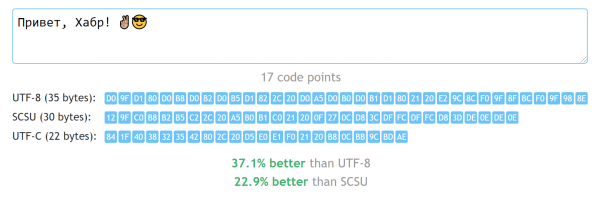
Si eres desarrollador y tienes que elegir una codificación, casi siempre la solución correcta será Unicode. La forma específica de representación depende del contexto, pero a menudo también hay una respuesta universal: UTF-8. Es bueno porque permite usar todos los caracteres de Unicode sin gastar demasiado byte en la mayoría de los casos. Sin embargo, para los idiomas que utilizan no solo el alfabeto latino, 'no demasiado' significa al menos dos bytes por carácter. ¿Se puede hacer mejor, sin volver a codificaciones prehistóricas que nos limitan a solo 256 símbolos disponibles?
A continuación, le propongo conocer mi intento de responder a esta pregunta y la implementación de un algoritmo relativamente simple que permite almacenar cadenas en la mayoría de los idiomas del mundo, sin añadir la redundancia que existe en UTF-8.
Descargo de responsabilidad. Primero haré unas importantes aclaraciones: la solución descrita no se ofrece como un sustituto universal de UTF-8, solo es adecuada para un conjunto específico de casos (que se describen a continuación), y de ningún modo debe utilizarse para la interacción con API externas (que no tienen conocimiento de ella). En la mayoría de los casos, los algoritmos de compresión de propósito general (como deflate) son adecuados para almacenar grandes volúmenes de datos textuales de manera compacta. Además, ya en el proceso de crear mi solución, encontré un estándar existente en Unicode que resuelve el mismo problema: es un poco más complicado (y a menudo peor), pero sigue siendo un estándar aceptado y no algo hecho improvisadamente. También hablaré de eso.
Sobre Unicode y UTF-8
Para empezar, unas palabras sobre qué es en general Unicode y UTF-8.
Como es sabido, antes eran populares las codificaciones de 8 bits. Con ellas todo era simple: 256 símbolos pueden numerarse con números del 0 al 255, y los números del 0 al 255 se pueden representar de manera obvia con un solo byte. Si retrocedemos a los orígenes, la codificación ASCII está limitada a 7 bits, por lo que el bit más significativo en su representación byte es cero, y la mayoría de las codificaciones de 8 bits son compatibles con ella (se diferencian solo en la parte 'superior', donde el bit más significativo es uno).
¿En qué se diferencia Unicode de esas codificaciones y por qué está relacionado con tantas representaciones específicas: UTF-8, UTF-16 (BE y LE), UTF-32? Vamos a desglosarlo.
El estándar principal de Unicode describe solo la correspondencia entre los caracteres (y en algunos casos, componentes individuales de los caracteres) y sus números. Y hay muchos números posibles en este estándar: desde 0x00 hasta 0x10FFFF (1 114 112 unidades). Si quisiéramos almacenar un número en ese rango en una variable, ni 1 ni 2 bytes serían suficientes. Y dado que nuestros procesadores no están adaptados para trabajar con números de tres bytes, tendríamos que usar 4 bytes para un solo carácter. Esto es UTF-32, pero precisamente debido a este 'desperdicio', este formato no es popular.
Afortunadamente, los caracteres dentro de Unicode no están ordenados al azar. Su gran cantidad se divide en 17 'planos', cada uno de los cuales contiene 65536 (0x10000) «puntos de código). El término 'punto de código' aquí es simplemente el número de carácter, asignado a él por Unicode. Pero, como se mencionó anteriormente, en Unicode no solo se numeran los caracteres individuales, sino también sus componentes y marcas de control (y a veces ni siquiera corresponde a un número, posiblemente hasta cierto tiempo, pero eso no nos importa), por lo que es más correcto hablar siempre del número de números en sí, y no de caracteres. Sin embargo, más adelante, por brevedad, a menudo utilizaré la palabra 'carácter', refiriéndome al término 'punto de código'.
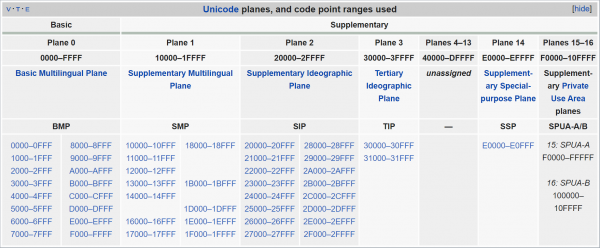
Planos de Unicode. Como se puede ver, la mayor parte (los planos del 4 al 13) aún no se ha utilizado.
Lo más notable es que toda la 'pulpa' principal se encuentra en el plano cero, que se llama "Plano Multilingüe Básico". Si la cadena contiene texto en uno de los idiomas modernos (incluyendo chino), no saldrás de este plano. Pero no se puede eliminar el resto de Unicode, ya que, por ejemplo, los emojis se encuentran principalmente al final del siguiente plano, "Plano Multilingüe Suplementario" (se extiende desde 0x10000 hasta 0x1FFFF). Por lo tanto, UTF-16 procede de esta manera: todos los caracteres que caen en Plano Multilingüe Básico, se codifican 'tal cual', con el número de dos bytes correspondiente. Sin embargo, algunos números en este rango no representan caracteres específicos, sino que indican que hay que considerar otra pareja de bytes después de esta; combinando los valores de estos cuatro bytes, obtendremos un número que abarca todo el rango permitido de Unicode. Esta representación se llama 'pares de sustitución' — tal vez ya hayas oído hablar de ellos.
Por lo tanto, UTF-16 requiere dos o (en muy raras ocasiones) cuatro bytes por cada "punto de código". Esto es mejor que usar constantemente cuatro bytes, pero la latínica (y otros caracteres ASCII) en esta codificación consume la mitad del espacio en ceros. UTF-8 está diseñado para corregir esto: en él, ASCII ocupa, como antes, solo un byte; los códigos de 0x80 hasta 0x7FF — dos bytes; de 0x800 hasta 0xFFFF — tres, y de 0x10000 hasta 0x10FFFF — cuatro. Por un lado, la latínica ha mejorado: ha regresado la compatibilidad con ASCII, y la distribución está más uniformemente "esparcida" de 1 a 4 bytes. Pero los alfabetos distintos del latino, lamentablemente, no ganan nada en comparación con UTF-16, y muchos ahora requieren tres bytes en lugar de dos: el rango cubierto por la codificación de dos bytes se ha reducido 32 veces, desde 0xFFFF hasta 0x7FF, y ya no incluye ningún chino, ni, por ejemplo, georgiano. La cirílica y otros cinco alfabetos — ¡hurra! — les fue bien, 2 bytes por símbolo.
¿Por qué sucede esto? Veamos cómo UTF-8 representa los códigos de los símbolos:
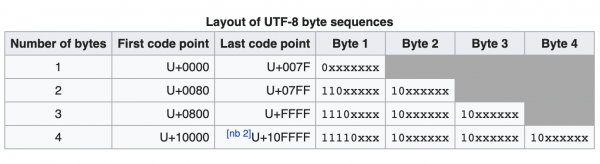
Directamente para representar números aquí se utilizan bits que están etiquetados con el símbolo x. Se puede ver que en la codificación de dos bytes hay solo 11 bits (de 16). Los bits principales aquí solo cumplen una función de servicio. En el caso de la codificación de cuatro bytes, se asignan 21 bits de 32 para el número del punto de código— parecía que con tres bytes (que dan un total de 24 bits) sería suficiente, pero los marcadores de servicio consumen demasiado.
¿Es esto malo? En realidad, no mucho. Por un lado, si nos importa mucho el espacio ocupado, tenemos algoritmos de compresión que pueden eliminar fácilmente toda la entropía y redundancia innecesarias. Por otro lado, el objetivo de Unicode era proporcionar una codificación lo más universal posible. Por ejemplo, una cadena codificada en UTF-8 se puede confiar a un código que antes solo trabajaba con ASCII, y no temer que vea un símbolo del rango ASCII que en realidad no está allí (porque en UTF-8, todos los bytes que comienzan con un bit cero son precisamente ASCII). Y si de repente queremos cortar una pequeña cola de una gran cadena, sin decodificarla desde el principio (o restaurar parte de la información después de un área dañada) — no es difícil encontrar el desplazamiento donde comienza algún símbolo (basta con omitir los bytes que tienen un prefijo de bits 10).
¿Por qué entonces inventar algo nuevo?
Al mismo tiempo, a veces hay situaciones en las que algoritmos de compresión como deflate son inaplicables, y se desea lograr un almacenamiento compacto de cadenas. Personalmente, me encontré con esta tarea al reflexionar sobre la construcción para un gran diccionario que incluye palabras en varios idiomas. Por un lado, cada palabra es muy corta, lo que hace que comprimirla sea inefectivo. Por otro lado, la implementación del árbol que estaba considerando estaba diseñada para que cada byte de la cadena almacenada generara un nodo separado del árbol, por lo que minimizar su cantidad era muy útil. En mi biblioteca (al igual que en , que es la base de esta) este problema se resuelve fácilmente: las cadenas empacadas en el se almacenan allí en . Sin embargo, como es fácil de entender, esto solo funciona bien para un alfabeto limitado; una cadena en chino no se puede almacenar en tal diccionario.
Me gustaría señalar también un aspecto incómodo que surge al usar UTF-8 en tal estructura de datos. En la imagen anterior, se puede ver que al escribir un carácter en forma de dos bytes, los bits correspondientes a su número no van en secuencia, sino que están interrumpidos por un par de bits 10 en el medio: 110xxxxx 10xxxxxx. Debido a esto, cuando se desbordan los 6 bits menos significativos del segundo byte del código del carácter (es decir, se produce un desbordamiento 10111111 → 10000000), el primer byte también cambia. Así, la letra «п» se representa con los bytes 0xD0 0xBF, mientras que la siguiente «р» ya es 0xD1 0x80. En el árbol de prefijos, esto conduce a la división del nodo padre en dos: uno para el prefijo 0xD0, y otro para 0xD1 (aunque toda la escritura cirílica podría codificarse solo con el segundo byte).
Lo que logré
Enfrentado a este reto, decidí practicar con juegos de bits y, de paso, conocer mejor la estructura de Unicode en general. El resultado fue un formato de codificación llamado UTF-C (‘C’ de compacto), que no utiliza más de 3 bytes por cada punto de código, y que a menudo permite utilizar solo un byte adicional para toda la cadena codificada. Esto resulta en que para muchos alfabetos no ASCII, tal codificación es 30-60% más compacta que UTF-8.
. He presentado ejemplos de implementación de los algoritmos de codificación y decodificación en forma de , puede utilizarlos libremente en su código. Sin embargo, subrayo que, en cierto modo, este formato sigue siendo una “bicicleta” y no lo recomiendo usar sin tener claro por qué lo necesita. Al fin y al cabo, es más un experimento que una verdadera “mejora de UTF-8”. Sin embargo, el código está bien escrito, es conciso, con muchos comentarios y cobertura de pruebas.
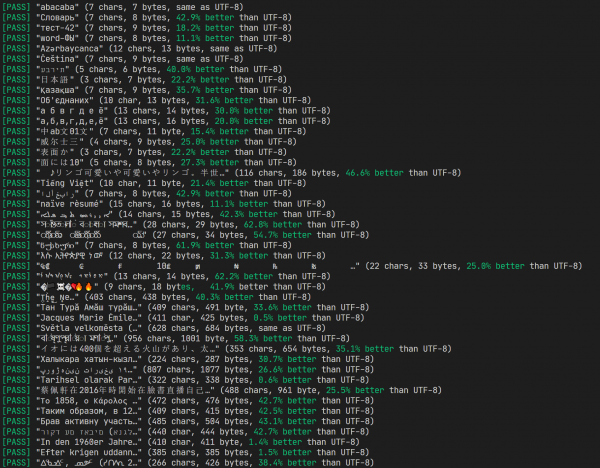
Resultados de la ejecución de pruebas y comparación con UTF-8
También he creado , donde puedes evaluar el funcionamiento del algoritmo, y más adelante contaré más sobre sus principios y el proceso de desarrollo.
Eliminando bits redundantes
Como base, tomé, por supuesto, UTF-8. Lo primero y más obvio que se puede cambiar es reducir el número de bits de control en cada byte. Por ejemplo, el primer byte en UTF-8 siempre comienza con 0, o con 11 — y el prefijo 10 solo está presente en los siguientes bytes. Cambiemos el prefijo 11 en 1, y en los siguientes bytes eliminemos los prefijos por completo. ¿Qué obtendremos?
0xxxxxxx — 1 byte
10xxxxxx xxxxxxxx — 2 bytes
110xxxxx xxxxxxxx xxxxxxxx — 3 bytes
Espera, ¿y dónde está el registro de cuatro bytes? Ya no es necesario — al usar tres bytes ahora tenemos disponible 21 bits y esto es más que suficiente para todos los números hasta 0x10FFFF.
¿Qué sacrificamos aquí? Lo más importante es la detección de los límites de los caracteres desde cualquier parte del buffer. No podemos simplemente apuntar a un byte y desde ahí encontrar el inicio del siguiente carácter. Esta es una limitación de nuestro formato, pero en la práctica no suele ser necesario. Normalmente, podemos recorrer el buffer desde el principio (especialmente cuando se trata de cadenas cortas).
La situación con la representación de idiomas con 2 bytes también ha mejorado: ahora el formato de dos bytes proporciona un rango de 14 bits, lo que equivale a códigos hasta 0x3FFF. Los chinos no tienen suerte (sus caracteres principalmente están en el rango de 0x4E00 hasta 0x9FFF), pero los georgianos y muchos otros pueblos se alegran — sus idiomas también se ajustan a 2 bytes por carácter.
Introduciendo el estado del codificador
Ahora pensemos en las propiedades de las cadenas mismas. En el diccionario, a menudo hay palabras escritas con caracteres de un solo alfabeto, y esto también es cierto para muchos otros textos. Sería bueno indicar este alfabeto una vez y luego solo mencionar el número de la letra dentro de él. Veamos si la ubicación de los caracteres en la tabla de Unicode nos ayuda.
Como se mencionó anteriormente, Unicode se divide en plano por 65536 códigos cada uno. Sin embargo, esta división no es muy útil (como ya se ha mencionado, la mayoría de las veces estamos en el plano cero). Una división más interesante es la de bloques. Estos rangos ya no tienen una longitud fija y tienen más sentido; por lo general, cada uno agrupa símbolos de un mismo alfabeto.
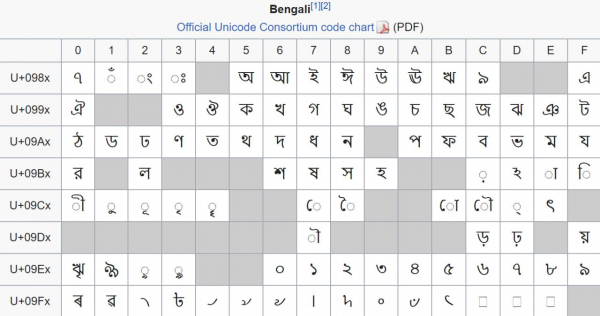
Bloque que contiene símbolos del alfabeto bengalí. Desafortunadamente, por razones históricas, este es un ejemplo de empaquetado no muy denso: 96 símbolos están distribuidos caóticamente en 128 puntos de código del bloque.
Los inicios de los bloques y sus tamaños siempre son múltiplos de 16, lo que se hace simplemente por conveniencia. Además, muchos bloques comienzan y terminan en valores que son múltiplos de 128 o incluso de 256; por ejemplo, el alfabeto cirílico básico ocupa 256 bytes desde 0x0400 hasta 0x04FF. Esto es bastante conveniente: si una vez guardamos el prefijo 0x04, entonces cualquier símbolo cirílico se puede representar con un solo byte. Sin embargo, así perdemos la posibilidad de volver a ASCII (y a cualquier otro símbolo en general). Por lo tanto, hacemos lo siguiente:
- Dos bytes
10yyyyyy yxxxxxxxno solo representan el símbolo con el númeroyyyyyy yxxxxxxx, sino que también cambian el alfabeto actual enyyyyyy y0000000es decir, recordamos todos los bits, excepto los menos significativos. 7 bits); - Un byte
0xxxxxxxes un símbolo del alfabeto actual. Simplemente hay que sumarlo al desplazamiento que hemos recordado en el paso 1. Mientras no hayamos cambiado el alfabeto, el desplazamiento es cero, así que hemos mantenido la compatibilidad con ASCII.
De manera similar para los códigos que requieren 3 bytes:
- Tres bytes
110yyyyy yxxxxxxx xxxxxxxxrepresentan el símbolo con el númeroyyyyyy yxxxxxxx xxxxxxxx, cambian el alfabeto actual enyyyyyy y0000000 00000000(recordamos todo, excepto los menos significativos 15 bits), y ponen una bandera de que ahora estamos en modo largo en modo largo, este es un símbolo del alfabeto actual. De manera similar, lo sumamos al desplazamiento del paso 1. La única diferencia es que ahora leemos dos bytes (porque hemos cambiado a ese modo). - Dos bytes
0xxxxxxx xxxxxxxxSuena bien: ahora, mientras necesitemos codificar símbolos de un mismo rango de 7 bits de Unicode, gastamos 1 byte extra al principio y solo un byte por cada símbolo.
Trabajo de una de las primeras versiones. Ya supera a UTF-8 con frecuencia, pero aún hay mucho que mejorar.
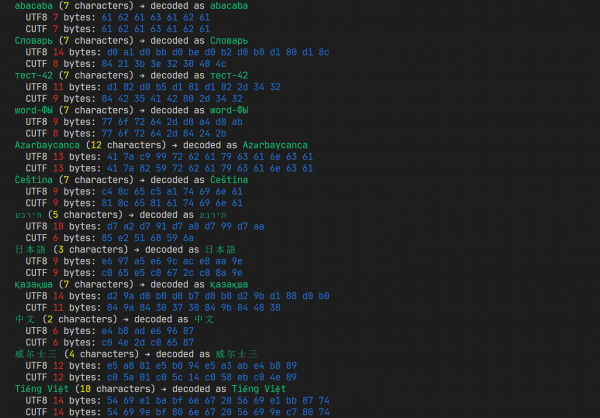
¿Qué ha empeorado? En primer lugar, tenemos un estado, a saber,
el desplazamiento del alfabeto actual y la bandera de modo largo. modo largoEsto nos limita adicionalmente: ahora los mismos caracteres pueden estar codificados de diferentes maneras en diferentes contextos. La búsqueda de subcadenas, por ejemplo, tendrá que hacerse teniendo esto en cuenta, y no simplemente comparando bytes. En segundo lugar, tan pronto como cambiamos el alfabeto, hubo problemas con la codificación de caracteres ASCII (y esto no solo incluye caracteres latinos, sino también puntuación básica, incluidos los espacios) — requieren un nuevo cambio de alfabeto en 0, es decir, de nuevo un byte adicional (y luego otro para volver a nuestro alfabeto principal).
Un alfabeto está bien, dos — mejor
Intentemos cambiar un poco nuestros prefijos de bits, añadiendo uno más a los tres descritos anteriormente:
0xxxxxxx — 1 byte en modo normal, 2 en modo extendido
11xxxxxx — 1 byte
100xxxxx xxxxxxxx — 2 bytes
101xxxxx xxxxxxxx xxxxxxxx — 3 bytes
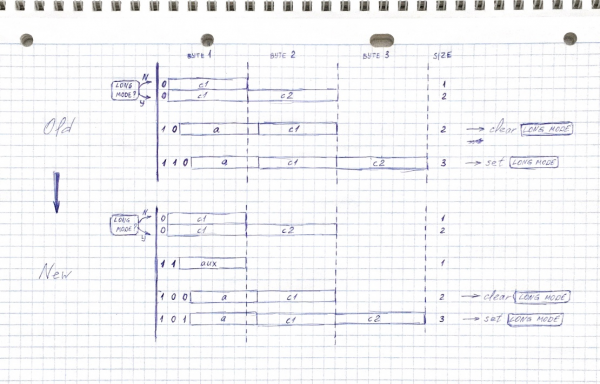
Ahora en la codificación de dos bytes hay un bit menos disponible — se pueden codificar puntos hasta 0x1FFF, y no 0x3FFF. Sin embargo, sigue siendo notablemente más que en los códigos de dos bytes de UTF-8, la mayor parte de los idiomas comunes todavía cabe, la pérdida más notable — se cayó y , los japoneses están tristes.
¿Cuál es el nuevo código 11xxxxxx? Это небольшой «загашник» размером в 64 символа, он дополняет наш основной алфавит, поэтому я назвал его вспомогательным (auxiliary) del alfabeto. Cuando cambiamos el alfabeto actual, un fragmento del alfabeto antiguo se convierte en auxiliar. Por ejemplo, cambiamos de ASCII a cirílico — ahora hay 64 caracteres en el 'almacén' que contienen caracteres latinos, números, espacios y una coma (las inserciones más comunes en textos no ASCII). Si cambiamos de nuevo a ASCII — el alfabeto auxiliar se convertirá en la parte principal del cirílico.
Gracias al acceso a dos alfabetos, podemos manejar una mayor cantidad de textos con un costo mínimo de cambio de alfabetos (la puntuación generalmente llevará a regresar a ASCII, pero después de eso, muchos caracteres no ASCII los obtendremos del alfabeto adicional, sin necesidad de un cambio adicional).
Bonus: al designar el alfabeto adicional con un prefijo 11xxxxxx y elegir su desplazamiento inicial igual a 0xC0, obtenemos compatibilidad parcial con CP1252. En otras palabras, muchos (pero no todos) los textos de Europa occidental codificados en CP1252 se verán igual en UTF-C.
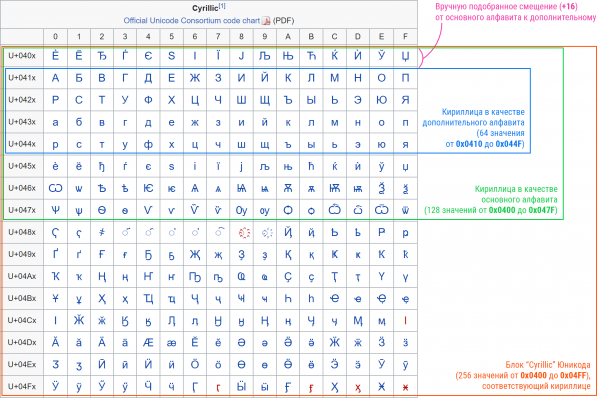
Aquí, sin embargo, surge una dificultad: ¿cómo obtener el auxiliar del alfabeto principal? Se puede dejar el mismo desplazamiento, pero — desafortunadamente — aquí la estructura de Unicode ya juega en nuestra contra. Muy a menudo la parte principal del alfabeto no está al inicio del bloque (por ejemplo, la 'A' mayúscula rusa tiene código 0x0410, aunque el bloque cirílico comienza con 0x0400). Por lo tanto, al tomar en 'caché' los primeros 64 caracteres, es posible que perdamos acceso a la parte final del alfabeto.
Para resolver este problema, revisé manualmente algunos bloques correspondientes a diferentes idiomas y señalé el desplazamiento del alfabeto auxiliar dentro del principal. En el caso del alfabeto latino, por excepción, lo reordené completamente al estilo de base64.
Los toques finales
Pensemos por último dónde más podríamos mejorar algo.
Notemos que el formato 101xxxxx xxxxxxxx xxxxxxxx permite codificar números hasta 0x1FFFFF, mientras que Unicode termina antes, en 0x10FFFF. En otras palabras, el último punto de código se representará como 10110000 11111111 11111111. Por lo tanto, podemos decir que si el primer byte tiene la forma 1011xxxx (donde xxxx es mayor que 0), significa algo más. Por ejemplo, se pueden añadir otros 15 caracteres, siempre disponibles para codificación en un byte, pero decidí proceder de otra manera.
Veamos aquellos bloques de Unicode que requieren tres bytes actualmente. En su mayoría, como ya se mencionó, son caracteres chinos, pero es difícil hacer algo al respecto, hay 21 mil. Sin embargo, también se incluyen hiragana y katakana, que son menos de doscientos. Y, dado que hemos mencionado a los japoneses, allí también están los emojis (en realidad están esparcidos en muchas partes de Unicode, pero los bloques principales están en el rango 0x1F300 – 0x1FBFF). Si pensamos en el hecho de que ahora existen emojis que se componen de varios puntos de código (por ejemplo, el emoji se compone de hasta 7 códigos), resulta muy desafortunado gastar tres bytes en cada uno (7×3 = 21 bytes por un solo símbolo, es un verdadero desastre).
Por lo tanto, elegimos algunos rangos seleccionados que corresponden a emojis, hiragana y katakana, los renumeramos en una sola lista continua y los codificamos en forma de dos bytes en lugar de tres:
1011xxxx xxxxxxxx
Genial: el mencionado emoji , que consiste en 7 puntos de código, en UTF-8 ocupa 25 bytes, y nosotros lo hemos comprimido en 14 (exactamente dos bytes para cada punto de código). A propósito, Habr se negó a procesarlo (tanto en el antiguo como en el nuevo editor), así que tuve que insertarlo como imagen.
Intentemos corregir otro problema. Como recordamos, el alfabeto principal es, en esencia, los 6 bits más significativos, que mantenemos en mente y adjuntamos al código de cada símbolo decodificado subsiguiente. En el caso de los caracteres chinos que están en el bloque 0x4E00 – 0x9FFF, es un bit 0 o 1. No es muy conveniente: tendremos que alternar constantemente entre estos dos valores (es decir, gastar tres bytes cada vez). Sin embargo, notemos que en el modo largo podemos restar del propio código el número de caracteres que estamos codificando mediante el modo corto (después de todas las astucias descritas anteriormente, esto son 10240) — así el rango de los caracteres se trasladará a 0x2600 – 0x77FF, y en este caso, en todo este rango, los 6 bits superiores (de 21) serán iguales a 0. Así, las secuencias de caracteres utilizarán dos bytes por carácter (lo que es óptimo para un rango tan grande), sin requerir cambios de alfabeto.
Soluciones alternativas: SCSU, BOCU-1
Los conocedores de Unicode, al leer el título del artículo, probablemente se apresuren a recordar que dentro de los estándares de Unicode hay (SCSU), que describe un método de codificación bastante similar al que se menciona en el artículo.
Confieso sinceramente: su existencia solo la descubrí después de haberme sumergido profundamente en la escritura de mi propia solución. Si hubiera sabido de él desde el principio, probablemente habría intentado escribir su implementación en lugar de idear mi propio enfoque.
Curiosamente, SCSU utiliza ideas muy parecidas a las que desarrollé por mi cuenta (en lugar del concepto de «alfabetos», se utilizan «ventanas», y hay más disponibles que los míos). Al mismo tiempo, este formato también tiene desventajas: está un poco más cerca de los algoritmos de compresión que de la codificación. En particular, el estándar ofrece múltiples formas de representación, pero no indica cómo elegir la óptima: para esto, el codificador debe aplicar ciertas heurísticas. Por lo tanto, un codificador SCSU que brinde una buena compresión será más complicado y voluminoso que mi algoritmo.
Para comparar, trasladé una implementación relativamente simple de SCSU a JavaScript — en cuanto a volumen de código fue comparable a mi UTF-C, pero en varios casos mostró resultados decenas de por ciento inferiores (en ocasiones puede superarlo, pero no mucho). Por ejemplo, textos en hebreo y griego fueron codificados en UTF-C un 60% mejor que SCSU (probablemente debido a sus compactos alfabetos).
Además, añadiré que, además de SCSU, también existe otro método de representación compacta de Unicode — , pero tiene como objetivo la compatibilidad con MIME (lo cual no necesitaba), y utiliza un enfoque ligeramente diferente para la codificación. No he evaluado su eficacia, pero me parece que no será mayor que la de SCSU.
Posibles mejoras
El algoritmo que he presentado no es universal por diseño (en esto, probablemente, mis objetivos divergen más de los del consorcio Unicode). Ya mencioné que fue desarrollado principalmente para una tarea (almacenamiento de un diccionario multilingüe en un árbol de prefijo), y algunas de sus características pueden no ser adecuadas para otras tareas. Pero el hecho de que no sea un estándar puede ser también una ventaja — puedes adaptarlo fácilmente a tus necesidades.
Por ejemplo, de manera obvia se puede eliminar la necesidad de estado, haciendo la codificación sin estado: simplemente no actualizar las variables ofertas, auxOffs y is21Bit en el codificador y el decodificador. En ese caso, no podrás empaquetar de manera eficiente secuencias de caracteres de un mismo alfabeto, pero garantizas que el mismo carácter siempre se codifica con los mismos bytes, independientemente del contexto.
Además, se puede afinar el codificador para un idioma específico, cambiando el estado por defecto — por ejemplo, orientándose hacia textos en ruso, configurando al principio del codificador y del decodificador offs = 0x0400 y auxOffs = 0. Esto tiene sentido especialmente en el caso del modo sin estado. En general, esto será similar al uso de codificación de ocho bits antigua, solo que no limita la posibilidad de insertar caracteres de todo Unicode según sea necesario.
Otra desventaja, mencionada anteriormente, es que en un texto voluminoso codificado en UTF-C no hay una forma rápida de encontrar el límite de un carácter cercano a un byte arbitrario. Si cortas del buffer codificado los últimos, digamos, 100 bytes, corres el riesgo de obtener basura, con la que no se puede hacer nada. La codificación no está diseñada para almacenar logs de varios gigabytes, pero en general esto se puede corregir. El byte 0xBF nunca debe encontrarse como primer byte (pero puede ser el segundo o tercero). Por lo tanto, al codificar se puede insertar una secuencia 0xBF 0xBF 0xBF cada, digamos, 10 Kb — así que cuando sea necesario, para encontrar el límite será suficiente escanear el trozo seleccionado hasta que se encuentre un marcador similar. Tras el último 0xBF garantizado será el inicio de un carácter. (Al decodificar, esta secuencia de tres bytes, por supuesto, debe ser ignorada.)
Resumiendo
Si has llegado hasta aquí, ¡felicitaciones! Espero que tú, al igual que yo, hayas aprendido algo nuevo (o refrescado lo antiguo) sobre la tecnología Unicode.
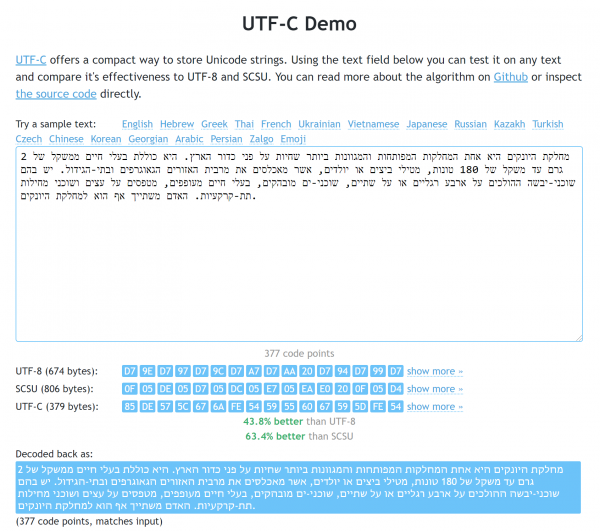
Página de demostración. A través del hebreo se pueden ver las ventajas tanto frente a UTF-8 como ante SCSU.
No se deben considerar las investigaciones anteriores como una invasión a los estándares. Sin embargo, en general estoy satisfecho con los resultados de mi trabajo y por eso estoy feliz de : por ejemplo, la biblioteca JS en su versión minimizada ocupa solo 1710 bytes (y, por supuesto, no tiene dependencias). Como mencioné anteriormente, se puede ver su funcionamiento en (allí también hay un conjunto de textos para compararla con UTF-8 y SCSU).
Por último, me gustaría volver a llamar la atención sobre los casos en los que usar UTF-C no vale la pena:
- Si tus cadenas son lo suficientemente largas (de 100 a 200 caracteres). En tal caso, deberías considerar el uso de algoritmos de compresión como deflate.
- Si necesitas transparencia ASCII, es decir, te importa que en las secuencias codificadas no aparezcan códigos ASCII que no estaban en la cadena original. Se puede evitar esta necesidad si al interactuar con API externas (por ejemplo, al trabajar con bases de datos) transmites el resultado de la codificación como un conjunto abstracto de bytes y no como cadenas. De lo contrario, corres el riesgo de obtener vulnerabilidades imprevistas.
- Si deseas poder encontrar rápidamente los límites de los caracteres a partir de un desplazamiento arbitrario (por ejemplo, al dañar parte de la cadena). Esto es posible, pero solo examinando la cadena desde el principio (o aplicando la mejora descrita en la sección anterior).
- Si necesitas realizar rápidamente operaciones sobre el contenido de las cadenas (ordenarlas, buscar subcadenas, concatenar). Para ello, primero es necesario decodificar las cadenas, por lo que UTF-C será más lento que UTF-8 en estos casos (pero más rápido que los algoritmos de compresión). Dado que una misma cadena siempre se codifica de la misma manera, la comparación exacta de la decodificación no requiere, se puede realizar byte a byte.
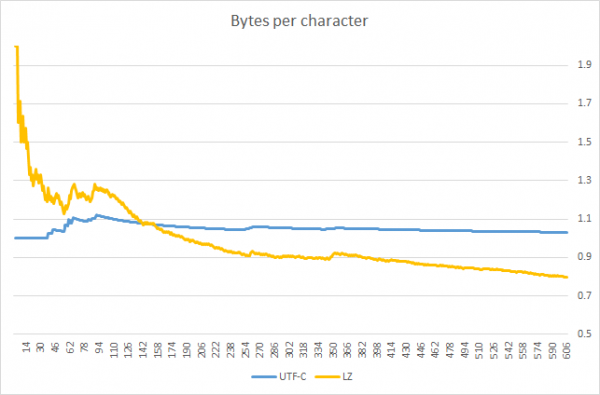
Update: usuario publicó un gráfico que destaca el límite de aplicabilidad de UTF-C. En él se puede ver que UTF-C es más eficaz que el algoritmo de compresión de propósito general (variaciones de LZW) mientras la cadena empaquetada sea más corta ~140 caracteres (aunque debo señalar que la comparación se realizó en un solo texto; para otros idiomas, el resultado puede variar).
Fuente: habr.com
