

Déjame contarte una historia técnica.
Hace muchos años, desarrollé una aplicación con funciones de colaboración integradas. Era un cómodo stack experimental que aprovechaba todo el potencial de las primeras versiones de React y CouchDB. Sincronizaba datos en tiempo real a través de JSON. . Se utilizaba en el trabajo interno de la empresa, pero su amplia aplicabilidad y potencial en otros ámbitos eran evidentes.
Al intentar vender esta tecnología a posibles clientes, nos encontramos con un obstáculo inesperado. En el video de demostración, nuestra tecnología se veía y funcionaba a la perfección, sin ningún problema. El video mostraba cómo funcionaba realmente, y no había nada simulado. Inventamos y codificamos un escenario realista de uso del programa.
De hecho, eso fue lo que se convirtió en un problema. Nuestra demo funcionaba como simulaban hacerlo los demás con sus aplicaciones. En concreto, la información se transmitía instantáneamente de A a B, incluso si eran archivos multimedia grandes. Después de iniciar sesión, cada usuario podía ver nuevas entradas. Con la aplicación, diferentes usuarios podían colaborar estrechamente en los mismos proyectos, incluso si había una conexión a Internet intermitente en algún lugar de un pueblo. Esto se da por sentado en cualquier video sobre el producto editado en After Effects.
A pesar de que todos sabían para qué sirve el botón Refresh, nadie entendía que las aplicaciones web que nos piden crear a menudo tienen sus limitaciones. Y que si ya no son necesarias, la experiencia del usuario será completamente diferente. Principalmente notaban que podían "chatear", dejando notas a sus interlocutores, por lo que se preguntaban en qué se diferenciaba esto de Slack, por ejemplo. ¡Uf!
Diseño de sincronizaciones cotidianas
Si ya tienes experiencia en desarrollo de software, deberías estar frustrado por tener que recordar que la mayoría de las personas no puede simplemente mirar una imagen de la interfaz y entender lo que hará al interactuar con ella. Sin mencionar lo que sucede dentro del propio programa. Saber lo que puede sucederá es en gran medida resultado del conocimiento de lo que no puede suceder y lo que no debe suceder. Para esto se requiere no solo de lo que hace el software, sino también de cómo se coordinan y comunican entre sí sus distintas partes.
Un ejemplo clásico de esto es un usuario que, durante veinte minutos, está mirando spinner.gif, preguntándose cuándo se completará finalmente el trabajo. Un desarrollador entendería que el proceso probablemente se ha bloqueado, y que el gif nunca desaparecerá de la pantalla. Esta animación simula que el trabajo está en progreso, pero no está relacionada con su estado. En tales casos, a algunos técnicos les gusta poner los ojos en blanco, asombrándose de cuán malinterpretado está el usuario. Sin embargo, pregúntate, ¿quién de ellos señala el reloj giratorio y dice que en realidad está parado?
Ahí radica el valor del tiempo real. Hoy en día, las bases de datos en tiempo real siguen siendo utilizadas en gran medida de manera escasa, y muchos las ven con sospecha. La mayoría de estas bases de datos tienden a adoptar el estilo NoSQL, por lo que normalmente se utilizan soluciones basadas en Mongo, que es mejor olvidar. Sin embargo, para mí, eso significa la comodidad de trabajar con CouchDB, así como estudiar el diseño de estructuras que no solo serán capaces de ser llenadas de datos por algún burócrata. Creo que estoy utilizando mi tiempo de manera más óptima.
Pero el verdadero tema de esta publicación es lo que estoy usando hoy. No por elección propia, sino debido a la política corporativa indiferente y ciega que se aplica. Por lo tanto, haré una comparación Totalmente Honesta e Imparcial de dos productos estrechamente relacionados para trabajar con bases de datos en tiempo real de Google.
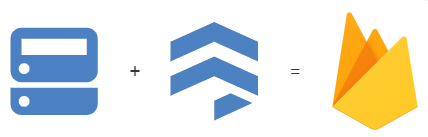
Ambos tienen la palabra Fire en sus nombres. Uno lo recuerdo con cariño. El segundo para mí es otro tipo de fuego. No tengo prisa por decir sus nombres, porque en cuanto lo haga, nos confrontaremos con el primer gran problema: los nombres.
El primero se llama Firebase Real-Time Database, y el segundo — Firebase Cloud Firestore. Ambos son productos de la Firebase suite de Google. Sus API se llaman, respectivamente, firebase.database(…) y firebase.firestore(…).
Esto sucedió porque Real-Time Database es simplemente la versión original Firebase antes de su compra por Google en 2014. Luego, en Google decidieron crear un producto paralelo, una copia de Firebase basada en los big data de la compañía, y la llamaron Firestore with a cloud. Espero que no te hayas confundido aún. Si te has confundido, no te preocupes, yo mismo reescribí esta parte del artículo diez veces.
Porque es necesario especificar Firebase en cuestión de Firebase, y Firestore en el asunto de Firebase, al menos para hacerte entender hace unos años en Stack Overflow.
Si hubiera un premio para el peor nombramiento de productos de software, este caso definitivamente sería un fuerte candidato. La distancia de Hamming entre estos nombres es tan pequeña que confunde incluso a los ingenieros experimentados, cuyas manos escriben un nombre mientras su cabeza piensa en otro. Son planes que fracasaron estrepitosamente, ideados con las mejores intenciones; cumplieron la profecía de que la base de datos estaría ardiendo. Y no estoy bromeando. La persona que ideó tal esquema de nomenclatura ha causado sangre, sudor y lágrimas.
Victoria pírrica
Se podría pensar que Firestore es una sustitución de Firebase, su descendiente de siguiente generación, pero eso sería un error. Firestore no está destinado a ser un reemplazo de Firebase. Parece que alguien le quitó todo lo interesante y enredó gran parte de lo que quedó de varias maneras.
Sin embargo, una mirada rápida a los dos productos puede confundirte: parece que hacen lo mismo, a través de API mayormente idénticas y aun en la misma sesión de base de datos. Las diferencias son sutiles y se descubren solo al estudiar detenidamente la extensa documentación comparativa. O cuando intentas portar código que funciona perfectamente en Firebase para que funcione con Firestore. Ya entonces te das cuenta de que la interfaz de la base de datos se queda en blanco tan pronto como intentas arrastrar el mouse en tiempo real. Repito, no estoy bromeando.
El cliente de Firebase es cortés en el sentido de que almacena los cambios en búfer y realiza reintentos automáticos de actualización, priorizando la última operación de escritura. Sin embargo, Firestore tiene una limitación de 1 operación de escritura por documento por usuario por segundo, y esta limitación la impone el servidor. Cuando trabajas con él, tú mismo debes encontrar la manera de sortear esta restricción e implementar un limitador de frecuencia de actualizaciones, incluso cuando solo intentas crear tu aplicación. Es decir, Firestore es una base de datos en tiempo real sin un cliente en tiempo real, que se disfraza como tal a través de su API.
Aquí es donde comenzamos a ver los primeros signos del sentido de existencia de Firestore. Puede que me equivoque, pero sospecho que alguien en lo más alto de Google vio Firebase después de la adquisición y simplemente dijo: 'No, Dios mío, no. Esto es inaceptable. No bajo mi mando.'
Salió de sus aposentos y proclamó:
¿'¿Un gran documento JSON? No. Ustedes dividirán los datos en documentos individuales, cada uno de los cuales tendrá un tamaño de no más de 1 megabyte.'
Parece que tal restricción no sobrevivirá al primer choque con cualquier base de usuarios suficientemente motivada. Sabes que es cierto. En nuestro trabajo, por ejemplo, tenemos más de mil quinientas presentaciones, y eso es completamente normal.
Con tal restricción, tendrás que aceptar el hecho de que un 'documento' en la base de datos no se parecerá a ningún objeto que el usuario podría llamar documento.
¿'¿Arreglos de arreglos, que pueden contener otros elementos recursivamente? No. Los arreglos solo contendrán objetos o números de longitud fija, como lo desea el Señor.'
Así que si esperabas incluir tu GeoJSON en Firestore, te darás cuenta de que eso es imposible. No se permite nada de dimensión múltiple. Espero que te guste Base64 y/o JSON dentro de JSON.
¿'¿Importación y exportación de JSON por HTTP, herramientas de línea de comandos o panel de administración? No. Solo podrás exportar e importar datos a Google Cloud Storage. Así es como parece llamarse ahora. Y cuando digo 'tú', me dirijo solo a aquellos que tienen las credenciales de Propietario del Proyecto. Todos los demás pueden ir y crear tickets.'
Como puedes ver, el modelo de datos de Firebase es fácil de describir. Contiene un enorme documento JSON que vincula las claves JSON con rutas URL. Si escribes usando HTTP PUT en / FireBase lo siguiente:
{
  "hello": "world"
}
Entonces GET /hello devolverá "world". En su mayor parte, funciona exactamente como esperas. Una colección de objetos FireBase /my-collection/:id es equivalente a un diccionario JSON {"my-collection": {...}} en la raíz, cuyo contenido es accesible en /my-collection:
{
  "id1": {...object},
  "id2": {...object},
  "id3": {...object},
  // ...
}
Esto funciona excelente si cada inserción tiene un ID sin colisiones, para lo cual hay una solución estándar en el sistema.
En otras palabras, la base de datos es 100% compatible con JSON (*) y funciona perfectamente con HTTP, como CouchDB. Sin embargo, principalmente la utilizas a través de una API en tiempo real que abstrae websockets, autorización y suscripciones. El panel de administración ofrece ambas capacidades, permitiendo tanto la edición en tiempo real como la importación/exportación de JSON. Si en tu código sigues lo mismo, te sorprenderás de cuánta cantidad de código especializado desaparecerá al darte cuenta de que el patch y diff de JSON resuelven el 90% de las tareas rutinarias de manejo de estado persistente.
El modelo de datos de Firestore es similar a JSON, pero se diferencia en algunos aspectos críticos. Ya he mencionado la ausencia de arrays dentro de arrays. El modelo de sub-colecciones es que son conceptos de primera clase, separados del documento JSON que las contiene. Como no existe una serialización lista para esto, se requiere una ruta de ejecución de código especializada para leer y escribir datos. Para manejar colecciones personalizadas, es necesario escribir tus propios scripts y herramientas. El panel de administración solo te permite hacer pequeños cambios en un campo a la vez, y no tiene capacidades de importación/exportación.
Tomaron una base de datos NoSQL en tiempo real y la convirtieron en una lenta no-SQL con auto-fusión y una columna separada de no-JSON. Algo en la línea de GraftQL.
Java caliente
Si Firestore tenía que volverse más confiable y escalable, la ironía es que el desarrollador promedio obtendrá una solución menos confiable que al elegir FireBase 'listo para usar'. El software que necesita el Administrador de Base de Datos Gruñón, requiere un nivel de esfuerzo y calibre de especialistas que es simplemente irrealista para el nicho en el que supuestamente debería haber un buen producto. Es como si HTML5 Canvas no fuera en absoluto un reemplazo para Flash, si no hay herramientas de desarrollo y reproductor. Además, Firestore se ha enredado en su búsqueda de la limpieza de datos y la validación estéril, algo que simplemente no se alinea con la forma en que el usuario promedio de negocios prefiere trabajar: para él, no es necesario, ya que hasta el final todo es un borrador.
La principal desventaja de FireBase es que el cliente se creó varios años antes de lo necesario, incluso antes de que la mayoría de los desarrolladores web conocieran la inmutabilidad. Debido a esto, FireBase asume que vas a modificar los datos y, por lo tanto, no aprovecha los beneficios de la inmutabilidad proporcionada por el usuario. Además, no reutiliza los datos en los snapshots enviados al usuario, lo que hace que realizar diffs sea mucho más complicado. Para documentos grandes, su mecanismo transaccional basado en diffs modificables simplemente no es adecuado. Chicos, ya tenemos WeakMap en JavaScript. Es conveniente.
Si das a los datos la forma adecuada y no haces los árboles demasiado voluminosos, se puede evitar este problema. Pero me pregunto, ¿sería FireBase mucho más interesante si los desarrolladores lanzaran una API del cliente realmente buena que utilizara la inmutabilidad junto con consejos prácticos serios sobre la estructura de bases de datos? En vez de eso, parece que intentaron arreglar algo que no estaba roto, y resultó peor.
No sé toda la lógica detrás de la creación de Firestore. Reflexionar sobre los motivos que surgen dentro de una caja negra también es parte de la diversión. Tal contraposición de dos bases de datos extremadamente similares pero incomparables es bastante rara. Es como si alguien pensara: «Firebase es solo una función que podemos emular en Google Cloud», pero al mismo tiempo aún no ha descubierto el concepto de definir los requisitos del mundo real o de crear soluciones útiles que satisfacen todos esos requisitos. «Deja que lo piensen los desarrolladores. Simplemente haz que la interfaz de usuario se vea bien... ¿Se puede añadir más fuego?»
Entiendo un par de cosas sobre las estructuras de datos. Veo claramente que la concepción de «todo en un gran árbol JSON» es un intento de abstraer de la base de datos cualquier sensación de estructura a gran escala. Esperar que el software simplemente gestione cualquier fractal dudoso de estructura de datos es simplemente una locura. No necesito ni imaginar lo mal que pueden estar las cosas; he llevado a cabo auditorías de código rigurosas y he visto cosas que ustedes, humanos, ni siquiera han soñado.. Pero también sé cómo lucen las buenas estructuras, y Puedo imaginar un mundo en el que Firestore parecería completamente lógica, y las personas que la crearon pensarían que hicieron un buen trabajo. Pero no vivimos en ese mundo.
El soporte para construir consultas en FireBase es deficiente por cualquier estándar, prácticamente no existe. Definitivamente requiere mejoras o al menos una revisión. Pero Firestore no es mucho mejor, ya que está limitada por los mismos índices unidimensionales que existen en un SQL simple. Si necesitas consultas que las personas realicen con datos desordenados, se requiere búsqueda de texto completo, filtros en varios rangos y un orden arbitrario definido por el usuario. Con un examen más cuidadoso, las funciones del SQL simple son demasiado limitadas por sí solas. Además, las únicas consultas SQL que las personas pueden ejecutar en producción son consultas rápidas. Necesitarás una solución especializada para la indexación con estructuras de datos bien pensadas. Para todo lo demás, al menos debería haber un map-reduce incremental o algo similar.
Si buscas información sobre esto en la documentación de Google, espero que te dirijan hacia algo como BigTable y BigQuery. Sin embargo, todas estas soluciones vienen acompañadas de una cantidad de denso jerga corporativa que te hará regresar rápidamente y empezar a buscar algo diferente.
Lo último que necesitas en una base de datos en tiempo real es algo creado por personas y para personas, trabajando bajo una escala de sueldos para la dirección.
(*) Esto es una broma, no existe tal cosa como .
Publicidad
Buscando para depurar proyectos, ¿servidor para desarrollo y alojamiento? Definitivamente eres nuestro cliente 🙂 Precios por día para servidores de diversas configuraciones, antiDDoS y licencias de Windows ya están incluidos en el costo.
Fuente: habr.com
