

Hoy en día, la mayoría de los productos de software se desarrollan en equipos. Las condiciones para el éxito del desarrollo en equipo se pueden representar en un esquema simple.
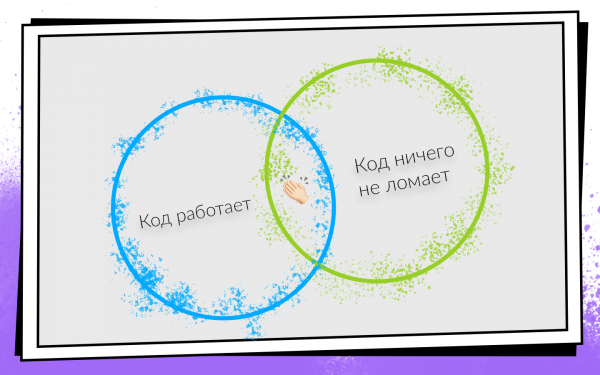
Una vez que escribas tu código, debes asegurarte de que:
- Funciona.
- No rompe nada, incluyendo el código que han escrito tus compañeros.
Si ambas condiciones se cumplen, estás en el camino hacia el éxito. Para verificar fácilmente estas condiciones y no desviarte de un camino ventajoso, se ideó la Integración Continua.
CI es un proceso de trabajo en el que integras tu código en el código general del producto con la mayor frecuencia posible. Y no solo integras, sino que además revisas constantemente que todo funcione. Dado que necesitas hacer muchas verificaciones y con frecuencia, vale la pena pensar en la automatización. Se puede verificar todo manualmente, pero no es recomendable, y aquí está el porqué.
- Las personas son costosas. La hora de trabajo de un programador cuesta más que la hora de trabajo de cualquier servidor.
- Las personas cometen errores. Por lo tanto, pueden surgir situaciones en las que se ejecuten pruebas en la rama incorrecta o se compila el commit equivocado para los testers.
- Las personas son perezosas. De vez en cuando, cuando termino alguna tarea, me surge el pensamiento: '¿Para qué comprobar esto? Solo escribí dos líneas; seguro que todo funciona!' Creo que a algunos de ustedes también les vienen a la mente esos pensamientos a veces. Pero siempre hay que verificar.
Cómo se implementó y desarrolló la Integración Continua en el equipo de desarrollo móvil de Avito, cómo pasaron de 0 a 450 compilaciones al día, y qué las máquinas de compilación reúnen 200 horas al día, lo cuenta Nikolai Nesterov () — participante de todos los cambios evolutivos en CI/CD de la aplicación Android.
La narración está basada en el ejemplo del equipo de Android, pero la mayoría de los enfoques son aplicables también en iOS.
Hace mucho tiempo, en el equipo de Android de Avito, solo trabajaba una persona. Por definición, no necesitaba nada de Integración Continua: no había con quién integrarse.
Pero la aplicación crecía, surgían cada vez más tareas nuevas y, por lo tanto, el equipo también crecía. En algún momento llegó el momento de formalizar más el proceso de integración del código. Se decidió utilizar Git flow.
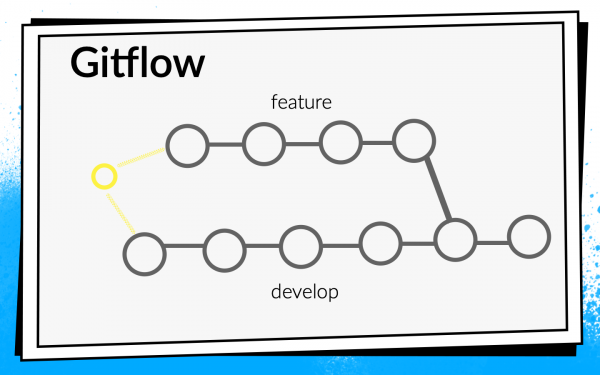
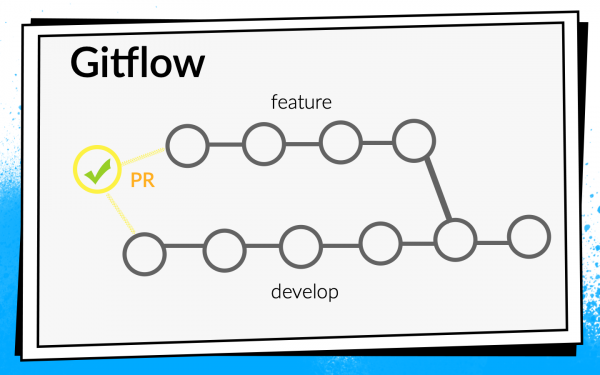
La conceptualización de Git flow es conocida: en el proyecto hay una rama común llamada develop, y para cada nueva funcionalidad, los desarrolladores crean una rama separada, hacen commits en ella, la empujan y, cuando desean fusionar su código en la rama develop, abren una pull request. Para compartir conocimientos y discutir enfoques, hemos implementado revisiones de código, es decir, los colegas deben revisar y confirmar el código de los demás.
Revisiones
Ver el código no es suficiente, por lo tanto se implementan revisiones automáticas.
- Primero comprobamos la construcción de ARC.
- Muchos tests de Junit.
- Calculamos la cobertura de código, dado que estamos ejecutando pruebas.
Para entender cómo se deben ejecutar estas pruebas, observemos el proceso de desarrollo en Avito.
Esquemáticamente, se puede representar así:
- El desarrollador escribe código en su portátil. Se pueden ejecutar pruebas de integración aquí mismo — ya sea mediante un hook de commit o simplemente ejecutando pruebas en segundo plano.
- Después de que el desarrollador haya empujado el código, abre una pull request. Para que su código entre en la rama develop, debe pasar por una revisión de código y obtener el número necesario de aprobaciones. Se pueden incluir pruebas y compilaciones aquí: mientras no todas las compilaciones sean exitosas, la pull request no puede fusionarse.
- Una vez que la pull request se fusiona y el código entra en develop, se puede elegir un momento conveniente: por ejemplo, de noche, cuando todos los servidores están libres, y ejecutar tantas pruebas como se pueda.
A nadie le gustó ejecutar pruebas en su propio portátil. Cuando el desarrollador termina una funcionalidad, quiere empujarla rápidamente y abrir la pull request. Si en ese momento se están ejecutando algunas pruebas largas, no solo es incómodo, sino que también ralentiza el desarrollo: mientras el portátil está comprobando algo, no se puede trabajar normalmente.
Nos gustó mucho ejecutar pruebas por la noche, porque hay mucho tiempo y servidores, se puede disfrutar. Pero, desafortunadamente, cuando el código de la funcionalidad entra en develop, el desarrollador ya tiene mucha menos motivación para corregir los errores que encontró CI. De vez en cuando me encontraba pensando, al ver el informe matutino con todos los errores encontrados, que los arreglaría en otro momento, porque actualmente tengo una nueva tarea interesante en Jira que realmente quiero comenzar.
Si las pruebas bloquean la pull request, entonces hay suficiente motivación, porque mientras las compilaciones no se pongan en verde, el código no entrará en develop, y por lo tanto, la tarea no se completará.
Al final, elegimos esta estrategia: por la noche realizamos la máxima cantidad posible de pruebas, y las más críticas y, lo más importante, rápidas, las ejecutamos en la solicitud de extracción. Pero no nos detenemos ahí; paralelamente optimizamos la velocidad de las pruebas para poder pasarlas de modo nocturno a pruebas en la solicitud de extracción.
En ese momento, todas nuestras compilaciones pasaban bastante rápido, así que simplemente activamos como bloqueador en la solicitud de extracción la compilación ARK, pruebas Junit y el cálculo de la cobertura de código. Lo activamos, pensamos... y nos deshicimos de la cobertura de código, porque consideramos que no la necesitábamos.
La configuración básica de CI nos tomó dos días (las estimaciones de tiempo aquí y en adelante son aproximadas, necesarias para dar una idea de la escala).
Después de esto comenzamos a pensar más: ¿estamos verificando correctamente? ¿Estamos ejecutando las compilaciones en la solicitud de extracción de manera adecuada?
Ejecutamos la compilación en el último commit de la rama desde la cual se abrió la solicitud de extracción. Pero las verificaciones de ese commit solo pueden mostrar que el código que escribió el desarrollador funciona. No demuestran que no rompió nada. En realidad, debemos verificar el estado de la rama develop después de que se haya integrado la característica.
Para esto, escribimos un sencillo script bash. premerge.sh:
#!/usr/bin/env bash

set -e

git fetch origin develop

git merge origin/develop
Aquí simplemente se traen todos los cambios más recientes de develop y se fusionan en la rama actual. Agregamos el script premerge.sh como primer paso de todas las compilaciones y comenzamos a verificar exactamente lo que queremos, es decir, integración..
Para la localización de problemas, búsqueda de soluciones y redacción de este script, nos llevó tres días.
La aplicación fue evolucionando, aparecían más tareas, el equipo crecía y premerge.sh a veces comenzó a defraudarnos. Cambios conflictivos ingresaban en develop, rompiendo la compilación.
Un ejemplo de cómo sucede esto:
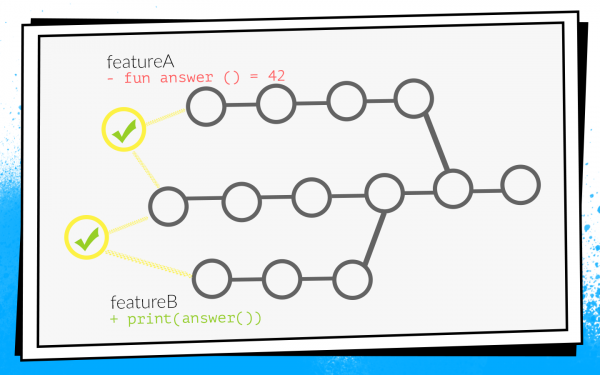
Dos desarrolladores comienzan a trabajar en las características A y B al mismo tiempo. El desarrollador de la característica A descubre una función no utilizada en el proyecto, answer() y, como un buen explorador, la elimina. Mientras tanto, el desarrollador de la característica B en su rama agrega una nueva llamada a esta función.
Los desarrolladores terminan su trabajo y al mismo tiempo abren la solicitud de extracción. Se inician las compilaciones, premerge.sh verifica ambas solicitudes de extracción con respecto al estado fresco de develop: todas las verificaciones están verdes. Después de esto, se fusiona la solicitud de extracción de la característica A, se fusiona la solicitud de extracción de la característica B... ¡Boom! Develop se rompe, porque en el código de develop hay una llamada a una función inexistente.
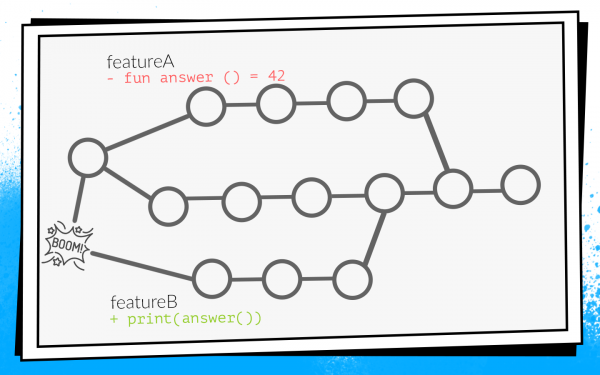
Cuando develop no se compila, esto es catástrofe local. Todo el equipo no puede reunir nada para las pruebas.
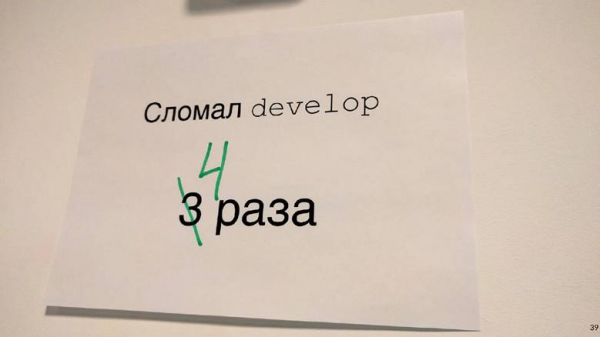
Resulta que, con mayor frecuencia, me ocupé de tareas de infraestructura: analítica, red, bases de datos. Es decir, fui yo quien escribió las funciones y clases que utilizan otros desarrolladores. Por eso, a menudo me encontraba en situaciones similares. Incluso hubo un tiempo en el que tenía esta imagen colgada.
Dado que eso no nos satisfacía, comenzamos a explorar opciones para prevenirlo.
Cómo no romper develop
Primera opción: reconstruir todos los pull requests al actualizar develop. Si en nuestro ejemplo el pull request con la característica A llega primero a develop, el pull request de la característica B se reconstruirá y, por lo tanto, no pasará las pruebas debido a un error de compilación.
Para entender cuánto tiempo llevará esto, consideremos el ejemplo de dos PR. Abrimos dos PR: dos compilaciones, dos ejecuciones de pruebas. Después de que el primer PR se mezcle en develop, el segundo necesita ser reconstruido. En total, para dos PR se necesitan tres ejecuciones de pruebas: 2 + 1 = 3.
En principio, está bien. Pero revisamos las estadísticas, y una situación típica en nuestro equipo era tener 10 PR abiertos, y entonces el número de pruebas sería la suma de la progresión: 10 + 9 +… + 1 = 55. Es decir, para aceptar 10 PR, hay que reconstruir 55 veces. Y eso en una situación ideal, cuando todas las pruebas pasan a la primera, cuando nadie abre un pull request adicional mientras se procesan esos diez.
Imagínate como desarrollador, que necesitas apresurarte a presionar el botón "merge" primero, porque si lo hace el vecino, entonces tendrás que esperar a que todas las compilaciones se realicen de nuevo... No, eso no funcionará, ralentizará gravemente el desarrollo.
Segunda posible manera: compilar pull requests después de code review. Es decir, abres un pull request, obtienes la cantidad necesaria de aprobaciones de tus colegas, corriges lo que sea necesario, y después ejecutas las compilaciones. Si son exitosas, el pull request se mezcla con develop. En este caso, no hay reinicios adicionales, pero la retroalimentación se ralentiza considerablemente. Yo, como desarrollador, al abrir un pull request, quiero ver inmediatamente si se compila. Por ejemplo, si alguna prueba falla, necesito arreglarla rápidamente. En el caso de una compilación retrasada, la retroalimentación se ralentiza, lo que significa que todo el desarrollo también se ralentiza. Esto tampoco nos satisfizo.
Al final, solo quedó la tercera opción — hacerlo a mano. Todo nuestro código y todos nuestros archivos fuente se almacenan en el repositorio del servidor Bitbucket. Por lo tanto, tuvimos que desarrollar un complemento para Bitbucket.
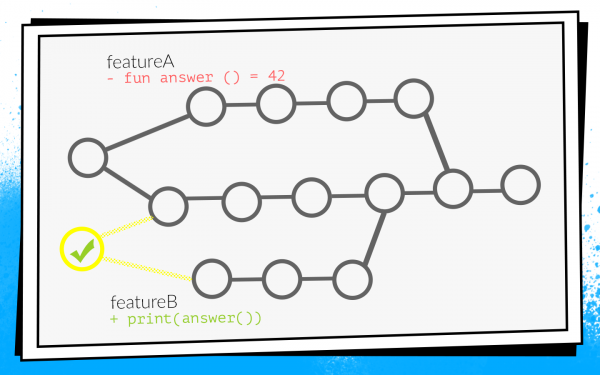
Este complemento redefine el mecanismo de fusión de pull requests. Comienza de manera estándar: se abre un PR, se ejecutan todas las compilaciones, y se realiza la revisión de código. Pero después de que la revisión de código ha sido aprobada, y el desarrollador decide presionar 'merge', el complemento verifica en qué estado se encontraba develop cuando se realizaron las verificaciones. Si después de las compilaciones develop se ha actualizado, el complemento no permitirá fusionar dicho pull request en la rama principal. Simplemente reiniciará las compilaciones en relación con el develop actualizado.
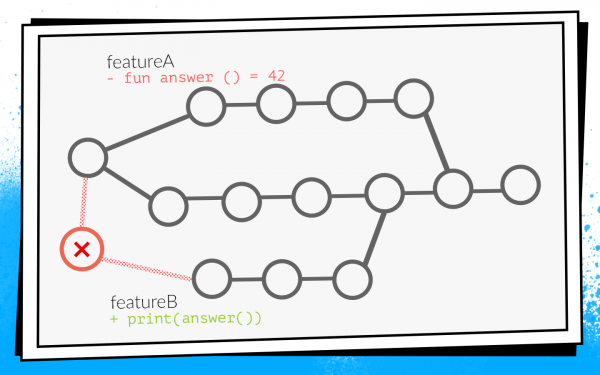
En nuestro ejemplo con cambios en conflicto, tales compilaciones no pasarán debido a un error de compilación. Por lo tanto, el desarrollador de la función B tendrá que corregir el código y reiniciar las verificaciones, momento en el cual el complemento aplicará automáticamente el pull request.
Antes de implementar este complemento, teníamos un promedio de 2.7 lanzamientos de verificación por cada pull request. Con el complemento, se convirtió en 3.6 lanzamientos. Esto fue satisfactorio para nosotros.
Cabe destacar que este complemento tiene una desventaja: reinicia la compilación solo una vez. Es decir, todavía queda una pequeña ventana a través de la cual podrían entrar cambios en conflicto en develop. Pero la probabilidad de que esto ocurra es baja, y decidimos aceptar este compromiso entre el número de lanzamientos y el riesgo de fallos. En dos años, solo sucedió una vez, por lo que probablemente no fue en vano.
Nos tomó dos semanas desarrollar la primera versión del complemento para Bitbucket.
Nuevas verificaciones
Mientras tanto, nuestro equipo continuó creciendo. Se añadieron nuevas verificaciones.
Pensamos: ¿por qué arreglar errores si se pueden prevenir? Y por eso implementamos análisis estático de código. Comenzamos con lint, que forma parte del Android SDK. Pero en ese momento no sabía trabajar con código Kotlin, y ya teníamos el 75% de la aplicación escrita en Kotlin. Así que junto con lint, se añadieron las verificaciones integradas de Android Studio.
Para ello, tuvimos que hacer muchas acrobacias: tomar Android Studio, empaquetarla en Docker y ejecutarla en CI con un monitor virtual, para que pensara que estaba corriendo en una laptop real. Pero funcionó.
También en ese momento comenzamos a escribir muchas pruebas de instrumentación e implementamos pruebas de capturas de pantalla. Esto es cuando se genera una captura de pantalla de referencia para una pequeña vista específica, y la prueba consiste en tomar una captura de pantalla de esa vista y compararla píxel por píxel con la referencia. Si hay alguna discrepancia, significa que algo falló en la maquetación o hay algún problema con los estilos.
Pero las pruebas de instrumentación y las pruebas de captura de pantalla deben ejecutarse en dispositivos: en emuladores o en dispositivos reales. Teniendo en cuenta que hay muchas pruebas y se ejecutan con frecuencia, se necesita una granja completa. Crear nuestra propia granja consume demasiados recursos, así que encontramos una opción lista: Firebase Test Lab.
Firebase Test Lab
Se eligió porque Firebase es un producto de Google, es decir, debería ser confiable y es poco probable que desaparezca. Los precios son accesibles: 5$ por hora de uso de un dispositivo real, 1$ por hora de uso de un emulador.
La implementación de Firebase Test Lab en nuestro CI tomó aproximadamente tres semanas.
Sin embargo, el equipo continuó creciendo y, desafortunadamente, Firebase comenzó a fallarnos. En ese momento no tenía ningún SLA. A veces, Firebase hacía esperar hasta que estuvieran disponibles suficientes dispositivos para las pruebas, en lugar de comenzar a ejecutarlas de inmediato, como deseábamos. La espera en la cola podía llevar hasta media hora, lo cual es mucho tiempo. Las pruebas de instrumentación se ejecutaban en cada PR, y los retrasos ralentizaban mucho el desarrollo, y luego llegó la factura mensual con una suma considerable. En resumen, se decidió abandonar Firebase y construir una solución interna, ya que el equipo había crecido lo suficiente.
Docker + Python + bash
Tomamos Docker, metimos emuladores en él, y escribimos un programa simple en Python que, en el momento adecuado, lanza la cantidad necesaria de emuladores en la versión requerida y, cuando es necesario, los detiene. Y, por supuesto, un par de scripts en bash, ¿cómo podríamos estar sin ellos?
La creación de nuestro propio entorno de prueba tomó cinco semanas.
Como resultado, cada pull request tenía una extensa lista de verificaciones bloqueantes de fusión:
- Construcción de ARC;
- Pruebas Junit;
- Lint;
- Verificaciones de Android Studio;
- Pruebas de instrumentación;
- Pruebas de captura de pantalla.
Esto prevenía muchos posibles fallos. Técnicamente, todo funcionaba, pero los desarrolladores se quejaban de que esperar los resultados tomaba demasiado tiempo.
¿Demasiado tiempo? Examinamos los datos de Bitbucket y TeamCity en un sistema de análisis y entendimos que el tiempo promedio de espera es de 45 minutos. Es decir, un desarrollador que abre un pull request espera en promedio 45 minutos los resultados de los builds. En mi opinión, eso es demasiado y no se puede trabajar así.
Por supuesto, decidimos acelerar todas nuestras compilaciones.
Acelerando
Al ver que a menudo las compilaciones estaban en cola, primero compramos más hardware — el desarrollo extensivo es lo más sencillo. Las compilaciones dejaron de estar en cola, pero el tiempo de espera solo se redujo un poco, porque algunas verificaciones en sí mismas tardaban mucho tiempo.
Eliminamos las verificaciones demasiado largas
Nuestra integración continua podría detectar este tipo de errores y problemas.
- No compila. La integración continua puede atrapar un error de compilación cuando, debido a cambios conflictivos, algo no se compila. Como ya mencioné, en ese momento nadie puede compilar nada, el desarrollo se detiene y todos se ponen nerviosos.
- Un error en el comportamiento. Por ejemplo, cuando la aplicación se compila, pero al hacer clic en un botón se cierra, o el botón ni siquiera responde. Esto es malo porque dicho error puede llegar al usuario.
- Un error en el diseño. Por ejemplo, el botón responde, pero se ha movido 10 píxeles hacia la izquierda.
- Aumento de la deuda técnica.
Al observar esta lista, nos dimos cuenta de que solo los dos primeros puntos son críticos. Queremos detectar tales problemas en primer lugar. Los errores de diseño se identifican en la etapa de revisión de diseño y se pueden corregir fácilmente. El trabajo con la deuda técnica requiere un proceso y planificación separados, por lo que decidimos no verificarlo en el pull request.
Basándonos en esta clasificación, revisamos toda la lista de verificaciones. Eliminamos Lint y trasladamos su ejecución a la noche: solo para que entregue un informe de cuántos problemas hay en el proyecto. Acordamos trabajar por separado con la deuda técnica, y nos deshicimos por completo de las verificaciones de Android Studio. Android Studio en Docker para ejecutar inspecciones suena interesante, pero causa muchos problemas en el soporte. Cualquier actualización de las versiones de Android Studio es una lucha contra errores inexplicables. También era complicado mantener las pruebas de captura de pantalla, porque la biblioteca no funcionaba muy estable, había disparos falsos. Eliminamos las pruebas de captura de pantalla de la lista de verificaciones.
En última instancia, nos quedaron:
- Construcción de ARC;
- Pruebas Junit;
- Pruebas de Instrumentación.
Caché remoto de Gradle
Sin verificaciones pesadas, todo ha mejorado. Pero no hay límite para la perfección.
Nuestra aplicación ya estaba dividida en aproximadamente 150 módulos gradle. Normalmente, en tal caso, el caché remoto de Gradle funciona bien, y decidimos probarlo.
El caché remoto de Gradle es un servicio que puede almacenar en caché los artefactos de compilación para tareas individuales en módulos separados. Gradle, en lugar de compilar el código realmente, se conecta por HTTP al caché remoto y pregunta si alguien ya ejecutó esa tarea. Si es así, simplemente descarga el resultado.
Iniciar el caché remoto de Gradle es fácil, porque Gradle proporciona una imagen de Docker. Logramos hacerlo en tres horas.
Solo necesitábamos iniciar Docker y escribir una línea en el proyecto. Pero aunque se puede iniciar rápidamente, para que todo funcione bien, se necesitará bastante tiempo.
A continuación se muestra el gráfico de fallos de caché.
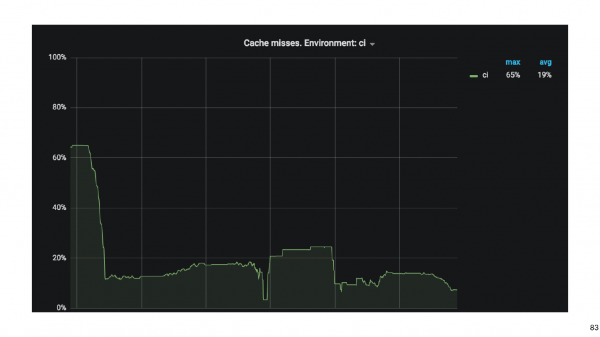
Al principio, el porcentaje de fallos de caché era de aproximadamente 65. Después de tres semanas, logramos reducir este valor al 20%. Resultó que las tareas que compila la aplicación de Android tienen dependencias transitivas extrañas, lo que causó que Gradle fallara en el caché.
Al activar el caché, aceleramos significativamente la compilación. Pero además de la compilación, también se ejecutan pruebas de instrumentación, y estas tardan mucho. Es posible que no sea necesario ejecutar todas las pruebas en cada solicitud de extracción. Para averiguarlo, utilizamos el análisis de impacto.
Análisis de impacto
En la solicitud de extracción, recopilamos el diff de git y encontramos los módulos de Gradle modificados.
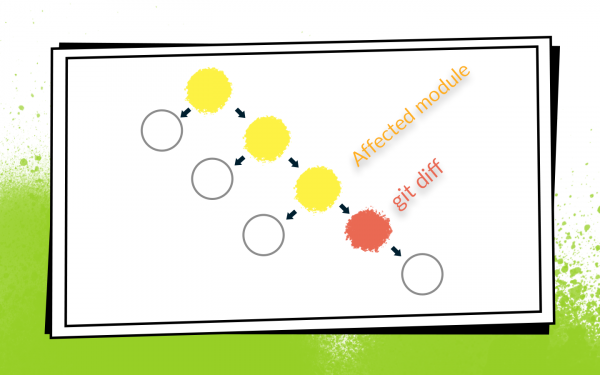
Tiene sentido ejecutar solo las pruebas de instrumentación que verifican los módulos modificados y todos los módulos de los que dependen. No tiene sentido ejecutar pruebas para módulos vecinos: allí no se modificó el código, y nada puede romperse.
Con las pruebas de instrumentación, no es tan simple, porque deben estar en el módulo superior Application. Aplicamos una heurística con análisis de bytecode para entender a qué módulo pertenece cada prueba.
La modernización del trabajo de las pruebas de instrumentación para que solo verifiquen los módulos implicados tomó alrededor de ocho semanas.
Las medidas para acelerar las verificaciones funcionaron con éxito. Pasamos de 45 minutos a unos 15. Esperar un cuarto de hora para la compilación ya es aceptable.
Pero ahora los desarrolladores han comenzado a quejarse de que no pueden entender qué compilaciones se están ejecutando, dónde ver los logs, por qué la compilación falló, qué prueba falló, etc.
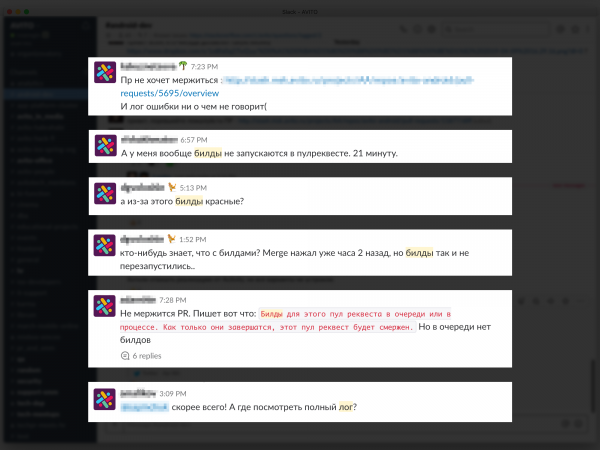
Los problemas con la retroalimentación ralentizan el desarrollo, por lo que hemos tratado de proporcionar la información más clara y detallada posible sobre cada PR y construcción. Comenzamos con comentarios en Bitbucket para el PR indicando qué construcción falló y por qué, y enviamos mensajes directos en Slack. Al final, creamos una página de panel de control de PR con una lista de todas las construcciones que se están ejecutando actualmente y su estado: en cola, en ejecución, fallido o completado. Se puede hacer clic en la construcción y acceder a su registro.
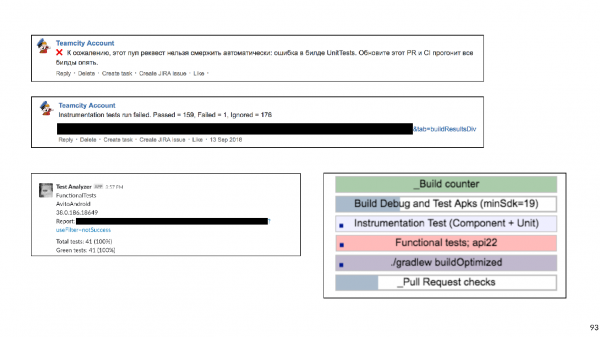
Se dedicaron seis semanas a la retroalimentación detallada.
Planes
Pasemos a la historia más reciente. Al resolver la cuestión de la retroalimentación, alcanzamos un nuevo nivel: decidimos construir nuestra propia granja de emuladores. Cuando hay muchas pruebas y emuladores, se vuelve complicado gestionarlos. Como resultado, todos nuestros emuladores se trasladaron a un clúster de k8s con gestión de recursos flexible.
Además, hay otros planes.
- Restaurar Lint (y otro análisis estático). Ya estamos trabajando en esta dirección.
- Ejecutar todas las pruebas de extremo a extremo en PR como bloqueador en todas las versiones del SDK.
Así que hemos seguido la evolución de la Integración Continua en Avito. Ahora quiero dar algunos consejos desde la perspectiva de un veterano.
Consejos
Si pudiera dar solo un consejo, sería este:
¡Por favor, tengan cuidado con los scripts de shell!
Bash es una herramienta muy flexible y poderosa, es muy conveniente y rápido escribir scripts. Pero se puede caer en una trampa, y nosotros, lamentablemente, caímos en ella.
Todo comenzó con scripts simples que se ejecutaban en nuestras máquinas de construcción:
#!/usr/bin/env bash
./gradlew assembleDebug
Pero, como es sabido, todo evoluciona y se complica con el tiempo: vamos a ejecutar un script desde otro, vamos a pasarle algunos parámetros; al final, tuve que escribir una función que determina en qué nivel de anidamiento de bash estamos, para insertar las comillas adecuadas y que todo funcione.
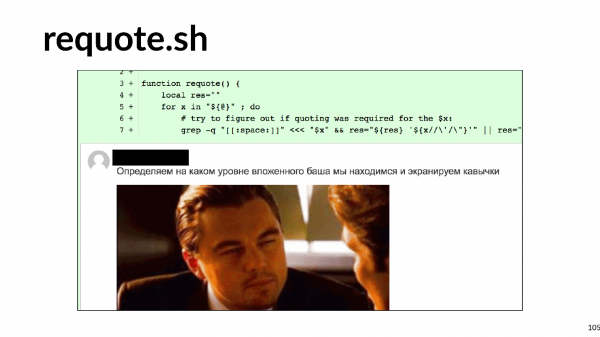
Pueden imaginarse el esfuerzo necesario para desarrollar tales scripts. Les aconsejo que no caigan en esta trampa.
¿Con qué se puede sustituir?
- Cualquier lenguaje de scripting. Es más conveniente programar en Python o Kotlin Script porque eso es programación, no script.
- O describir toda la lógica de las construcciones en forma de tareas gradle personalizadas para su proyecto.
Decidimos optar por la segunda opción y ahora estamos eliminando gradualmente todos los scripts de bash y escribiendo muchas tareas gradle personalizadas.
Consejo nº 2: mantener la infraestructura en código.
Es conveniente cuando la configuración de Continuous Integration no se almacena en la interfaz UI de Jenkins o TeamCity, etc., sino en forma de archivos de texto directamente en el repositorio del proyecto. Esto permite la versionabilidad. No será difícil revertir o compilar el código en otra rama.
Los scripts se pueden almacenar en el proyecto. ¿Y qué hacer con el entorno?
Consejo nº 3: Docker puede ayudar con el entorno.
A los desarrolladores de Android sin duda les ayudará, pero a iOS no, lamentablemente.
Este es un ejemplo de un archivo docker simple que contiene jdk y android-sdk:
FROM openjdk:8

ENV SDK_URL="https://dl.google.com/android/repository/sdk-tools-linux-3859397.zip"
    ANDROID_HOME="/usr/local/android-sdk"
    ANDROID_VERSION=26
    ANDROID_BUILD_TOOLS_VERSION=26.0.2

# Descargar Android SDK
RUN mkdir "$ANDROID_HOME" .android
    && cd "$ANDROID_HOME"
    && curl -o sdk.zip $SDK_URL
    && unzip sdk.zip
    && rm sdk.zip
    && yes | $ANDROID_HOME/tools/bin/sdkmanager --licenses

# Instalar Android Build Tool y bibliotecas
RUN $ANDROID_HOME/tools/bin/sdkmanager --update
RUN $ANDROID_HOME/tools/bin/sdkmanager "build-tools;${ANDROID_BUILD_TOOLS_VERSION}"
    "platforms;android-${ANDROID_VERSION}"
    "platform-tools"

RUN mkdir /application
WORKDIR /application
Escribí este archivo docker (te diré en secreto que no es necesario escribirlo, puedes obtener uno ya hecho de GitHub) y al construir la imagen, obtienes una máquina virtual en la que puedes compilar la aplicación y ejecutar pruebas de Junit.
Dos argumentos principales de por qué esto tiene sentido: escalabilidad y repetibilidad. Con Docker, puedes levantar rápidamente una docena de agentes de build que tendrán exactamente el mismo entorno que el anterior. Esto facilita mucho la vida a los ingenieros de CI. Incluir android-sdk en Docker es bastante simple, con los emuladores es un poco más complicado: tendrás que esforzarte un poco (bueno, o nuevamente descargar uno ya hecho de GitHub).
Consejo nº 4: no olvides que las pruebas se realizan no por el hecho de probar, sino para las personas.
Para los desarrolladores, es muy importante recibir retroalimentación rápida y, sobre todo, clara: qué se rompió, qué prueba falló, dónde ver el build log.
Consejo nº 5: sé pragmático en el desarrollo de Continuous Integration.
Ten claro qué tipos de errores deseas prevenir, cuánto estás dispuesto a gastar en recursos, tiempo y tiempo de máquina. Las pruebas demasiado largas, por ejemplo, se pueden mover a la noche. Y puedes renunciar a aquellas que detectan errores no muy importantes.
Consejo nº 6: utiliza herramientas listas.
Ahora hay muchas empresas que ofrecen CI en la nube.
Para equipos pequeños, esta es una buena salida. No se necesita mantener nada, solo pagas un poco de dinero, reúnes tu aplicación y hasta ejecutas pruebas de instrumentación.
Consejo nº 7: en un gran equipo, las soluciones internas son más rentables.
Pero tarde o temprano, con el crecimiento del equipo, las soluciones internas se volverán más rentables. Hay un punto a considerar con estas soluciones. En economía hay una ley de rendimientos decrecientes: en cualquier proyecto, cada mejora adicional se vuelve más difícil, requiere cada vez más inversiones.
La economía describe toda nuestra vida, incluida la Integración Continua. He construido un gráfico de esfuerzo en cada etapa del desarrollo de nuestra Integración Continua.
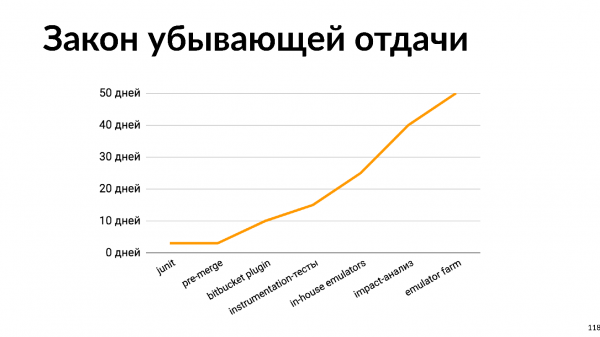
Es evidente que cada mejora se vuelve cada vez más difícil. Mirando este gráfico, se puede entender que el desarrollo de la Integración Continua debe alinearse con el crecimiento del tamaño del equipo. Para un equipo de dos personas, gastar 50 días en desarrollar una granja interna de emuladores no es una buena idea. Pero, al mismo tiempo, para un gran equipo no involucrarse en la Integración Continua tampoco es una buena idea, porque se gastará aún más tiempo en problemas de integración, reparación de comunicaciones, etc.
Comenzamos con la idea de que la automatización es necesaria, porque las personas son caras, cometen errores y son perezosas. Pero también son las personas las que automatizan. Por lo tanto, esos mismos problemas están relacionados con la automatización.
- Automatizar es caro. Recuerda el gráfico del esfuerzo.
- En la automatización, las personas cometen errores.
- A veces, da mucha pereza automatizar, porque ya funciona todo. ¿Por qué mejorar algo, por qué toda esta Integración Continua?
Pero tengo estadísticas: en el 20% de las compilaciones se detectan errores. Y esto no ocurre porque nuestros desarrolladores escriban mal el código. Sucede porque los desarrolladores están seguros de que, si cometen un error, no llegará a develop; las pruebas automatizadas lo atraparán. Por lo tanto, los desarrolladores pueden dedicar más tiempo a escribir código y a hacer cosas interesantes, en lugar de ejecutar y verificar algo localmente.
Practica la Integración Continua. Pero con moderación.
Por cierto, Nikolai Nesterov no solo hace excelentes presentaciones, sino que también forma parte del comité del programa y ayuda a otros a preparar intervenciones sustanciosas para ustedes. La plenitud y utilidad del programa de la próxima conferencia se puede evaluar por los temas en . Y para más detalles, vengan el 22-23 de abril al Espacio de Información.
Fuente: habr.com
