

En verano, tradicionalmente, disminuyen tanto la actividad de compra como la intensidad del cambio en la infraestructura de los proyectos web, nos dice el Capitán Obviedad. Simplemente porque, incluso los informáticos, a veces se van de vacaciones. Y el CTO también. Más difícil es para aquellos que permanecen en sus puestos, pero ahora no es de eso de lo que se trata: tal vez, por eso, el verano sea el mejor momento para pensar tranquilamente en el esquema de backup existente y elaborar un plan para mejorarlo. Y en esto te será útil la experiencia de Egor Andreyev de , que compartió en la conferencia .
Al construir sitios de respaldo, al realizar reservas, hay varias trampas en las que se puede caer. Y caer en ellas no es aceptable. Lo que nos destruye en todo esto, como en muchas otras cosas, es el perfeccionismo y... la pereza. Intentamos hacer todo, todo, todo de manera perfecta, ¡y no es necesario hacerlo a la perfección! Solo necesitamos hacer ciertas cosas, pero hacerlas correctamente, llevarlas hasta el final para que funcionen bien.
El failover no es algo divertido que existe 'por existir'; es algo que debe hacer una sola cosa: reducir el tiempo de inactividad, para que el servicio, la empresa, pierda menos dinero. Y en todos los métodos de reserva, propongo pensar en el siguiente contexto: ¿dónde está el dinero?
La primera trampa: cuando construimos sistemas grandes y confiables y nos encargamos de la reserva, estamos reduciendo el número de fallas. Este es un terrible engaño. Cuando nos estamos ocupando de la reserva, es probable que aumentemos el número de fallas. Y si hacemos todo bien, en conjunto, reduciremos el tiempo de inactividad. Habrá más fallas, pero ocurrirán con menores costos. ¿Qué es la reserva? — es una complicación del sistema. Cualquier complicación es mala: tenemos más tornillos, más engranajes, en resumen, más elementos — y, por lo tanto, mayor probabilidad de fallo. Y realmente se romperán. Y se romperán más a menudo. Un ejemplo simple: digamos que tenemos un sitio web, con PHP, MySQL. Y es urgentemente necesario hacer una reserva.
Bueno, tomamos el segundo sitio, construimos un sistema idéntico... La complejidad se duplica: tenemos dos entidades. Además, aplicamos cierta lógica para transferir datos de un sitio a otro, es decir, replicación de datos, copia de estática, y así sucesivamente. La lógica de replicación, como suele ser, es generalmente muy compleja, y, por lo tanto, la complejidad total del sistema puede ser no el doble, sino 3, 5, 10 veces mayor.
La segunda trampa: cuando construimos realmente grandes sistemas complejos, fantaseamos sobre lo que queremos lograr al final. Voilà: queremos crear un sistema hiperconfiable que funcione sin tiempo de inactividad, que se cambie en medio segundo (o mejor aún, instantáneamente), y empezamos a hacer realidad nuestros sueños. Pero aquí también hay un matiz: cuanto menor sea el tiempo de conmutación deseado, más compleja se convierte la lógica del sistema. Cuanto más compleja debamos hacer esta lógica, más a menudo fallará el sistema. Y podemos caer en una situación muy desagradable: nos esforzamos en reducir el tiempo de inactividad, pero en realidad estamos complicando todo, y cuando algo sale mal, el tiempo de inactividad al final será mayor. A menudo te encuentras pensando: bueno... hubiera sido mejor no tener una reserva. Mejor que funcionara uno solo con un tiempo de inactividad claro.
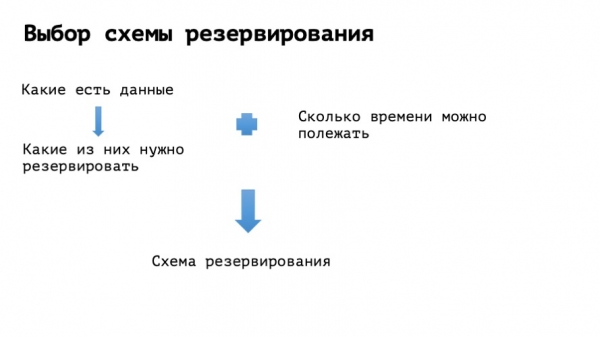
¿Cómo se puede combatir esto? Hay que dejar de engañarse a sí mismo, dejar de halagarse diciendo que ahora vamos a construir una nave espacial, y comprender adecuadamente cuánto tiempo puede estar el proyecto en espera. Con base en este tiempo máximo, elegiremos qué métodos utilizaremos para aumentar la confiabilidad de nuestro sistema.
Es hora de "historias de la vida"... de la vida, por supuesto.
Ejemplo número uno
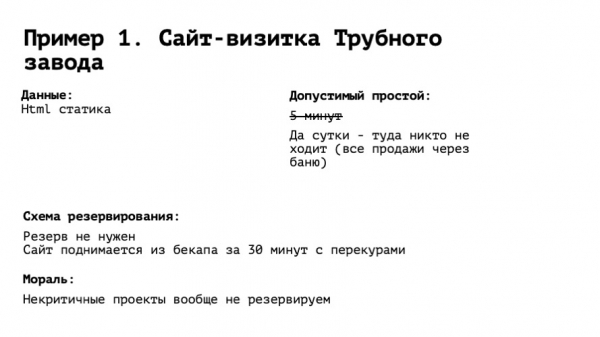
Imagina una página web de presentación de la fábrica de tubos número 1 de la ciudad de N. En ella, en letras enormes, está escrito – FABRICA DE TUBOS N° 1. Un poco más abajo, el eslogan: «Nuestros tubos son los más redondos de N». Y al final, el número de teléfono del director general y su nombre. Entendemos que es necesario reservar — ¡es una cosa muy importante! Comenzamos a explorar de qué está compuesto. Html estático — es decir, un par de imágenes donde el director, en realidad, está en la sauna con su socio discutiendo algún trato. Comenzamos a pensar en el tiempo de inactividad. Se nos ocurre: debe estar ahí cinco minutos, no más. Y aquí viene la pregunta: ¿cuántas ventas se hicieron a través de nuestro sitio? ¿Cuántas? ¿Qué significa «cero»? O, incluso, significa: porque todas las cuatro transacciones del año pasado las hizo en la misma mesa, con las mismas personas, con las que van a la sauna y se sientan a la mesa. Y entendemos que incluso si el sitio permanece inactivo un día, no pasará nada terrible.
Con base en los datos, hay un día para elevar esta historia. Comenzamos a pensar en el esquema de reserva. Y elegimos el esquema más ideal para la reserva en este caso: no usamos la reserva. Todo esto puede ser levantado por cualquier administrador en media hora, con pausas. Instalar un servidor web, colocar archivos — eso es todo. Funcionará. No hay nada de qué preocuparse, nada a lo que prestar especial atención. Es decir, la conclusión del primer ejemplo es bastante obvia: los servicios que no necesitan ser reservados — no necesitan ser reservados.
Ejemplo número dos
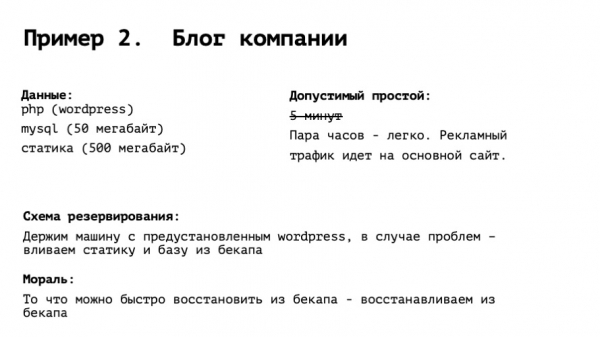
Blog de la empresa: personas especialmente capacitadas escriben allí noticias, por ejemplo, participamos en una exhibición determinada, y aquí lanzamos otro nuevo producto, y así sucesivamente. Supongamos que es un PHP estándar con WordPress, una base de datos pequeña y un poco de estática. En la mente, por supuesto, vuelve la idea de que no se puede estar caído bajo ninguna circunstancia — "¡no más de cinco minutos!", todo eso. Pero reflexionemos un poco más. ¿Qué hace este blog? La gente llega desde Yandex, desde Google con alguna búsqueda, de manera orgánica. Genial. ¿Y las ventas están de alguna manera relacionadas con esto? La revelación: no tanto. El tráfico publicitario va al sitio principal, que está en otra máquina. Empezamos a pensar en un esquema de reserva para el blog. Lo ideal sería levantarlo en un par de horas, y sería bueno prepararse para ello. Lo razonable sería obtener una máquina en otro centro de datos, instalar allí el entorno, es decir, un servidor web, PHP, WordPress, MySQL, y dejarlo en modo reposo. En el momento en que entendemos que todo ha fallado, necesitamos hacer dos cosas: restaurar el volcado de MySQL de 50 megas, que se completará en un minuto, y restaurar algunas imágenes del respaldo. Esto tampoco es un gran problema. De esta manera, en media hora, todo este asunto se levanta. Sin replicas, o Dios no lo quiera, failover automático. Conclusión: lo que podemos restaurar rápidamente desde una copia de seguridad no necesita ser reservado.
Ejemplo número tres, un poco más complicado.
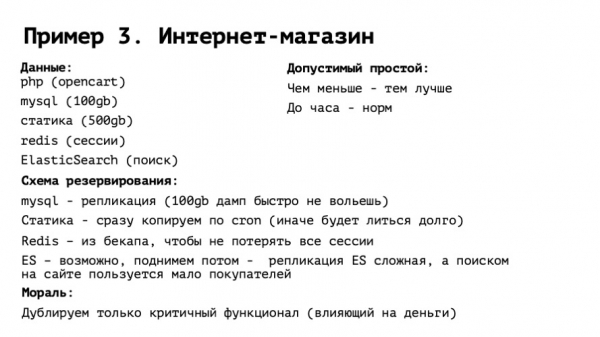
Tienda en línea. PHP con open heart ligeramente modificado, MySQL con una base sólida. Bastante estática (ya que en una tienda en línea hay bonitas imágenes en HD y todo eso), Redis para sesiones y Elasticsearch para búsqueda. Empezamos a pensar sobre el tiempo de inactividad. Y aquí, por supuesto, es obvio que un día sin problema la tienda en línea no puede estar caída. Cuanto más tiempo esté inactiva, más dinero perdemos. Es necesario acelerar el proceso. ¿Y en qué medida? Supongo que si estamos caídos una hora, nadie se volverá loco. Sí, perderemos algo, pero si comenzamos a apurarnos, solo empeorará. Determinamos el esquema de inactividad aceptable en una hora.
¿Cómo se puede reservar todo esto? En cualquier caso, se necesita una máquina: una hora es bastante poco tiempo. Mysql: aquí ya se necesita replicación, replicación en vivo, porque en una hora 100 GB de volcado probablemente no se puedan procesar. Estática, imágenes: de nuevo, en una hora 500 GB pueden no dar tiempo a transferirse. Por lo tanto, es mejor copiar las imágenes de inmediato. Redis: aquí es más interesante. En Redis se almacenan las sesiones; simplemente no podemos desecharlo. Porque eso no sería muy bueno: todos los usuarios quedarían desconectados, los carritos vacíos, etc. La gente tendría que ingresar de nuevo su identificación y contraseña, y muchas personas podrían desinteresarse y no completar la compra. Nuevamente, la conversión disminuiría. Por otro lado, Redis tal como está, con los últimos usuarios autenticados, tampoco sería necesario. Y un buen compromiso sería tomar Redis y restaurarlo desde una copia de seguridad, de ayer, o, si se hace cada hora, de hace una hora. afortunadamente, restaurarlo desde una copia de seguridad es solo copiar un archivo. Y la historia más interesante es Elasticsearch. ¿Quién ha levantado alguna vez la replicación de MySQL? ¿Quién ha levantado alguna vez la replicación de Elasticsearch? ¿Y a quién le ha funcionado bien después? A lo que me refiero: vemos en nuestro sistema alguna entidad. Parece útil, pero es complicada.
Es complicado en el sentido de que nuestros colegas ingenieros no tienen experiencia trabajando con ello. O tienen experiencia negativa. O entendemos que todavía es una tecnología bastante nueva con matices o fallas. Pensamos… Vaya, elastic también es grande, restaurarlo desde una copia de seguridad también toma tiempo, ¿qué hacemos? Entendemos que elastic se utiliza para la búsqueda en nuestro caso. ¿Y cómo vende nuestra tienda en línea? Vamos con los mercadólogos y preguntamos, de dónde vienen las personas. Ellos responden: "el 90% viene directamente de Yandex Market a la página del producto". Y compran o no compran. Por lo tanto, la búsqueda es necesaria para el 10% de los usuarios. Y mantener la replicación de elastic, especialmente entre diferentes centros de datos en diferentes zonas, tiene muchas complejidades. ¿Cuál es la salida? Tomamos elastic en un sitio de respaldo y no hacemos nada con él. Si el asunto se alarga, quizás lo levantemos más adelante, pero no es seguro. En esencia, la conclusión es más o menos la misma: los servicios que no afectan los ingresos, nuevamente, no los respaldamos. Para mantener el esquema más simple.
Ejemplo número cuatro, aún más complicado.
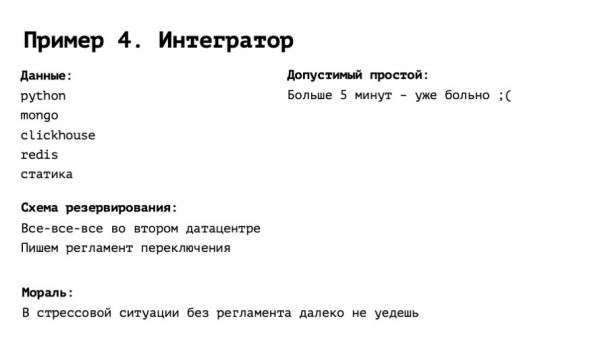
Integrador: ventas de flores, llamada de taxis, venta de productos, en general, cualquier cosa. Una cosa seria, que trabaja 24/7 para un gran número de usuarios. Con un stack interesante, donde hay bases interesantes, soluciones, alta carga, y lo más importante, no puede estar inactivo más de 5 minutos. No solo porque la gente no comprará, sino porque la gente verá que esto no funciona, se decepcionará y puede que no regresen en el futuro.
Está bien. Cinco minutos. ¿Qué vamos a hacer con esto? En este caso, de manera profesional, construimos una verdadera plataforma de respaldo con replicación de todo y quizás incluso automatizamos al máximo la conmutación a esta plataforma. Y además de eso, no hay que olvidar hacer una cosa importante: redactar un protocolo de conmutación. El protocolo, incluso si todo está automatizado, puede ser muy sencillo. Algo así como "ejecutar este escenario de ansible", "en route 53 marcar esta casilla" y así sucesivamente: pero debe ser una lista clara de acciones.
Y parece que todo está claro. Cambiar la replicación es una tarea trivial, o se cambiará automáticamente. Reescribir el nombre de dominio en DNS es de la misma serie. El problema es que cuando un proyecto como este falla, comienza la pánico, y incluso los administradores más experimentados pueden verse afectados. Sin una instrucción clara "abre la terminal, entra aquí, la dirección de nuestro servidor sigue siendo esta", es difícil cumplir con el plazo de 5 minutos asignado para la reanimación. Además, cuando usamos este reglamento, es fácil fijar algún cambio en la infraestructura, por ejemplo, — y modificar el reglamento en consecuencia.
Pero si el sistema de reserva es muy complicado y en algún momento cometimos un error, podemos comprometer nuestra plataforma de respaldo y, además, convertir los datos en calabaza en ambas plataformas — eso sería muy triste.
Ejemplo número cinco, pura adrenalina.
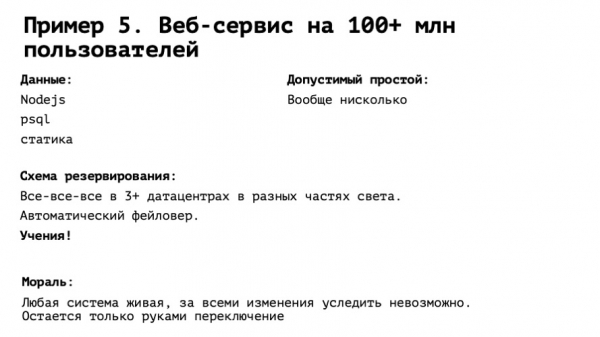
Un servicio internacional con cientos de millones de usuarios en todo el mundo. Todas las zonas horarias que existen, alta carga al máximo, no puede haber caídas de ninguna manera. Un minuto y será triste. ¿Qué hacer? Reservar, nuevamente, a lo grande. Hicimos todo lo que se mencionó en el ejemplo anterior, y un poco más. En un mundo ideal, nuestra infraestructura — es por todos los conceptos DevOps IaaC. Es decir, todo está en git, y solo tienes que presionar un botón.
¿Qué falta? Una cosa — ejercicios. Sin ellos no se puede. Parece que todo está perfecto, tenemos todo bajo control. Presionamos el botón, todo sucede. Incluso si así fuera — y entendemos que no es así — nuestro sistema interactúa con otros sistemas. Por ejemplo, con DNS de Route 53, almacenamiento S3, integración con algunas API. No podremos prever todo en este experimento teórico. Y mientras no accionemos realmente el interruptor — no sabremos si funcionará o no.
Eso es todo, probablemente. No te dejes llevar y no te excedas. ¡Y que el uptime esté contigo!
Fuente: habr.com
