

Cuando se habla de la monitorización de la seguridad de una red corporativa o gubernamental, muchos asocian esto con el control de las filtraciones de información y la implementación de soluciones DLP. Pero si intentamos precisar la pregunta y preguntar cómo detectan ataques en la red interna, la respuesta suele ser una mención a los sistemas de detección de intrusos (IDS). Lo que solía ser la única opción hace 10 o 20 años, hoy se está convirtiendo en un anacronismo. Existe una opción más eficaz, que en ciertos casos es incluso la única posible para la monitorización de la red interna: utilizar protocolos de flujo, que originalmente estaban destinados a la búsqueda de problemas de red (troubleshooting), pero que con el tiempo se han transformado en una herramienta de seguridad muy interesante. En este artículo hablaremos sobre los distintos tipos de protocolos de flujo, cuáles son los más adecuados para detectar ataques de red, dónde es mejor implementar la monitorización de flujo, en qué aspectos fijarse al desplegar este tipo de esquema, e incluso cómo se puede
No me detendré en la cuestión de “¿Por qué es necesaria la monitorización de la seguridad de la infraestructura interna?” La respuesta parece obvia. Pero si aún así quisieran asegurarse de que hoy en día esto es indispensable, un breve video que explica cómo se puede acceder a una red corporativa protegida por un cortafuegos de 17 maneras diferentes. Por lo tanto, consideremos que entendemos que la monitorización interna es necesaria y solo queda aclarar cómo se puede organizar.
Identificaría tres fuentes clave de datos para la monitorización de la infraestructura a nivel de red:
- tráfico “crudo” que capturamos y enviamos a sistemas de análisis para su evaluación,
- eventos procedentes de dispositivos de red por los que transita el tráfico,
- información sobre el tráfico obtenida a través de uno de los protocolos de flujo.
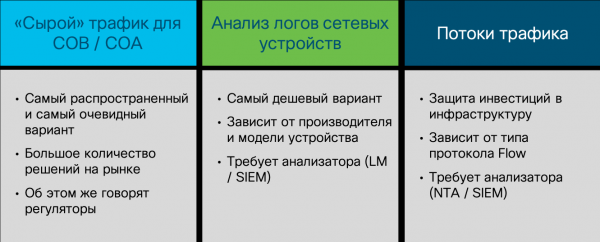
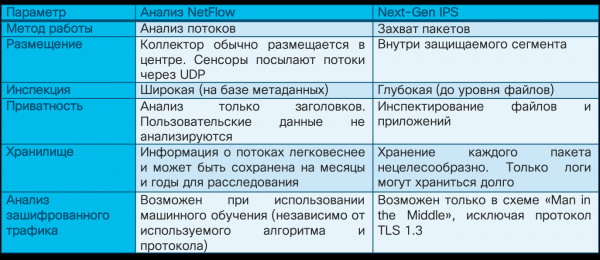
La captura de tráfico bruto es la opción más popular entre los especialistas en seguridad, ya que históricamente fue la primera en aparecer. Los sistemas de detección de intrusiones (la primera de ellas fue NetRanger de Wheel Group, adquirida por Cisco en 1998) se encargan precisamente de capturar paquetes (y más tarde sesiones) en los que se buscan ciertas firmas ("reglas decisivas" en la terminología de la FSTEK) que indican ataques. Por supuesto, el análisis de tráfico bruto se puede realizar no solo con IDS, sino también con otras herramientas (como Wireshark, tcpdump o la funcionalidad NBAR2 en Cisco IOS), pero suelen carecer de la base de conocimientos que distingue a una herramienta de seguridad de un simple recurso de TI.
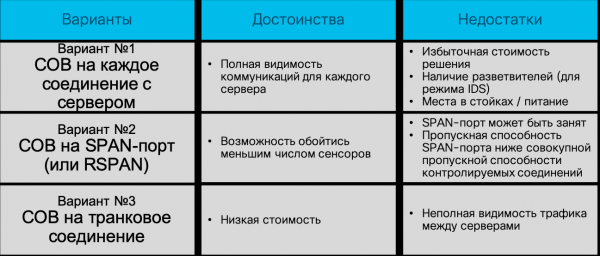
Así que, sistemas de detección de intrusiones. El método más antiguo y popular para detectar ataques de red, que se desempeña razonablemente bien en el perímetro (sin importar cuál — corporativo, centro de datos, segmento, etc.), pero que flaquea en redes modernas conmutadas y definidas por software. En el caso de una red construida con conmutadores estándar, la infraestructura de sensores de detección de ataques se vuelve demasiado grande: tendrás que instalar un sensor en cada conexión con un nodo cuyas amenazas deseas monitorear. Cualquier fabricante, por supuesto, estará encantado de venderte cientos y miles de sensores, pero creo que tu presupuesto no soportará tales gastos. Puedo decir que incluso en Cisco (donde desarrollamos NGIPS) no pudimos lograrlo, aunque, aparentemente, el precio no debería ser un obstáculo — es nuestra propia solución. Además, surge la pregunta de cómo conectar el sensor en tal caso. ¿En la interrupción? ¿Y si el propio sensor falla? ¿Exigir un módulo bypass en el sensor? ¿Usar divisores (tap)? Todo esto encarece la solución y la hace inalcanzable para empresas de cualquier tamaño.
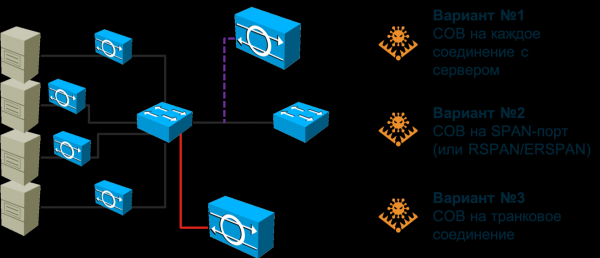
Se puede intentar "colocar" un sensor en un puerto SPAN/RSPAN/ERSPAN y dirigir el tráfico desde los puertos necesarios del conmutador hacia él. Esta opción alivia en parte el problema planteado en el párrafo anterior, pero plantea otro: el puerto SPAN no puede aceptar todo el tráfico que se le envíe, ya que no tendrá la capacidad suficiente. Habrá que sacrificar algo. O dejar algunas máquinas sin monitoreo (en cuyo caso será necesario priorizarlas previamente), o dirigir no todo el tráfico desde un nodo, sino solo cierto tipo. En cualquier caso, podemos perder algunos ataques. Además, el puerto SPAN puede estar ocupado para otros fines. Al final, tendremos que reconsiderar la topología de red existente y realizar, posiblemente, ajustes en ella para abarcar al máximo su red con el número de sensores que tiene (y coordinarlo con IT).
¿Y si su red utiliza rutas asimétricas? ¿Y si tiene implementado o está planeando implementar SDN? ¿Y si necesita monitorear máquinas virtuales o contenedores, cuyo tráfico no llega al conmutador físico? Estas preguntas no son del agrado de los fabricantes de IDS tradicionales, porque no saben cómo responderlas. Es posible que intenten persuadirlo de que todas estas tecnologías de moda son una exageración y que no las necesita. Tal vez hablen de la necesidad de empezar poco a poco. O quizás dirán que debe instalar una potente máquina en el centro de la red y redirigir todo el tráfico hacia ella mediante balanceadores. Cualquiera que sea la opción que le ofrezcan, necesita entender claramente cuán adecuada es para usted. Y solo después de eso, tomar una decisión sobre el enfoque para el monitoreo de la infraestructura de seguridad de red. Volviendo a la captura de paquetes, debo decir que este método sigue siendo muy popular e importante, pero su propósito principal es el control de fronteras: las fronteras entre su organización y la Internet, las fronteras entre el centro de datos y la red restante, las fronteras entre los sistemas de control industrial y el segmento corporativo. En estos lugares, los IDS/IPS clásicos aún tienen razón de ser y cumplen bien con las tareas asignadas.
Pasemos a la segunda opción. El análisis de eventos provenientes de dispositivos de red también puede ser utilizado para detectar ataques, aunque no como un mecanismo principal, ya que permite detectar solo un pequeño grupo de intrusiones. Además, tiene cierta reactividad: primero debe ocurrir un ataque, luego debe ser registrado por el dispositivo de red, el cual de alguna manera señalará el problema de ciberseguridad. Existen varios métodos para ello. Puede ser syslog, RMON o SNMP. Los últimos dos protocolos para monitoreo de red en el contexto de ciberseguridad se utilizan solo si necesitamos detectar un ataque DoS contra el propio equipo de red, ya que con RMON y SNMP se puede, por ejemplo, monitorear la carga del CPU del dispositivo o sus interfaces. Este es uno de los métodos más “económicos” (syslog o SNMP están disponibles para todos), pero también el menos efectivo para el monitoreo de ciberseguridad de la infraestructura interna: muchos ataques simplemente están ocultos para él. Desde luego, no se deben menospreciar, y el mismo análisis de syslog te ayuda a identificar a tiempo los cambios en la configuración del propio dispositivo, así como su compromiso, pero no es muy adecuado para detectar ataques en toda la red.
La tercera opción es el análisis de la información sobre el tráfico que pasa a través de un dispositivo que soporta uno de varios protocolos de flujo. En este caso, independientemente del protocolo, la infraestructura de trabajo con flujos consta obligatoriamente de tres componentes:
- Generación o exportación de flujo. Este papel generalmente recae en el enrutador, conmutador u otro dispositivo de red que, al permitir que el tráfico de red pase a través de él, permite extraer parámetros clave que luego se envían al módulo de recolección. Por ejemplo, en Cisco, el protocolo Netflow se soporta no solo en enrutadores y conmutadores, incluyendo virtuales e industriales, sino también en controladores inalámbricos, cortafuegos e incluso servidores.
- Recolección de flujo. Dado que en una red moderna generalmente hay más de un dispositivo de red, surge la tarea de recopilar y consolidar los flujos, que se resuelve mediante lo que se llama recolectores, que procesan los flujos recibidos y luego los envían para su análisis.
- Análisis de flujo. El analizador asume la tarea intelectual principal y, aplicando diferentes algoritmos a los flujos, llega a diversas conclusiones. Por ejemplo, en el contexto de funciones de TI, dicho analizador puede detectar cuellos de botella en la red o analizar el perfil de carga del tráfico para optimizar la red. Para la seguridad de la información, este analizador puede descubrir filtraciones de datos, la propagación de código malicioso o ataques DoS.
No hay que pensar que tal arquitectura de tres capas es demasiado compleja; todas las demás opciones (excepto, quizás, los sistemas de monitorización de red que funcionan con SNMP y RMON) también operan de acuerdo con ella. Contamos con un generador de datos para el análisis, que es un dispositivo de red o un sensor independiente. Tenemos un sistema para recopilar señales de alarma y un sistema para gestionar toda la infraestructura de monitorización. Estos dos últimos componentes pueden integrarse en un solo nodo, pero en redes medianas o grandes, normalmente se distribuyen en al menos dos dispositivos para asegurar escalabilidad y fiabilidad.
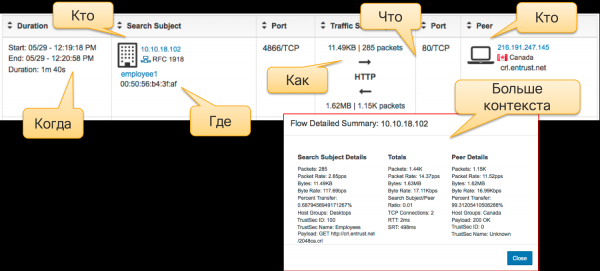
A diferencia del análisis de paquetes, que se basa en el estudio de los encabezados y el cuerpo de los datos de cada paquete y las sesiones que estos componen, el análisis de flujos se basa en la recopilación de metadatos sobre el tráfico de red. ¿Cuándo, cuánto, de dónde y hacia dónde, cómo...? Estas son las preguntas que responde el análisis de la telemetría de red mediante diversos protocolos de flujo. Inicialmente, se utilizaban para analizar estadísticas y buscar problemas de TI en la red, pero luego, a medida que los mecanismos analíticos se desarrollaron, se volvieron aplicables a la misma telemetría para fines de seguridad. Cabe señalar una vez más que el análisis de flujos no reemplaza ni anula la captura de paquetes. Cada uno de estos métodos tiene su propio ámbito de aplicación. Sin embargo, en el contexto de este artículo, el análisis de flujos es el más adecuado para monitorear la infraestructura interna. Ustedes tienen dispositivos de red (y no importa si operan bajo una paradigma definida por software o según reglas estáticas) que no pueden ser eludidos por un ataque. Un sensor IDS clásico puede ser eludido, pero un dispositivo de red que soporte el protocolo de flujo no puede. Esta es la ventaja de este método.
Por otro lado, si necesita pruebas para las fuerzas del orden o su propio grupo de investigación de incidentes, no puede prescindir de la captura de paquetes: la telemetría de red no es una copia del tráfico que se puede utilizar en la recopilación de pruebas; es necesaria para la detección operativa y la toma de decisiones en el ámbito de la seguridad de la información. Por otro lado, al utilizar el análisis de telemetría, puede "escribir" no todo el tráfico de red (si es necesario, Cisco y los centros de datos se encargan de ello :-), sino solo el que está involucrado en el ataque. Las herramientas de análisis de telemetría complementan adecuadamente los mecanismos tradicionales de captura de paquetes, dando la orden para la captura y almacenamiento selectivo. De lo contrario, tendrá que contar con una infraestructura de almacenamiento colosal.
Imaginemos una red que opera a 250 Mbit/s. Si desea almacenar todo ese volumen, necesitará un almacenamiento de 31 MB para un segundo de transmisión de tráfico, 1,8 GB para un minuto, 108 GB para una hora y 2,6 TB para un día. Para almacenar datos diarios de una red con un ancho de banda de 10 Gbit/s, necesitará un almacenamiento de 108 TB. Y algunos reguladores exigen almacenar datos de seguridad durante años... La grabación "a demanda", que el análisis de flujos le ayuda a implementar, reduce estos valores en órdenes de magnitud. Por cierto, si hablamos de la relación entre el volumen de datos grabados de la telemetría de red y la captura completa de datos, es de aproximadamente 1 a 500. Para los valores mencionados anteriormente, el almacenamiento completo de la decodificación de todo el tráfico diario sería de 5 y 216 GB, respectivamente (incluso se puede grabar en una memoria USB común).
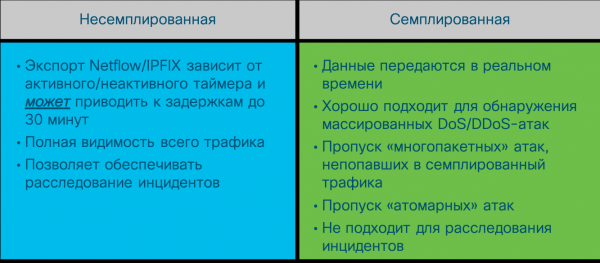
Si bien para los medios de análisis de datos de red en crudo el método de captura apenas difiere de un proveedor a otro, en el caso del análisis de flujos la situación es diferente. Existen varias versiones de protocolos de flujo, sobre cuyas diferencias es necesario conocer, especialmente en el contexto de la seguridad. El protocolo más popular es Netflow, desarrollado por Cisco. Hay varias versiones de este protocolo, que varían en sus capacidades y en la cantidad de información sobre el tráfico que registran. La versión actual es la novena (Netflow v9), sobre la cual se desarrolló el estándar industrial Netflow v10, también conocido como IPFIX. Hoy en día, la mayoría de los proveedores de redes soportan precisamente Netflow o IPFIX en su equipamiento. Sin embargo, hay varias otras versiones de protocolos de flujo: sFlow, jFlow, cFlow, rFlow, NetStream, etc., de las cuales la más popular es sFlow. Este es el que más a menudo es soportado por los fabricantes nacionales de equipos de red debido a su simplicidad de implementación. ¿Cuáles son las diferencias clave entre Netflow, que se ha convertido en un estándar de facto, y sFlow? Yo destacaría varias. Primero, Netflow tiene campos personalizables por el usuario, a diferencia de los campos fijos en sFlow. Y segundo, y esto es lo más importante en nuestro caso, sFlow recopila la llamada telemetría muestreada; a diferencia de la telemetría no muestreada de Netflow e IPFIX. ¿En qué difieren entre sí?
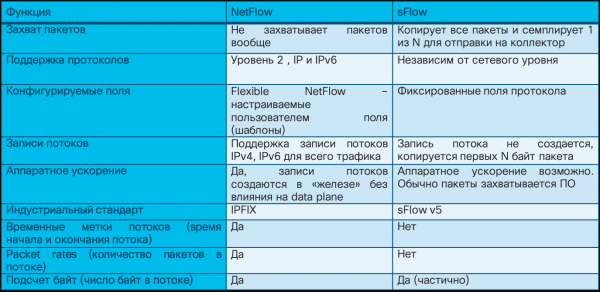
Imagina que has decidido familiarizarte con el libro “” de mis colegas — Gary McIntyre, Joseph Muniz y Nadeem AlFardan (en el enlace puedes descargar una parte del libro). Tienes tres opciones para alcanzar el objetivo: leer el libro completo, hojearlo, deteniéndote en cada décima o vigésima página, o intentar encontrar un resumen de los conceptos clave en algún blog o servicio tipo SmartReading. Así que la telemetría no muestreada es como leer cada “página” del tráfico de red, es decir, analizar los metadatos de cada paquete. La telemetría muestreada es el estudio selectivo del tráfico con la esperanza de que en las muestras elegidas se encuentre lo que necesitas. Dependiendo de la velocidad del canal, la telemetría muestreada devolverá para análisis cada 64, 200, 500, 1000, 2000 o incluso cada 10000 paquetes.
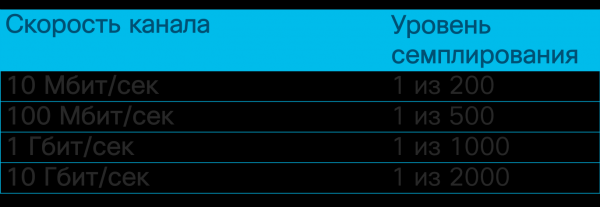
En el contexto de la monitorización de la ciberseguridad, esto significa que la telemetría muestreada es adecuada para detectar ataques DDoS, escaneos y propagación de malware, pero puede pasar por alto ataques atómicos o multi-paquete que no se incluyan en la muestra enviada para análisis. La telemetría no muestreada no tiene estas limitaciones, lo que amplía significativamente el espectro de ataques detectables. Aquí hay una pequeña lista de eventos que se pueden detectar mediante herramientas de análisis de telemetría de red.
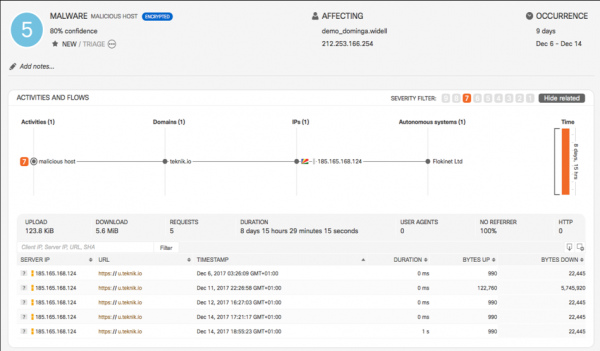
Por supuesto, algún analizador de Netflow de código abierto no le permitirá esto, ya que su principal tarea es recopilar la telemetría y realizar un análisis básico desde el punto de vista de TI. Para identificar amenazas de ciberseguridad basadas en flujos, es necesario equipar al analizador con diversos motores y algoritmos que detecten problemas de ciberseguridad basándose en campos estándar o personalizados de Netflow, enriqueciendo los datos estándar con información externa de varias fuentes de Threat Intelligence, etc.
Por lo tanto, si tiene una opción, elija Netflow o IPFIX. Pero incluso si su equipo solo funciona con sFlow, como ocurre con algunos fabricantes nacionales, aún puede beneficiarse de ello en el contexto de la seguridad.
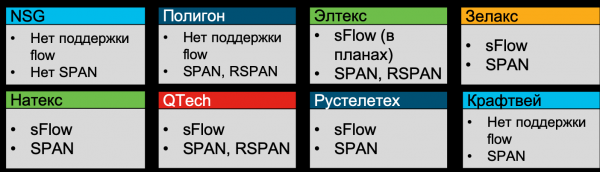
En el verano de 2019, realicé un análisis de las capacidades disponibles de los fabricantes rusos de hardware de red, y todos ellos, excepto NSG, Polígono y Kraftway, afirmaron soportar sFlow (al menos, Zelax, Natex, Eltex, QTech, Rusteletech).
La siguiente pregunta que se planteará es: ¿dónde implementar el soporte para flow con fines de seguridad? En realidad, la pregunta no está formulada del todo correctamente. En el equipo moderno, el soporte para protocolos flow está casi siempre presente. Por lo tanto, reformularía la pregunta de otra manera: ¿dónde es más efectivo recoger telemetría desde el punto de vista de la seguridad? La respuesta será bastante obvia: a nivel de acceso, donde verá el 100% del tráfico, donde tendrá información detallada sobre los hosts (MAC, VLAN, ID de interfaz), donde podrá rastrear incluso el tráfico P2P entre hosts, lo que es crítico para detectar escaneos y la propagación de código malicioso. A nivel de núcleo, puede que no vea parte del tráfico, y a nivel de perímetro verá, a lo sumo, una cuarta parte de todo su tráfico de red. Pero si, por alguna razón, hay dispositivos ajenos en su red que permiten a los atacantes “entrar y salir”, el análisis de la telemetría desde allí no le servirá de nada. Por eso, para una cobertura máxima, se recomienda habilitar la recolección de telemetría precisamente a nivel de acceso. Cabe señalar que incluso si hablamos de virtualización o contenedores, en los conmutadores virtuales modernos también suele haber soporte para flow, lo que permite controlar el tráfico allí.
Pero ya que he mencionado el tema, es necesario responder a la pregunta: ¿qué pasa si, de hecho, el hardware, físico o virtual, no soporta protocolos flow? ¿O su activación está prohibida (por ejemplo, en segmentos industriales para garantizar la fiabilidad)? ¿O su activación provoca una alta carga en el procesador central (lo cual sucede en equipos obsoletos)? Para resolver este problema, existen sensores virtuales especializados (flow sensor), que en esencia son simples divisores que permiten pasar tráfico a través de ellos y lo retransmiten en forma de flow a un módulo de recolección. Sin embargo, en este caso, nos enfrentamos a todo un cúmulo de problemas que mencionamos anteriormente en relación con los medios de captura de paquetes. Es decir, hay que entender no solo las ventajas de la tecnología de análisis de flujos, sino también sus limitaciones.
Otro aspecto importante a tener en cuenta al hablar sobre las herramientas de análisis de flujos. Si para las herramientas convencionales de generación de eventos de seguridad aplicamos la métrica EPS (eventos por segundo), para el análisis de telemetría este indicador no es aplicable; se reemplaza por FPS (flujos por segundo). Al igual que con EPS, no se puede calcular de antemano, pero se puede estimar el número aproximado de flujos que genera un dispositivo según su tarea. En Internet, puedes encontrar tablas con valores aproximados para diferentes tipos de dispositivos corporativos que te permitirán calcular qué licencias necesitas para las herramientas de análisis y cuál será su arquitectura. La cuestión es que el sensor IDS tiene un ancho de banda limitado que puede 'soportar', y el colector de flujos también tiene sus restricciones que hay que entender. Por lo tanto, en redes grandes y distribuidas geográficamente, suele haber múltiples colectores. Cuando describí, , ya mencioné el número de nuestros colectores: son 21. Y eso para una red dispersa por cinco continentes y que cuenta con alrededor de medio millón de dispositivos activos).
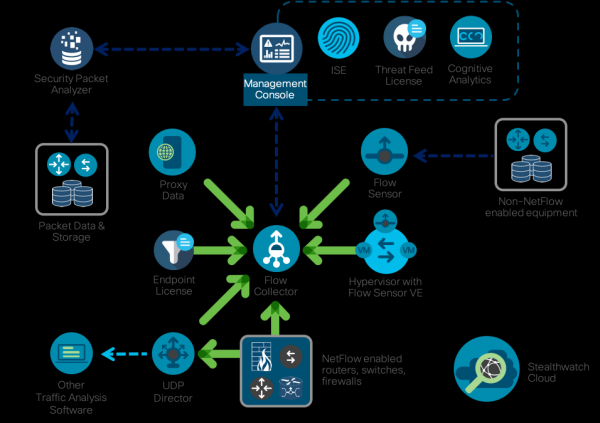
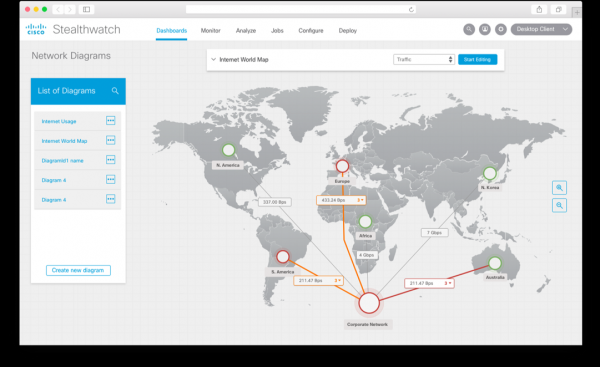
Como sistema de monitoreo de Netflow, utilizamos nuestra propia solución , que está especialmente orientado a resolver problemas de seguridad. Tiene muchos motores integrados para detectar actividades anómalas, sospechosas y claramente malignas, lo que permite identificar una amplia gama de amenazas diferentes, desde minería de criptomonedas hasta filtraciones de información, desde la distribución de malware hasta el fraude. Al igual que la mayoría de los analizadores de flujos, Stealthwatch se basa en un esquema de tres niveles (generador - colector - analizador), pero se complementa con una serie de características interesantes que son importantes en el contexto del material tratado. Primero, se integra con soluciones de captura de paquetes (por ejemplo, Cisco Security Packet Analyzer), lo que permite grabar sesiones de red seleccionadas para una posterior investigación y análisis en profundidad. En segundo lugar, especialmente para ampliar las capacidades de seguridad, hemos desarrollado un protocolo especial, nvzFlow, que permite
Es evidente que, al hablar sobre sistemas de análisis de Netflow desde la perspectiva de la seguridad, el mercado no se limita a una única solución de Cisco. Puedes utilizar tanto soluciones comerciales como gratuitas o de pago condicional. Es un tanto extraño que en el blog de Cisco dé ejemplos de soluciones de competidores, así que comentaré un par de palabras sobre cómo puede analizarse la telemetría de red con dos herramientas populares, que tienen nombres similares pero son, no obstante, diferentes: SiLK y ELK.
SiLK es un conjunto de herramientas (el Sistema para el Conocimiento a Nivel de Internet) para el análisis de tráfico, desarrollado por el CERT/CC estadounidense. En el contexto del artículo de hoy, soporta Netflow (versiones 5 y 9, las más populares), IPFIX y sFlow, y mediante diversas utilidades (rwfilter, rwcount, rwflowpack, entre otras) lleva a cabo diversas operaciones sobre la telemetría de red para detectar signos de acciones no autorizadas. Sin embargo, hay un par de puntos importantes a señalar. SiLK es una herramienta de línea de comandos, y realizar un análisis operativo siempre requiere introducir comandos como (detección de paquetes ICMP de más de 200 bytes):
rwfilter --flowtypes=all/all --proto=1 --bytes-per-packet=200- --pass=stdout | rwrwcut --fields=sIP,dIP,iType,iCode --num-recs=15
no es muy conveniente. Puede utilizar la interfaz gráfica iSiLK, pero esta no facilitará mucho su vida, ya que solo cumple con la función de visualización y no sustituye al analista. Y este es el segundo punto. A diferencia de las soluciones comerciales, que ya tienen una sólida base analítica, algoritmos de detección de anomalías, flujos de trabajo, etc., en el caso de SiLK, usted deberá realizar todo eso por su cuenta, lo que requerirá de competencias diferentes a las de usar un conjunto de herramientas ya listo para funcionar. Esto no es ni bueno ni malo, es una característica de prácticamente cualquier herramienta gratuita, que asume que usted sabe qué hacer, y solo le ayuda en eso (los conjuntos de herramientas comerciales son menos dependientes de las competencias de sus usuarios, aunque también suponen que los analistas entienden al menos las bases de las investigaciones y el monitoreo de redes). Pero volvamos a SiLK. El ciclo de trabajo de un analista con esta herramienta es el siguiente:
- Formulación de una hipótesis. Debemos entender qué buscaremos dentro de la telemetría de red, conocer los atributos únicos que utilizaremos para identificar ciertas anomalías o amenazas.
- Construcción de un modelo. Una vez formulada la hipótesis, la programamos con Python, shell u otras herramientas que no están incluidas en SiLK.
- Pruebas. Es el momento de verificar la validez de nuestra hipótesis, que se confirma o refuta usando las utilidades de SiLK, comenzando con 'rw', 'set', 'bag'.
- Análisis de datos reales. En la operación industrial, SiLK nos ayuda a identificar ciertos elementos y el analista debe responder a las preguntas: «¿Encontramos lo que esperábamos?», «¿Se ajusta esto a nuestra hipótesis?», «¿Cómo reducir el número de falsos positivos?», «¿Cómo mejorar la tasa de reconocimiento?» y así sucesivamente.
- Mejora. En la etapa final, mejoramos lo realizado anteriormente: creamos plantillas, mejoramos y optimizamos el código, reformulamos y aclaramos la hipótesis, entre otros.
Este ciclo también se aplicará a Cisco Stealthwatch, solo que este último automatiza los cinco pasos al máximo, reduciendo los errores del analista y aumentando la rapidez en la detección de incidentes. Por ejemplo, en SiLK puedes enriquecer las estadísticas de red con datos externos sobre IP maliciosas mediante scripts escritos por ti, mientras que en Cisco Stealthwatch, esta es una función integrada que te muestra inmediatamente una alerta si hay interacción en el tráfico de red con direcciones IP de la lista negra.
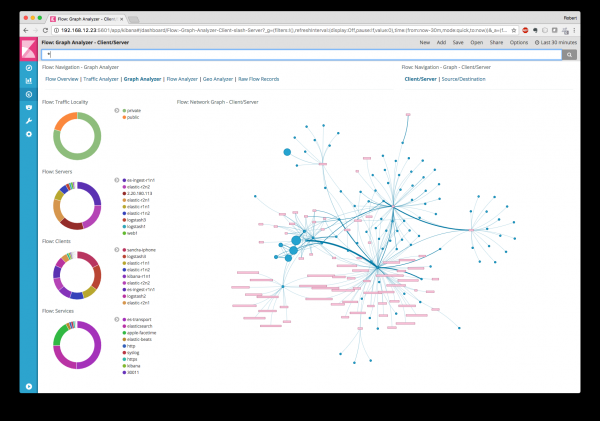
Si se sube en la pirámide de "costo" del software de análisis de flujo, el SiLK gratuito se complementa con el ELK, que es condicionalmente gratuito y consta de tres componentes clave: Elasticsearch (indexación, búsqueda y análisis de datos), Logstash (entrada/salida de datos) y Kibana (visualización). A diferencia de SiLK, donde debes escribir todo tú mismo, ELK ya tiene muchas bibliotecas/módulos listos (algunos de pago, otros no) que automatizan el análisis de telemetría de red. Por ejemplo, el filtro GeoIP en Logstash permite vincular direcciones IP observadas a su ubicación geográfica (esa función está integrada en Stealthwatch).
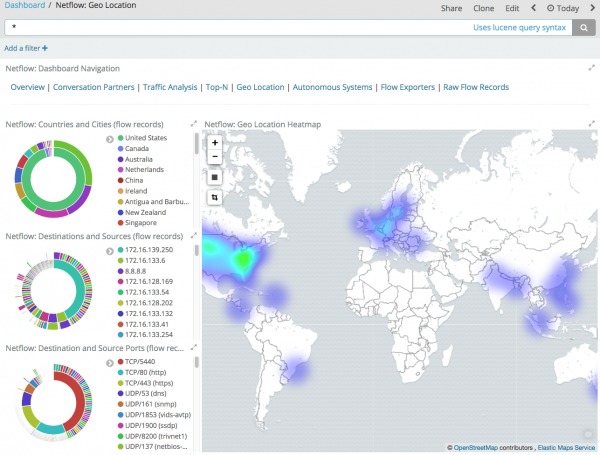
ELK también tiene una comunidad bastante amplia que desarrolla componentes faltantes para esta solución de monitoreo. Por ejemplo, para trabajar con Netflow, IPFIX y sFlow, puedes utilizar el módulo , si no te satisface el Módulo de Netflow de Logstash, que solo admite Netflow.
Dando más rapidez en la recopilación y búsqueda de flujo, ELK actualmente carece de rica analítica integrada para la detección de anomalías y amenazas en la telemetría de red. Es decir, siguiendo el ciclo de vida descrito anteriormente, tendrás que describir por ti mismo los modelos de violaciones y luego utilizarlos en el sistema operativo (no hay modelos integrados).
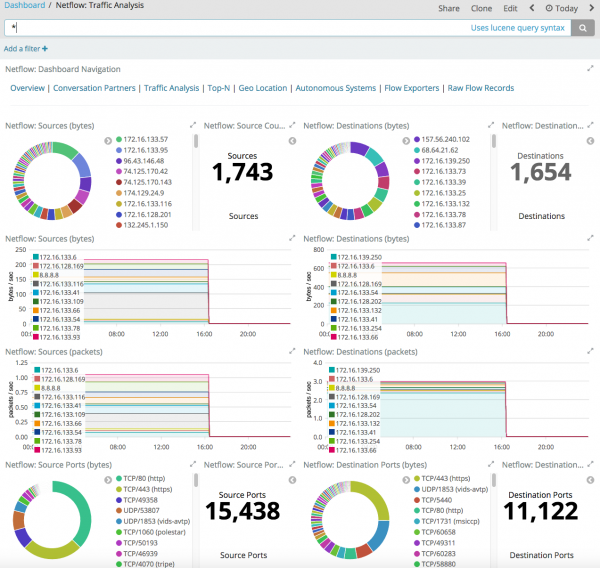
Existen, por supuesto, extensiones más sofisticadas para ELK, que ya incluyen algunos modelos de detección de anomalías en la telemetría de red, pero tales extensiones tienen un costo y aquí ya surge la pregunta de si realmente vale la pena: ¿es mejor crear un modelo similar por cuenta propia, comprar su implementación para su herramienta de monitoreo o adquirir una solución lista de la clase de Análisis de Tráfico de Red?
Realmente no quiero entrar en la polémica sobre si es mejor gastar dinero y comprar una solución lista para la monitorización de anomalías y amenazas en la telemetría de red (por ejemplo, Cisco Stealthwatch) o resolverlo por uno mismo y ajustar tools como SiLK, ELK o nfdump u OSU Flow Tools (me refiero a los últimos dos de ellos). Cada quien elige según sus propias motivaciones y hay razones válidas para optar por cualquiera de las dos opciones. Solo quería mostrar que la telemetría de red es una herramienta muy importante para garantizar la seguridad de la infraestructura interna y no debe ser descuidada, para no unirse a la lista de empresas cuyo nombre aparece en los medios junto con epítetos como "hackeada", "que no cumplía con los requisitos de seguridad de la información", "que no se preocupa por la seguridad de sus datos y los de sus clientes".
Para resumir, me gustaría enumerar algunos consejos clave a seguir al establecer la monitorización de la seguridad de la información en su infraestructura interna:
- ¡No se limite solo al perímetro! Utilice (y elija) la infraestructura de red no solo para transmitir tráfico de un punto A a un punto B, sino también para abordar cuestiones de ciberseguridad.
- Estudie los mecanismos existentes de monitorización de seguridad de la información en su equipo de red y utilícelos.
- Para la monitorización interna, prefiera el análisis de telemetría: este método permite detectar hasta el 80-90% de todos los incidentes de seguridad de la información, haciendo lo que no es posible con la captura de paquetes de red y ahorrando espacio para almacenar todos los eventos de seguridad de la información.
- Para la monitorización de flujos, utilice Netflow v9 o IPFIX: proporcionan más información en el contexto de seguridad y permiten monitorizar no solo IPv4, sino también IPv6, MPLS, etc.
- Utilice un protocolo de flujo no muestreado, ya que brinda más información para la detección de amenazas. Por ejemplo, Netflow o IPFIX.
- Verifique la carga de su equipo de red; podría no ser capaz de manejar también el protocolo flow. Entonces, considere el uso de sensores virtuales o un Netflow Generation Appliance.
- Implemente el control principalmente a nivel de acceso; esto le dará la capacidad de ver el 100% de todo el tráfico.
- Si no tiene opciones y utiliza equipos de red rusos, elija aquellos que soporten protocolos flow o que tengan puertos SPAN/RSPAN.
- Combine sistemas de detección/preventivos de intrusiones ataques en los bordes y sistemas de análisis de flujo en la red interna (incluyendo en la nube).
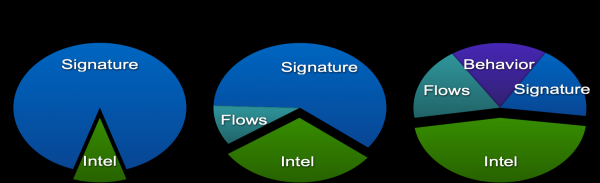
En cuanto al último consejo, me gustaría presentar una ilustración que ya he mencionado anteriormente. Pueden ver que si antes el servicio de seguridad Cisco construía casi todo su sistema de monitoreo de seguridad basado en sistemas de detección de intrusiones y métodos de firmas, ahora solo representa el 20% de los incidentes. Otro 20% corresponde a sistemas de análisis de flujo, lo que indica que estas soluciones no son un capricho, sino una herramienta real en la actividad de los servicios de seguridad de las empresas modernas. Además, contar con su infraestructura de red para implementarlas es lo más importante, ya que puede proteger su inversión al incluir también funciones de monitoreo de seguridad en la red.
No he abordado el tema de la respuesta ante anomalías o amenazas detectadas en los flujos de red, pero creo que está claro que el monitoreo no debe finalizar solo con la detección de amenazas. Debe seguir una respuesta, preferiblemente en modo automático o automatizado. Pero ese es un tema para otra discusión.
Información adicional:
PD: Si le resulta más fácil captar lo que se ha escrito arriba a escuchar, puede ver una presentación de una hora que sirvió de base para esta nota.

Fuente: habr.com
