

En la actualidad, es imposible imaginar un proyecto basado en Kubernetes sin la pila ELK, que permite almacenar los registros tanto de las aplicaciones como de los componentes del sistema del clúster. En nuestra práctica, utilizamos la pila EFK con Fluentd en lugar de Logstash.
Fluentd es un recolector de registros universal moderno que está ganando cada vez más popularidad y se ha unido a la Cloud Native Computing Foundation, lo que orienta su desarrollo hacia su uso junto con Kubernetes.
El hecho de usar Fluentd en lugar de Logstash no cambia la esencia del sistema de software, sin embargo, Fluentd tiene sus propias particularidades derivadas de su multifuncionalidad.
Por ejemplo, al comenzar a usar EFK en un proyecto con alta carga y una intensidad de escritura de registros elevada, nos enfrentamos al problema de que algunos mensajes aparecen varias veces en Kibana. En este artículo, explicaremos por qué ocurre este fenómeno y cómo solucionar el problema.
El problema de la duplicación de documentos
En nuestros proyectos, Fluentd se despliega como DaemonSet (se inicia automáticamente en una instancia en cada nodo del clúster Kubernetes) y monitorea los registros stdout de los contenedores en /var/log/containers. Después de recopilar y procesar, los registros en forma de documentos JSON se envían a ElasticSearch, implementado en modo clúster o standalone, dependiendo de la escala del proyecto y los requisitos de rendimiento y tolerancia a fallos. Se utiliza Kibana como interfaz gráfica.
Al usar Fluentd con un complemento de almacenamiento en búfer, nos encontramos con la situación en la que algunos documentos en ElasticSearch tienen contenido idéntico y solo difieren en el identificador. Se puede verificar que se trata de un mensaje repetido con el ejemplo del registro de Nginx. En el archivo de registro, este mensaje existe en una única instancia:
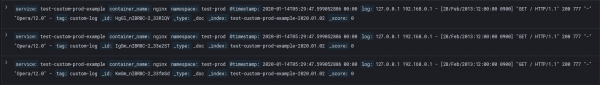
127.0.0.1 192.168.0.1 - [28/Feb/2013:12:00:00 +0900] "GET / HTTP/1.1" 200 777 "-" "Opera/12.0" -Sin embargo, en ElasticSearch existen varios documentos que contienen este mensaje:
{
  "_index": "test-custom-prod-example-2020.01.02",
  "_type": "_doc",
  "_id": "HgGl_nIBR8C-2_33RlQV",
  "_version": 1,
  "_score": 0,
  "_source": {
    "service": "test-custom-prod-example",
    "container_name": "nginx",
    "namespace": "test-prod",
    "@timestamp": "2020-01-14T05:29:47.599052886 00:00",
    "log": "127.0.0.1 192.168.0.1 - [28\/Feb\/2013:12:00:00  0900] "GET \/ HTTP\/1.1" 200 777 "-" "Opera\/12.0" -",
    "tag": "custom-log"
  }
}

{
  "_index": "test-custom-prod-example-2020.01.02",
  "_type": "_doc",
  "_id": "IgGm_nIBR8C-2_33e2ST",
  "_version": 1,
  "_score": 0,
  "_source": {
    "service": "test-custom-prod-example",
    "container_name": "nginx",
    "namespace": "test-prod",
    "@timestamp": "2020-01-14T05:29:47.599052886 00:00",
    "log": "127.0.0.1 192.168.0.1 - [28\/Feb\/2013:12:00:00  0900] "GET \/ HTTP\/1.1" 200 777 "-" "Opera\/12.0" -",
    "tag": "custom-log"
  }
}
Sin embargo, puede haber más de dos repeticiones.
Al registrar este problema, se pueden observar numerosos avisos en los registros de Fluentd con el siguiente contenido:
2020-01-16 01:46:46 +0000 [warn]: [test-prod] falló al vaciar el búfer. retry_time=4 next_retry_seconds=2020-01-16 01:46:53 +0000 chunk="59c37fc3fb320608692c352802b973ce" error_class=Fluent::Plugin::ElasticsearchOutput::RecoverableRequestFailure error="no se pudieron enviar los registros al clúster de Elasticsearch ({:host=>"elasticsearch", :port=>9200, :scheme=>"http", :user=>"elastic", :password=>"obfuscated"}): se alcanzó el tiempo de espera de lectura"Estas advertencias surgen cuando ElasticSearch no puede devolver una respuesta a la solicitud dentro del tiempo establecido por el parámetro request_timeout, lo que impide que el fragmento del búfer se limpie. Después de eso, Fluentd intenta enviar el fragmento del búfer a ElasticSearch nuevamente y, tras un número arbitrario de intentos, la operación se completa con éxito:
2020-01-16 01:47:05 +0000 [warn]: [test-prod] reintento exitoso. chunk_id="59c37fc3fb320608692c352802b973ce"
2020-01-16 01:47:05 +0000 [warn]: [test-prod] reintento exitoso. chunk_id="59c37fad241ab300518b936e27200747"
2020-01-16 01:47:05 +0000 [warn]: [test-dev] reintento exitoso. chunk_id="59c37fc11f7ab707ca5de72a88321cc2"
2020-01-16 01:47:05 +0000 [warn]: [test-dev] reintento exitoso. chunk_id="59c37fb5adb70c06e649d8c108318c9b"
2020-01-16 01:47:15 +0000 [warn]: [kube-system] reintento exitoso. chunk_id="59c37f63a9046e6dff7e9987729be66f"
Sin embargo, ElasticSearch trata cada uno de los fragmentos del búfer reenviados como únicos y les asigna valores únicos para los campos _id durante la indexación. Así es como aparecen las copias de los mensajes.
En Kibana, esto se ve así:
Solucionar el problema
Existen varias opciones para resolver este problema. Una de ellas es el mecanismo de generación de un hash único para cada documento, integrado en el complemento fluent-plugin-elasticsearch. Si se utiliza este mecanismo, ElasticSearch reconocerá las repeticiones en la etapa de envío y evitará la duplicación de documentos. Sin embargo, no se puede ignorar que este método solo aborda la consecuencia y no resuelve el error relacionado con la falta de un tiempo de espera, por lo que decidimos no utilizarlo.
Utilizamos un complemento de almacenamiento en búfer en la salida de Fluentd para evitar la pérdida de registros en caso de problemas temporales con la red o un aumento en la intensidad de escritura de registros. Si por alguna razón ElasticSearch no puede escribir un documento en el índice de inmediato, el documento entra en una cola que se almacena en el disco. Por lo tanto, en nuestro caso, para eliminar la fuente del problema que conduce al error mencionado anteriormente, es necesario establecer valores correctos para los parámetros de almacenamiento en búfer, donde el búfer de salida de Fluentd sea de suficiente tamaño y se borre a tiempo.
Cabe destacar que los valores de los parámetros, de los que se hablará a continuación, son individuales en cada caso específico de uso del almacenamiento en búfer en los complementos de salida, ya que dependen de múltiples factores: la intensidad de la escritura de mensajes de registro de los servicios, el rendimiento del sistema de disco, la carga de la red y su capacidad de ancho de banda. Por lo tanto, para obtener configuraciones adecuadas para cada caso particular, pero no excesivas, evitando un extenso proceso de prueba ciega, se puede utilizar la información de depuración que Fluentd escribe en su registro durante el funcionamiento y obtener rápidamente valores correctos.
En el momento de la captura del problema, la configuración era la siguiente:
 @type file
        path /var/log/fluentd-buffers/kubernetes.test.buffer
        flush_mode interval
        retry_type exponential_backoff
        flush_thread_count 2
        flush_interval 5s
        retry_forever
        retry_max_interval 30
        chunk_limit_size 8M
        queue_limit_length 8
        overflow_action block
En el proceso de resolver el problema, se seleccionaron manualmente los valores de los siguientes parámetros:
chunk_limit_size — el tamaño de los chunks en los que se dividen los mensajes en el búfer.
- flush_interval — el intervalo de tiempo después del cual se limpia el búfer.
- queue_limit_length — la cantidad máxima de chunks en la cola.
- request_timeout — el tiempo que se establece para la conexión entre Fluentd y ElasticSearch.
El tamaño total del búfer se puede calcular multiplicando los parámetros queue_limit_length y chunk_limit_size, lo que se puede interpretar como «la cantidad máxima de chunks en la cola, cada uno de los cuales tiene un tamaño determinado». Si el tamaño del búfer es insuficiente, aparecerá la siguiente advertencia en los logs:
2020-01-21 10:22:57 +0000 [warn]: [test-prod] falló al escribir datos en el búfer por acción de desbordamiento del búfer=:blockEsto significa que el búfer no se limpia a tiempo y los datos que llegan al búfer lleno son bloqueados, lo que resultará en la pérdida de parte de los logs.
Se puede aumentar el búfer de dos maneras: aumentando el tamaño de cada chunk en la cola, o aumentando la cantidad de chunks que pueden estar en la cola.
Si el tamaño del chunk chunk_limit_size se establece en más de 32 megabytes, ElasticSearch no lo aceptará, ya que el paquete entrante será demasiado grande. Por lo tanto, si es necesario aumentar el búfer adicionalmente, es mejor aumentar la longitud máxima de la cola queue_limit_length.
Cuando el búfer deja de desbordarse y solo queda el mensaje sobre insuficiencia del timeout, se puede proceder a aumentar el parámetro request_timeout. Sin embargo, al establecer un valor superior a 20 segundos, comenzarán a aparecer las siguientes advertencias en los logs de Fluentd:
2020-01-21 09:55:33 +0000 [warn]: [test-dev] el vaciado del búfer tomó más tiempo que slow_flush_log_threshold: elapsed_time=20.85753920301795 slow_flush_log_threshold=20.0 plugin_id="postgresql-dev" Este mensaje no afecta el funcionamiento del sistema y significa que el tiempo de limpieza del búfer tomó más tiempo del que se establece en el parámetro slow_flush_log_threshold. Esta es información de depuración y la utilizamos al ajustar el valor del parámetro request_timeout.
El algoritmo general de ajuste se ve de la siguiente manera:
- Establecer el valor de request_timeout garantizadamente mayor de lo necesario (cientos de segundos). Durante el ajuste, el principal criterio de correctitud para este parámetro será la desaparición de las advertencias sobre insuficiencia del timeout.
- Esperar mensajes sobre el incumplimiento del umbral slow_flush_log_threshold. En el texto de la advertencia, el campo elapsed_time indicará el tiempo real de limpieza del búfer.
- Establecer el valor de request_timeout mayor que el tiempo máximo elapsed_time obtenido durante el período de observación. Calculamos el valor de request_timeout como elapsed_time + 50%.
- Para eliminar las advertencias sobre la larga limpieza del búfer del registro, se puede aumentar el valor de slow_flush_log_threshold. Calculamos este valor como elapsed_time + 25%.
Los valores finales de estos parámetros, como se mencionó anteriormente, son individuales para cada caso. Siguiendo el algoritmo mencionado anteriormente, garantizamos la eliminación del error que provoca la repetición de mensajes.
La tabla a continuación muestra cómo cambia la cantidad de errores por día que conducen a la duplicación de mensajes, durante el ajuste de los valores de los parámetros descritos anteriormente:
node-1
node-2
node-3
node-4
Antes/Después
Antes/Después
Antes/Después
Antes/Después
no se pudo vaciar el búfer
1749/2
694/2
47/0
1121/2
reintento exitoso
410/2
205/1
24/0
241/2
Cabe señalar que la configuración obtenida puede perder su relevancia con el crecimiento del proyecto y, en consecuencia, el aumento en la cantidad de registros. Un signo primario de la falta de un tiempo de espera establecido es el retorno en el registro de Fluentd de mensajes sobre la larga limpieza del búfer, es decir, el umbral del slow_flush_log_threshold excedido. Desde este momento hay un pequeño margen antes de exceder el parámetro request_timeout, por lo que es necesario reaccionar a estos mensajes de manera oportuna y volver a realizar el proceso de ajuste de configuraciones óptimas descrito anteriormente.
Conclusión
La optimización del búfer de salida de Fluentd es uno de los principales pasos en la configuración de la pila EFK, que determina la estabilidad de su funcionamiento y la correcta colocación de documentos en los índices. Siguiendo el algoritmo de configuración descrito, se puede estar seguro de que todos los registros se escribirán en el índice de ElasticSearch en el orden correcto, sin repeticiones ni pérdidas.
También lee otros artículos en nuestro blog:
Fuente: habr.com
