

Comando ofrece del ingeniero Rahul Bhatia de Clairvoyant sobre los formatos de archivo en big data, las funciones más comunes de los formatos de Hadoop y cuál formato es el mejor para usar.
¿Por qué son necesarios diferentes formatos de archivos?
Un punto crítico en el rendimiento de las aplicaciones que soportan HDFS, como MapReduce y Spark, es el tiempo de búsqueda, lectura y escritura de datos. Estos problemas se agravan por las dificultades en la gestión de grandes conjuntos de datos, especialmente si no tenemos un esquema fijo, sino uno en evolución, o si hay ciertas limitaciones de almacenamiento.
El procesamiento de big data aumenta la carga en el subsistema de almacenamiento: Hadoop almacena datos de manera redundante para lograr resistencia a fallos. Además de los discos, también se sobrecargan el procesador, la red, el sistema de entrada/salida, etc. A medida que aumenta el volumen de datos, también lo hacen los costos de su procesamiento y almacenamiento.
Los diferentes formatos de archivo en han sido diseñados precisamente para abordar estos problemas. Elegir el formato de archivo adecuado puede proporcionar importantes beneficios:
- Tiempo de lectura más rápido.
- Tiempo de escritura más rápido.
- Archivos compartibles.
- Soporte para la evolución de esquemas.
- Soporte avanzado para compresión.
Algunos formatos de archivo están diseñados para uso general, otros para variantes más específicas, y algunos han sido desarrollados teniendo en cuenta características de datos concretas. Así que la elección es realmente bastante amplia.
El formato de archivo Avro
Para de serialización de datos es ampliamente utilizado; Avro es un formato de almacenamiento de datos basado en filas, lo que significa que es de tipo fila, en Hadoop. Almacena el esquema en formato JSON, facilitando su lectura e interpretación por cualquier programa. Los propios datos se encuentran en un formato binario, de manera compacta y eficiente.
El sistema de serialización Avro es neutral en cuanto a lenguajes. Los archivos pueden ser procesados por diferentes lenguajes, actualmente son C, C++, C#, Java, Python y Ruby.
Una característica clave de Avro es su sólida compatibilidad con esquemas de datos que cambian con el tiempo, es decir, que evolucionan. Avro entiende los cambios en el esquema: eliminación, adición o modificación de campos.
Avro soporta una variedad de estructuras de datos. Por ejemplo, se puede crear un registro que contenga un array, un tipo enumerado y un subregistro.
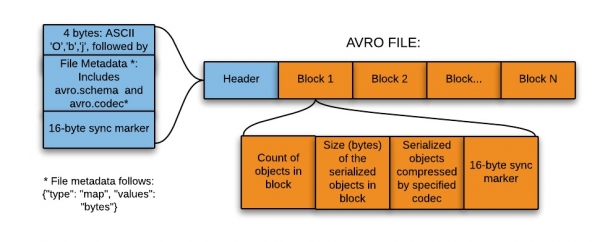
Este formato es ideal para la escritura en la zona de aterrizaje (transitoria) de un lago de datos (, o data lake — una colección de instancias para almacenar varios tipos de datos, además de las fuentes de datos directamente.
Así que, para escribir en la zona de aterrizaje del lago de datos, este formato es el más adecuado por las siguientes razones:
- Los datos de esta zona generalmente se leen en su totalidad para un procesamiento posterior por parte de sistemas inferiores, y el formato basado en filas es más eficiente en este caso.
- Los sistemas inferiores pueden extraer fácilmente tablas de esquemas de los archivos; no es necesario almacenar los esquemas por separado en un almacenamiento de metadatos externo.
- Cualquier cambio en el esquema original se maneja fácilmente (evolución del esquema).
Formato de archivos Parquet
Parquet es un formato de archivo de código abierto para Hadoop que almacena estructuras de datos anidadas en un formato de columnas plano.
En comparación con el enfoque tradicional en filas, Parquet es más eficiente en términos de almacenamiento y rendimiento.
Esto es especialmente útil para consultas que leen ciertas columnas de una tabla amplia (con muchas columnas). Con el formato de archivos, solo se leen las columnas necesarias, minimizando así la entrada/salida.
Pequeña aclaración: para comprender mejor el formato de archivo Parquet en Hadoop, veamos qué es un formato basado en columnas, es decir, formato columnar. En este formato, se almacenan juntos los valores del mismo tipo de cada columna.
, la entrada incluye los campos ID, Name y Department. En este caso, todos los valores de la columna ID se almacenarán juntos, al igual que los valores de la columna Name y así sucesivamente. La tabla tendrá un aspecto similar al siguiente:
ID
Nombre
Departamento
1
emp1
d1
2
emp2
d2
3
emp3
d3
En formato de filas, los datos se guardarán de la siguiente manera:
1
emp1
d1
2
emp2
d2
3
emp3
d3
En el formato de columnas, los mismos datos se guardarán así:
1
2
3
emp1
emp2
emp3
d1
d2
d3
El formato columnar es más eficiente cuando necesitas consultar varias columnas de una tabla. Solo lee las columnas necesarias, ya que están juntas. Así, las operaciones de entrada/salida se minimizan.
Por ejemplo, solo necesitas la columna NAME. En cada registro en el conjunto de datos necesita ser cargado, desglosado por campos y luego extraer los datos NAME. El formato columnar permite acceder directamente a la columna Name, ya que todos los valores para esa columna se almacenan juntos. No es necesario escanear todo el registro.
De este modo, el formato de columnas aumenta el rendimiento de las consultas, ya que se necesita menos tiempo de búsqueda para acceder a las columnas requeridas y se reduce la cantidad de operaciones de entrada/salida, dado que se leen solo las columnas necesarias.
Una de las características únicas es que en este formato puede almacenar datos con estructuras anidadas. Esto significa que en el archivo Parquet incluso se pueden leer por separado los campos anidados sin necesidad de leer todos los campos de la estructura anidada. Para almacenar estructuras anidadas, Parquet utiliza el algoritmo de fragmentación y ensamblaje (shredding and assembly).
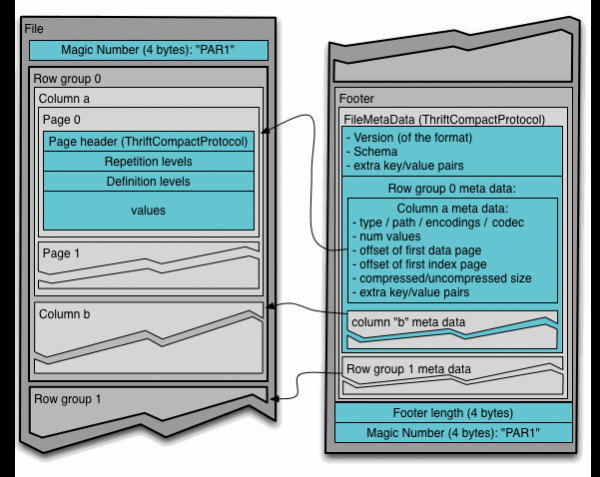
Para entender el formato de archivo Parquet en Hadoop, es necesario conocer los siguientes términos:
- Grupo de filas (row group): división lógica horizontal de los datos en filas. Un grupo de filas consiste en un fragmento de cada columna en el conjunto de datos.
- Fragmento de columna (column chunk): fragmento específico de una columna. Estos fragmentos de columnas residen en un grupo de filas determinado y estarán garantizados como contiguos en el archivo.
- Página (page): los fragmentos de columnas se dividen en páginas, escritas secuencialmente. Las páginas tienen un encabezado común, por lo que se pueden omitir las innecesarias al leer.
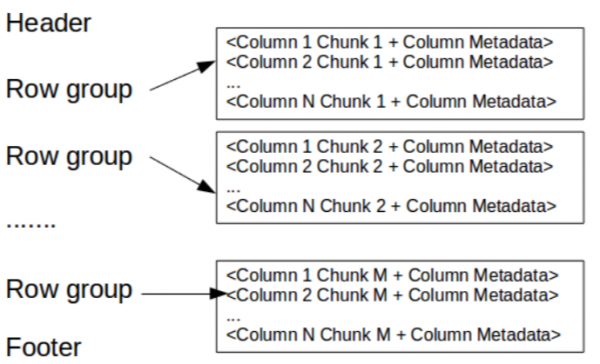
Aquí el encabezado simplemente contiene un número mágico PAR1 (4 bytes), que identifica el archivo como un archivo del formato Parquet.
En el pie de página se registra lo siguiente:
- Metadatos del archivo, que contienen las coordenadas iniciales de los metadatos de cada columna. Al leer, primero se deben leer los metadatos del archivo para encontrar todos los fragmentos de columnas de interés. Luego, los fragmentos de columnas deben ser leídos secuencialmente. Además, los metadatos incluyen la versión del formato, el esquema y cualquier par clave-valor adicional.
- Longitud de los metadatos (4 bytes).
- Número mágico PAR1 (4 bytes).
El formato de archivos ORC
es un formato de archivo optimizado por filas y columnas (Optimized Row Columnar, ) ofrece una forma muy eficiente de almacenar datos y fue desarrollado para superar las limitaciones de otros formatos. Almacena datos en una forma perfectamente compacta, permitiendo omitir detalles innecesarios, sin la necesidad de construir índices grandes, complejos o mantenidos manualmente.
Ventajas del formato ORC:
- Un archivo de salida por cada tarea, lo que reduce la carga en el NameNode.
- Soporte para tipos de datos de Hive, incluyendo DateTime, tipos decimales y tipos complejos (struct, list, map y union).
- Lectura simultánea del mismo archivo por diferentes procesos de RecordReader.
- Capacidad de dividir archivos sin escanear en busca de marcadores.
- Estimación de la máxima asignación de memoria heap para procesos de lectura/escritura según la información en el pie de página del archivo.
- Los metadatos se almacenan en un formato binario de serialización de Protocol Buffers, que permite agregar y eliminar campos.
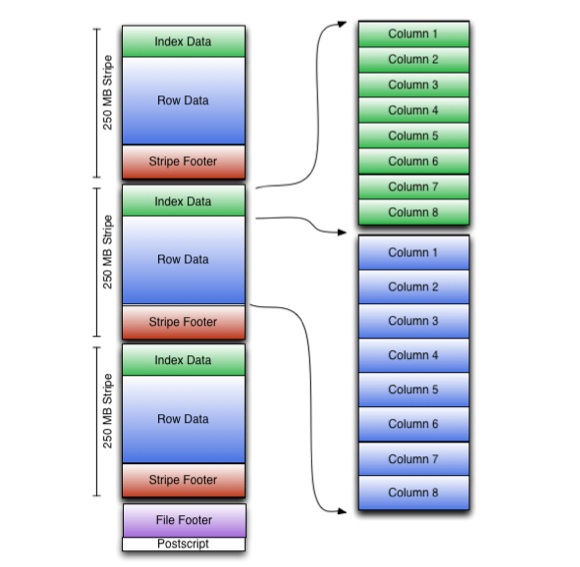
ORC almacena colecciones de filas en un solo archivo, y dentro de la colección, los datos de fila se almacenan en formato columnar.
Un archivo ORC almacena grupos de filas, conocidos como stripes, y la información auxiliar en el pie de página del archivo. El postscript al final del archivo contiene parámetros de compresión y el tamaño del pie de página comprimido.
Por defecto, el tamaño de una stripe es de 250 MB. Gracias a stripes de este gran tamaño, la lectura desde HDFS se realiza de manera más eficiente: en grandes bloques continuos.
El pie de página del archivo registra una lista de stripes en el archivo, el número de filas por stripe y el tipo de datos de cada columna. También se registra el valor resultante de count, min, max y sum por cada columna.
El pie de página de la stripe contiene un catálogo de ubicaciones de flujo.
Los datos de fila se utilizan al escanear tablas.
Los datos de índice incluyen valores mínimos y máximos para cada columna y la posición de las filas en cada columna. Los índices ORC solo se utilizan para seleccionar stripes y grupos de filas, no para responder consultas.
Comparación de diferentes formatos de archivo.
Avro frente a Parquet.
- Avro es un formato de almacenamiento por filas, mientras que Parquet almacena datos por columnas.
- Parquet es más adecuado para consultas analíticas, es decir, las operaciones de lectura y consulta de datos son mucho más eficientes que las de escritura.
- Las operaciones de escritura en Avro se realizan de manera más eficiente que en Parquet.
- Avro maneja la evolución de esquemas de forma más madura. Parquet solo admite la adición de esquemas, mientras que Avro implementa una evolución multifuncional, es decir, la adición o modificación de columnas.
- Parquet es ideal para consultar subconjuntos de columnas en una tabla de múltiples columnas. Avro es adecuado para operaciones ETL, donde consultamos todas las columnas.
ORC frente a Parquet.
- Parquet almacena mejor los datos anidados.
- ORC está mejor adaptado para el empuje de predicados (predicate pushdown).
- ORC admite propiedades ACID.
- ORC comprime mejor los datos.
Lecturas adicionales sobre el tema:
- .
- .
- .
Fuente: habr.com
