

Hola, lectores de Habr. Con este artículo comenzamos un ciclo que hablará sobre nuestro sistema hiperconvergente AERODISK vAIR. Inicialmente queríamos presentar todo sobre todo en el primer artículo, pero el sistema es bastante complejo, así que vamos a comer el elefante por partes.
Comenzaremos la historia de la creación del sistema, profundizaremos en el sistema de archivos ARDFS, que es la base de vAIR, y también reflexionaremos un poco sobre el posicionamiento de esta solución en el mercado ruso.
En futuros artículos, hablaremos con más detalle sobre los diferentes componentes arquitectónicos (clúster, hipervisor, balanceador de carga, sistema de monitoreo, etc.), el proceso de configuración, abordaremos cuestiones de licenciamiento, mostraremos pruebas de estrés y, por supuesto, escribiremos sobre pruebas de carga y dimensionamiento. También dedicaremos un artículo aparte a la versión community de vAIR.
¿Aerodisk es una historia sobre almacenamiento? ¿O por qué comenzamos a trabajar en hiperconvergencia?
La idea de crear nuestro propio hiperconvergente nos llegó alrededor de 2010. En aquel entonces, no existía ni Aerodisk, ni soluciones similares (sistemas hiperconvergentes comerciales) en el mercado. Nuestro objetivo era el siguiente: a partir de un conjunto de servidores con discos locales, interconectados por protocolo Ethernet, crear un almacenamiento distribuido y ejecutar máquinas virtuales y una red de software ahí mismo. Todo esto tenía que implementarse sin almacenamiento (porque simplemente no teníamos dinero para almacenamiento y su infraestructura, y en ese momento aún no habíamos inventado nuestro propio almacenamiento).
Probamos muchas soluciones de código abierto y, al final, resolvimos esta tarea, pero la solución resultó ser muy complicada y difícil de reproducir. Además, esta solución era del tipo '¿Funciona? ¡No lo toques!'. Por lo tanto, al resolver esa tarea, no continuamos desarrollando la idea de convertir el resultado de nuestro trabajo en un producto completo.
Después de ese evento, nos alejamos de esa idea, pero aún nos quedaba la sensación de que esta tarea era completamente resolvible y que los beneficios de tal solución eran más que evidentes. En el futuro, los productos HCI lanzados por empresas extranjeras solo confirmaron esta sensación.
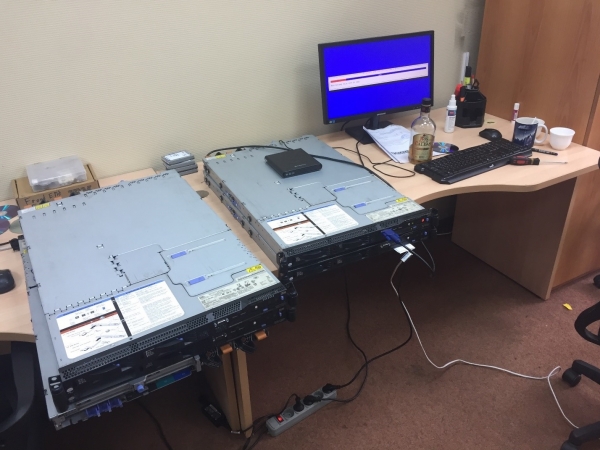
Por lo tanto, a mediados de 2016, volvimos a esta tarea ya en el contexto de la creación de un producto completo. En ese momento, aún no teníamos relaciones con inversores, por lo que tuvimos que comprar el stand de desarrollo con nuestro propio dinero, que no era mucho. Comprando servidores y conmutadores de segunda mano en Avito, comenzamos con el trabajo.
La tarea inicial principal era crear nuestro propio sistema de archivos, aunque simple, pero propio, que pudiera distribuir automáticamente y de manera uniforme los datos en forma de bloques virtuales en un número n de nodos de un clúster, que estaban conectados por interconectores a través de Ethernet. Al mismo tiempo, el sistema de archivos debía escalar bien y fácilmente, y ser independiente de los sistemas adyacentes, es decir, ser separable de vAIR como 'simple almacenamiento'.
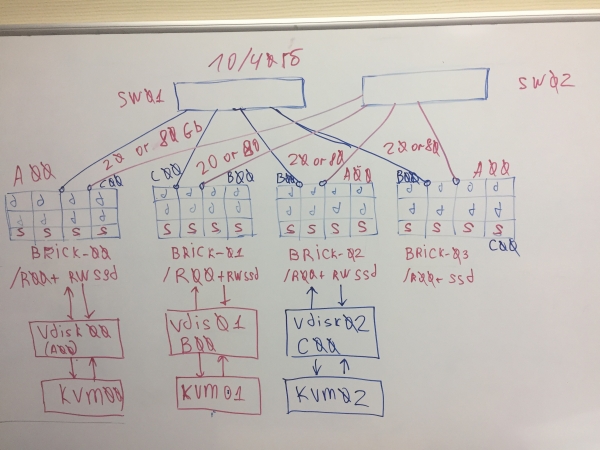
El primer concepto de vAIR
Decidimos no usar soluciones open source listas para la organización de un almacenamiento distribuido (ceph, gluster, lustre y similares) en favor de nuestro propio desarrollo, ya que ya teníamos mucha experiencia de proyecto con ellos. Sin duda, estas soluciones son excelentes por sí solas, y hasta antes de trabajar en Aerodisco habíamos realizado más de un proyecto de integración con ellas. Pero una cosa es realizar una tarea específica para un cliente, formar al personal y, posiblemente, comprar soporte de un gran vendedor, y otra muy diferente es crear un producto que sea fácil de reproducir, que se utilice para diferentes tareas, de las que, como proveedor, posiblemente ni siquiera tengamos conocimiento. Para este segundo objetivo, los productos open source existentes no eran adecuados, por lo que decidimos desarrollar nuestro propio sistema de archivos distribuido.
Dos años después, gracias a varios desarrolladores (que combinaban su trabajo en vAIR con el trabajo en una matriz de disco clásica Engine), se logró un resultado determinado.
Para 2018, habíamos escrito un sistema de archivos muy simple y lo habíamos complementado con el cableado necesario. El sistema unía, a través de un interconector interno, discos físicos (locales) de diferentes servidores en un único conjunto plano y 'cortaba' estos discos en bloques virtuales; luego se creaban dispositivos de bloques a partir de los bloques virtuales con un cierto grado de tolerancia a fallos, en los que, utilizando el hipervisor KVM, se creaban y ejecutaban máquinas virtuales.
No hemos complicado mucho con el nombre del sistema de archivos y lo hemos llamado ARDFS (traten de adivinar qué significa))
Este prototipo se veía bien (no visualmente, por supuesto, en ese momento no había diseño visual) y mostraba buenos resultados en cuanto a rendimiento y escalabilidad. Tras el primer resultado real, avanzamos con el proyecto, organizando un entorno de desarrollo completo y un equipo separado que se dedicaba exclusivamente a vAIR.
Justo en ese momento, se maduró la arquitectura global de la solución, que hasta ahora no ha sufrido cambios significativos.
Sumergiéndonos en el sistema de archivos ARDFS
ARDFS es la base de vAIR, que proporciona almacenamiento de datos distribuido y tolerante a fallos para todo el clúster. Una de las (aunque no la única) características distintivas de ARDFS es que no utiliza ninguna servidores dedicados subestructura ni gestión. Así se concibió desde el principio para simplificar la configuración de la solución y para su fiabilidad.
Estructura de almacenamiento
Dentro de todos los nodos del clúster, ARDFS organiza un grupo lógico de todo el espacio en disco disponible. Es importante entender que el grupo no son datos ni espacio formateado, sino simplemente un diseño, es decir, cualquier nodo con vAIR instalado que se añada al clúster se agrega automáticamente al grupo común de ARDFS y los recursos de disco se vuelven automáticamente comunes para todo el clúster (y disponibles para el futuro almacenamiento de datos). Este enfoque permite agregar y eliminar nodos sobre la marcha sin ningún impacto serio en el sistema ya en funcionamiento. Es decir, el sistema se puede escalar muy fácilmente en "ladrillos", agregando o eliminando nodos del clúster según sea necesario.
Sobre el grupo de ARDFS se añaden discos virtuales (objetos de almacenamiento para máquinas virtuales), que se construyen a partir de bloques virtuales de 4 megabytes. En los discos virtuales se almacenan directamente los datos. A nivel de discos virtuales también se establece un esquema de tolerancia a fallos.
Como se podría adivinar, para la tolerancia a fallos del subsistema de discos no utilizamos la concepción de RAID (Conjunto redundante de discos independientes), sino que empleamos RAIN (Conjunto redundante de nodos independientes). Es decir, la tolerancia a fallos se mide, automatiza y gestiona en función de los nodos y no de los discos. Los discos, por supuesto, también son un objeto de almacenamiento, son monitoreados como cualquier otra cosa y se pueden realizar todas las operaciones estándar con ellos, incluyendo la creación de un RAID de hardware local, pero el clúster opera precisamente con nodos.
En una situación en la que se desea RAID (por ejemplo, un escenario que admite múltiples fallos en clústeres pequeños), nada impide utilizar controladores RAID locales y, sobre ellos, crear un almacenamiento extendido y una arquitectura RAIN. Este escenario es completamente viable y lo respaldamos, por lo que lo abordaremos en un artículo sobre escenarios típicos de aplicación de vAIR.
Esquemas de tolerancia a fallos del almacenamiento
Existen dos esquemas de tolerancia a fallos de los discos virtuales en vAIR:
1) Factor de replicación o simplemente replicación: este método de tolerancia a fallos es tan simple como una vara y una cuerda. Se realiza una replicación sincronizada entre nodos con un factor de 2 (2 copias en el clúster) o 3 (3 copias, respectivamente). RF-2 permite que el disco virtual soporte la falla de un nodo en el clúster, pero 'consume' la mitad del volumen útil, mientras que RF-3 soportará la falla de 2 nodos en el clúster, pero ya reservará 2/3 del volumen útil para sus necesidades. Este esquema se asemeja mucho a RAID-1, es decir, un disco virtual configurado en RF-2 es resistente a la falla de cualquier nodo en el clúster. En este caso, los datos estarán en buen estado y, de hecho, la entrada/salida no se detendrá. Cuando el nodo caído vuelva a estar operativo, comenzará la recuperación/sincronización automática de los datos.
A continuación se presentan ejemplos de la distribución de datos RF-2 y RF-3 en modo operativo y en situaciones de fallos.
Tenemos una máquina virtual con 8MB de datos únicos (útiles) que opera en 4 nodos vAIR. Es evidente que en la realidad es poco probable que haya un volumen tan bajo, pero para un esquema que refleja la lógica de funcionamiento de ARDFS, este ejemplo es el más claro. AB son bloques virtuales de 4MB que contienen datos únicos de la máquina virtual. En RF-2 se crean dos copias de estos bloques A1+A2 y B1+B2, respectivamente. Estos bloques se 'distribuyen' entre nodos, evitando la superposición de los mismos datos en un solo nodo, es decir, la copia A1 no estará en el mismo nodo que la copia A2. Lo mismo ocurre con B1 y B2.
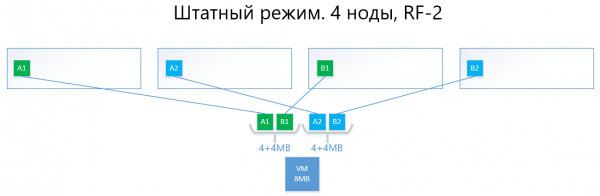
En caso de fallo de uno de los nodos (por ejemplo, el nodo nº 3, donde se encuentra la copia B1), esta copia se activará automáticamente en el nodo donde no haya copia de su copia (es decir, la copia B2).
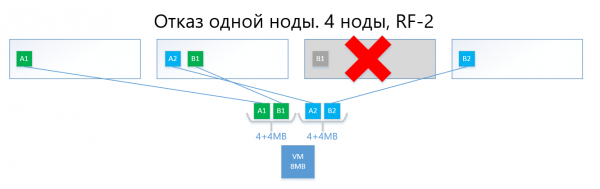
Así, el disco virtual (y la VM, respectivamente) sobrevivirán fácilmente al fallo de un nodo en el esquema RF-2.
El esquema de replicación, a pesar de su simplicidad y fiabilidad, sufre del mismo problema que RAID1: poco espacio útil.
2) Codificación de borrado o erasure coding (también conocido como 'código redundante' o 'código de paridad') existe para resolver el problema anterior. EC es un esquema de redundancia que proporciona alta disponibilidad de datos con menores costos de espacio en disco en comparación con la replicación. El principio de funcionamiento de este mecanismo es similar al RAID 5, 6, 6P.
En el proceso de codificación, el proceso EC divide un bloque virtual (por defecto 4MB) en varios 'pedazos de datos' más pequeños dependiendo del esquema de EC (por ejemplo, el esquema 2+1 divide cada bloque de 4MB en 2 pedazos de 2MB). A continuación, este proceso genera para los 'pedazos de datos' 'pedazos de paridad' que no superen a una de las partes previamente divididas. Durante la decodificación, EC genera los pedazos faltantes leyendo los 'datos sobrevivientes' en todo el clúster.
Por ejemplo, un disco virtual con un esquema EC 2+1, implementado en 4 nodos del clúster, soportará tranquilamente la falla de un nodo en el clúster al igual que RF-2. Además, los costos de operación serán menores, especificando que el coeficiente de capacidad útil en RF-2 es 2, mientras que en EC 2+1 será 1.5.
Si lo describimos de manera más simple, la esencia es que el bloque virtual se divide en 2-8 (por qué de 2 a 8 se explicará más adelante) 'trozos', y para estos trozos se calculan 'trozos' de paridad de volumen equivalente.
En resumen, los datos y la paridad se distribuyen uniformemente entre todos los nodos del clúster. Al igual que en la replicación, ARDFS distribuye automáticamente los datos entre los nodos de tal manera que se evite almacenar los mismos datos (copias de los datos y su paridad) en un solo nodo, para excluir la posibilidad de perder datos debido a que tanto los datos como su paridad se encuentren de repente en un solo nodo de almacenamiento que se descomponga.
A continuación, un ejemplo con la misma máquina virtual de 8 MB y 4 nodos, pero ya con el esquema EC 2+1.
Los bloques A y B se dividen en dos partes de 2 MB cada uno (en dos porque 2+1), es decir, en A1+A2 y B1+B2. A diferencia de la réplica, A1 no es una copia de A2, es un bloque virtual A, dividido en dos partes, lo mismo ocurre con el bloque B. Por lo tanto, obtenemos dos conjuntos de 4MB, cada uno conteniendo dos partes de dos megabytes. Luego, para cada uno de estos conjuntos se calcula la paridad, que no excede un fragmento (es decir, 2 MB), obteniendo adicionalmente + 2 fragmentos de paridad (A-P y B-P). En total, tenemos 4×2 datos + 2×2 paridad.
Luego, las partes se "distribuyen" entre los nodos de tal manera que los datos no se crucen con su paridad. Es decir, A1 y A2 no estarán en el mismo nodo que A-P.
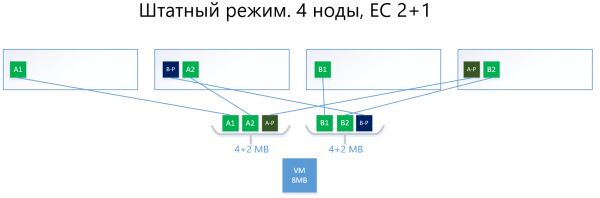
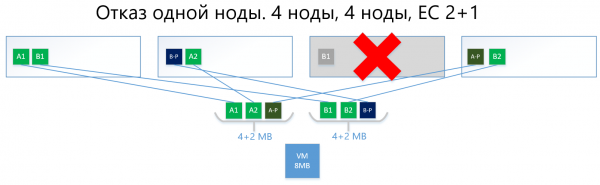
En caso de falla de un nodo (supongamos, el tercero), el bloque caído B1 se restaurará automáticamente de la paridad B-P, que se almacena en el nodo №2, y se activará en el nodo donde no hay paridad B, es decir, el fragmento B-P. En este ejemplo, este es el nodo №1.
Estoy seguro de que surge la pregunta en el lector:
«Todo lo que has descrito ya ha sido implementado tanto por competidores como en soluciones de código abierto, ¿cuál es la diferencia de tu implementación de EC en ARDFS?»
A continuación, se presentarán características interesantes del funcionamiento de ARDFS.
Codificación de borrado con énfasis en la flexibilidad.
Inicialmente, hemos previsto un esquema de EC X+Y bastante flexible, donde X es un número de 2 a 8, y Y es un número de 1 a 8, pero siempre menor o igual que X. Este esquema está diseñado para flexibilidad. Aumentar el número de fragmentos de datos (X) en los que se divide un bloque virtual permite reducir los costos generales, es decir, aumentar el espacio útil.
Sin embargo, aumentar el número de fragmentos de paridad (Y) incrementa la fiabilidad del disco virtual. Cuanto mayor sea el valor de Y, más nodos en el clúster pueden fallar. Por supuesto, aumentar el volumen de paridad reduce el volumen de capacidad útil, pero esto es el precio a pagar por la fiabilidad.
La dependencia del rendimiento respecto a los esquemas EC es casi directa: cuanto más "fragmentos", menor es el rendimiento; aquí, es evidente que se necesita una visión equilibrada.
Este enfoque permite a los administradores configurar de forma flexible el almacenamiento distribuido. En el marco del pool ARDFS, se pueden utilizar cualquier combinación de esquemas de tolerancia a fallos, lo cual también nos parece muy útil.
A continuación se presenta una tabla comparativa de varios (no todos los posibles) esquemas RF y EC.
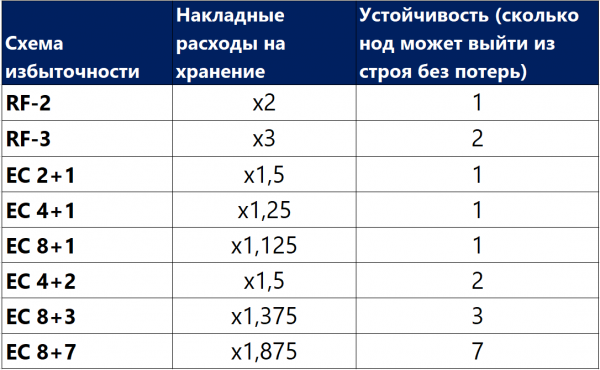
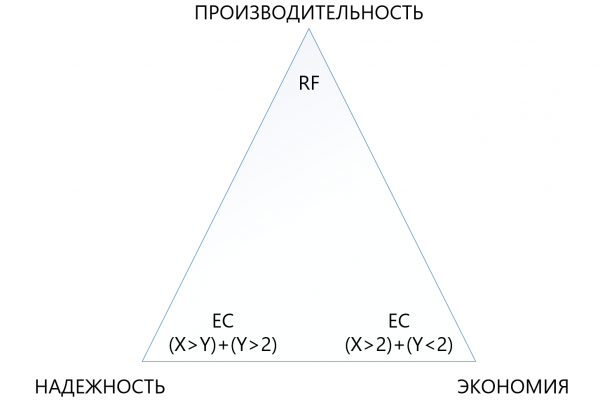
De la tabla se observa que incluso la combinación más "extrema" EC 8+7, que permite la pérdida simultánea de hasta 7 nodos en el clúster, consume menos espacio útil (1,875 frente a 2) que la replicación estándar, mientras que ofrece una protección 7 veces superior, lo que hace que este mecanismo de protección, aunque más complejo, sea significativamente más atractivo en situaciones donde se requiere la máxima fiabilidad en condiciones de escasez de espacio en disco. Hay que entender que cada "más" a X o Y implica un costo adicional en rendimiento, por lo que en el triángulo entre fiabilidad, ahorro y rendimiento, hay que elegir con mucho cuidado. Por esta razón, dedicaremos un artículo separado al dimensionamiento del codificador remoto.
Fiabilidad y autonomía del sistema de archivos
ARDFS se ejecuta localmente en todos los nodos del clúster y sincroniza mediante sus propios medios a través de interfaces Ethernet dedicadas. Un punto importante es que ARDFS sincroniza no solo los datos, sino también los metadatos relacionados con el almacenamiento. Durante el desarrollo de ARDFS, también estudiamos una serie de soluciones existentes y descubrimos que muchos realizan la sincronización de los metadatos del sistema de archivos utilizando una base de datos distribuida externa, que también utilizamos para la sincronización, pero solo de configuraciones y no de metadatos del sistema de archivos (sobre esto y otros subsistemas relacionados hablaremos en el próximo artículo).
La sincronización de los metadatos del FS mediante una base de datos externa es, por supuesto, una solución viable, pero entonces la consistencia de los datos almacenados en ARDFS dependería de la base de datos externa y su comportamiento (y, para ser sinceros, es un cliente caprichoso), lo cual, desde nuestro punto de vista, es malo. ¿Por qué? Si los metadatos del FS se dañan, también se podría decir adiós a los propios datos del FS, por lo que decidimos optar por un camino más complicado pero confiable.
Desarrollamos nosotros mismos el subsistema de sincronización de metadatos para ARDFS, y vive absolutamente independiente de los subsistemas adyacentes. Es decir, ningún otro subsistema puede dañar los datos de ARDFS. En nuestra opinión, este es el camino más confiable y correcto, aunque el tiempo dirá si realmente es así. Además, con este enfoque, hay una ventaja adicional. ARDFS se puede utilizar independientemente de vAIR, simplemente como un almacenamiento ampliado, lo que sin duda utilizaremos en productos futuros.
Como resultado, al desarrollar ARDFS, obtuvimos un sistema de archivos flexible y confiable que permite elegir dónde se puede ahorrar en capacidad o dedicar todos los recursos a rendimiento, o hacer que el almacenamiento sea extremadamente confiable a un costo moderado, reduciendo así los requisitos de rendimiento.
Junto con una política de licencias sencilla y un modelo de entrega flexible (para adelantarnos, vAIR se licencia por nodos y se suministra ya sea como software o como un paquete), esto permite ajustar la solución de manera muy precisa a los diversos requisitos de los clientes y mantener fácilmente ese equilibrio en el futuro.
¿A quién le interesa este milagro?
Por un lado, se puede decir que ya hay jugadores en el mercado que tienen soluciones serias en el ámbito de la hiperconvergencia, y a dónde, de hecho, estamos intentando entrar. Parece que esta afirmación es correcta, PERO…
Por otro lado, al salir al 'campo' y hablar con los clientes, nosotros y nuestros socios vemos que no es así en absoluto. Hay muchas tareas para la hiperconvergencia, en algunos casos la gente simplemente no sabía que existían tales soluciones, en otros casos parecía caro, en algunos hubo pruebas fallidas de soluciones alternativas, y en otros, en general, están prohibidas las compras debido a sanciones. En general, el campo resultó ser inexplorado, así que decidimos cultivarlo))).
¿Cuándo es mejor un sistema de almacenamiento que un sistema de hiperconvergencia?
A lo largo de nuestro trabajo con el mercado, a menudo nos preguntan cuándo es mejor utilizar el esquema clásico con almacenamiento de datos (SНD), y cuándo optar por el hiperescalar. Muchas empresas que fabrican soluciones hiperescalables (en particular, aquellas que no tienen SНD en su cartera) dicen: «El SНD se está volviendo obsoleto, ¡solo hiperescalar!». Esta declaración es audaz, pero no refleja completamente la realidad.
A decir verdad, el mercado de SНD realmente se está trasladando hacia soluciones hiperescalables y similares, pero siempre hay un 'pero'.
En primer lugar, los centros de datos (CD) e infraestructuras de TI construidas con el esquema clásico con SНD no se pueden transformar tan fácilmente, por lo que la modernización y expansión de dichas infraestructuras son un legado que durará entre 5 y 7 años.
En segundo lugar, la mayoría de las infraestructuras que se están construyendo actualmente (refiriéndonos a Rusia) están siendo realizadas con el esquema clásico utilizando SНD, no porque la gente no conozca el hiperescalar, sino porque el mercado del hiperescalar es nuevo, las soluciones y estándares aún no se han asentado, los especialistas en TI aún no están capacitados, hay poca experiencia y es necesario construir centros de datos aquí y ahora. Y esta tendencia se mantendrá durante 3-5 años más (y luego quedará otro legado, ver punto 1).
En tercer lugar, existe una limitación técnica puramente relacionada con demoras adicionales de 2 milisegundos en las escrituras (sin tener en cuenta la caché local, por supuesto), que son el costo del almacenamiento distribuido.
Y no olvidemos el uso de grandes servidores físicos que prefieren la escalabilidad vertical del subsistema de almacenamiento.
Existen muchas tareas necesarias y populares donde el SНD se comporta mejor que el hiperescalar. Por supuesto, aquellos fabricantes que no tienen SНD en su cartera no coincidirán con nosotros, pero estamos listos para argumentar de manera fundamentada. Por supuesto, como desarrolladores de ambos productos, en una de nuestras futuras publicaciones realizaremos una comparación entre SНD y hiperescalar, donde demostraremos claramente qué es mejor en qué condiciones.
¿Y en qué casos las soluciones hiperescalables funcionan mejor que el SНD?
A partir de las tesis anteriores, se pueden hacer tres conclusiones obvias:
- Allí donde las adicionales 2 milisegundos de latencia en las escrituras, que aparecen consistentemente en cualquier producción (esto no se refiere a la sintética, donde se pueden mostrar incluso nanosegundos), son no críticas, el hiperescalar será adecuado.
- Donde la carga de grandes servidores físicos se puede convertir en muchas pequeñas máquinas virtuales y distribuirse entre nodos, allí también el hiperconvergente funcionará bien.
- Donde la escalabilidad horizontal es más prioritaria que la vertical, allí también el GCS tendrá un buen rendimiento.
¿Cuáles son estas soluciones?
- Todos los servicios de infraestructura estándar (servicio de directorio, correo, gestión documental, servidores de archivos, sistemas ERP y BI pequeños o medianos, etc.). A esto lo llamamos 'computación compartida'.
- La infraestructura de los proveedores de nube, donde es necesario escalar horizontalmente de manera rápida y estandarizada y 'cortar' fácilmente una gran cantidad de máquinas virtuales para los clientes.
- Infraestructura escritorios virtuales (VDI), donde muchas pequeñas máquinas virtuales de usuario se inician y 'navegan' tranquilamente dentro de un clúster uniforme.
- Redes de filiales, donde en cada filial es necesario obtener una infraestructura estándar, tolerante a fallos, pero económica, compuesta por 15-20 máquinas virtuales.
- Cualquier computación distribuida (servicios de big data, por ejemplo). Donde la carga se va 'horizontalmente', no 'profundamente'.
- Ambientes de prueba, donde se permiten ligeros retrasos adicionales, pero hay limitaciones presupuestarias, pues son pruebas.
Actualmente, es precisamente para estas tareas que hemos creado AERODISK vAIR y nos estamos enfocando en ellas (hasta ahora exitosamente). Es posible que esto cambie pronto, ya que el mundo no se detiene.
Así que...
Con esto, la primera parte de un gran ciclo de artículos ha terminado; en el siguiente artículo, hablaremos sobre la arquitectura de la solución y los componentes utilizados.
Estaremos encantados de recibir preguntas, propuestas y debates constructivos.
Fuente: habr.com
