

Les invito a revisar la transcripción de la conferencia de fin de 2019 de Alexander Valyalkin "Optimización de Go en VictoriaMetrics"
— una base de datos SQL rápida y escalable para el almacenamiento y procesamiento de datos en forma de series temporales (un registro que forma el tiempo y un conjunto de valores correspondientes a ese tiempo, por ejemplo, obtenidos a través de encuestas periódicas sobre el estado de sensores o la recopilación de métricas).
Aquí está el enlace al video de esta conferencia —
Permítanme contarles un poco sobre mí. Soy Alexander Valyalkin. Aquí está . Me apasiona Go y la optimización del rendimiento. He escrito muchas bibliotecas útiles y otras no tanto. Comienzan con fast, o con quick de prefijo.
En este momento, estoy trabajando en VictoriaMetrics. ¿Qué es eso y qué hago allí? De esto hablaré en esta presentación.
El plan de la conferencia es el siguiente:
- Primero, les contaré qué es VictoriaMetrics.
- Luego explicaré qué son las series temporales.
- Después hablaré sobre cómo funciona una base de datos de series temporales.
- Luego, discutiré la arquitectura de la base de datos: de qué se compone.
- Y finalmente, pasaremos a las optimizaciones que existen en VictoriaMetrics. Esta es la optimización del índice invertido y la optimización para la implementación de bitset en Go.
¿Alguien en la audiencia sabe qué es VictoriaMetrics? Vaya, mucha gente sabe. Esa es una buena noticia. Para quienes no lo saben, es una base de datos para series temporales. Está basada en la arquitectura de ClickHouse, en algunos detalles de la implementación de ClickHouse. Por ejemplo, detalles como: MergeTree, cálculo paralelo en todos los núcleos de CPU disponibles y optimización de rendimiento mediante el trabajo en bloques de datos que se colocan en la caché del procesador.
VictoriaMetrics ofrece la mejor compresión de datos en comparación con otras bases de datos para series temporales.
Se escala verticalmente, es decir, pueden agregarse más procesadores, más memoria RAM en una sola máquina. VictoriaMetrics utilizará con éxito estos recursos disponibles y aumentará su rendimiento lineal.
Además, VictoriaMetrics se escala horizontalmente, es decir, pueden agregarse nodos adicionales al clúster de VictoriaMetrics y su rendimiento crecerá casi de forma lineal.
Como habrán adivinado, VictoriaMetrics es una base de datos rápida, porque no puedo escribir sobre otras. Y está escrita en Go, por eso hablo de ella en este meetup.
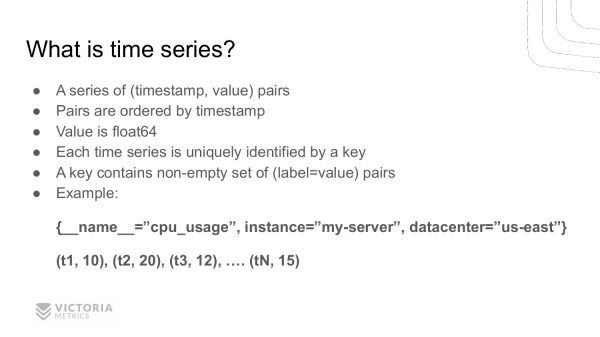
¿Quién sabe qué es una serie temporal? También muchas personas lo saben. Una serie temporal es una serie de pares (timestamp, valor), donde estos pares están ordenados por tiempo. El valor consiste en un número de punto flotante – float64.
Cada serie temporal está identificada de manera única por una clave. ¿De qué consiste esta clave? Consiste en un conjunto no vacío de pares clave-valor.
Aquí hay un ejemplo de una serie temporal. La clave de esta serie es una lista de pares: __name__="cpu_usage" – este es el nombre de la métrica, instance="my-server" — este es el ordenador en el que se recopiló esta métrica, datacenter="us-east" — este es el centro de datos donde se encuentra este ordenador.
Hemos obtenido el nombre de la serie temporal, que consiste en tres pares clave-valor. Esta clave corresponde a una lista de pares (timestamp, value). t1, t3, t3, ..., tN — estos son los timestamps, 10, 20, 12, ..., 15 — los valores correspondientes. Este es el uso de CPU en un momento dado para esta serie.
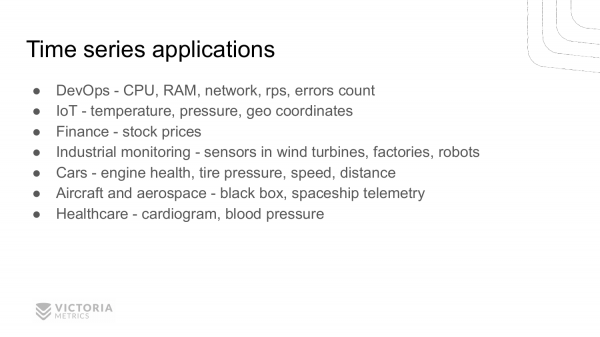
¿Dónde pueden ser utilizados las series temporales? ¿Alguien tiene ideas?
- En DevOps se pueden medir las lecturas de carga de CPU, RAM, red, rps, número de errores, etc.
- IoT – podemos medir la temperatura, la presión, coordenadas geográficas y algo más.
- También en finanzas – podemos monitorear precios de diversas acciones y divisas.
- Además, las series temporales pueden usarse para monitorear procesos de producción en fábricas. Tenemos usuarios que utilizan VictoriaMetrics para monitorear turbinas eólicas, para robots.
- Las series temporales también son útiles para recoger información de sensores de diversos dispositivos. Por ejemplo, para un motor; para medir la presión en los neumáticos; para medir velocidad, distancia; para medir el consumo de gasolina, etc.
- También se pueden utilizar series temporales para monitorear aviones. Cada avión tiene una caja negra que recopila series temporales sobre diferentes parámetros de salud del avión. Las series temporales también se utilizan en la industria aeroespacial.
- Salud – esto incluye la presión arterial, el pulso, etc.
Quizás haya otras aplicaciones que he olvidado, pero espero que hayan entendido que las series temporales se utilizan activamente en el mundo moderno. Y su volumen de uso aumenta cada año.
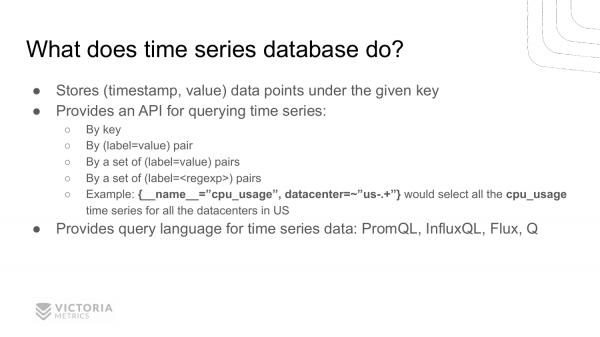
¿Para qué se necesita una base de datos para series temporales? ¿Por qué no se puede utilizar una base de datos relacional normal para almacenar series temporales?
Porque en las series temporales suele haber una gran cantidad de información que es difícil de almacenar y procesar en bases de datos convencionales. Por eso surgieron bases de datos especializadas para series temporales. Estas bases almacenan eficientemente los puntos (timestamp, value) con una clave determinada. Proporcionan una API para leer los datos almacenados por clave, ya sea de un par clave-valor, de varios pares, o mediante expresiones regulares. Por ejemplo, si deseas encontrar la carga del CPU de todos tus servicios en el centro de datos en América, deberías usar una consulta pseudocode como esta.
Normalmente, las bases de datos para series temporales presentan lenguajes de consulta especializados, porque SQL no se adapta muy bien a las series temporales. Aunque hay bases de datos que soportan SQL, no es la mejor opción. Lenguajes de consulta como , , , . Espero que alguien haya oído al menos uno de estos lenguajes. Muchos probablemente han oído hablar de PromQL. Este es el lenguaje de consulta de Prometheus.
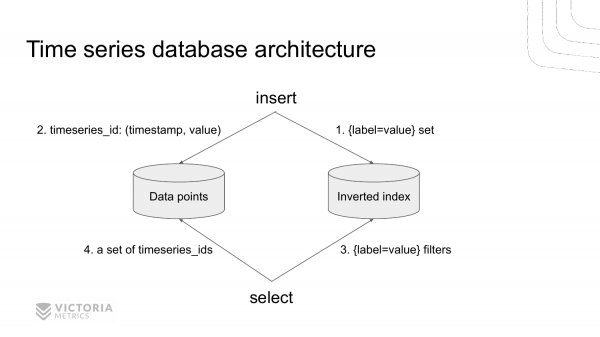
Así es como se ve la arquitectura de una base de datos moderna para series temporales, usando VictoriaMetrics como ejemplo.
Consiste en dos partes. Un almacenamiento para índices invertidos y otro para valores de series temporales. Estos almacenes están separados.
Cuando llega un nuevo registro a la base de datos, primero accedemos al índice invertido para encontrar el identificador de la serie temporal correspondiente al conjunto dado de label=value para esta métrica. Encontramos este identificador y guardamos el valor en el almacenamiento de datos.
Cuando se recibe una consulta para la extracción de datos de la TSDB, primero accedemos al índice invertido. Obtenemos todos los timeseries_ids que corresponden al conjunto dado. label=valueLuego, extraemos todos los datos necesarios del almacenamiento de datos, indexados por timeseries_ids.
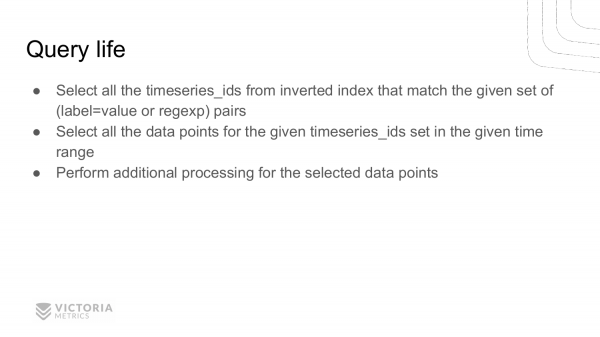
Consideremos un ejemplo de cómo una base de datos para series temporales procesa una consulta de selección entrante.
- Primero recupera todos los
timeseries_idsdel índice invertido que contienen los pares dadoslabel=value, o que satisfacen una expresión regular determinada. - Luego extrae todos los puntos de datos del almacenamiento de datos en el intervalo de tiempo especificado para los que fueron encontrados.
timeseries_ids. - Después de eso, la base de datos realiza algunos cálculos sobre estos puntos de datos, de acuerdo con la consulta del usuario. Y finalmente devuelve la respuesta.
En esta presentación, les hablaré sobre la primera parte. Esto es la búsqueda. timeseries_ids a través del índice invertido. Puedes ver la segunda y tercera parte más tarde. , o esperar a que prepare otras presentaciones 🙂
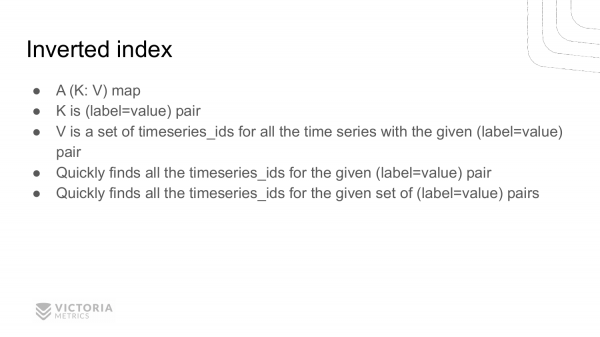
Vamos a empezar con el índice invertido. A muchos les puede parecer simple. ¿Quién sabe qué es un índice invertido y cómo funciona? Oh, ya no son muchas las personas. Intentemos entender qué es.
En realidad, es todo bastante simple. Es solo un diccionario que mapea claves a valores. ¿Qué es una clave? Este par label=value, donde label y value – son cadenas. Y los valores son un conjunto timeseries_ids, que incluye el par dado label=value.
El índice invertido permite encontrar rápidamente todas timeseries_ids, que tienen las label=value.
Así como permite encontrar rápidamente timeseries_ids series temporales para varios pares label=value, o para los pares label=regexp. ¿Cómo funciona esto? A través de la intersección de conjuntos timeseries_ids para cada par label=value.
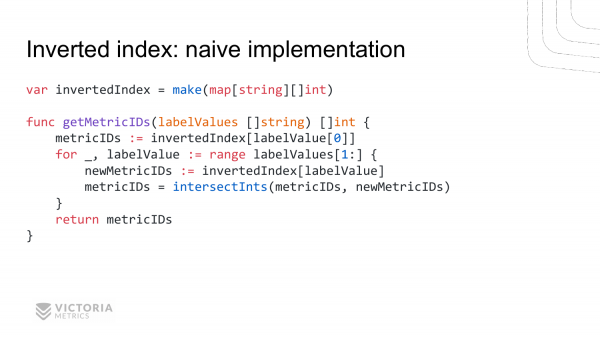
Consideremos diferentes implementaciones del índice invertido. Empezaremos con la implementación ingenua más simple. Se ve así.
La función getMetricIDs devuelve una lista de cadenas. Cada cadena contiene label=value. Esta función devuelve una lista metricIDs.
¿Cómo funciona esto? Aquí tenemos una variable global llamada invertedIndex. Es un diccionario normal (map), que mapea una cadena a un slice de int. La cadena contiene label=value.
Implementación de la función: obtenemos metricIDs para el primero label=value, luego recorremos todos los demás label=value, obtenemos metricIDs para ellos. Y llamamos a la función intersectInts, que se explicará más adelante. Y esta función devuelve la intersección de estas listas.
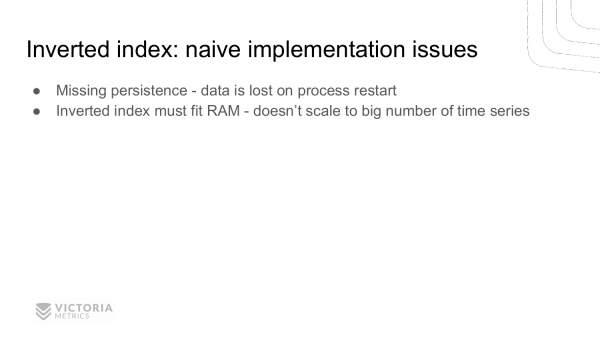
Como pueden ver, la implementación del índice invertido no es muy compleja. Pero esta es una implementación ingenua. ¿Cuáles son sus desventajas? La principal desventaja de la implementación ingenua es que este índice invertido se almacena en la memoria RAM. Después de reiniciar la aplicación, perdemos este índice. No hay guardado de este índice en disco. Para una base de datos, este índice invertido probablemente no sirva.
La segunda desventaja también está relacionada con la memoria. El índice invertido debe caber en la memoria RAM. Si supera el tamaño de la memoria RAM, es evidente que obtendremos un error de falta de memoria. Y el programa no funcionará.
Este problema se puede resolver utilizando soluciones ya existentes como , o .
En resumen, necesitamos una base de datos que permita realizar rápidamente tres operaciones.
- La primera operación es la escritura
clave-valoren esta base. Lo hace muy rápido, dondeclave-valorson cadenas arbitrarias. - La segunda operación es la búsqueda rápida de un valor por una clave dada.
- Y la tercera operación es la búsqueda rápida de todos los valores por un prefijo dado.
LevelDB y RocksDB son bases de datos desarrolladas por Google y Facebook. Primero apareció LevelDB. Luego, el equipo de Facebook tomó LevelDB y comenzó a mejorarlo, creando RocksDB. Actualmente, casi todas las bases de datos internas en Facebook funcionan sobre RocksDB, incluso migraron MySQL a RocksDB. Lo llamaron .
El índice invertido se puede implementar con LevelDB. ¿Cómo hacerlo? Guardamos como clave label=value. Y como valor, el identificador de la serie temporal donde está presente el par label=value.
Si tenemos muchas series temporales con este par label=value, habrá muchas líneas en esta base de datos con la misma clave y diferentes timeseries_ids. Para obtener una lista de todos los timeseries_ids, que comienzan con el dado label=prefix, hacemos un escaneo de rango, para lo cual esta base de datos está optimizada. Es decir, elegimos todas las líneas que comienzan con label=prefix y obtenemos los necesarios timeseries_ids.
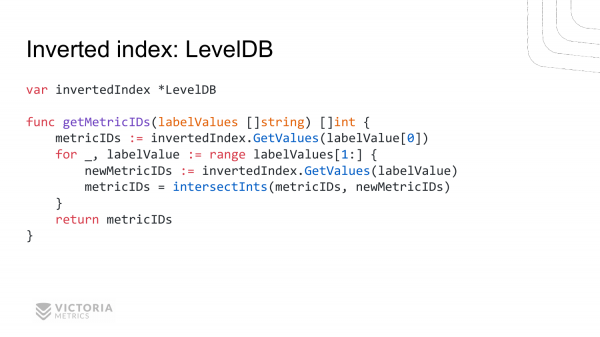
Aquí hay una implementación aproximada de cómo se vería en Go. Tenemos un índice invertido. Esto es LevelDB.
La función es la misma que para la implementación ingenua. Casi repite línea por línea la implementación ingenua. El único detalle es que en lugar de acceder a map accedemos al índice invertido. Sacamos todos los valores para la primera label=value. Luego recorrremos todos los pares restantes label=value y extraemos los conjuntos correspondientes de metricIDs para ellos. Luego encontramos la intersección.
Parece que todo está bien, pero en esta solución hay desventajas. VictoriaMetrics inicialmente implementó un índice invertido basado en LevelDB. Pero al final tuvo que abandonarlo.
¿Por qué? Porque LevelDB es más lento que la implementación ingenua. En la implementación ingenua, al dado clave, obtenemos inmediatamente todo el slice metricIDs. Esta es una operación muy rápida: todo el slice está listo para su uso.
En LevelDB, sin embargo, en cada llamada a la función GetValues hay que recorrer todas las líneas que comienzan con label=value. Y para cada línea obtener el valor timeseries_ids. A partir de esos timeseries_ids reunir el slice de estos timeseries_ids. Es evidente que esto es mucho más lento que simplemente acceder a un map normal por clave.
La segunda desventaja es que LevelDB está escrito en C. Llamar funciones de C desde Go no es muy rápido. Toma cientos de nanosegundos. Esto no es muy rápido, ya que, en comparación con una llamada a una función escrita en Go, que toma de 1 a 5 nanosegundos, la diferencia en el rendimiento es de decenas de veces. Para VictoriaMetrics, esta fue una desventaja fatal 🙂
Por lo tanto, escribí mi propia implementación de un índice invertido. La llamé .
Mergeset se basa en la estructura de datos MergeTree. Esta estructura de datos se toma de ClickHouse. Es obvio que mergeset debe estar optimizado para búsqueda rápida timeseries_ids por una clave específica. Mergeset está completamente escrito en Go. Puedes ver . La implementación de mergeset se encuentra en la carpeta . Puedes intentar averiguar qué está sucediendo allí.
La API de mergeset es muy similar a la de LevelDB y RocksDB. Es decir, permite guardar rápidamente nuevos registros y seleccionar registros rápidamente por un prefijo dado.
Hablaremos de las desventajas de mergeset más adelante. Ahora vamos a hablar sobre los problemas que surgieron con VictoriaMetrics en producción al implementar el índice invertido.
¿Por qué surgieron?
La primera razón es la alta tasa de cambio. En español, esto se traduce como la frecuente modificación de series temporales. Esto ocurre cuando una serie temporal termina y comienza una nueva serie, o cuando comienzan muchas nuevas series temporales. Y esto sucede con frecuencia.
La segunda razón es la gran cantidad de series temporales. Al principio, cuando el monitoreo comenzó a ganar popularidad, el número de series temporales era pequeño. Por ejemplo, para cada computadora se necesita monitorear la carga de la CPU, memoria, red y disco. 4 series temporales por cada computadora. Supongamos que tienes 100 computadoras y 400 series temporales. Eso es muy poco.
Con el tiempo, las personas idearon que se podía medir información más detallada. Por ejemplo, medir la carga no solo de toda la CPU, sino de cada núcleo de procesador por separado. Si tienes 40 núcleos de procesador, entonces, consecuentemente, tienes 40 veces más series temporales para medir la carga del procesador.
Pero eso no es todo. Cada núcleo de procesador puede tener varios estados, como el estado idle, cuando está inactivo. También hay funcionamiento en el espacio de usuario, funcionamiento en el espacio del kernel y otros estados. Y cada uno de estos estados también se puede medir como una serie temporal separada. Esto aumenta adicionalmente la cantidad de series en 7-8 veces.
De una métrica obtuvimos 40 x 8 = 320 métricas solo para un ordenador. Multiplicamos por 100 y obtenemos 32,000 en lugar de 400.
Luego apareció Kubernetes. Y esto empeoró aún más, porque en Kubernetes pueden alojarse muchos servicios diferentes. Cada servicio en Kubernetes consta de muchos pods. Y todo esto necesita ser monitoreado. Además, tenemos constantes despliegues de nuevas versiones de sus servicios. Para cada nueva versión, se deben crear nuevas series temporales. Como resultado, la cantidad de series temporales crece exponencialmente y nos encontramos con el problema de la gran cantidad de series temporales, llamado high-cardinality. VictoriaMetrics lo maneja con éxito en comparación con otras bases de datos para series temporales.
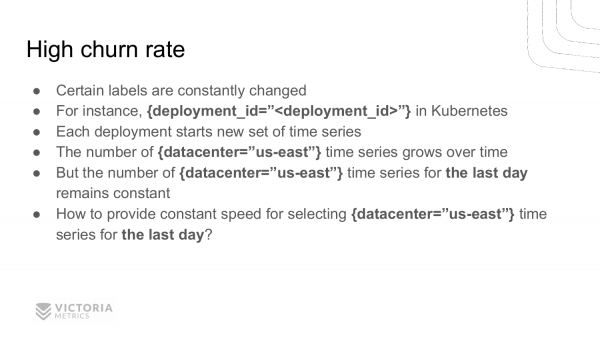
Veamos más de cerca el high churn rate. ¿Por qué aparece el high churn rate en producción? Porque algunos valores de etiquetas y tags cambian constantemente.
Por ejemplo, tomemos Kubernetes, en el que hay un concepto de deployment, es decir, cuando se despliega una nueva versión de su aplicación. Los desarrolladores de Kubernetes decidieron inexplicablemente agregar el id del despliegue en la etiqueta.
¿A qué llevó esto? A que con cada nuevo despliegue, nuestras antiguas series temporales se interrumpen, y en su lugar comienzan nuevas series temporales con un nuevo valor de etiqueta deployment_id. Puede haber cientos de miles e incluso millones de tales series.
Una característica importante de todo esto es que el número total de series temporales está en aumento, pero el número de series temporales que están activas en este momento, a las que llegan datos, se mantiene constante. Este estado se llama high churn rate.
El principal problema del high churn rate es garantizar una velocidad de búsqueda constante de todas las series temporales según un conjunto dado de etiquetas durante un intervalo de tiempo determinado. Generalmente, este intervalo de tiempo es el último hora o el último día.
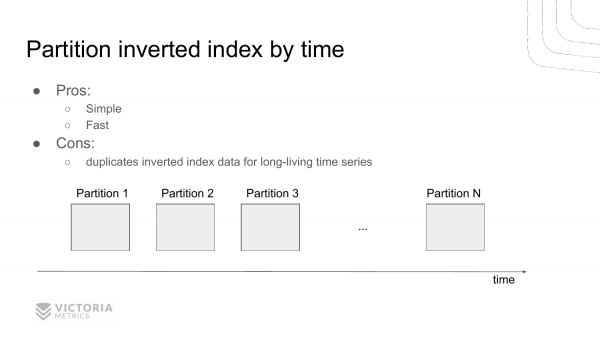
¿Cómo resolver este problema? Aquí hay una primera opción. Se trata de dividir el índice inverso en partes independientes por tiempo. Es decir, después de un cierto intervalo de tiempo, dejamos de trabajar con el índice inverso actual y creamos un nuevo índice inverso. Pasa otro intervalo de tiempo, creamos otro y otro más.
Y al seleccionar de estos índices inversos, encontramos un conjunto de índices inversos que caen dentro del intervalo especificado. Y, por lo tanto, elegimos de allí los ID de las series temporales.
Esto permite ahorrar recursos, porque no tenemos que revisar partes que no caen dentro del intervalo especificado. Es decir, normalmente, si seleccionamos datos de la última hora, pasamos por alto las solicitudes de los intervalos temporales anteriores.
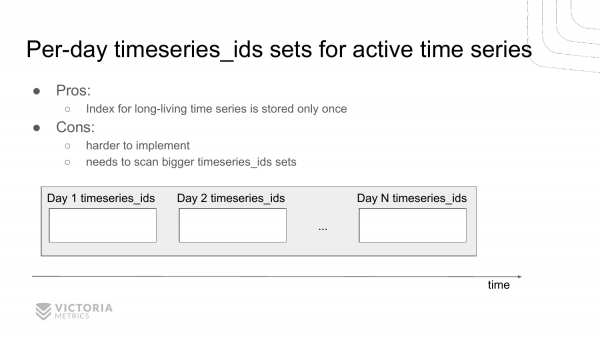
Hay otra opción para resolver este problema. Es almacenar para cada día una lista separada de ID de series temporales que se encontraron durante ese día.
La ventaja de esta solución en comparación con la anterior es que no duplicamos la información sobre las series temporales que no desaparecen con el tiempo. Están presentes de manera constante y no cambian.
La desventaja es que esta solución es más complicada de implementar y más difícil de depurar. Y VictoriaMetrics eligió esta solución. Esto sucedió históricamente. Esta solución también se desempeña bastante bien, en comparación con la anterior. Porque esta solución no se implementó debido a que había que duplicar datos en cada partición para las series temporales que no cambian, es decir, que no desaparecen con el tiempo. VictoriaMetrics fue optimizada principalmente para el consumo de espacio en disco, y la implementación anterior deterioraba el consumo de espacio en disco. En cambio, esta implementación es más adecuada para minimizar el consumo de espacio en disco, por lo que fue elegida.
Tuve que luchar con eso. La lucha consistió en que en esta implementación aún necesita seleccionar una cantidad mucho mayor timeseries_ids de datos que cuando el índice inverso está dividido por tiempo.
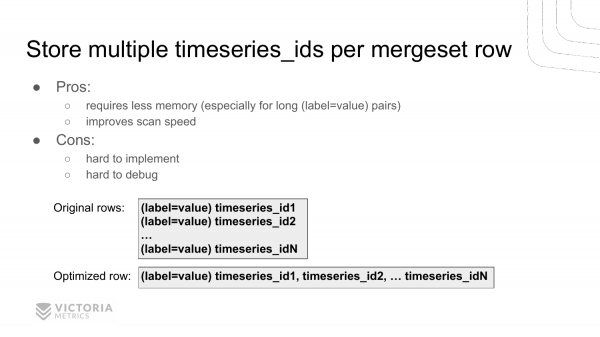
¿Cómo resolvimos este problema? Lo resolvimos de una manera original: guardando múltiples identificadores de series temporales en cada registro del índice inverso en lugar de un único identificador. Es decir, tenemos una clave label=value, que se encuentra en cada serie temporal. Y ahora estamos guardando varios timeseries_ids en un solo registro.
Aquí hay un ejemplo. Antes teníamos N registros, y ahora tenemos un registro con un prefijo igual al de todos los demás. El valor del registro anterior contiene todos los id de las series temporales.
Esto ha permitido aumentar la velocidad de escaneo de dicho índice invertido hasta 10 veces. Y ha permitido reducir el consumo de memoria para el caché, porque ahora almacenamos la cadena label=value solo una vez en el caché junto con N veces. Y esta cadena puede ser grande si tienes largas cadenas en las etiquetas y labels que Kubernetes tiende a introducir allí.
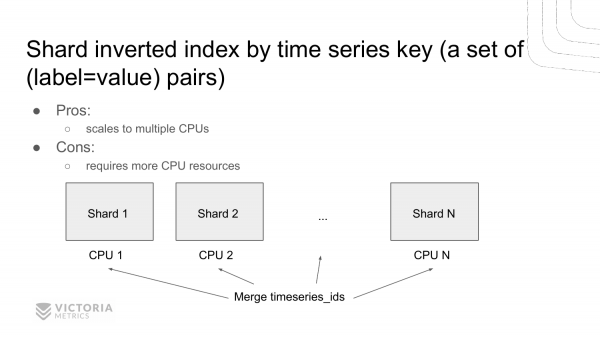
Otra opción para acelerar la búsqueda en el índice invertido es el sharding. La creación de varios índices invertidos en lugar de uno y el sharding de datos entre ellos por clave. Esto es un conjunto clave=valor de pares. Es decir, obtenemos varios índices invertidos independientes que podemos consultar en paralelo en varios procesadores. Las implementaciones anteriores solo permitían operar en modo de un solo procesador, es decir, escanear datos solo en un núcleo. Esta solución permite escanear datos simultáneamente en varios núcleos, como a ClickHouse le gusta hacer. Esto planeamos implementar.
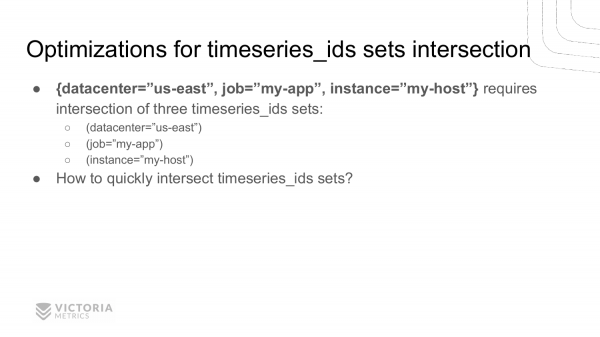
Y ahora volvamos a lo nuestro – a la función de intersección timeseries_ids. Veamos qué implementaciones podrían existir. Esta función permite encontrar timeseries_ids para un conjunto dado label=value.
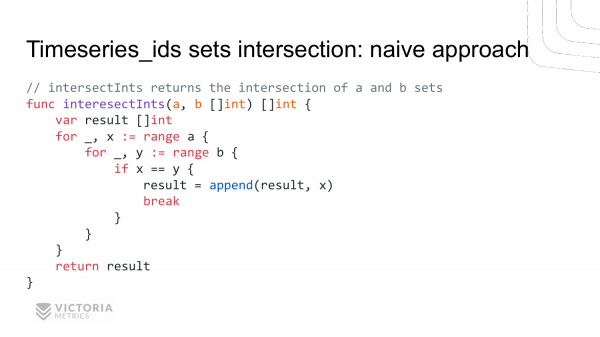
La primera opción es una implementación naïve. Dos ciclos anidados. Aquí recibimos como entrada las funciones intersectInts dos slices – a y b. En la salida, debe devolvernos la intersección de estos slices.
La implementación naïve se ve así. Recorremos todos los valores del slice a, dentro de este ciclo recorremos todos los valores del slice b. Y los comparamos. Si coinciden, significa que hemos encontrado la intersección. Y lo guardamos en resultado.
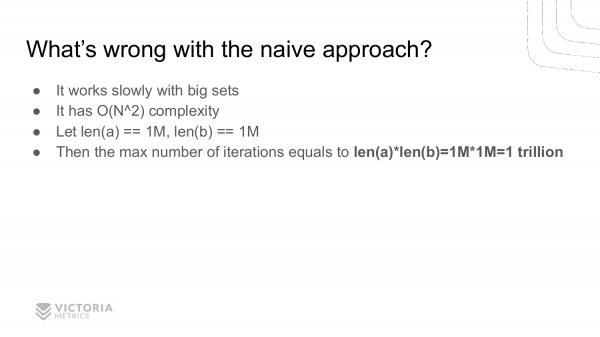
¿Cuáles son las desventajas? La complejidad cuadrática es su principal desventaja. Por ejemplo, si los tamaños del slice a y b son de un millón, esta función nunca te devolverá una respuesta. Porque necesitaría hacer un billón de iteraciones, lo cual es demasiado incluso para las computadoras modernas.
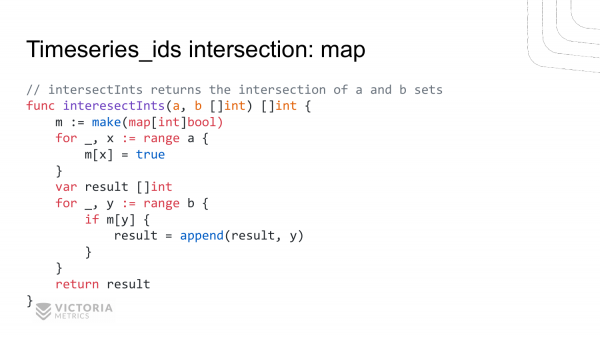
La segunda implementación se basa en un map. Creamos un map. Colocamos en este map todos los valores del slice a. Luego, recorremos con un ciclo separado el slice b. Y verificamos si este valor del slice b en map. Si existe, lo añadimos al resultado.
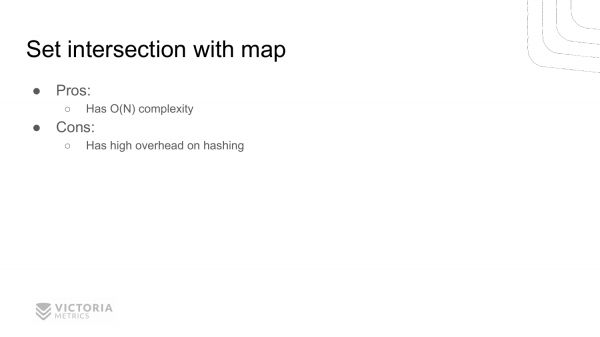
¿Cuáles son las ventajas? La ventaja es que aquí solo hay complejidad lineal. Es decir, la función se ejecutará mucho más rápido para tamaños grandes de slices. Para un slice de un millón de tamaño, esta función se ejecutará en 2 millones de iteraciones, a diferencia de un billón de iteraciones, como en la función anterior.
Sin embargo, la desventaja es que esta función requiere más memoria para crear este map.
La segunda desventaja es el gran overhead en el hashing. Esta desventaja no es muy obvia. Y para nosotros tampoco fue muy obvia, por eso al principio en VictoriaMetrics la implementación de la intersección se hacía a través de map. Pero luego el perfilado mostró que la mayor parte del tiempo del procesador se gasta en escribir en el map y en verificar la existencia de un valor en este map.
¿Por qué se gasta tiempo de procesador en estos lugares? Porque en esas líneas Go realiza la operación de hashing. Es decir, calcula el hash de la clave para luego acceder por el índice dado en el HashMap. La operación de cálculo del hash se realiza en decenas de nanosegundos. Esto es lento para VictoriaMetrics.
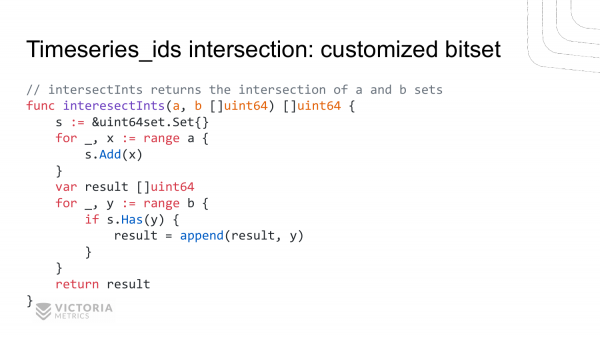
Decidí implementar un bitset, optimizado específicamente para este caso. Así es como se ve ahora la intersección de dos slices. Aquí creamos un bitset. Añadimos elementos del primer slice. Luego verificamos la existencia de esos elementos en el segundo slice. Y los añadimos al resultado. Es decir, no se diferencia mucho del ejemplo anterior. La única diferencia es que aquí hemos reemplazado el acceso al map por funciones personalizadas. add y has.
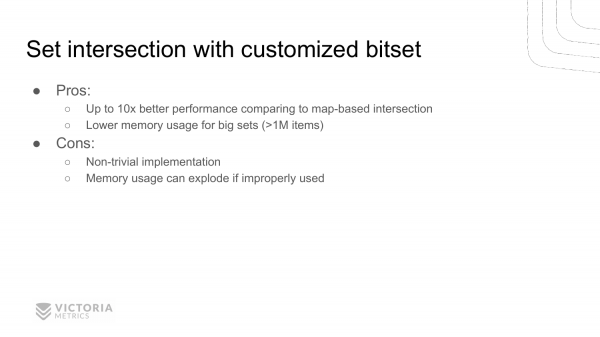
A primera vista parece que esto debería funcionar más lento, si antes se utilizaba un map estándar y aquí se llaman a algunas funciones, pero el perfilado muestra que esta cosa funciona 10 veces más rápido que un map estándar para el caso de VictoriaMetrics.
Además, utiliza mucho menos memoria en comparación con la implementación en map. Porque aquí almacenamos bits en lugar de valores de ocho bytes.
La desventaja de esta implementación es que no es tan obvia, no es trivial.
Otra desventaja que muchos pueden no notar es que esta implementación puede fallar en algunos casos. Es decir, está optimizada para un caso específico, para este caso de intersección de ids de series temporales de VictoriaMetrics. Esto no significa que sea adecuada para todos los casos. Si se utiliza incorrectamente, obtendremos no un aumento de rendimiento, sino un error de falta de memoria y una disminución en el rendimiento.
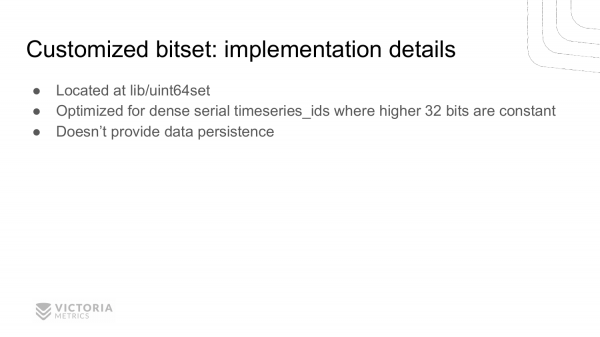
Consideremos la implementación de esta estructura. Si deseas verlo, se encuentra en las fuentes de VictoriaMetrics, en la carpeta . Está optimizada específicamente para el caso de VictoriaMetrics, donde timeseries_id es un valor de 64 bits, donde los primeros 32 bits son constantes y solo cambian los últimos 32 bits.
Esta estructura de datos no se almacena en disco, solo funciona en memoria.
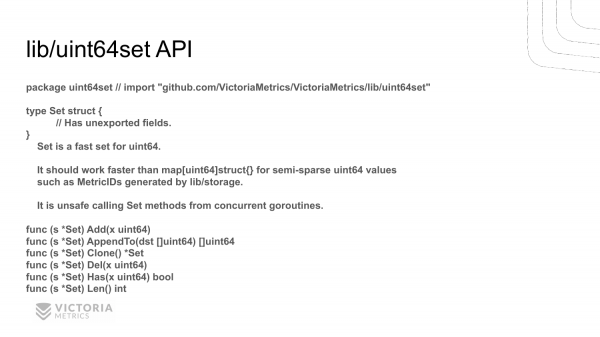
Aquí está su API. No es muy complicada. La API está ajustada específicamente para el ejemplo de uso de VictoriaMetrics. Es decir, no hay funciones innecesarias. Aquí están las funciones que se utilizan explícitamente en VictoriaMetrics.
Hay una función add, que agrega nuevos valores. Hay una función has, que verifica nuevos valores. Y hay una función del, que elimina valores. Hay una función auxiliar len, que devuelve el tamaño del conjunto. La función clone clona el conjunto. Y la función appendto transforma este conjunto en un slice timeseries_ids.
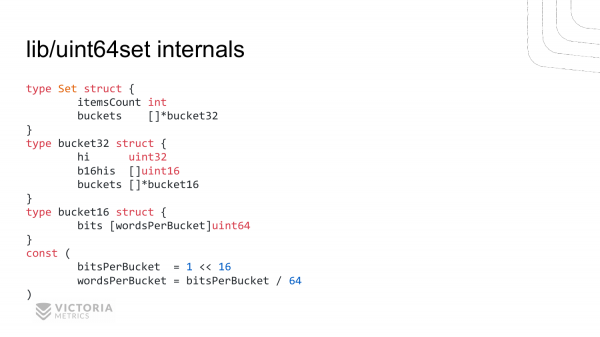
Así es como se ve la implementación de esta estructura de datos. En el conjunto hay dos elementos:
ItemsCount– es un campo auxiliar para devolver rápidamente el número de elementos en el conjunto. Podría prescindirse de este campo auxiliar, pero se tuvo que añadir aquí porque VictoriaMetrics solicita a menudo la longitud del bitset en sus algoritmos.El segundo campo es
buckets. Es un slice de la estructurabucket32. En cada estructura se almacenahiel campo. Estos son los 32 bits superiores. Y dos slices —b16hisybucketsdebucket16estructuras.
Aquí se almacenan los 16 bits superiores de la segunda parte de la estructura de 64 bits. Y aquí se almacenan los bitsets para los 16 bits inferiores de cada byte.
Bucket64 consiste en un arreglo uint64. La longitud se calcula usando estas constantes. En uno bucket16 se pueden almacenar como máximo 2^16=65536 bits. Si eso se divide entre 8, son 8 kilobytes. Si se divide nuevamente entre 8, son 1000 uint64 valores. Es decir, Bucket16 – es nuestra estructura de 8 kilobytes.
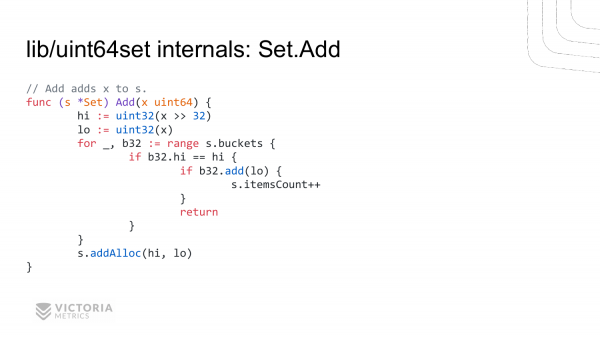
Veamos cómo se implementa uno de los métodos de esta estructura para agregar un nuevo valor.
Todo comienza con uint64 valores. Calculamos los 32 bits superiores, calculamos los 32 bits inferiores. Revisamos todos buckets. Comparamos los 32 bits superiores en cada bucket con el valor que estamos añadiendo. Y si coinciden, llamamos a la función add en la estructura b32 buckets. Y añadimos allí los 32 bits inferiores. Y si esto devolvió true, entonces significa que hemos añadido ese valor allí y no teníamos ese valor previamente. Si devuelve false, entonces ese valor ya existía. Luego incrementamos la cantidad de elementos en la estructura.
Si no encontramos el necesario bucket con el valor hi correspondiente, entonces llamamos a la función addAlloc, que asigna un nuevo bucket, añadiéndolo a la estructura de buckets.
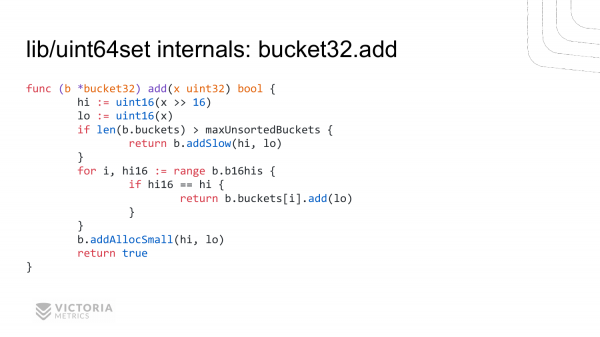
Esta es la implementación de la función b32.add. Es similar a la implementación anterior. Calculamos los 16 bits superiores, los 16 bits inferiores.
Luego revisamos todos los 16 bits superiores. Buscamos coincidencias. Y al coincidir, llamamos al método add, que revisaremos en la siguiente página para bucket16.
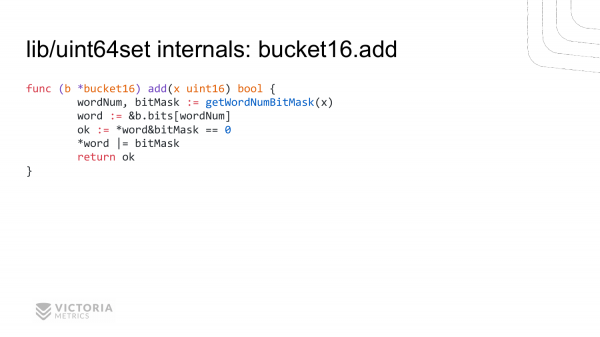
Y aquí está el nivel más bajo, que debe estar optimizado al máximo. Calculamos para uint64 el valor id en el slice bit, así como bitmask. Esta es una máscara para este valor de 64 bits, que puede verificar la presencia de este bit, o establecerlo. Comprobamos la existencia de este bit, lo establecemos y devolvemos su presencia. Esta es nuestra implementación, que ha permitido acelerar la operación de intersección de ids de series temporales por 10 veces en comparación con los mapas normales.
En VictoriaMetrics, además de esta optimización, hay muchas otras optimizaciones. La mayoría de estas optimizaciones no se añadieron al azar, sino después de perfilar el código en producción.
Esta es la regla principal de la optimización: no añadir optimización suponiendo que aquí habrá un cuello de botella, porque podría resultarse que no hay ningún cuello de botella. La optimización generalmente empeora la calidad del código. Por lo tanto, vale la pena optimizar solo después de perfilar y, preferiblemente, en producción, para que sean datos reales. A quienes les interese, pueden ver las fuentes de VictoriaMetrics y estudiar otras optimizaciones que hay allí.
Tengo una pregunta sobre bitset. Muy parecido a la implementación de C++ vector bool, bitset optimizado. ¿Tomaron la implementación de allí?
No, no es de allí. Al implementar este bitset, me guié por el conocimiento de la estructura de estos ids de series temporales que se utilizan en VictoriaMetrics. La estructura es tal que los 32 bits superiores son en su mayor parte constantes. Los 32 bits inferiores pueden cambiar. Cuanto más bajo es el bit, más a menudo puede cambiar. Por lo tanto, esta implementación está optimizada para esta estructura de datos. La implementación en C++, hasta donde sé, está optimizada para el caso general. Si se hace una optimización para el caso general, eso significa que no será la más óptima para un caso específico.
Te aconsejo que mires la presentación de Alexey Milovid. Hace aproximadamente un mes habló sobre optimizaciones en ClickHouse para especializaciones concretas. Él menciona que, en general, la implementación en C++ o cualquier otra implementación está diseñada para un buen funcionamiento promedio. Puede funcionar peor que una implementación especializada basada en conocimientos concretos, como en nuestro caso, cuando sabemos que los 32 bits superiores son en su mayoría constantes.
Tengo una segunda pregunta. ¿Cuál es la diferencia fundamental con InfluxDB?
Hay muchas diferencias fundamentales. En términos de rendimiento y consumo de memoria, InfluxDB muestra en las pruebas un consumo de memoria 10 veces mayor para series temporales de alta cardinalidad, cuando tienes muchas, por ejemplo, millones. Por ejemplo, VictoriaMetrics consume 1 GB por millón de series activas, mientras que InfluxDB consume 10 GB. Y esa es una gran diferencia.
La segunda diferencia fundamental es que InfluxDB tiene lenguajes de consulta extraños: Flux e InfluxQL. No son muy convenientes para trabajar con series temporales en comparación con , que es soportado en VictoriaMetrics. PromQL es el lenguaje de consultas de Prometheus.
Y otra diferencia es que InfluxDB tiene un modelo de datos algo extraño, donde cada línea puede contener varios fields con diferentes conjuntos de etiquetas. Estas líneas se dividen además en varias tablas. Estas complicaciones adicionales hacen que el trabajo posterior con esta base sea más complicado. Es difícil de mantener y entender.
En VictoriaMetrics todo es mucho más simple. Cada serie temporal se representa como una clave-valor. El valor es un conjunto de puntos - (timestamp, value), y la clave es un conjunto label=value. No hay división entre fields y measurements. Esto permite elegir cualquier dato y luego combinarlos, sumarlos, restarlos, multiplicarlos, dividirlos, a diferencia de InfluxDB, donde los cálculos entre diferentes series aún no están implementados, hasta donde yo sé. Incluso si están implementados, es complicado; hay que escribir mucho código.
Tengo una pregunta aclaratoria. ¿Entendí correctamente que hubo algún problema del que hablaste, que este índice invertido no cabe en memoria, por lo que se está particionando?
Al principio, mostré una implementación ingenua de un índice invertido en el mapa estándar de Go. Tal implementación no es adecuada para bases de datos, porque este índice invertido no se guarda en disco, y una base de datos debe guardar en disco para que, al reiniciar, esos datos sigan siendo accesibles. En esta implementación, al reiniciar la aplicación, perderás el índice invertido. Y perderás el acceso a todos los datos, porque no podrás encontrarlos.
¡Hola! Gracias por la presentación. Me llamo Pavel. Soy de la empresa Wildberries. Tengo varias preguntas para ti. La primera pregunta. ¿Crees que si hubieras elegido otro principio al construir la arquitectura de tu aplicación y particionado los datos por tiempo, tal vez habrías podido hacer intersecciones de datos al buscar, basándote solo en que en una partición se encuentran datos de un mismo período de tiempo, es decir, de un mismo intervalo de tiempo, y no tendrías que preocuparte de que tus trozos están distribuidos de manera diferente? La pregunta número 2: dado que implementas un algoritmo similar con bitset y todo lo demás, ¿quizás has intentado usar instrucciones del procesador? ¿Quizás has intentado tales optimizaciones?
Responderé inmediatamente a la segunda. Aún no hemos llegado a eso. Pero si es necesario, llegaremos. ¿Y la primera, cuál era la pregunta?
Discutiste dos escenarios. Y dijiste que elegiste el segundo con una implementación más complicada. Y no preferiste el primero, donde los datos están particionados por tiempo.
Sí. En el primer caso, el volumen total del índice sería mayor, porque en cada partición tendríamos que almacenar duplicados de datos para aquellas series temporales que se extienden a través de todas estas particiones. Y si su tasa de cambio en las series temporales es baja, es decir, se utilizan constantemente las mismas series, entonces en el primer caso perderíamos mucho más en términos de espacio en disco en comparación con el segundo caso.
Así es, la partición temporal es una buena opción. Prometheus la utiliza. Pero Prometheus tiene otra desventaja. Al fusionar estos fragmentos de datos, necesita mantener en memoria la metainformación de todas las etiquetas y series temporales. Por lo tanto, si los fragmentos de datos que está fusionando son grandes, el consumo de memoria aumenta mucho durante la fusión, a diferencia de VictoriaMetrics. Durante la fusión, VictoriaMetrics no consume memoria, solo se utilizan unos pocos kilobytes, independientemente del tamaño de los fragmentos de datos que se están fusionando.
El algoritmo que está utilizando consume memoria. Se marcan las etiquetas de serie temporal en las que hay valores. Así es como verifica la existencia coincidente en un conjunto de datos y en otro. Y entiende si ha habido intersección o no. Normalmente, en las bases de datos se implementan cursores, iteradores que mantienen su estado actual y recorren los datos ordenados, lo que le permite tener una complejidad simple en esas operaciones.
¿Por qué no usamos cursores para la intersección de datos?
Sí.
En LevelDB o en mergeset, se almacenan precisamente las filas ordenadas. Podemos usar un cursor para pasar y encontrar la intersección. Pero, ¿por qué no lo utilizamos? Porque es lento. Porque los cursores implican que para cada fila hay que llamar a una función. La llamada a la función toma 5 nanosegundos. Y si tiene 100,000,000 filas, eso significa que gastamos medio segundo solo en llamar a la función.
Sí, eso existe. Y tengo una última pregunta. Puede que esta pregunta suene un poco extraña. ¿Por qué en el momento de la llegada de los datos no se pueden calcular todos los agregados necesarios y guardarlos en la forma necesaria? ¿Por qué almacenar enormes volúmenes en sistemas como VictoriaMetrics, ClickHouse, etc., solo para gastar luego mucho tiempo en ellos?
Voy a dar un ejemplo para que sea más claro. Supongamos, ¿cómo funciona un pequeño velocímetro de juguete? Registra la distancia que has recorrido, sumando continuamente a una medida el tiempo. Y divide. Y obtiene la velocidad promedio. Se puede hacer algo parecido. Acumular sobre la marcha todos los hechos necesarios.
Bien, entiendo la pregunta. Tu ejemplo tiene sentido. Si sabes qué agregados necesitas, esa es la mejor implementación. Pero el problema es que las personas almacenan estas métricas, algunos datos en ClickHouse y no saben aún cómo van a agregarlos o filtrarlos en el futuro, por lo que tienen que guardar todos los datos en crudo. Pero si sabes que necesitas calcular algo promedio, ¿por qué no calcularlo, en lugar de guardar un montón de valores en crudo? Pero esto solo se aplica si sabes exactamente lo que necesitas.
Por cierto, las bases de datos para el almacenamiento de series temporales soportan el conteo de agregados. Por ejemplo, Prometheus soporta . Es decir, se puede hacer esto si sabes qué agregados necesitarás. En VictoriaMetrics esto actualmente no está disponible, pero normalmente se coloca Prometheus delante, en el que se puede hacer esto con las reglas de grabación.
Por ejemplo, en mi trabajo anterior necesitaba contar la cantidad de eventos en una ventana deslizante durante la última hora. El problema era que tuve que hacer una implementación personalizada en Go, es decir, un servicio para contar esto. Este servicio resultó ser no trivial, porque es complicado de calcular. La implementación puede ser sencilla si necesitas contar algunos agregados en intervalos de tiempo fijos. Sin embargo, si quieres contar eventos en una ventana deslizante, no es tan fácil como parece. Creo que esto aún no se ha implementado en ClickHouse o en bases de datos de series temporales, porque es complicado de implementar.
Y otra pregunta. Ahora hemos hablado sobre el promedio, y recordé que alguna vez existió algo llamado Graphite con un backend Carbon. Y podía reducir los datos antiguos, es decir, dejar un punto por minuto, un punto por hora, etc. En principio, esto es bastante conveniente si necesitamos datos en crudo, digamos, durante un mes, y todo lo demás se puede reducir. Pero Prometheus y VictoriaMetrics no soportan esta funcionalidad. ¿Está previsto soportarlo? Si no, ¿por qué?
Gracias por su pregunta. Nuestros usuarios la hacen periódicamente. Preguntan cuándo añadiremos soporte para el muestreo (downsampling). Aquí hay varios problemas. En primer lugar, cada usuario entiende por downsampling algo diferente: algunos quieren obtener cualquier punto arbitrario en un intervalo determinado, otros desean valores máximos, mínimos o promedios. Si en su base escriben datos muchos sistemas, no se pueden agrupar todos de la misma manera. Puede suceder que para cada sistema se necesite utilizar un muestreo diferente. Y eso es complicado de implementar.
Y segundo, es que VictoriaMetrics, al igual que ClickHouse, está optimizada para trabajar con grandes volúmenes de datos en bruto, por lo que puede procesar mil millones de filas en menos de un segundo, si tiene muchos núcleos en su sistema. El escaneo de puntos de una serie temporal en VictoriaMetrics es de 50,000,000 de puntos por segundo por núcleo. Y este rendimiento se escala en los núcleos disponibles. Es decir, si tiene 20 núcleos, por ejemplo, puede escanear mil millones de puntos por segundo. Y esta característica de VictoriaMetrics y ClickHouse reduce la necesidad de muestreo.
Otra propiedad es que VictoriaMetrics comprime los datos de manera efectiva. La compresión, en promedio, en producción es de 0.4 a 0.8 bytes por punto. Cada punto es un timestamp + valor. Y se comprime en menos de un byte en promedio.
Sergiy. Tengo una pregunta. ¿Cuál es el mínimo intervalo de tiempo de registro?
Una milésima de segundo. Recientemente tuvimos una conversación con otros desarrolladores de bases de datos para series temporales. Su mínimo intervalo de tiempo es de un segundo. En Graphite, por ejemplo, también es un segundo. En OpenTSDB también es un segundo. En InfluxDB, la precisión es de nanosegundos. En VictoriaMetrics, es de una milésima de segundo, porque en Prometheus es de una milésima de segundo. Y VictoriaMetrics se desarrolló inicialmente como almacenamiento remoto para Prometheus. Pero ahora puede almacenar datos de otros sistemas.
La persona con la que hablé dice que ellos tienen precisión de un segundo — eso les basta, porque depende del tipo de datos que se guardan en la base de datos de series temporales. Si son datos de DevOps o datos de infraestructura, donde se recogen a intervalos de 30 segundos o un minuto, entonces la precisión de un segundo es suficiente, no necesitan menos. Pero si recoge estos datos de sistemas de trading de alta frecuencia, entonces se necesita precisión de nanosegundos.
La precisión en milisegundos de VictoriaMetrics es adecuada tanto para casos de DevOps como para la mayoría de los casos que mencioné al principio de la presentación. La única excepción podría ser para sistemas de trading de alta frecuencia.
¡Gracias! Y otra pregunta. ¿Cuál es la compatibilidad en PromQL?
Compatibilidad total. VictoriaMetrics ofrece soporte completo para PromQL. Además, agrega una funcionalidad extendida adicional a PromQL, que se llama . En relación a esta funcionalidad extendida, hay una presentación en YouTube. Hablé en el Monitoring Meetup que se llevó a cabo en primavera en San Petersburgo.
Canal de Telegram .
Solo los usuarios registrados pueden participar en la encuesta. , por favor.
¿Qué te impide migrar a VictoriaMetrics como almacenamiento a largo plazo para Prometheus? (Escribe en los comentarios, lo agregaré a la encuesta))
71,4%No utilizo Prometheus5
28,6%No sabía sobre VictoriaMetrics2
7 usuarios votaron. 12 usuarios se abstuvieron.
Fuente: habr.com
