

Examinaremos el funcionamiento de Zabbix con la base de datos TimescaleDB como backend. Mostraremos cómo ponerlo en marcha desde cero y cómo migrar desde PostgreSQL. También presentaremos pruebas comparativas de rendimiento de dos configuraciones.
HighLoad++ Siberia 2019. Sala "Tomsk". 24 de junio, 16:00. Resúmenes y . La próxima conferencia de HighLoad++ se llevará a cabo el 6 y 7 de abril de 2020 en San Petersburgo. Detalles y entradas .
Andrey Gushchin (en adelante – AG): – Soy ingeniero de soporte técnico de ZABBIX (en adelante – "Zabbix"), capacitador. He trabajado más de 6 años en soporte técnico y he enfrentado directamente cuestiones de rendimiento. Hoy hablaré sobre el rendimiento que puede ofrecer TimescaleDB en comparación con el tradicional PostgreSQL 10. También habrá una parte introductoria sobre cómo funciona en general.
Los principales desafíos de rendimiento: desde la recolección hasta la limpieza de datos
Comenzaremos por señalar que hay ciertos desafíos de rendimiento que enfrenta cada sistema de monitoreo. El primer desafío de rendimiento es la rápida recolección y procesamiento de datos.
Un buen sistema de monitoreo debe recibir todos los datos de manera rápida y oportuna, procesarlos según expresiones de activación, es decir, procesarlos según ciertos criterios (que varían en diferentes sistemas) y almacenarlos en la base de datos para que esos datos puedan ser utilizados más adelante.
El segundo desafío de rendimiento es el almacenamiento de la historia. Almacenar en la base de datos y tener un acceso rápido y conveniente a estas métricas que se han recopilado durante un cierto período de tiempo. Lo más importante es que esos datos sean accesibles y utilizables en informes, gráficos, activaciones, valores umbrales, alertas, etc.
La tercera llamada de rendimiento es la limpieza de la historia, es decir, cuando llega un día en que no necesitas almacenar métricas detalladas que se han recopilado durante 5 años (incluso meses o dos meses). Algunos nodos de la red han sido eliminados, o algunos hosts, las métricas ya no son necesarias porque se han vuelto obsoletas y han dejado de ser recopiladas. Todo esto debe ser limpiado para que tu base de datos no crezca demasiado. De hecho, la limpieza de la historia suele ser una prueba seria para el almacenamiento, ya que a menudo afecta mucho al rendimiento.
¿Cómo resolver problemas de caché?
Ahora voy a hablar específicamente sobre 'Zabbix'. En 'Zabbix', la primera y segunda llamadas se resuelven mediante el uso de caché.
La recolección y el procesamiento de datos: utilizamos la memoria RAM para almacenar todos esos datos. Ahora se hablará con más detalle sobre estos datos.
Además, del lado de la base de datos hay un cierto tipo de caché para las consultas principales: para gráficos y otras cosas.
Caché en el propio servidor de Zabbix: tenemos ConfigurationCache, ValueCache, HistoryCache, TrendsCache. ¿Qué son?
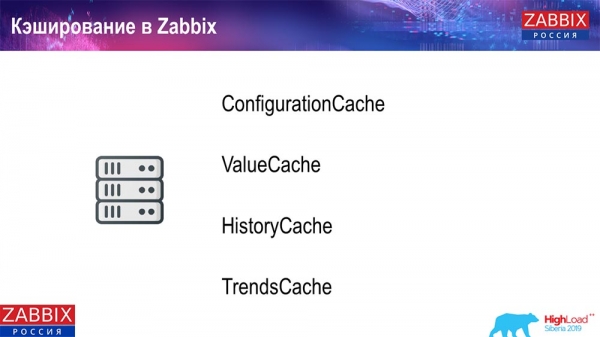
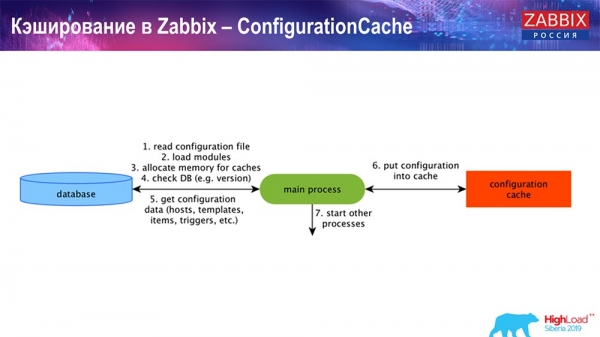
ConfigurationCache es la caché principal, en la que almacenamos métricas, hosts, elementos de datos, disparadores; todo lo que se necesita para el procesamiento previo, recolección de datos, de qué hosts recolectar, con qué frecuencia. Todo esto se almacena en ConfigurationCache para no ir a la base de datos, no crear solicitudes innecesarias. Después de iniciar el servidor, actualizamos esta caché (la creamos) y la actualizamos periódicamente (dependiendo de la configuración).
Caché en Zabbix. Recolección de datos
Aquí el esquema es bastante grande:
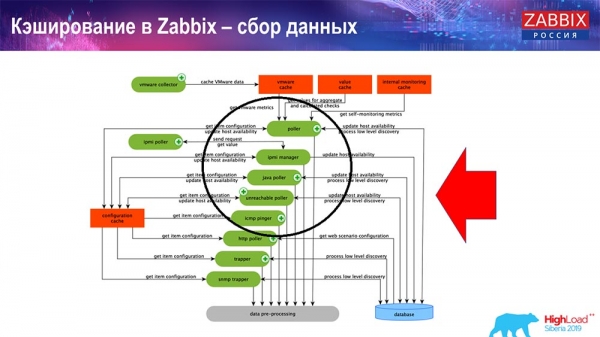
Los principales en el esquema son estos recolectores:
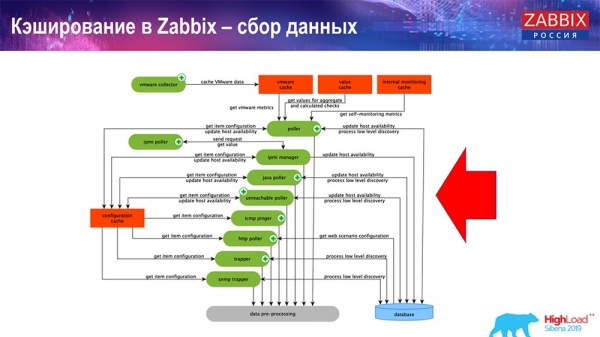
Son los propios procesos de recolección, varios 'pollers', que se encargan de diferentes tipos de recolección. Recolectan datos a través de icmp, ipmi, diferentes protocolos y transmiten todo esto para el procesamiento previo.
PreProcessing HistoryCache
Además, si tenemos elementos de datos calculados (quien esté familiarizado con 'Zabbix' lo sabe), es decir, elementos de datos calculados y agregados, los recuperamos directamente de ValueCache. Más adelante hablaré sobre cómo se llena. Todos estos recolectores utilizan ConfigurationCache para obtener sus tareas y luego las transmiten para el procesamiento previo.
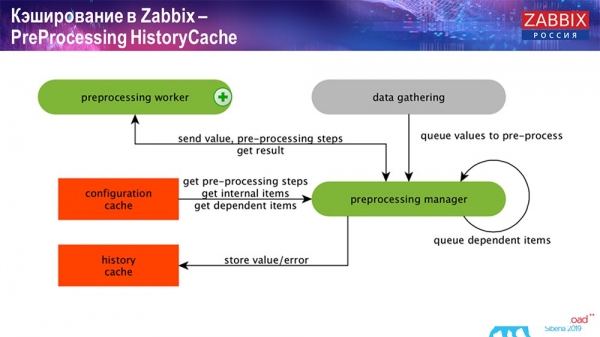
El preprocesamiento también utiliza ConfigurationCache para obtener los pasos de preprocesamiento, procesando estos datos de diversas maneras. A partir de la versión 4.2, se ha trasladado a un proxy. Esto es muy conveniente, ya que el preprocesamiento en sí es una operación bastante pesada. Y si tienes un 'Zabbix' muy grande, con muchos elementos de datos y una alta frecuencia de recopilación, esto facilita mucho el trabajo.
Por lo tanto, después de procesar estos datos de alguna manera mediante el preprocesamiento, los guardamos en HistoryCache para su posterior procesamiento. Aquí termina la recopilación de datos. Pasamos al proceso principal.
Trabajo de History syncer
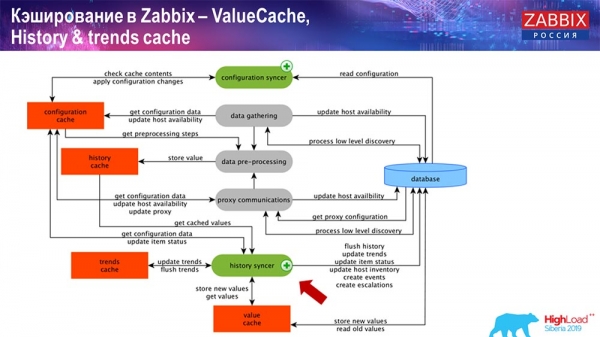
El proceso principal en 'Zabbix' (dado que es una arquitectura monolítica) es el History syncer. Este es el proceso principal que se encarga de la procesamiento atómico de cada elemento de datos, es decir, de cada valor:
- recibe un valor (lo toma de HistoryCache);
- verifica en Configuration syncer: si hay algún disparador para calcular — los calcula;
si hay — crea eventos, crea una escalación para generar una notificación, si es necesario según la configuración; - registra los disparadores para su posterior procesamiento, agregación; si agregas durante la última hora y así sucesivamente, este valor lo guarda en ValueCache, para no tener que consultar la tabla de historia; de este modo, ValueCache se llena con los datos necesarios para calcular los disparadores, los elementos calculados, etc.;
- a continuación, el History syncer graba todos los datos en la base de datos;
- la base de datos los escribe en el disco - aquí termina el proceso de procesamiento.
Bases de datos. Caché
Del lado de la base de datos, cuando deseas ver gráficos o algunos informes sobre eventos, hay varios cachés. Pero en el marco de esta presentación, no voy a hablar de ellos.
Para MySQL hay Innodb_buffer_pool, y muchos otros cachés que también se pueden configurar.
Pero estos son los principales:
- shared_buffers;
- effective_cache_size;
- shared_pool.
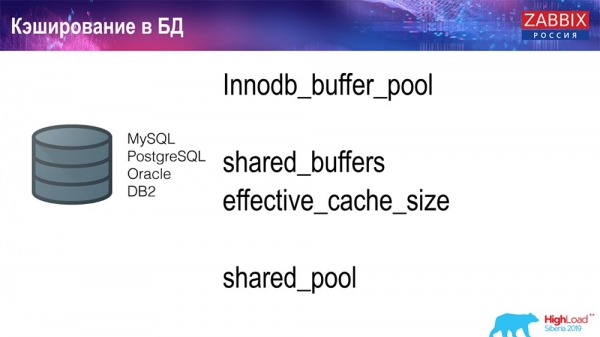
He mencionado para todas las bases de datos que hay cachés específicos que permiten mantener en memoria RAM aquellos datos que son frecuentemente necesarios para consultas. Tienen sus propias tecnologías para esto.
Sobre el rendimiento de la base de datos
Por lo tanto, hay un entorno competitivo, es decir, el servidor Zabbix recopila datos y los registra. Al reiniciarse, también lee de la historia para llenar el ValueCache, entre otras cosas. Aquí también pueden haber scripts e informes que utilizan la API de Zabbix, que se basa en una interfaz web. La API de Zabbix accede a la base de datos y obtiene los datos necesarios para generar gráficos, informes o alguna lista de eventos, las últimas incidencias.
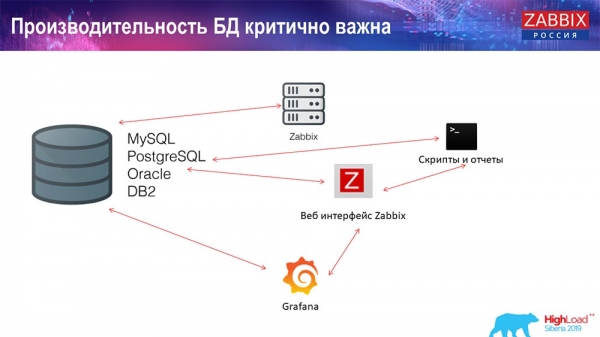
Otra solución muy popular para la visualización es Grafana, que utilizan nuestros usuarios. Puede acceder directamente tanto a través de la API de Zabbix como de la base de datos. Esto también genera una cierta competencia para la obtención de datos: se requiere una configuración más refinada y adecuada de la base de datos para garantizar una rápida entrega de resultados y pruebas.
Limpieza de historial. En Zabbix hay un Housekeeper.
La tercera llamada que se utiliza en Zabbix es la limpieza del historial mediante el Housekeeper. El 'Housekeeper' respeta todas las configuraciones, es decir, en nuestros elementos de datos se indica cuánto almacenar (en días), cuánto almacenar como tendencias, y la dinámica de los cambios.
No he mencionado el TrendCache, que calculamos en tiempo real: llegan los datos, los agregamos durante una hora (principalmente son números del último hora), el promedio / mínimo, y lo registramos una vez por hora en la tabla de dinámica de cambios ('Trends'). El 'Housekeeper' se ejecuta y elimina los datos de la base de datos mediante selects, lo que no siempre es eficiente.
¿Cómo saber que esto no es eficiente? En los gráficos de rendimiento de los procesos internos, puedes ver la siguiente situación:
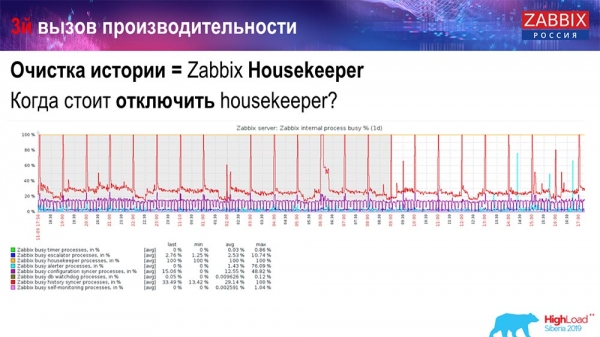
Tu History syncer está constantemente ocupado (gráfico rojo). Y el gráfico en 'naranja' que va por encima. Este es el 'Housekeeper', que se ejecuta y espera a que la base de datos elimine todas las filas que ha señalado.
Tomemos algún Item ID: necesitas eliminar las últimas 5 mil; claro, por índices. Pero normalmente el conjunto de datos es lo suficientemente grande: la base de datos de todos modos lo lee del disco y lo sube a la caché, y esa es una operación muy costosa para la base de datos. Dependiendo de su tamaño, esto puede llevar a ciertos problemas de rendimiento.
Desactivar 'Housekeeper' se puede hacer de manera sencilla: tenemos la interfaz web que todos conocemos. En la configuración de Administration general (ajustes para 'Housekeeper'), desactivamos el housekeeping interno para el historial y las tendencias internas. Por lo tanto, 'Housekeeper' ya no gestiona esto:
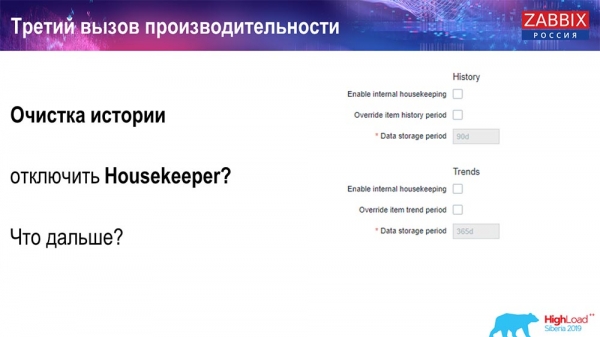
¿Qué se puede hacer a continuación? Has desactivado, tus gráficos se han alineado... ¿Cuáles podrían ser los problemas que surjan después? ¿Qué puede ayudar?
Particionamiento (seccionamiento)
Generalmente, esto se configura en cada base de datos relacional de las que he mencionado, de diferentes maneras. MySQL tiene su propia tecnología. Pero, en general, son muy similares si hablamos de PostgreSQL 10 y MySQL. Por supuesto, hay muchas diferencias internas sobre cómo se implementa todo esto y cómo afecta al rendimiento. Sin embargo, en general, la creación de una nueva partición a menudo también conduce a ciertos problemas.
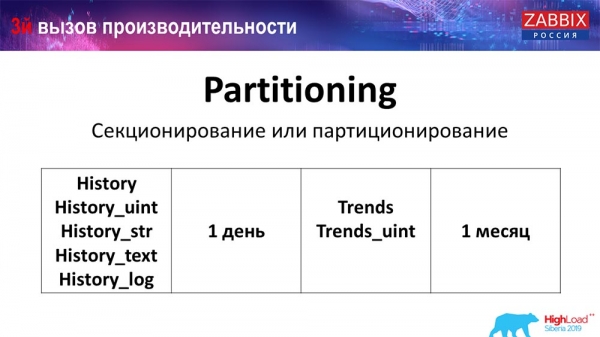
Dependiendo de tu configuración (cuántos datos se generan en un día), generalmente se establece el mínimo: 1 día/partición, y para 'tendencias', dinámica de cambios: 1 mes/nueva partición. Esto puede cambiar si tienes una configuración muy grande.
Primero, hablemos de los tamaños de la configuración: hasta 5,000 nuevos valores por segundo (nvps, así llamado) se considera una 'configuración' pequeña. Media: de 5 a 25 mil valores por segundo. Todo lo que supere esto ya son instalaciones grandes y muy grandes, que requieren una configuración muy cuidadosa de la base de datos.
En instalaciones muy grandes, 1 día puede no ser óptimo. Personalmente he visto en MySQL particiones de 40 gigabytes por día (y pueden ser más). Este es un volumen de datos muy grande que puede causar algunos problemas. Debe reducirse.
¿Por qué se necesita el particionamiento?
Lo que aporta el particionamiento, creo que todos lo sabemos: es la seccionamiento de tablas. A menudo son archivos separados en el disco y consultas de span. Selecciona de manera más óptima una partición, si está dentro del particionamiento habitual.
Para «Zabbix», en particular, se utiliza por rango, es decir, usamos timestamp (un número común, tiempo desde el inicio de la época). Usted establece el inicio del día / fin del día, y esto constituye la partición. Por lo tanto, si solicita datos de hace dos días, todo esto se selecciona de la base de datos más rápido porque solo se necesita cargar un archivo en la caché y emitirlo (y no una tabla grande).
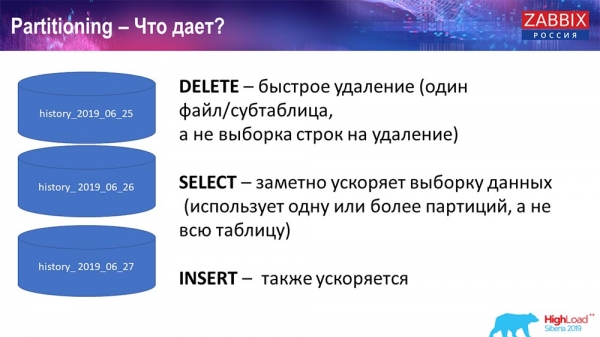
Muchas bases de datos también aceleran la inserción (inserción en una tabla hijo). Estoy hablando de manera abstracta, pero también es posible. La partición a menudo ayuda.
Elasticsearch para NoSQL
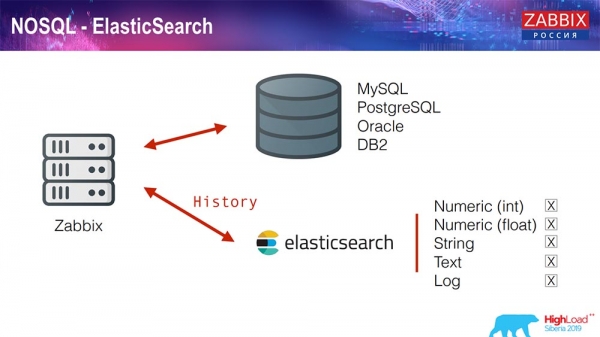
Recientemente, en la versión 3.4, implementamos una solución para NoSQL. Agregamos la capacidad de escribir en Elasticsearch. Puede escribir ciertos tipos: elige – o escribes números, o ciertos caracteres; tenemos texto en cadena, registros puede escribir en Elasticsearch... Por lo tanto, la interfaz web también tendrá que dirigirse a Elasticsearch. Esto funciona excelentemente en algunos casos, pero en este momento se puede utilizar.
TimescaleDB. Hiper-tablas
Para la versión 4.4.2, notamos una cosa, como TimescaleDB. ¿Qué es esto? Es una extensión para «Postgres», es decir, tiene una interfaz nativa de PostgreSQL. Además, esta extensión permite trabajar de manera mucho más eficiente con datos de series temporales y tener particionamiento automático. Así es como se ve:
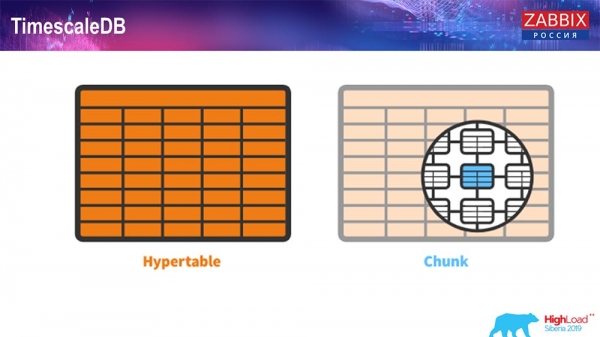
Esta es una hypertable – hay tal concepto en Timescale. Es una hiper-tabla que creas, y en ella hay chunks (fragmentos). Los chunks son particiones, son tablas hijo, si no me equivoco. Esto es realmente eficiente.
TimescaleDB y PostgreSQL
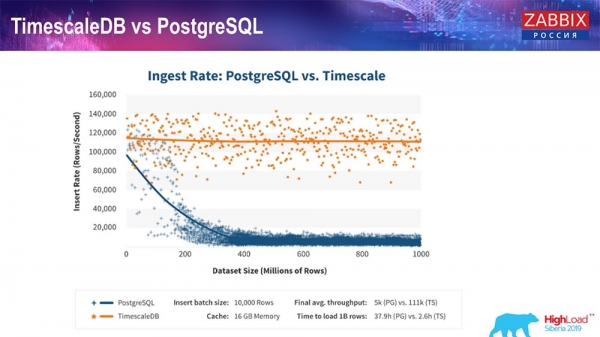
Como aseguran los productores de TimescaleDB, utilizan un algoritmo más correcto de procesamiento de consultas, en particular de inserciones, que permite tener un rendimiento prácticamente constante al aumentar el tamaño del conjunto de datos de inserción. Es decir, después de 200 millones de filas, PostgreSQL normal comienza a bajar mucho el rendimiento y pierde productividad casi hasta cero, mientras que «Timescale» permite insertar las inserciones de la manera más eficiente posible con cualquier cantidad de datos.
¿Cómo instalar TimescaleDB? ¡Es muy sencillo!
En su documentación se describe – se puede instalar desde paquetes para cualquier... Depende de los paquetes oficiales de «Postgres». Se puede compilar manualmente. Así sucedió que tuve que compilar para la base de datos.
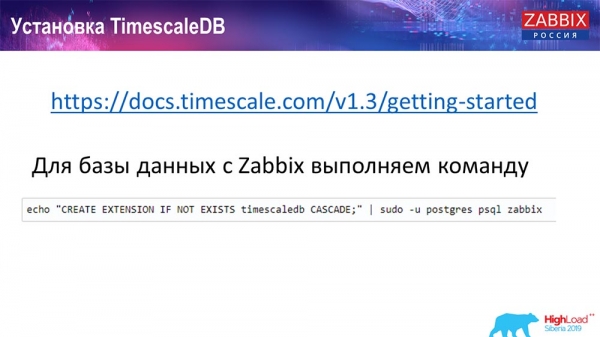
En "Zabbix" simplemente activamos la Extensión. Creo que aquellos que han usado la Extensión en "Postgres"… Solo activas la Extensión y la creas para la base de datos "Zabbix" que estás utilizando.
Y el último paso…
TimescaleDB. Migración de tablas históricas
Necesitas crear un hypertable. Para esto hay una función especial: Create hypertable. En ella, el primer parámetro es la tabla que necesitas en esta base de datos (para la cual necesitas crear el hypertable).
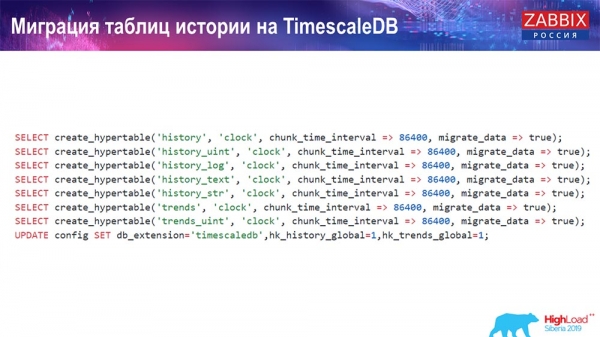
El campo por el que necesitas crear, y chunk_time_interval (este es el intervalo de los chunks (particiones que se deben utilizar). 86 400 es un día.
El parámetro migrate_data: si lo estableces en true, trasladará todos los datos actuales a los chunks creados previamente.
Yo mismo utilicé migrate_data; esto toma un tiempo considerable, dependiendo del tamaño de tu base de datos. Tenía más de un terabyte; la creación tomó más de una hora. En algunos casos, al probar, eliminé datos históricos para texto (history_text) y cadena (history_str), para no trasladarlos; en realidad no me interesaban.
Y la última actualización la hacemos en nuestro db_extension: instalamos timescaledb para que la base de datos y, en particular, nuestro "Zabbix", comprendan que hay db_extension. Lo activa y utiliza correctamente la sintaxis y las consultas a la base de datos, aprovechando ya esas "funciones" que son necesarias para TimescaleDB.
Configuración del servidor
Utilicé dos servidores. El primer servidor es una máquina virtual bastante pequeña, con 20 procesadores y 16 gigabytes de RAM. La configuré con "Postgres" 10.8:
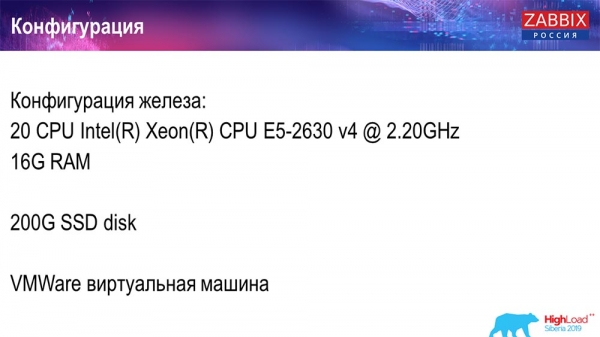
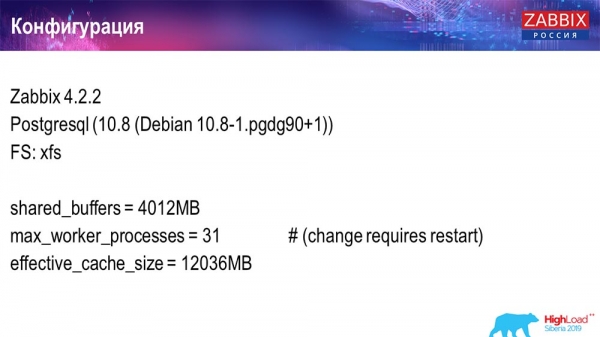
El sistema operativo era Debian, el sistema de archivos – xfs. Realicé configuraciones mínimas para utilizar exactamente esta base de datos, sin contar lo que Zabbix utilizará. En esta misma máquina estaba el servidor de Zabbix, PostgreSQL y los agentes de carga.
Utilicé 50 agentes activos que utilizan LoadableModule para generar rápidamente diversos resultados. Ellos generaban cadenas, números y así sucesivamente. Llené la base de datos con una gran cantidad de datos. Inicialmente, la configuración contenía 5 mil elementos de datos por cada host, y aproximadamente cada elemento de datos contenía un trigger, para que fuera una configuración real. A veces, incluso se requiere más de un trigger.
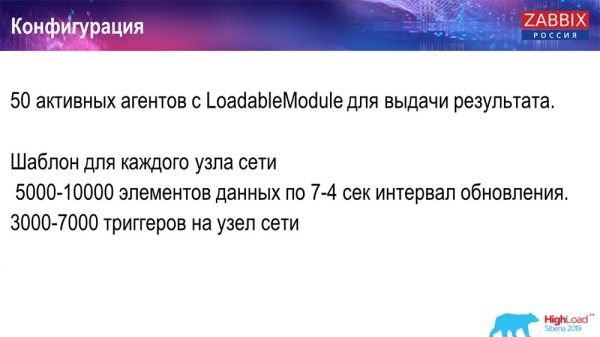
El intervalo de actualización, la carga la regulé no solo utilizando 50 agentes (agregué más), sino también con elementos dinámicos de datos y reduje el intervalo de actualización a 4 segundos.
Prueba de rendimiento. PostgreSQL: 36 mil NVPs
El primer lanzamiento, la primera configuración la hice en PostgreSQL 10 limpio en este hardware (35 mil valores por segundo). En general, como se puede ver en la pantalla, la inserción de datos toma fracciones de segundo: todo bien y rápido, discos SSD (200 gigabytes). Lo único es que 20 GB se llenan bastante rápido.
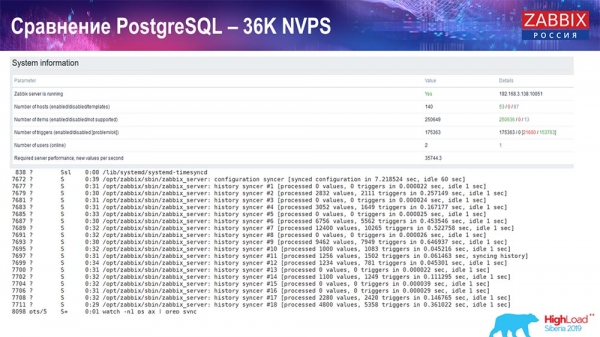
Habrá muchos gráficos como este más adelante. Este es el panel de rendimiento estándar del servidor 'Zabbix'.
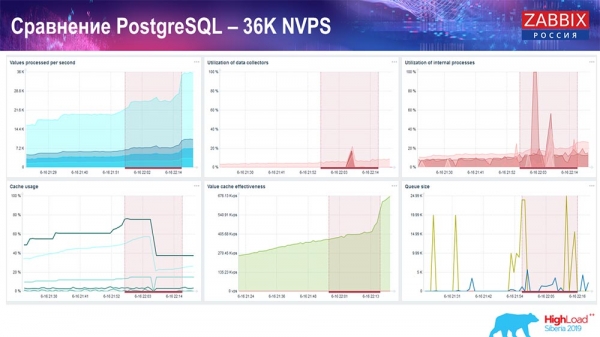
El primer gráfico muestra la cantidad de valores por segundo (azul, en la parte superior izquierda), 35 mil valores en este caso. Esto (en la parte superior del centro) es la carga de los procesos de recopilación, y esto (en la parte superior derecha) es la carga de los procesos internos: history syncers y housekeeper, que aquí (en la parte inferior del centro) se ejecutó durante un tiempo considerable.
Este gráfico (en la parte inferior del centro) muestra el uso de ValueCache: cuántos hits de ValueCache para los triggers (varios miles de valores por segundo). Otro gráfico importante es el cuarto (en la parte inferior izquierda), que muestra el uso de HistoryCache, del que hablé, que es un buffer antes de la inserción en la base de datos.
Prueba de rendimiento. PostgreSQL: 50 mil NVPs
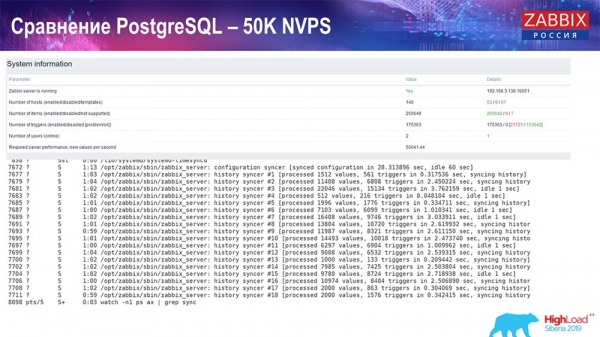
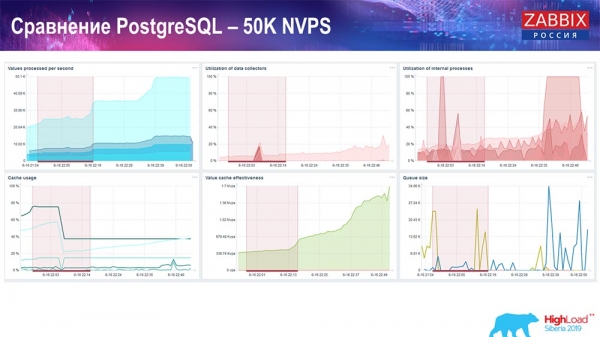
Luego aumenté la carga a 50 mil valores por segundo en este mismo hardware. Al cargar con 'Housekeeper', ya se registraban 10 mil valores en 2-3 segundos con el cálculo. Lo que, de hecho, se muestra en la siguiente captura de pantalla:
'Housekeeper' ya empieza a interferir con el trabajo, pero en general la carga de los trappers de los history syncers aún permanece en el nivel del 60 % (tercer gráfico, en la parte superior derecha). HistoryCache ya durante la operación de 'Housekeeper' comienza a llenarse activamente (en la parte inferior izquierda). Era alrededor de medio gigabyte, y se llenó en un 20 %.
Prueba de rendimiento. PostgreSQL: 80 mil NVPs
Luego aumenté a 80 mil valores por segundo:
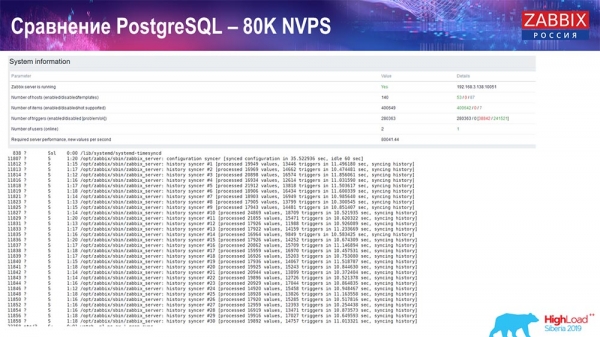
Había aproximadamente 400 mil elementos de datos, 280 mil disparadores. La carga, como pueden ver, por la carga de los history-syncers (había 30 en total) ya era bastante alta. Luego aumenté varios parámetros: history-syncers, caché… En este hardware, la carga de los history-syncers comenzó a aumentar al máximo, prácticamente "en su límite" – de acuerdo, HistoryCache estaba bajo una carga muy alta:
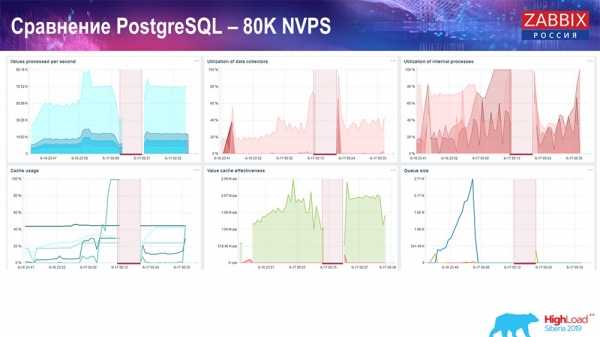
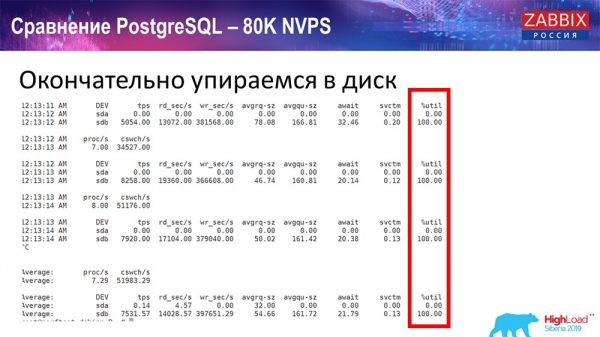
Durante todo este tiempo, observé todos los parámetros del sistema (cómo se utilizaba la CPU, la memoria RAM) y descubrí que la utilización de los discos era máxima: había alcanzado la capacidad máxima de ese disco en este hardware, en esta máquina virtual. PostgreSQL comenzó, con esa intensidad, a descargar datos de manera bastante activa, y el disco ya no podía mantenerse al ritmo de escritura, lectura…
Tomé otro servidor que ya tenía 48 procesadores y 128 gigabytes de RAM:
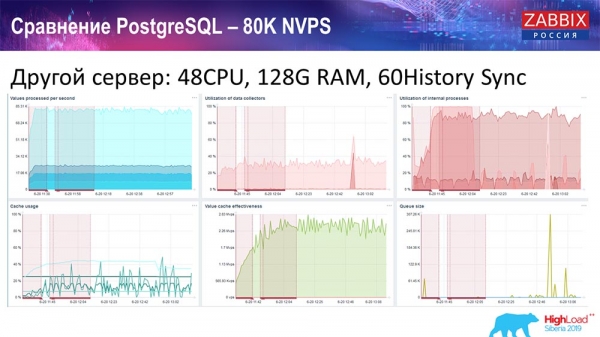
También lo "optimicé" - instalé 60 history syncers y logré un rendimiento aceptable. De hecho, no estamos "en su límite", pero este es, probablemente, el máximo rendimiento donde ya es necesario tomar medidas.
Prueba de rendimiento. TimescaleDB: 80 mil NVPs
Tenía una tarea principal: usar TimescaleDB. En cada gráfico se puede ver una caída:
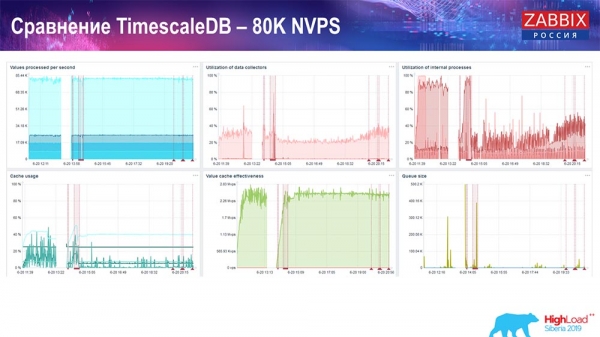
Estas caídas son precisamente la migración de datos. Después de eso, en el servidor de Zabbix, el perfil de carga de los history-syncers, como pueden ver, cambió drásticamente. Permite insertar datos casi 3 veces más rápido y utilizar menos HistoryCache – por lo tanto, los datos se suministrarán a tiempo. Nuevamente, 80 mil valores por segundo – es una tasa bastante alta (por supuesto, no para Yandex). En general, es un set up bastante grande, con un solo servidor.
Prueba de rendimiento de PostgreSQL: 120 mil NVPs
Luego incrementé el número de elementos de datos a medio millón y obtuve un valor calculado de 125 mil por segundo:
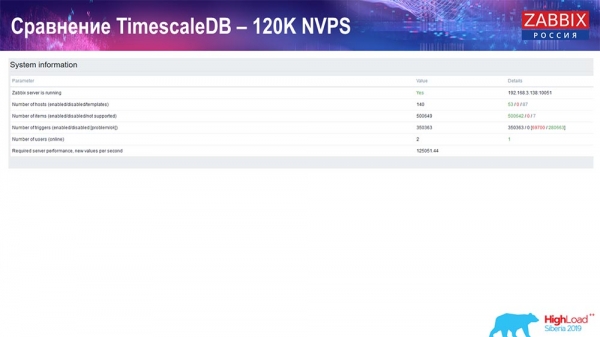
Y obtuve estos gráficos:
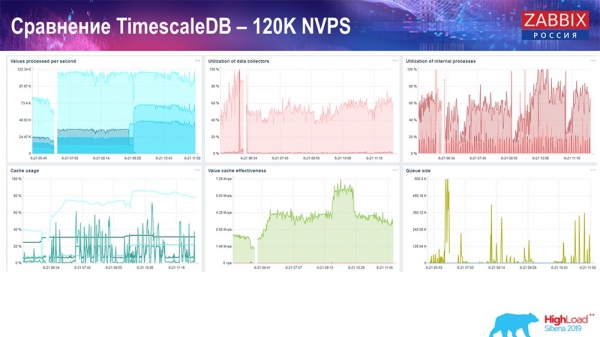
En principio, es un set up funcional, puede operar durante un período bastante prolongado. Pero como solo tenía un disco de 1.5 terabytes, lo consumí en un par de días. Lo más importante es que al mismo tiempo se estaban creando nuevas particiones en TimescaleDB, y eso para el rendimiento pasaba absolutamente desapercibido, lo que no se puede decir de MySQL.
Normalmente, las particiones se crean por la noche, ya que esto bloquea cualquier inserción y operación con tablas, lo que puede llevar a una degradación del servicio. ¡En este caso, esto no ha ocurrido! La tarea principal era verificar las capacidades de TimescaleDB. Se obtuvo una cifra de 120 mil valores por segundo.
También hay ejemplos en la «comunidad»:
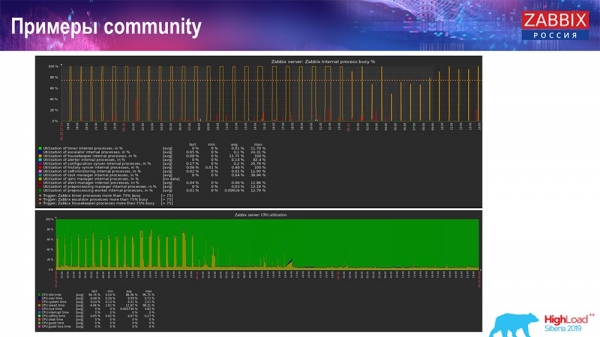
Una persona también activó TimescaleDB y la carga por uso de io.weight disminuyó en el procesador; y el uso de los elementos de los procesos internos también se redujo gracias a la activación de TimescaleDB. ¡Y son discos duros normales, es decir, una máquina virtual en discos normales (no SSD)!
Para algunas configuraciones pequeñas que están limitadas por el rendimiento del disco, TimescaleDB, en mi opinión, es una muy buena solución. Esto permitirá continuar operando hasta que migres a hardware más rápido para la base de datos.
Los invito a todos a nuestros eventos: Conferencia – en Moscú, Cumbre – en Riga. Utilicen nuestros canales: «Telegram», foro, IRC. Si tienen alguna pregunta, acérquense a nuestro stand, podemos hablar de todo.
Preguntas de la audiencia
Pregunta de la audiencia (en adelante – A): – Si TimescaleDB es tan fácil de configurar y proporciona un aumento tan grande en el rendimiento, ¿quizás debería utilizarse como mejor práctica para la configuración de «Zabbix» con «Postgres»? ¿Y hay alguna trampa o desventajas en esta solución, o en realidad, si decidí hacer «Zabbix», puedo simplemente usar «Postgres», instalar «Timescale» de inmediato, usarlo y no preocuparme por ningún problema?
AG: – Sí, diría que es una buena recomendación: usar «Postgres» desde el principio con la extensión TimescaleDB. Como ya dije, hay muchas buenas opiniones, a pesar de que esta «función» es experimental. Pero en realidad, las pruebas muestran que es una excelente solución (con TimescaleDB), y creo que seguirá desarrollándose. Estamos siguiendo cómo se desarrolla esta extensión y corregiremos lo que sea necesario.
Incluso durante el desarrollo nos basamos en una de sus conocidas «funciones»: allí se podía trabajar un poco diferente con los chunks. Pero luego lo eliminaron en la siguiente versión, y tuvimos que dejar de depender de ese código. Recomendaría usar esta solución en muchas configuraciones. Si usas MySQL… Para configuraciones medias, cualquier solución funciona bastante bien.
A: – En los últimos gráficos de la comunidad, había un gráfico con "Housekeeper":
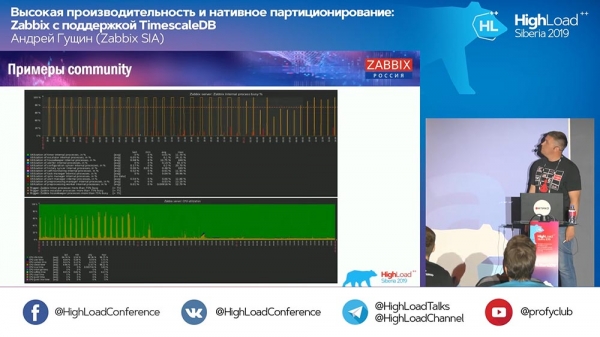
Siguió funcionando. ¿Qué hace "Housekeeper" en el caso de TimescaleDB?
AG: – Ahora no puedo decirlo con certeza; revisaré el código y lo diré con más detalle. Utiliza consultas de TimescaleDB no para eliminar chunks, sino que de alguna manera agrega. Por ahora, no estoy listo para responder a esta pregunta técnica. En el stand lo aclararemos hoy o mañana.
A: – Tengo una pregunta similar: sobre el rendimiento de la operación de eliminación en "Timescale".
Y (respuesta de la audiencia): – Cuando eliminas datos de una tabla, si lo haces a través de delete, necesitas recorrer la tabla: eliminar, limpiar, marcar todo para el futuro vacuum. En "Timescale", dado que tienes chunks, puedes eliminarlos. En términos simples, le estás diciendo al archivo que está en big data: "¡Elimina!"
"Timescale" simplemente entiende que ese chunk ya no existe. Y como se integra en el planificador de consultas, detecta tus condiciones en el select o en otras operaciones y entiende de inmediato que ese chunk ya no existe – "¡No iré allí!" (los datos están ausentes). ¡Eso es todo! Es decir, el escaneo de la tabla se reemplaza por la eliminación de un archivo binario, por lo que es rápido.
A: – Ya se tocó el tema de no SQL. Según tengo entendido, "Zabbix" no necesita mucho modificar datos, y todo esto es algo así como un registro. ¿Se pueden usar bases de datos especializadas que no pueden cambiar sus datos, pero que, sin embargo, guardan, acumulan y regresan mucho más rápido – como Clickhouse, o algo tipo Kafka...? ¡Kafka también es un registro! ¿Se pueden integrar de alguna manera?
AG: – Se puede hacer una exportación. Tenemos una característica específica desde la versión 3.4: puedes escribir en archivos todos los archivos históricos, eventos, todo lo demás; y después, con algún procesador, enviarlo a cualquier otra base de datos. De hecho, muchos están rehaciendo y escribiendo directamente en la base de datos. Los history-sinkers lo escriben en archivos sobre la marcha, rotan esos archivos, etc., y puedes transferirlo a "Clickhouse". No puedo hablar sobre planes, pero quizás el soporte futuro para soluciones NoSQL (como "Clickhouse") continúe.
A: – Entonces, ¿es posible deshacerse completamente de Postgres?
AG: – Por supuesto, la parte más difícil de «Zabbix» son las tablas históricas, que crean más problemas, y los eventos. En este caso, si no almacenas los eventos durante mucho tiempo y guardas la historia con tendencias en algún otro almacenamiento rápido, en general no debería haber problemas, creo yo.
A: – ¿Puedes estimar cuánto más rápido funcionará todo si cambiamos a «ClickHouse», por ejemplo?
AG: – No he probado. Creo que al menos se podrían alcanzar las mismas cifras bastante fácilmente, considerando que «ClickHouse» tiene su propia interfaz, pero no puedo decirlo con seguridad. Lo mejor es probar. Todo depende de la configuración: cuántos hosts tienes, etc. La inserción es una cosa, pero también necesitas obtener esos datos, ya sea con Grafana o alguna otra herramienta.
A: – Entonces se trata de una competencia equitativa, no de una gran ventaja de estas bases de datos rápidas?
AG: – Creo que cuando integremos, tendremos pruebas más precisas.
A: – ¿Y qué pasó con el viejo y querido RRD? ¿Qué te llevó a cambiar a bases de datos SQL? Inicialmente, todas las métricas se recopilaban en RRD.
AG: – En «Zabbix», RRD puede haber existido en una versión muy antigua. Siempre han existido bases de datos SQL: el enfoque clásico. El enfoque clásico es MySQL, PostgreSQL (que ya existen desde hace mucho tiempo). Tenemos una interfaz común para bases de datos SQL y casi nunca hemos utilizado RRD.

Un poco de publicidad 🙂
Gracias por permanecer con nosotros. ¿Te gustan nuestros artículos? ¿Quieres ver más contenido interesante? Apóyanos haciendo un pedido o recomendando a tus conocidos, , un análogo único de servidores entry-level que hemos diseñado para Ti: (disponibles opciones con RAID1 y RAID10, hasta 24 núcleos y hasta 40GB DDR4).
¿Dell R730xd a mitad de precio en el centro de datos Equinix Tier IV en Ámsterdam? Solo aquí ¡en los Países Bajos! Dell R420 — 2x E5-2430 2.2Ghz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — ¡desde $99! Lee sobre cómo
Fuente: habr.com
