

La próxima conferencia HighLoad++ se llevará a cabo el 6 y 7 de abril de 2020 en San Petersburgo. Detalles y entradas. . HighLoad++ Moscú 2018. Sala «Moscú». 9 de noviembre, 15:00. Tesís y .
* Monitoreo — en línea y analítica.
* Principales limitaciones de la plataforma ZABBIX.
* Solución para escalar el almacenamiento de análisis.
* Optimización del servidor ZABBIX.
* Optimización de la interfaz de usuario.
* Experiencia operativa del sistema bajo cargas superiores a 40k NVPS.
* Resumen breve.
Mikhail Makurov (en adelante – MM): – ¡Hola a todos!
Maxim Chernetsov (en adelante – MC): – ¡Buenos días!
MM: – Permítanme presentar a Maxim. Max es un ingeniero talentoso, el mejor especialista en redes que conozco. Maxim se encarga de las redes y servicios, su desarrollo y operación.
MC: – Y me gustaría hablar de Mikhail. Mikhail es un desarrollador en C. Ha escrito varias soluciones de alto rendimiento para el procesamiento de tráfico para nuestra empresa. Vivimos y trabajamos en los Urales, en la ciudad de hombres duros, Cheliábinsk, en la empresa ‘Intersvyaz’. Nuestra empresa es un proveedor de servicios de internet y televisión por cable para un millón de personas en 16 ciudades.
MM: – Y vale la pena decir que ‘Intersvyaz’ es mucho más que un simple proveedor; es una empresa de TI. La mayoría de nuestras soluciones son desarrolladas por nuestro departamento de TI.
A: desde servidores que procesan tráfico, hasta el centro de atención y la aplicación móvil. En el departamento de TI hay alrededor de 80 personas con competencias muy diversas.
Sobre Zabbix y su arquitectura
MC: – Ahora intentaré establecer un récord personal y explicar en un minuto qué es Zabbix (en adelante – ‘Zabbix’).
‘Zabbix’ se posiciona como un sistema de monitoreo ‘listo para usar’ a nivel empresarial. Tiene muchas funciones que simplifican la vida: reglas avanzadas de escalamiento, API para integración, agrupamiento y auto-descubrimiento de hosts y métricas. ‘Zabbix’ cuenta con lo que se denomina herramientas de escalabilidad – proxies. ‘Zabbix’ es un sistema de código abierto.
Breve descripción de la arquitectura. Se puede decir que está compuesta por tres componentes:
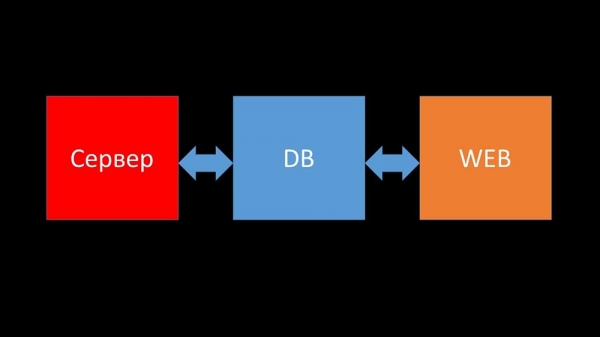
- Servidor. Escrito en C. Con un procesamiento y transferencia de información entre hilos bastante complejos. Todo el procesamiento ocurre allí: desde la recepción hasta el almacenamiento en la base de datos.
- Todos los datos se almacenan en la base de datos. ‘Zabbix’ soporta MySQL, PostgreSQL y Oracle.
- La interfaz web está escrita en PHP. En la mayoría de los sistemas, se suministra con el servidor Apache, pero funciona de manera más eficiente en combinación con nginx + php.
Hoy queremos contarles una historia de la vida de nuestra empresa relacionada con 'Zabbix'...
Historia de la vida de la empresa 'Intersvyaz'. ¿Qué tenemos y qué necesitamos?
Hace 5 o 6 meses. Una vez después del trabajo...
MC: – ¡Misha, hola! Me alegra haberte atrapado, tengo algo de qué hablar. Nuevamente tuvimos problemas con el monitoreo. Durante una gran emergencia, todo se ralentizaba y no había información sobre el estado de la red. Lamentablemente, esto ya ha ocurrido antes. Necesito tu ayuda. ¡Hagamos que nuestro monitoreo funcione en cualquier circunstancia!
MM: – Pero primero sincronizémonos. No he mirado eso en un par de años. Según recuerdo, abandonamos Nagios y pasamos a 'Zabbix' hace unos 8 años. Y ahora tenemos, parece, 6 servidores potentes y alrededor de una decena de proxies. ¿Estoy confundido?
MC: – Casi. 15 servidores, algunos de los cuales son máquinas virtuales. Lo más importante es que esto no nos salva en el momento en que más lo necesitamos. Cada vez que hay una emergencia, los servidores se ralentizan y no se ve nada. Hemos intentado optimizar la configuración, pero no proporciona una mejora de rendimiento óptima.
MM: – Entiendo. ¿Han revisado algo, han encontrado algo en el diagnóstico?
MC: – Lo primero con lo que tenemos que lidiar es con la base de datos. MySQL ya está constantemente cargado, almacenando nuevas métricas, y cuando 'Zabbix' comienza a generar un montón de eventos, la base literalmente se sumerge en sí misma durante varias horas. Ya te he hablado sobre la optimización de la configuración, pero este año actualizamos el hardware: los servidores tienen más de cien gigas de memoria y arreglos de discos en RAID SSD, no tiene sentido aumentar eso linealmente. ¿Qué haremos?
MM: – Entiendo. De hecho, MySQL es una base de datos LTP. Parece que ya no es adecuada para almacenar un archivo de métricas de nuestro tamaño. Vamos a averiguarlo.
MC: – ¡Vamos!
Integración de Zabbix y Clickhouse como resultado del hackathon.
Después de un tiempo, obtuvimos datos interesantes:
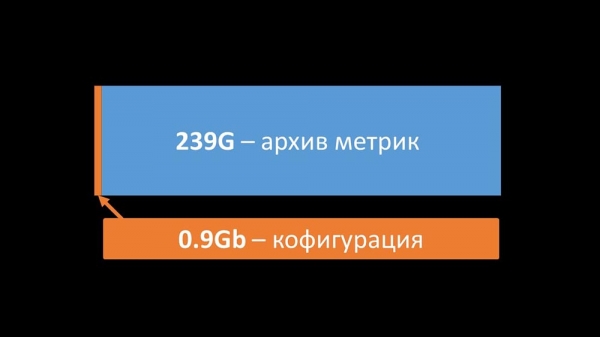
La mayor parte del espacio en nuestra base estaba ocupada por el archivo de métricas y menos del 1 % se utilizaba para configuraciones, plantillas y ajustes. Para ese momento, ya llevábamos más de un año utilizando una solución de Big Data basada en Clickhouse. La dirección a seguir era evidente para nosotros. En nuestro 'Hackathon' de primavera, escribí una integración de Zabbix con Clickhouse para el servidor y el frontend. En ese momento, Zabbix ya contaba con soporte para ElasticSearch, y decidimos compararlos.
Comparación entre Clickhouse y Elasticsearch
MM: Para la comparación, generamos una carga similar a la que proporcionaba el servidor Zabbix y observamos cómo se comportaban los sistemas. Escribíamos datos en bloques de 1000 filas, utilizando CURL. Suponíamos de antemano que Clickhouse sería más eficiente para el perfil de carga que genera Zabbix. Los resultados superaron nuestras expectativas:
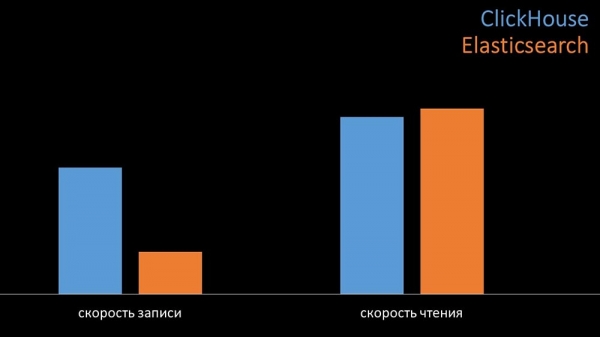
En condiciones idénticas, Clickhouse escribía tres veces más datos en las pruebas. Ambas sistemas consumían recursos de manera muy eficiente al leer datos. Sin embargo, ElasticSearch requería una cantidad considerable de CPU para escribir:
En resumen, Clickhouse superó con creces a ElasticSearch en consumo de CPU y velocidad. Gracias a la compresión de datos, Clickhouse utiliza 11 veces menos espacio en disco y realiza aproximadamente 30 veces menos operaciones de disco:
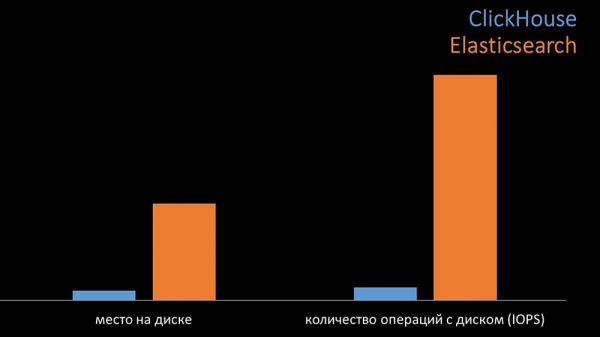
MC: Sí, la gestión del subsistema de disco en Clickhouse está implementada de manera muy eficiente. Se pueden utilizar enormes discos SATA para bases de datos y obtener velocidades de escritura de cientos de miles de filas por segundo. El sistema soporta sharding y replicación 'de caja', y es bastante fácil de configurar. Estamos más que satisfechos con su funcionamiento durante un año.
Para optimizar recursos, se puede instalar Clickhouse junto a la base de datos principal existente, ahorrando así una gran cantidad de tiempo de CPU y operaciones en disco. Hemos trasladado el archivo de métricas a los clústeres de Clickhouse ya existentes:
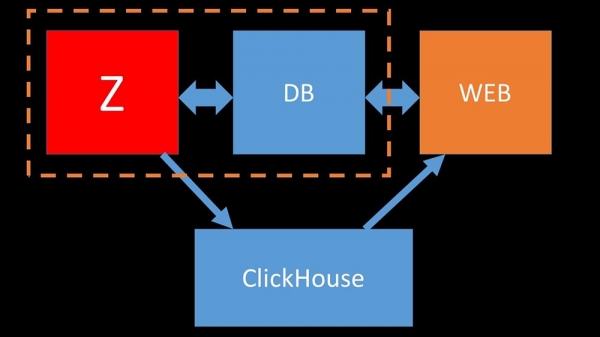
Hemos aliviado tanto la base de datos MySQL principal que pudimos combinarla en una sola máquina con el servidor Zabbix y prescindir de un servidor dedicado para MySQL.
¿Cómo funciona el polling en Zabbix?
Hace 4 meses
MM: Bueno, ¿se pueden olvidar los problemas con la base de datos?
MC: ¡Exacto! Otra tarea que necesitamos resolver es la lenta recopilación de datos. Ahora nuestros 15 servidores proxy están sobrecargados con procesos SNMP y polling. Y no hay más remedio que seguir instalando nuevos servidores.
MM: – Genial. Pero primero cuéntame, ¿cómo funciona el polling en 'Zabbix'?
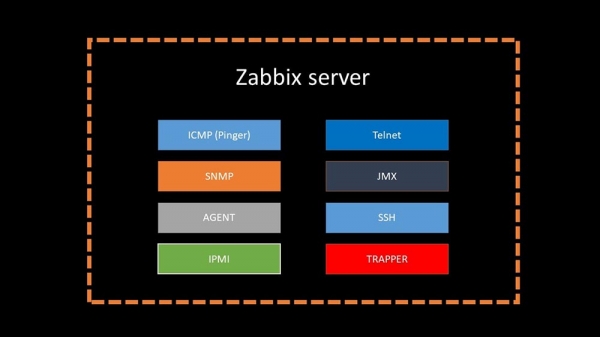
MC: – En resumen, hay 20 tipos de métricas y una docena de formas de obtenerlas. 'Zabbix' puede recopilar datos ya sea en modo 'solicitud – respuesta', o esperar nuevos datos a través de la 'Interfaz Trapper'.
Cabe mencionar que en la versión original de 'Zabbix' este método (Trapper) es el más rápido.
Existen servidores proxy para distribución de carga:
Los proxies pueden realizar las mismas funciones de recopilación que el servidor 'Zabbix', recibiendo tareas de él y enviando las métricas recopiladas a través de la interfaz Trapper. Este es el método recomendado oficialmente para la distribución de carga. Además, los proxies son útiles para monitorear infraestructuras remotas que operan a través de NAT o en canales lentos:
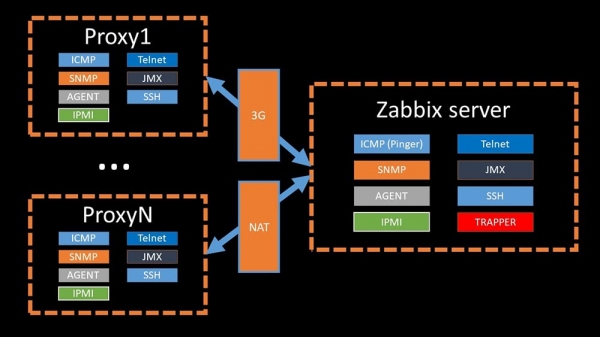
MM: – La arquitectura está clara. Necesitamos ver el código fuente...
Un par de días después
Historia de cómo nmap y fping ganaron
MM: – Parece que he encontrado algo.
MC: – ¡Cuéntame!
MM: – He descubierto que, al verificar la disponibilidad, 'Zabbix' comprueba un máximo de 128 hosts a la vez. Intenté aumentar esta cifra a 500 y eliminé el intervalo entre paquetes en su ping, lo que duplicó el rendimiento. Pero me gustaría números aún mayores.
MC: – En mi experiencia, a veces tengo que verificar la disponibilidad de miles de hosts, y no he encontrado nada más rápido que nmap. Estoy seguro de que es el método más rápido. ¡Probémoslo! Necesitamos aumentar significativamente el número de hosts por iteración.
MM: – ¿Verificar más de quinientos? ¿600?
MC: – Al menos un par de miles.
MM: – De acuerdo. Lo más importante que quería mencionar: encontré que la mayoría del polling en 'Zabbix' se realiza de manera sincrónica. Necesitamos transformarlo a un modo asíncrono. Entonces podremos aumentar radicalmente el número de métricas que los pollers recopilan, especialmente si aumentamos la cantidad de métricas por iteración.
MC: – ¡Genial! ¿Y cuándo?
MM: – Como siempre, ayer.
MC: – Comparamos ambas versiones de fping y nmap:
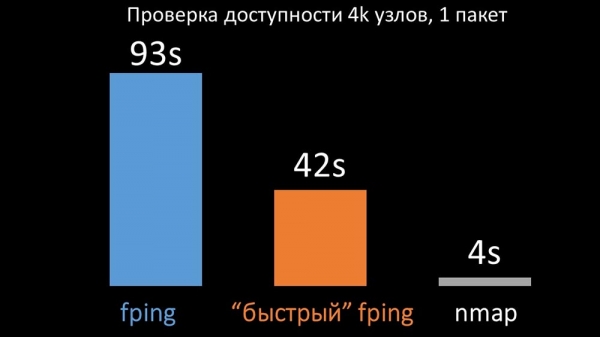
En un gran número de hosts, nmap resultó ser hasta cinco veces más eficiente de lo esperado. Dado que nmap solo verifica la disponibilidad y el tiempo de respuesta, trasladamos el conteo de pérdidas a los disparadores y significamos redujimos los intervalos de verificación de disponibilidad. Encontramos que el número óptimo de hosts para nmap está en torno a las 4,000 por iteración. Nmap nos permitió reducir el uso de CPU para las verificaciones de disponibilidad en tres veces y acortar el intervalo de 120 segundos a 10.
Optimización del sondeo
MM: – Luego nos ocupamos de los sondeadores. Principalmente nos interesaba la recopilación SNMP y los agentes. En «Zabbix», el sondeo se realiza de manera sincrónica y se han tomado medidas especiales para aumentar la eficiencia del sistema. En modo sincrónico, la falta de disponibilidad de hosts provoca una degradación significativa del sondeo. Existe todo un sistema de estados, hay procesos especiales, los llamados sondeadores no disponibles, que solo operan con hosts inalcanzables:

Este es un comentario que demuestra la matriz de estados, toda la complejidad del sistema de transiciones que se requiere para que el sistema siga siendo eficiente. Además, el propio sondeo sincrónico es bastante lento:
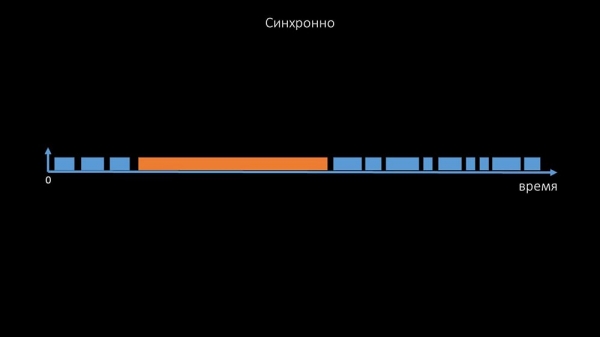
Por eso, miles de hilos de sondeadores en una decena de proxies no pudieron recopilar la cantidad necesaria de datos. La implementación asíncrona no solo resolvió los problemas con la cantidad de hilos, sino que también simplificó significativamente el sistema de estados de hosts inaccesibles, porque con cualquier número chequeado en una iteración de sondeo, el tiempo de espera máximo era de 1 timeout:
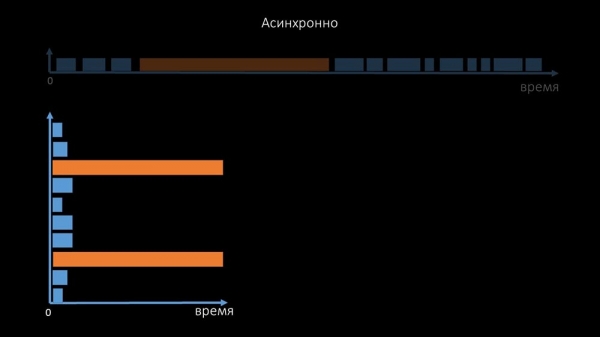
Adicionalmente, modificamos y perfeccionamos el sistema de sondeo para consultas SNMP. La cuestión es que la mayoría no pueden responder a múltiples consultas SNMP al mismo tiempo. Por eso creamos un modo híbrido en el que el sondeo SNMP de un mismo host se realiza de manera asíncrona:
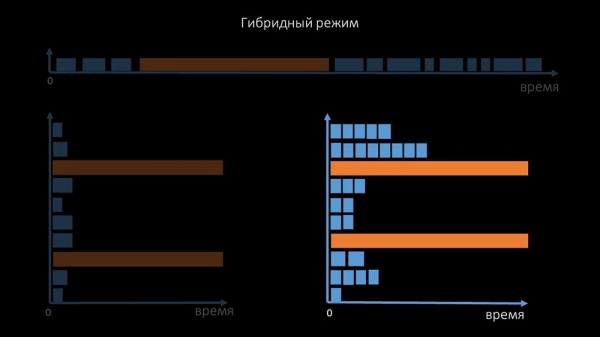
Esto se hace para todo un grupo de hosts. Este modo no es más lento que uno completamente asíncrono, ya que la consulta de una centena y media de valores SNMP sigue siendo mucho más rápida que 1 timeout.
Nuestros experimentos mostraron que el número óptimo de consultas en una iteración es aproximadamente 8,000 en el sondeo SNMP. En total, la transición al modo asíncrono permitió aumentar la productividad del sondeo 200 veces, en varios cientos de veces.
MC: Las optimizaciones de polling recibidas mostraron que no solo podemos deshacernos de todos los proxies, sino también reducir los intervalos de muchas comprobaciones, y los proxies dejarán de ser necesarios como forma de dividir la carga.
Hace aproximadamente tres meses
¡Cambia la arquitectura, aumenta la carga!
MM: – Bueno, Max, ¿es hora de pasar a producción? Necesito un servidor potente y un buen ingeniero.
MC: – Bien, lo planificaremos. Ya era hora de avanzar del estancamiento de 5 mil métricas por segundo.
Mañana después de la actualización
MC: – Misha, nos hemos actualizado, pero hasta la mañana hemos vuelto atrás... Adivina, ¿qué velocidad hemos logrado alcanzar?
MM: – Máximo 20 mil.
MC: – ¡Ajá, 25! Desafortunadamente, estamos donde comenzamos.
MM: – ¿Y por qué es eso? ¿Han realizado algún diagnóstico?
MC: – Sí, por supuesto. Aquí, por ejemplo, un top interesante:
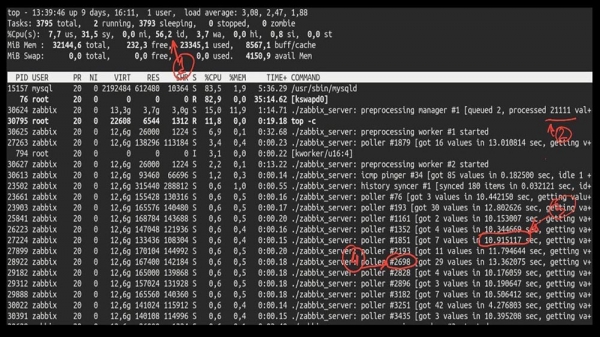
MM: – Vamos a verlo. Veo que hemos probado una enorme cantidad de hilos de polling:
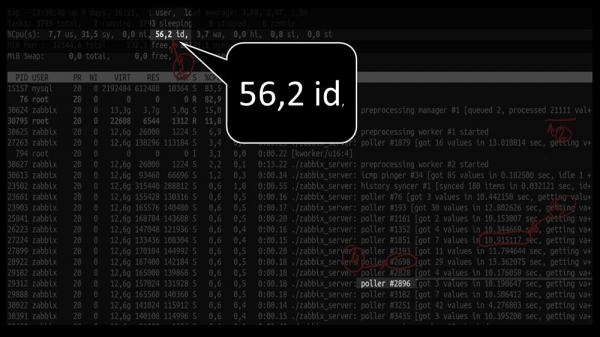
Pero al mismo tiempo no pudimos utilizar el sistema ni a la mitad:
Y el rendimiento total es bastante pequeño, alrededor de 4 mil métricas por segundo:
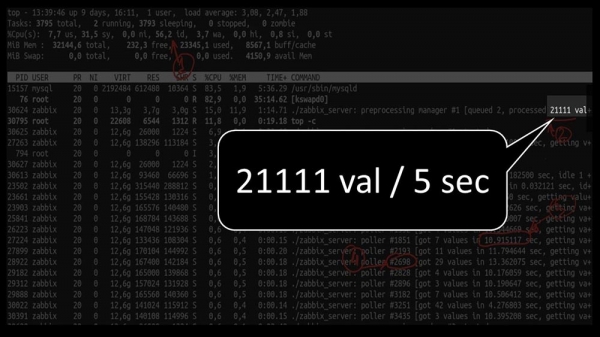
¿Hay algo más?
MC: – Sí, strace de uno de los pollers:
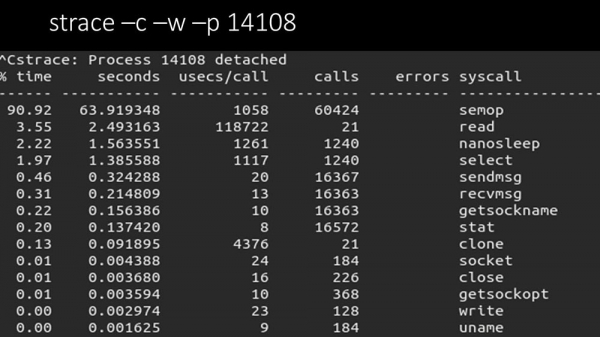
MM: – Aquí se ve claramente que el proceso de polling está esperando "semáforos". Estas son bloqueos:
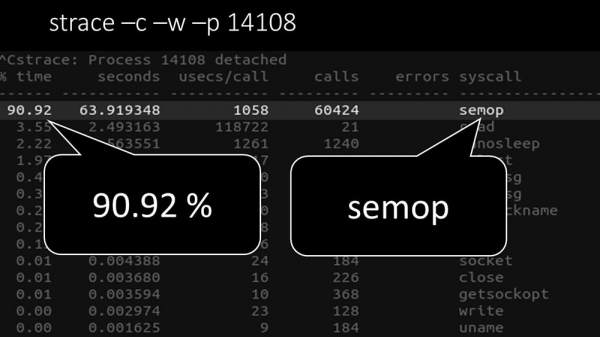
MC: – No entiendo.
MM: – Mira, esto parece una situación cuando un montón de hilos intenta trabajar con recursos que solo puede manejar uno a la vez. Entonces, todo lo que pueden hacer es compartir ese recurso en el tiempo:
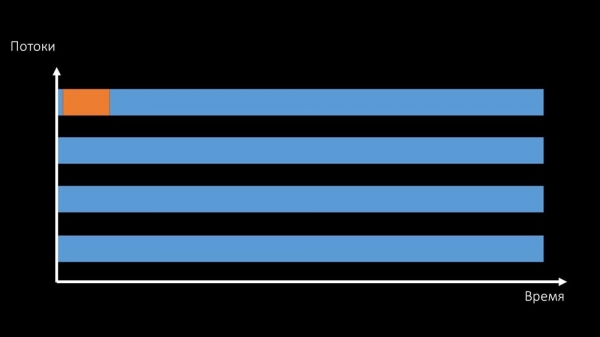
Y la producción total al trabajar con tal recurso está limitada por la velocidad de un solo núcleo:
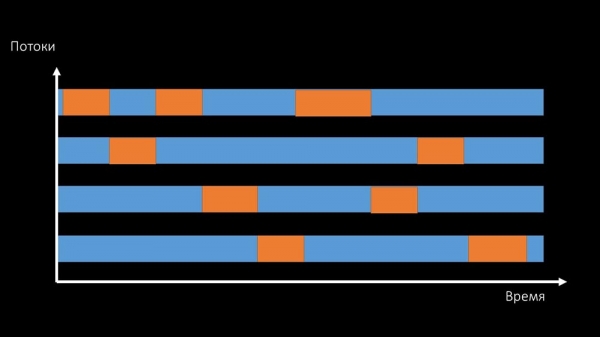
Esta clase de problemas se puede resolver de dos maneras.
Mejorar el hardware de la máquina, pasando a núcleos más rápidos:
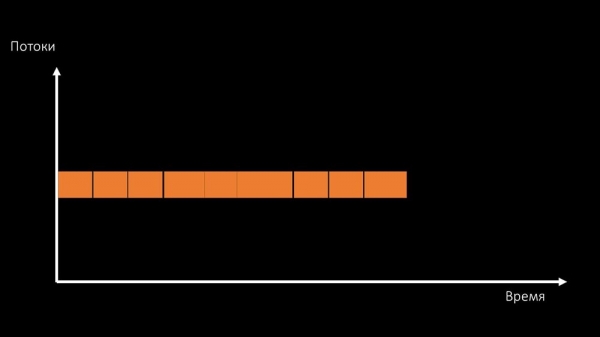
O cambiar la arquitectura y al mismo tiempo – la carga:
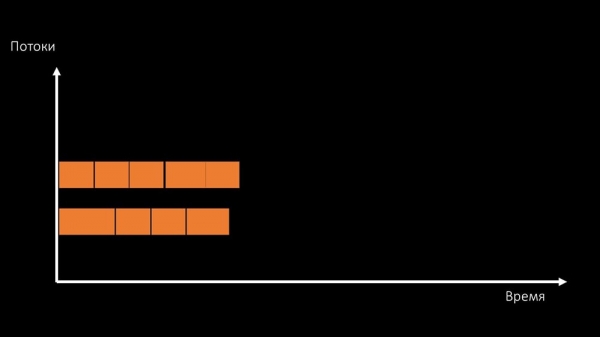
MC: – A propósito, en la máquina de prueba usaremos menos núcleos que en la de producción, ¡pero serán alrededor de 1.5 veces más rápidos por frecuencia por núcleo!
MM: – ¿Entendido? Hay que revisar el código del servidor.
El camino de los datos en el servidor Zabbix
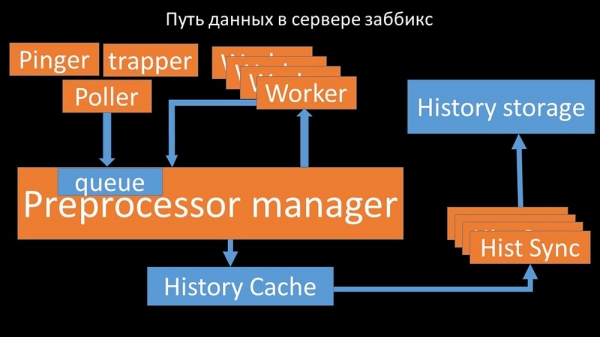
MC: – Para entenderlo, empezamos a analizar cómo se transmiten los datos dentro del servidor "Zabbix":
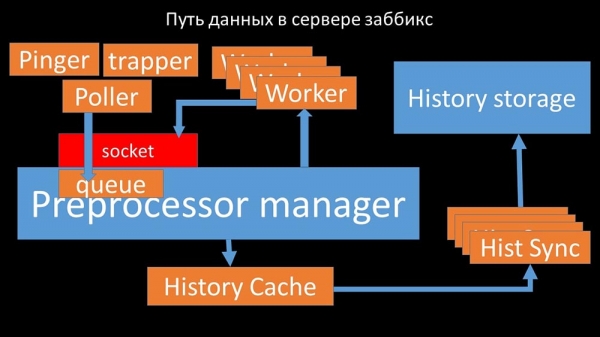
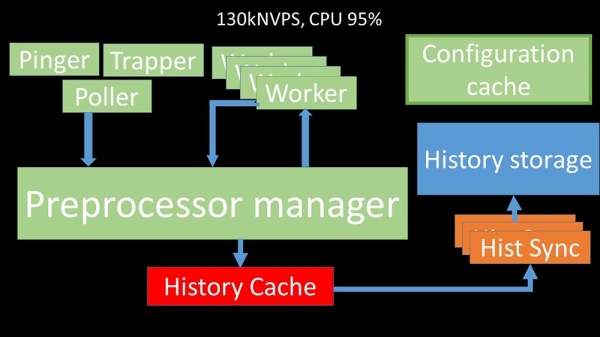
¿Genial la imagen, verdad? Vamos a recorrerla paso a paso para aclarar más o menos. Hay hilos y servicios responsables de la recopilación de datos:
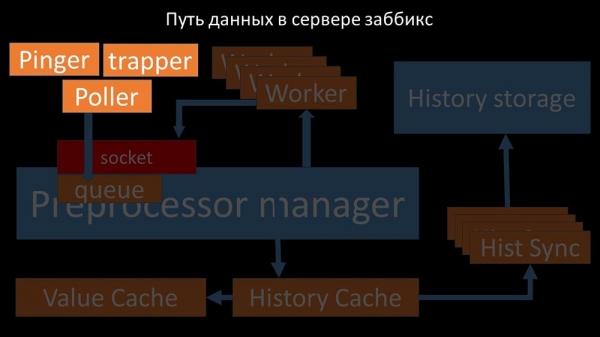
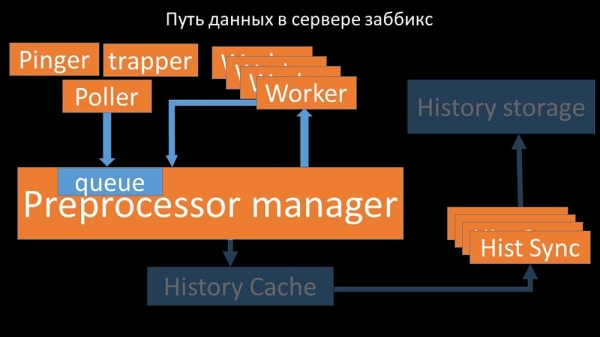
Las métricas recopiladas se envían a través de un socket al Preprocessor manager, donde se almacenan en una cola:
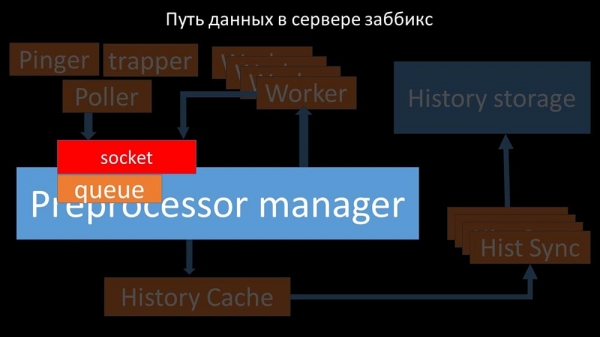
El "Preprocessor manager" envía los datos a sus trabajadores, quienes ejecutan instrucciones de preprocesamiento y los devuelven a través del mismo socket:
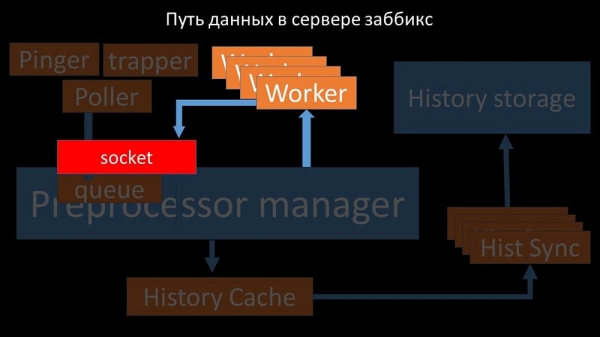
Después de esto, el gestor de preprocesador los guarda en la memoria caché del historial:
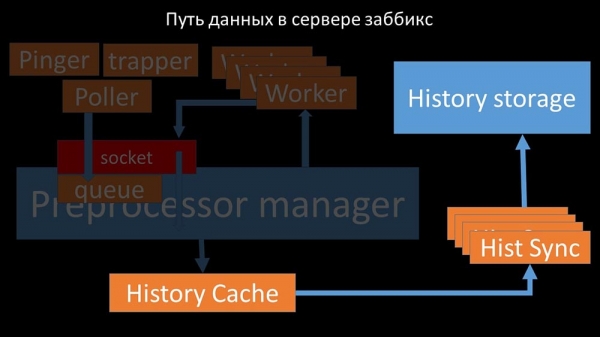
Desde allí, los recogen los sincronizadores de historial, que realizan muchas funciones: por ejemplo, calcular disparadores, llenar la memoria caché de valores y, lo más importante, guardar métricas en el almacenamiento de historial. En general, el proceso es complicado y bastante confuso.
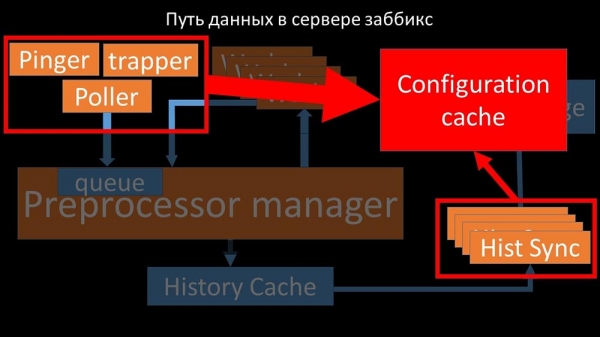
MM: – Lo primero que vimos fue que la mayoría de los flujos compiten por lo que se llama 'caché de configuración' (un área de memoria donde se almacenan todas las configuraciones del servidor). Especialmente muchas bloqueos son causados por los flujos responsables de la extracción de datos:
…ya que en la configuración se almacenan no solo métricas con sus parámetros, sino también colas de las que los sondeadores toman información sobre qué hacer a continuación. Cuando hay muchos sondeadores y uno bloquea la configuración, los demás esperan respuestas:
Los sondeadores no deben competir
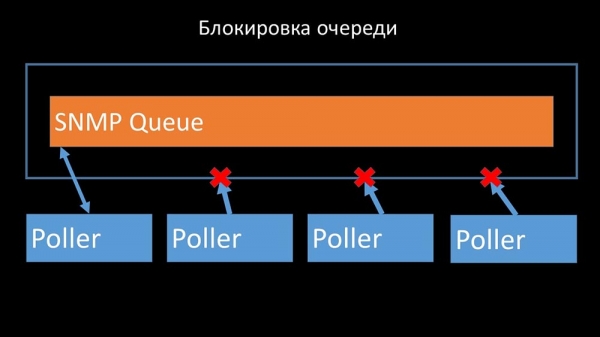
Por lo tanto, lo primero que hicimos fue dividir la cola en 4 partes y permitir a los sondeadores bloquear estas colas, estas partes, simultáneamente en condiciones seguras:
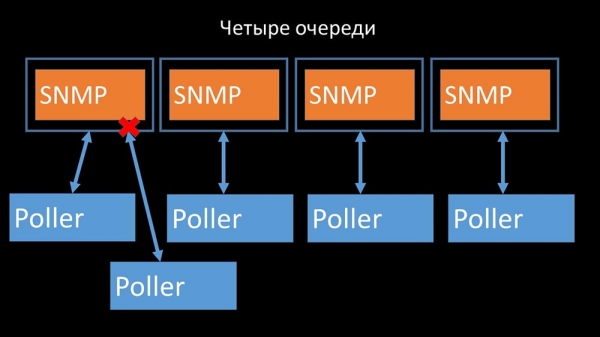
Esto eliminó la competencia por la caché de configuración, y la velocidad de los sondeadores aumentó significativamente. Pero luego nos encontramos con que el gestor de preprocesador comenzó a acumular cola de tareas:
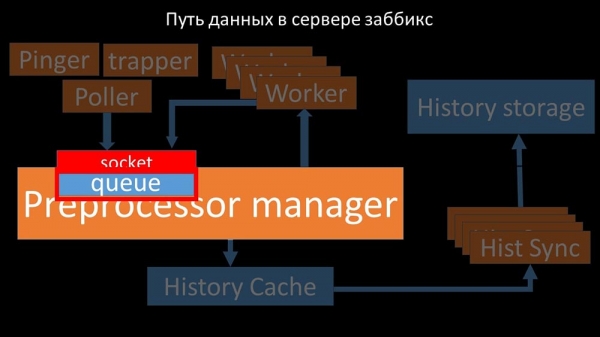
El gestor de preprocesador debe ser capaz de priorizar
Esto ocurría en casos en los que le faltaba rendimiento. Entonces, lo único que podía hacer era acumular solicitudes de procesos de recolección de datos y apilarlas en el búfer hasta que consumía toda la memoria y fallaba:
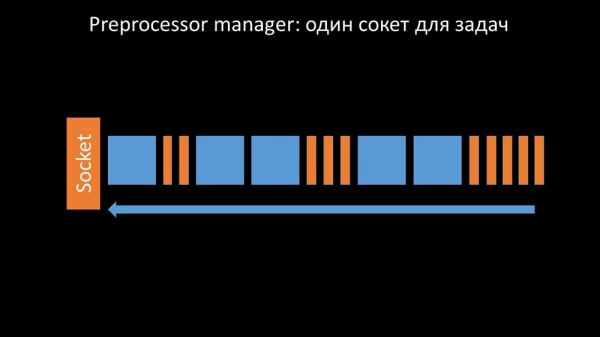
Para resolver este problema, añadimos un segundo socket, que fue dedicado especialmente a los trabajadores:
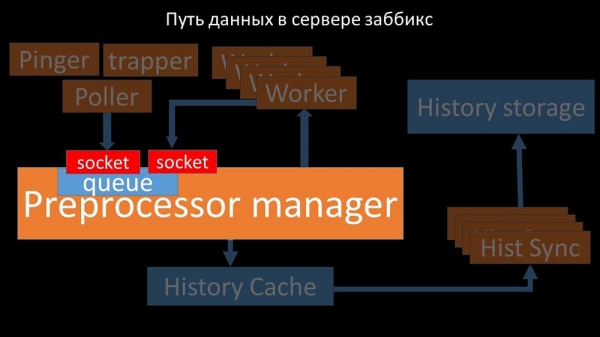
De este modo, el gestor de preprocesador obtuvo la posibilidad de priorizar su trabajo y, en caso de expansión del búfer, ralentizar la extracción, dando a los trabajadores la oportunidad de recoger ese búfer:
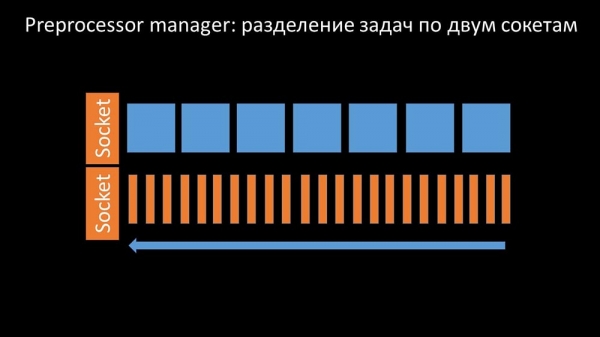
Luego descubrimos que una de las razones de la ralentización eran los propios trabajadores, ya que competían por un recurso completamente irrelevante para su trabajo. Esta problemática la presentamos como una corrección de errores, y en nuevas versiones de 'Zabbix' ya está resuelta:
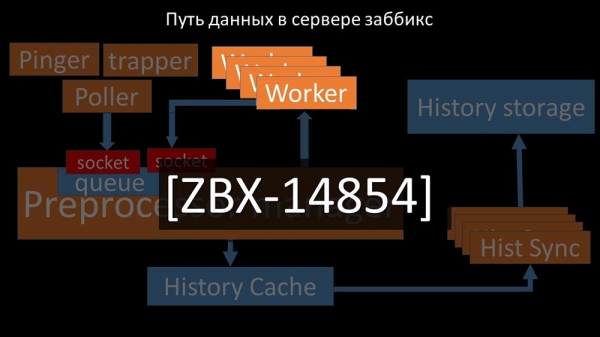
Aumentamos la cantidad de sockets – obtenemos resultados
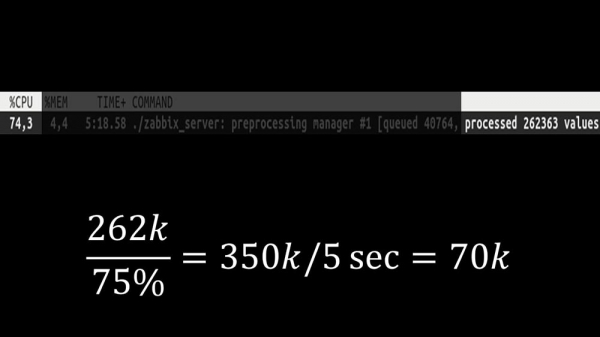
Luego, el propio gestor de preprocesador se convirtió en un cuello de botella, ya que es un solo hilo. Se limitaba por la velocidad del núcleo, alcanzando una velocidad máxima de aproximadamente 70 mil métricas por segundo:
Por eso hicimos cuatro, con cuatro conjuntos de sockets y trabajadores:
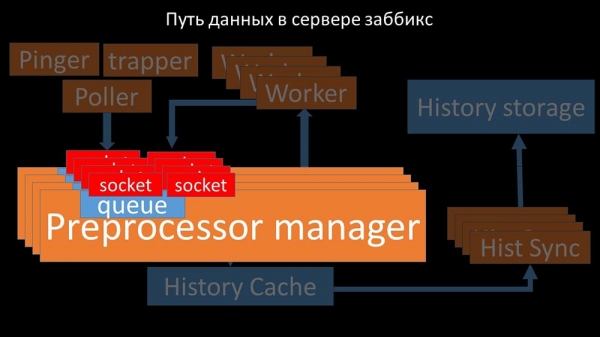
Y esto permitió aumentar la velocidad a aproximadamente 130 mil métricas:
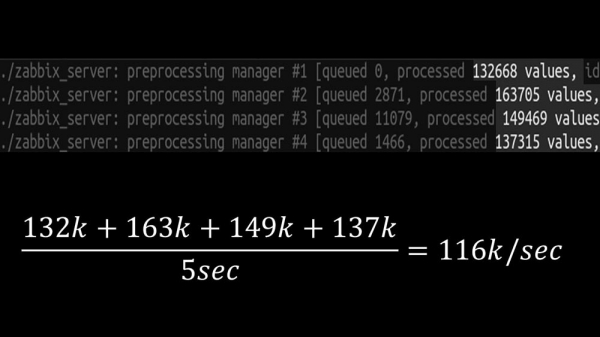
La no linealidad del crecimiento se explica porque hubo competencia por el caché de historia. Cuatro administradores de preprocesadores y sincronizadores de historia compitieron por él. En ese momento, estábamos obteniendo en la máquina de prueba aproximadamente 130 mil métricas por segundo, utilizando alrededor del 95 % de la CPU:
Hace aproximadamente 2,5 meses
Renunciar a snmp-community aumentó los NVPs en una vez y media
MM: – ¡Max, necesito una nueva máquina de prueba! Ya no cabemos en la actual.
MC: – ¿Y qué hay ahora?
MM: – Ahora – 130k NVPs y el procesador 'en la estantería'.
MC: – ¡Vaya! ¡Increíble! Espera, tengo dos preguntas. Según mis cálculos, nuestra necesidad es de alrededor de 15-20 mil métricas por segundo. ¿Por qué necesitamos más?
MM: – Queremos llevar el asunto hasta el final. Queremos ver cuánto podemos sacar de este sistema.
MC: – Pero…
MM: – Pero para el negocio es inútil.
MC: – Entendido. Y la segunda pregunta: ¿podremos mantener lo que hay ahora por nuestra cuenta, sin ayuda del desarrollador?
MM: – No lo creo. Cambiar el manejo de la caché de configuración es un problema. Afecta los cambios en la mayoría de los flujos y es bastante complicado de mantener. Probablemente será muy difícil de soportar.
MC: – Entonces necesitamos alguna alternativa.
MM: – Hay una opción. Podemos cambiar a núcleos rápidos, al mismo tiempo que renunciamos al nuevo sistema de bloqueo. Aun así obtendremos un rendimiento de 60-80 mil métricas. Y podremos dejar todo el resto del código. ClickHouse y la sondeo asíncrono funcionarán. Y será fácil de mantener.
MC: – ¡Maravilloso! Propongo detenernos aquí.
Después de optimizar la parte del servidor, finalmente pudimos implementar el nuevo código en producción. Renunciamos a parte de los cambios en favor de la transición a una máquina con núcleos rápidos y minimizamos la cantidad de cambios en el código. También simplificamos la configuración y, en la medida de lo posible, nos deshicimos de los macros en los elementos de datos, ya que son fuentes de bloqueos adicionales.
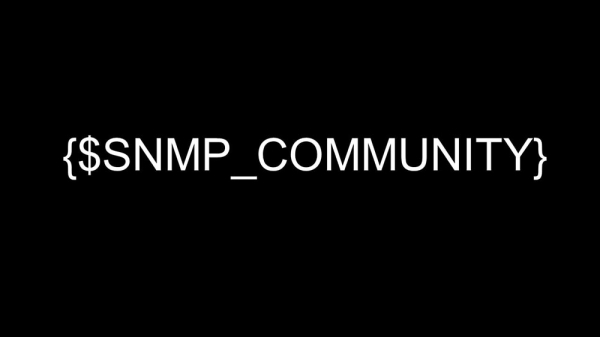
Por ejemplo, renunciar al macro snmp-community, que se encuentra comúnmente en la documentación y ejemplos, nos permitió acelerar los NVPs aproximadamente en 1,5 veces.
Después de dos días en producción
Eliminamos las ventanas emergentes de historia de incidentes
MC: – Misha, hemos estado usando el sistema durante dos días, y todo funciona. ¡Pero solo cuando todo está en funcionamiento! Tuvimos trabajos de mantenimiento con la migración de un segmento de red bastante grande, y nuevamente verificamos manualmente qué había funcionado y qué no.
MM: – ¡No puede ser! Verificamos todo 10 veces. El servidor maneja incluso la incomunicación total de la red de inmediato.
MC: – Lo entiendo todo: el servidor, la base, top, austat, los registros – todo rápido... Pero estamos mirando la interfaz web, y allí el procesador está "en el estante" en el servidor y esto:
MM: – Entiendo. Vamos a revisar la web. Descubrimos que en situaciones con un gran número de incidentes activos, la mayoría de los widgets operativos comenzaban a funcionar muy lentamente:
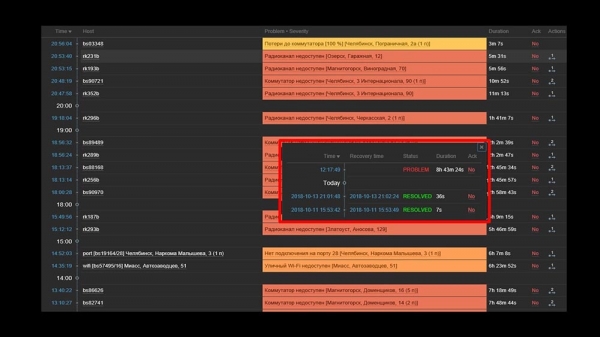
La causa de esto fue la generación de ventanas emergentes con el historial de incidentes, que se generan para cada elemento en la lista. Por lo tanto, renunciamos a la generación de estas ventanas (comentamos 5 líneas en el código), y esto resolvió nuestros problemas.
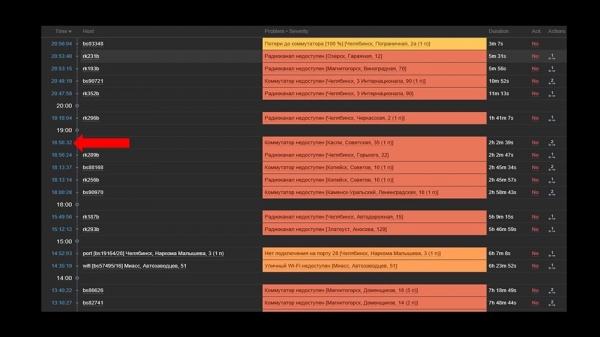
El tiempo de carga de los widgets, incluso en condiciones de total inaccesibilidad, se redujo de varios minutos a unos aceptables para nosotros 10-15 segundos, y el historial todavía se puede ver con un clic en el tiempo:
Después del trabajo. Hace 2 meses.
MC: – Misha, ¿te vas? Necesitamos hablar.
MM: – No tenía planes. ¿Algo más con Zabbix?
MC: – No, tranquilo. Solo quería decir: ¡todo funciona, gracias! Yo invito a una cerveza.
Zabbix es efectivo
«Zabbix» es un sistema y función bastante versátil y completo. Se puede utilizar para instalaciones pequeñas "listo para usar", pero a medida que crecen las necesidades, es necesario optimizarlo. Para almacenar un gran archivo de métricas, usa un almacenamiento adecuado:
- puedes usar herramientas integradas en forma de integración con «Elasticsearch» o exportación de historia a archivos de texto (disponible desde la cuarta versión);
- puedes aprovechar nuestra experiencia e integración con «ClickHouse».
Para un aumento drástico en la velocidad de recolección de métricas, recógelas mediante métodos asíncronos y envíalas a través de la interfaz del trapper al servidor «Zabbix»; o puedes usar un parche para la asincronía de los pollers de «Zabbix».
Zabbix está escrito en C y es bastante eficiente. Sin embargo, algunas limitaciones arquitectónicas permiten aumentar su rendimiento y, según nuestra experiencia, obtener más de 100 mil métricas en una máquina de un solo procesador.
El famoso parche Zabbix
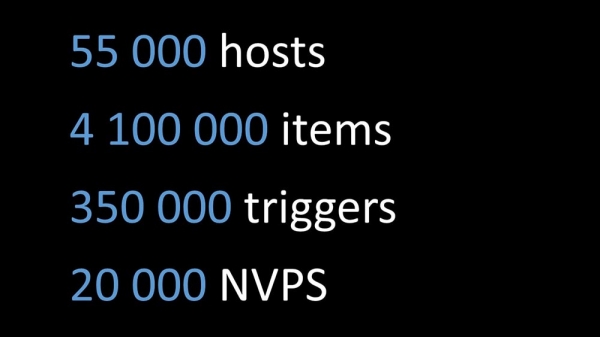
MM: – Quiero añadir un par de puntos. Todo el informe actual, todas las pruebas y cifras se han presentado para la configuración que utilizamos. En ella estamos recolectando aproximadamente 20 mil métricas por segundo. Si intentas entender si esto funcionará para ti, puedes compararlo. Lo que se ha comentado hoy está disponible en GitHub como un parche:
El parche incluye:
- integración completa con ClickHouse (tanto para el servidor Zabbix como para el frontend);
- soluciones a problemas con el gestor de preprocesadores;
- polling asíncrono.
El parche es compatible con toda la versión 4, incluyendo lts. Es probable que funcione con pocos cambios en la versión 3.4.
Gracias por su atención.
Preguntas
Pregunta de la audiencia (A): – ¡Buenos días! Por favor, díganme, ¿tienen planes de interactuar intensamente con el equipo de Zabbix o ellos con ustedes, para que esto no sea un parche, sino un comportamiento normal de Zabbix?
MM: – Sí, nos comprometemos a hacer algunos cambios. Algunas cosas quedarán como un parche.
A: – ¡Muchas gracias por la excelente presentación! Por favor, díganme, después de aplicar el parche, ¿seguirá habiendo soporte por parte de Zabbix y cómo se podrá actualizar a versiones más altas? ¿Habrá posibilidad de actualizar Zabbix después de su parche a 4.2, 5.0?
MM: – No puedo decir nada sobre el soporte. Si yo fuera soporte técnico de Zabbix, probablemente diría que no, porque es código externo. En cuanto a la base de código 4.2, nuestra posición es la siguiente: «Nos adaptaremos con el tiempo y actualizaremos a la siguiente versión». Por lo tanto, durante un tiempo publicaremos parches para versiones actualizadas. Ya he comentado en la presentación: la cantidad de cambios con las versiones sigue siendo bastante pequeña. Creo que la migración de 3.4 a 4 nos tomó, parece, unos 15 minutos. Hubo algunos cambios, pero no muy importantes.
A: – Entonces, ¿planean mantener su parche y se puede instalar sin problemas en producción, recibiendo actualizaciones de alguna manera?
MM: – Lo recomendamos encarecidamente. Esto resuelve muchos problemas.
MC: Me gustaría enfatizar una vez más que los cambios que no afectan la arquitectura y no están relacionados con bloqueos o colas son modulares, se encuentran en módulos separados. Incluso de forma independiente, con cambios menores, se pueden mantener con bastante facilidad.
MM: Si te interesan los detalles, 'ClickHouse' utiliza lo que se llama una biblioteca de historia. Está desacoplada: es una copia del soporte de 'Elasticsearch', es decir, es configurable. El polling solo cambia los pollers. Creemos que esto funcionará durante mucho tiempo.
A: Muchas gracias. ¿Podrías decirme si hay alguna documentación sobre los cambios realizados?
MM: La documentación es el parche. Obviamente, con la introducción de 'ClickHouse' y nuevos tipos de pollers, surgen nuevas opciones de configuración. En el enlace de la última diapositiva hay una breve descripción de cómo usarlo.
Sobre la sustitución de fping por nmap
A: ¿Cómo lo implementaron al final? ¿Puedes dar ejemplos concretos: son strapppers y un script externo? ¿Qué comprueba tan rápido una cantidad tan enorme de hosts? ¿Cómo obtienen estos hosts? ¿Hay que alimentarlos a nmap, conseguirlos de alguna parte, almacenarlos, ejecutar algo...?
MM: Genial. ¡Muy buena pregunta! La idea es esta. Modificamos la biblioteca (ICMP ping, parte de 'Zabbix') para las verificaciones ICMP, donde se especifica la cantidad de paquetes: uno (1), y el código intenta usar nmap. Es decir, esto se convierte en un trabajo interno de 'Zabbix', se ha convertido en un trabajo interno del ping. En consecuencia, no se requiere ninguna sincronización ni uso de trapper. Se hizo de forma consciente para mantener el sistema íntegro y no ocuparnos de la sincronización de dos sistemas de bases: qué verificar, subir a través del poller, y si nuestra carga no se rompió... Es mucho más simple.
A: ¿Esto también funciona para proxies?
MM: Sí, pero no lo hemos probado. El código de polling es el mismo en 'Zabbix' y en el servidor. Debería funcionar. Una vez más, subrayo: el rendimiento del sistema es tal que no necesitamos proxies.
MC: La respuesta correcta a la pregunta es: "¿Para qué necesitas un proxy en este sistema?" Solo por el NAT o para monitorear a través de algún canal lento...
A: ¿Estás utilizando 'Zabbix' como alertador, si entendí correctamente? ¿O los gráficos (donde está la capa de archivo) se han trasladado a otro sistema, como Grafana? ¿O no utilizan esta funcionalidad?
MM: – Quiero enfatizar nuevamente: hemos realizado una integración completa. Estamos vertiendo el historial en «ClickHouse», pero hemos modificado el frontend de PHP. El frontend de PHP se conecta a «ClickHouse» y genera todos los gráficos desde allí. Al mismo tiempo, si soy honesto, tenemos una parte que construye a partir del mismo «ClickHouse», utilizando los mismos datos de «Zabbix» para otras sistemas de visualización gráfica.
MC: – Incluido en «Grafana».
¿Cómo se tomó la decisión de asignar recursos?
A: – Comparta un poco de la cocina interna. ¿Cómo se tomó la decisión de que era necesario destinar recursos a una revisión significativa del producto? Esto, en general, implica ciertos riesgos. Y dígame, por favor, en el contexto de que planean mantener nuevas versiones: ¿cómo se justifica esta decisión desde el punto de vista de la gestión?
MM: – Parece que no contamos muy bien la dramatización de la historia. Nos encontramos en una situación en la que había que hacer algo, y seguimos, esencialmente, con dos equipos paralelos:
- Uno se encargó de lanzar el sistema de monitoreo con nuevos métodos: monitoreo como servicio, un conjunto estándar de soluciones de código abierto que combinamos y luego intentamos adaptar el proceso de negocio para trabajar con el nuevo sistema de monitoreo.
- Paralelamente, tuvimos un programador entusiasta que trabajó en esto (sobre sí mismo). Resultó que él ganó.
A: – ¿Y cuál es el tamaño del equipo?
MC: – Aquí están frente a ustedes.
A: – Entonces, ¿como siempre se necesita un apasionado?
MM: – No sé qué es un apasionado.
A: – En este caso, aparentemente, usted. Muchas gracias, ustedes son geniales.
MM: – Gracias.
Sobre los parches para Zabbix
A: – Para un sistema que utiliza proxies (por ejemplo, en algunos sistemas distribuidos), ¿es posible adaptar su solución y parchar, digamos, a los pollers, proxies y parcialmente el preprocesador de «Zabbix»; y su interacción? ¿Es posible optimizar los desarrollos existentes para un sistema con varios proxies?
MM: – Sé que el servidor de «Zabbix» se compila con la ayuda de proxies (se compila y se obtiene código). No hemos verificado esto en producción. No estoy seguro de ello, pero creo que el preprocesador-gestor no se utiliza en el proxy. La tarea del proxy es tomar un conjunto de métricas de «Zabbix», espelearlas (también guarda la configuración, la base de datos local) y devolverlas al servidor de «Zabbix». El preprocesamiento lo realizará luego el servidor mismo, cuando lo reciba.
El interés por los proxies es comprensible. Vamos a comprobarlo. Es un tema interesante.
A: – La idea era esta: si se pueden parchear los pollers, se pueden parchear para proxies y adaptar la interacción con el servidor, y el preprocesador solo para esos fines se adapta en el servidor.
MM: – Creo que es aún más simple. Tomáis el código, aplicáis el parche, luego configuráis como necesitéis – construís proxies (por ejemplo, con ODBC) y distribuís el código parcheado por los sistemas. Donde sea necesario, construís proxies, donde sea necesario, servidores.
A: – ¿No será necesario parchear adicionalmente la transmisión de proxies al servidor?
MC: – No, es estándar.
MM: – En realidad, no se mencionó una de las ideas. Siempre hemos mantenido el equilibrio entre una explosión de ideas y la cantidad de cambios, y la facilidad de soporte.
Un poco de publicidad 🙂
Gracias por permanecer con nosotros. ¿Te gustan nuestros artículos? ¿Quieres ver más contenido interesante? Apóyanos haciendo un pedido o recomendando a tus conocidos, , un análogo único de servidores entry-level que hemos diseñado para Ti: (disponibles opciones con RAID1 y RAID10, hasta 24 núcleos y hasta 40GB DDR4).
¿Dell R730xd a mitad de precio en el centro de datos Equinix Tier IV en Ámsterdam? Solo aquí ¡en los Países Bajos! Dell R420 — 2x E5-2430 2.2Ghz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — ¡desde $99! Lee sobre cómo
Fuente: habr.com
