

La próxima conferencia HighLoad++ se llevará a cabo el 6 y 7 de abril de 2020 en San Petersburgo.
Detalles y entradas . HighLoad++ Siberia 2019. Salón "Krasnoyarsk". 25 de junio, 12:00. Resúmenes y .
A veces, los requisitos prácticos entran en conflicto con la teoría, donde no se han considerado aspectos importantes para un producto comercial. En esta presentación se presenta el proceso de selección y combinación de diferentes enfoques para crear componentes de consistencia causal basados en investigaciones académicas a partir de los requisitos de un producto comercial. Los oyentes conocerán los enfoques teóricos existentes sobre relojes lógicos, seguimiento de dependencias, seguridad del sistema, sincronización de relojes y por qué MongoDB eligió ciertas soluciones.
Mikhail Tyulenev (en adelante – MT): – Voy a hablar sobre la consistencia causal; es una característica en la que hemos trabajado en MongoDB. Trabajo en el grupo de sistemas distribuidos, la creamos hace aproximadamente dos años.
En el proceso tuve que familiarizarme con una gran cantidad de investigación académica, ya que esta característica está bastante bien estudiada. Resultó que ningún artículo se ajusta a lo que se requiere en producción, a la base de datos, debido a los requisitos bastante específicos que existen, probablemente, en cualquier aplicación de producción.
Voy a hablar sobre cómo, como consumidores de la investigación académica, preparamos algo de ello que luego podemos presentar a nuestros usuarios como un plato terminado, con el que sea conveniente y seguro de usar.
Consistencia causal. Definamos los conceptos
Para comenzar, quiero esbozar en términos generales qué es la consistencia causal. Hay dos personajes: Leonard y Penny (de la serie "The Big Bang Theory"):
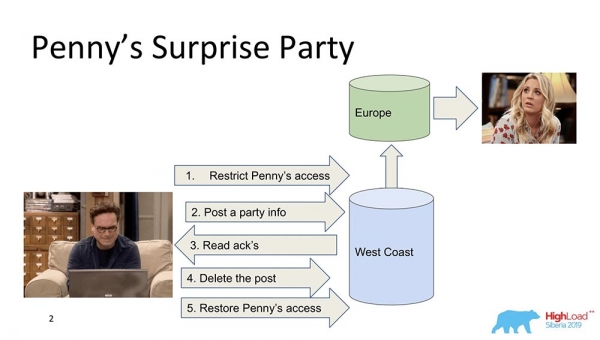
Supongamos que Penny está en Europa, y Leonard quiere hacerle una sorpresa, una fiesta. Y no se le ocurre nada mejor que eliminarla de su lista de amigos, enviar a todos sus amigos una actualización en el feed: "¡Celebremos a Penny!" (ella está en Europa, mientras duerme, no ve nada de esto y no puede verlo, porque no está allí). En un momento final elimina esa publicación, la borra del "Feed" y restaura el acceso, para que ella no se de cuenta y no haya escándalo.
Todo esto es maravilloso, pero supongamos que el sistema es distribuido, y las cosas no salieron exactamente como se esperaba. Puede suceder, por ejemplo, que la restricción de acceso a Penny se aplicara después de que se publicó esta entrada, si los eventos no están conectados entre sí de manera causal. Este es un ejemplo de cuándo se requiere consistencia causal para llevar a cabo una función comercial (en este caso).
En realidad, estas son propiedades bastante no triviales de las bases de datos, muy pocos las soportan. Pasemos a los modelos.
Modelos de consistencia (Consistency Models)
¿Qué es en realidad un modelo de consistencia en bases de datos? Son ciertas garantías que un sistema distribuido proporciona sobre qué datos y en qué secuencia un cliente puede recibir.
En principio, todos los modelos de consistencia se reducen a cuán parecido es un sistema distribuido a uno que opere, por ejemplo, en un solo nodo en una laptop. Y cuán similar es un sistema que opera en miles de nodos geográficamente distribuidos a una laptop, donde todas estas propiedades se cumplen automáticamente.
Por lo tanto, los modelos de consistencia solo se aplican a sistemas distribuidos. Todos los sistemas que existieron antes y funcionaron con una escalabilidad vertical no enfrentaban tales problemas. Había un solo Buffer Cache, y de él siempre se leía.
Modelo Strong
En realidad, el primer modelo es el Strong (o modelo de capacidad de crecimiento, como se le suele llamar). Este es un modelo de consistencia que garantiza que cada cambio, tan pronto como se recibe la confirmación de que ocurrió, se vuelve visible para todos los usuarios del sistema.
Esto crea un orden global de todos los eventos en la base de datos. Esta es una propiedad de consistencia muy fuerte, y es bastante costosa. Sin embargo, se mantiene muy bien. Es simplemente muy cara y lenta; por ello, se usa raramente. Esto se llama capacidad de crecimiento.
Hay otra propiedad, aún más fuerte, que se mantiene en 'Spanner' – se llama consistencia externa. Hablaremos de esto más adelante.
Causal
Lo siguiente es Causal, justo de lo que hablaba. Existen varios subniveles entre Strong y Causal, de los cuales no hablaré, pero todos se reducen a Causal. Este es un modelo importante porque es el más fuerte de todos los modelos, la consistencia más fuerte en presencia de una red o particiones.
Causals son, de hecho, la situación en la que los eventos están relacionados por una relación de causa y efecto. A menudo se perciben como Read your own rights desde la perspectiva del cliente. Si un cliente ha observado ciertos valores, no puede ver los valores que estaban en el pasado. Ya empieza a ver lecturas prefijadas. Todo esto se reduce a lo mismo.
Causals como modelo de consistencia - un orden parcial de los eventos en el servidor, donde los eventos de todos los clientes se observan en la misma secuencia. En este caso - Leonard y Penny.
Eventual
El tercer modelo es la Consistencia Eventual. Este es el que mantienen absolutamente todos los sistemas distribuidos, el modelo mínimo que tiene sentido. Significa lo siguiente: cuando ocurren ciertos cambios en los datos, en algún momento se vuelven consistentes.
En ese momento no dice nada, de lo contrario se convertiría en Consistencia Externa, sería una historia completamente diferente. Sin embargo, este es un modelo muy popular, el más común. Por defecto, todos los usuarios de sistemas distribuidos utilizan precisamente la Consistencia Eventual.
Quiero dar algunos ejemplos comparativos:
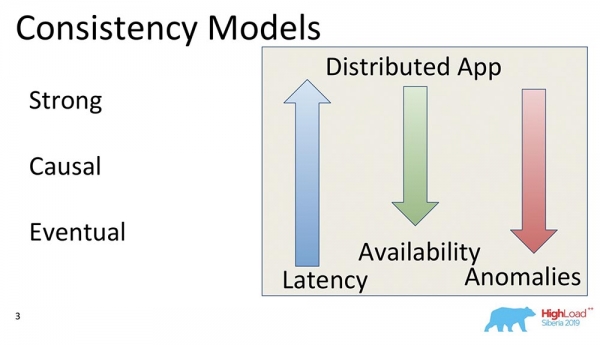
¿Qué significan estas flechas?
- Latencia. Con un aumento en la fuerza de la consistencia, aumenta por razones evidentes: hay que realizar más escrituras, obtener confirmación de todos los hosts y nodos que participan en el clúster, de que los datos ya están allí. Por tanto, en la Consistencia Eventual la respuesta más rápida, porque allí, por lo general, se puede incluso confirmar en memoria y eso será, en principio, suficiente.
- Disponibilidad. Si esto se entiende como la capacidad del sistema para responder a la existencia de interrupciones en la red, particiones o alguna falla, la resistencia a fallos aumenta al reducir el modelo de consistencia, ya que nos basta con que un host funcione y, al mismo tiempo, proporcione algunos datos. La Consistencia Eventual no garantiza nada acerca de los datos, puede ser cualquier cosa.
- Anomalías. Sin embargo, naturalmente, aumenta la cantidad de anomalías. En la Consistencia Fuerte casi no debería haber ninguna, mientras que en la Consistencia Eventual pueden existir muchas. Surge la pregunta: ¿por qué la gente elige la Consistencia Eventual si contiene anomalías? La respuesta radica en que los modelos de Consistencia Eventual son aplicables, y las anomalías existen, por ejemplo, durante un corto período de tiempo; existe la posibilidad de usar un maestro para leer y obtener datos más o menos consistentes; a menudo hay la posibilidad de utilizar fuertes modelos de consistencia. Prácticamente funciona, y a menudo el número de anomalías está limitado en el tiempo.
Teorema CAP
Cuando escucha las palabras consistencia, disponibilidad, ¿qué le viene a la mente? ¡Correcto: el teorema CAP! Ahora quiero desmentir un mito… No soy yo, es Martin Kleppmann, quien escribió un excelente artículo, un excelente libro.
El teorema CAP es un principio formulado en los años 2000, sobre que Consistencia, Disponibilidad, Particiones: toma cualquiera de los dos, y no puedes elegir los tres. Era un cierto principio. Fue probado como teorema algunos años después, lo hicieron Gilbert y Lynch. Luego comenzó a utilizarse como un mantra: los sistemas se dividieron en CA, CP, AP, y así sucesivamente.
Este teorema fue probado en realidad para ciertos casos… Primero, la Disponibilidad no se consideraba como un valor continuo de cero a cien (0 – sistema 'muerto', 100 – responde rápidamente; así solemos considerarlo), sino como una propiedad del algoritmo que garantiza que, en todas sus ejecuciones, devuelve datos.
¡No se menciona nada sobre el tiempo de respuesta! Hay un algoritmo que devuelve datos después de 100 años – un algoritmo disponible absolutamente maravilloso, que forma parte del teorema CAP.
En segundo lugar: el teorema se demostró para cambios en los valores de una misma clave, siendo estos cambios una línea redimensionable. Esto significa que, en realidad, se utilizan poco, porque hay otros modelos de Consistencia Eventual, Consistencia Fuerte (puede ser).
¿A qué viene todo esto? A que el teorema CAP, en la forma en que fue demostrado, es prácticamente inaplicable, se utiliza raramente. En su forma teórica, de alguna manera limita todo. Resulta ser un principio que es intuitivamente verdadero, pero que en general no está demostrado.
La consistencia causal es el modelo más fuerte.
Lo que está sucediendo ahora es que se pueden obtener las tres cosas: Consistencia, Disponibilidad se pueden lograr con Particiones. En particular, la consistencia causal es el modelo más fuerte de consistencia que, en presencia de particiones (interrupciones en la red), sigue funcionando. Por eso es de gran interés y por eso nos hemos ocupado de ello.
En primer lugar, simplifica el trabajo de los desarrolladores de aplicaciones. En particular, la gran cantidad de soporte del servidor: cuando todas las grabaciones que se realizan dentro de un solo cliente llegan garantizadas en tal secuencia a otro cliente. En segundo lugar, es resistente a particiones.
La cocina interna de MongoDB
Teniendo en cuenta que es hora del almuerzo, nos trasladamos a la cocina. Les hablaré sobre el modelo del sistema, es decir, qué es MongoDB para aquellos que escuchan sobre esta base de datos por primera vez.
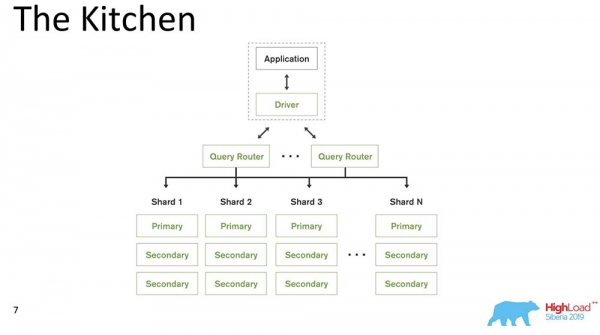
MongoDB (en adelante, 'MongoDB') es un sistema distribuido que soporta escalabilidad horizontal, es decir, sharding; y dentro de cada shard también soporta redundancia de datos, es decir, replicación.
El sharding en 'MongoDB' (una base de datos no relacional) realiza la balanceo automático, es decir, cada colección de documentos (o 'tabla' en términos de datos relacionales) se divide en partes, y el servidor ya mueve automáticamente esas partes entre los shards.
El Query Router, que distribuye las consultas, para el cliente es como un cliente a través del cual trabaja. Ya sabe dónde y qué datos se encuentran, y dirige todas las consultas al shard correcto.
Otro punto importante: MongoDB es un único maestro. Hay un Primary que puede tomar las grabaciones que soportan las claves que contiene. No se puede hacer escritura multi-maestro.
Hicimos el lanzamiento 4.2: aparecieron cosas nuevas e interesantes. En particular, se incorporó Lucene: búsqueda - es decir, java ejecutable directamente en 'Mongo', y ahora es posible realizar búsquedas a través de Lucene, igual que en 'Elasticsearch'.
Y lanzamos un nuevo producto: Charts, que también está disponible en 'Atlas' (nube propia de 'Mongo'). Tienen un Free Tier – se puede experimentar con eso. Charts me gustó mucho: visualización de datos, muy intuitiva.
Ingredientes de la consistencia causal
Conté aproximadamente 230 artículos que se han publicado sobre este tema – de Leslie Lampert. Ahora desde mi memoria les transmitiré algunas partes de esos materiales.
Todo comenzó con un artículo de Leslie Lampert, escrito en la década de 1970. Como pueden ver, todavía se llevan a cabo algunas investigaciones en este tema. Hoy en día, la consistencia causal está recibiendo interés debido al desarrollo de sistemas distribuidos.
Limitaciones
¿Cuáles son las limitaciones? Este es, de hecho, uno de los puntos principales, porque las limitaciones impuestas por los sistemas de producción difieren significativamente de las limitaciones que existen en los artículos académicos. A menudo, son bastante artificiales.
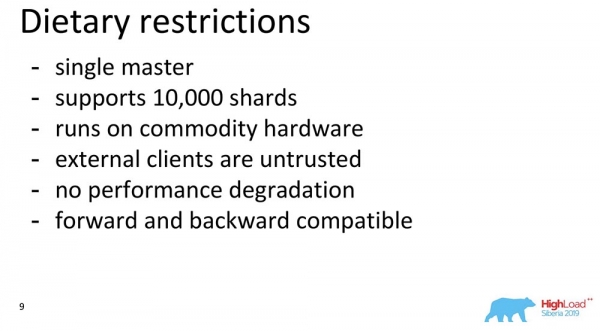
- Primero, 'MongoDB' es un maestro único, como ya he mencionado (lo que simplifica mucho).
- Consideramos que el sistema debería soportar alrededor de 10,000 shards. No podemos tomar decisiones arquitectónicas que restrinjan claramente este valor.
- Tenemos la nube, pero suponemos que una persona debe tener la opción, cuando descarga el binario, de ejecutarlo en su laptop, y todo debe funcionar perfectamente.
- Suponemos que en la investigación se usa raramente: los clientes externos pueden hacer lo que quieran. 'MongoDB' es de código abierto. En consecuencia, los clientes pueden ser lo suficientemente inteligentes y maliciosos como para querer romper todo. Suponemos que pueden ocurrir fallos bizantinos.
- Para clientes externos, que están fuera del perímetro, una limitación importante es: si esta función está desactivada, no debería haber degradación del rendimiento.
- Otro punto, en general anti-académico: la compatibilidad de versiones anteriores y futuras. Los controladores antiguos deben soportar nuevas actualizaciones, y la base de datos debe ser compatible con los controladores antiguos.
En general, todo esto impone limitaciones.
Componentes de la consistencia causal
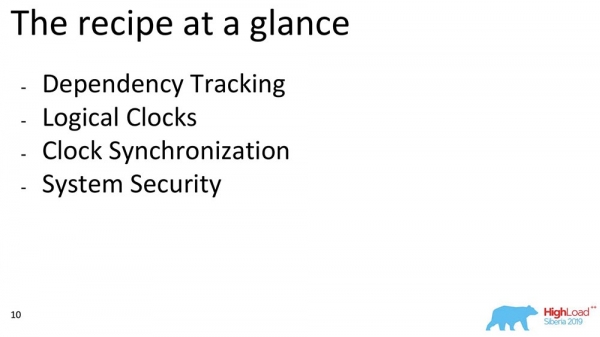
Ahora hablaré sobre algunos componentes. Si consideramos en general la consistencia causal, podemos destacar bloques. Elegimos trabajos que pertenecen a algún bloque: seguimiento de dependencias, elección de relojes, cómo sincronizar estos relojes entre sí y cómo garantizamos la seguridad; este es un esquema aproximado de lo que voy a discutir:
Seguimiento completo de dependencias (Full Dependency Tracking)
¿Para qué sirve? Para que, cuando se replican los datos, cada registro, cada cambio de datos contenga información sobre de cuáles cambios depende. El primer y más ingenuo cambio es cuando cada mensaje que contiene un registro incluye información sobre los mensajes anteriores:
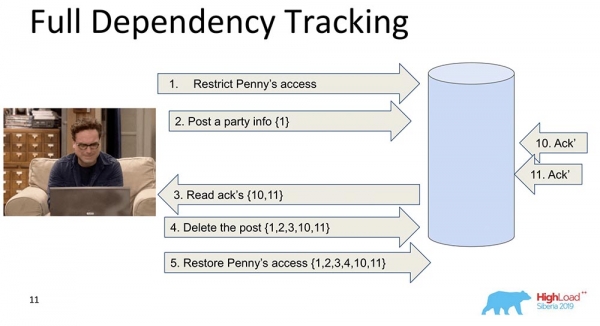
En este ejemplo, el número entre llaves corresponde a los números de los registros. A veces, estos registros con valores se transmiten en su totalidad, a veces se envían algunas versiones. La esencia reside en que cada cambio contiene información sobre el anterior (lo lleva implícitamente).
¿Por qué decidimos no utilizar este enfoque (seguimiento completo)? Obviamente, porque este enfoque es impráctico: cualquier cambio en una red social depende de todos los cambios anteriores en esa red social, transmitiendo, digamos, “Facebook” o “VKontakte” en cada actualización. Sin embargo, hay muchos estudios sobre el Full Dependency Tracking; para ciertas situaciones, realmente funciona.
Seguimiento explícito de dependencias (Explicit Dependency Tracking)
El siguiente es más limitado. Aquí también se considera la transmisión de información, pero solo aquella que depende explícitamente. Lo que depende de qué, generalmente lo determina la Aplicación. Cuando se replican los datos, en la consulta solo se devuelven respuestas cuando se han satisfecho las dependencias anteriores, es decir, se han mostrado. Esta es la esencia de cómo funciona la consistencia causal.
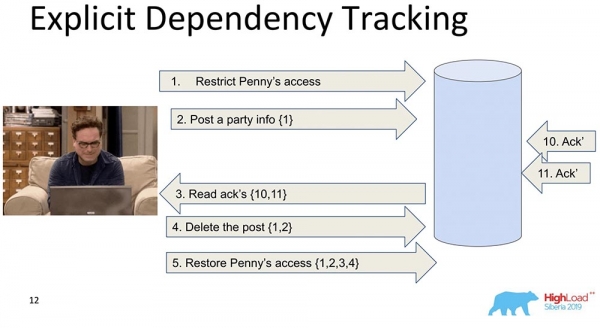
Ve que el registro 5 depende de los registros 1, 2, 3, 4; por lo tanto, espera antes de que el cliente acceda a los cambios realizados por la autorización de Penny, cuando todos los cambios anteriores ya han pasado en la base de datos.
Esto también nos desagrada, porque la información sigue siendo excesiva y eso ralentizará. Hay otro enfoque...
Relojes de Lamport (Lamport Clock)
Son muy antiguos. El reloj de Lamport implica que estas dependencias se consolidan en una función escalar, que es lo que se llama el reloj de Lamport.
Una función escalar es un cierto número abstracto. A menudo se le llama tiempo lógico. En cada evento, este contador aumenta. El contador que en este momento es conocido por el proceso envía cada mensaje. Es evidente que los procesos pueden estar desincronizados, pueden tener tiempos completamente diferentes. Sin embargo, mediante este intercambio de mensajes, el sistema equilibra de alguna manera los relojes. ¿Qué sucede en este caso?
Dividí esa gran fragmentación en dos partes para que quede claro: Friends puede vivir en un nodo que contiene una parte de la colección, mientras que Feed está en otro nodo que contiene otra parte de esta colección. ¿Es obvio cómo pueden no estar en cola? Primero Feed dirá: "Se ha replicado", y luego – Friends. Si el sistema no garantiza que Feed no se mostrará hasta que las dependencias de Friends en la colección Friends también estén entregadas, entonces se generará la situación de la que hablé.
Ves cómo aumenta el tiempo lógico del contador en Feed:
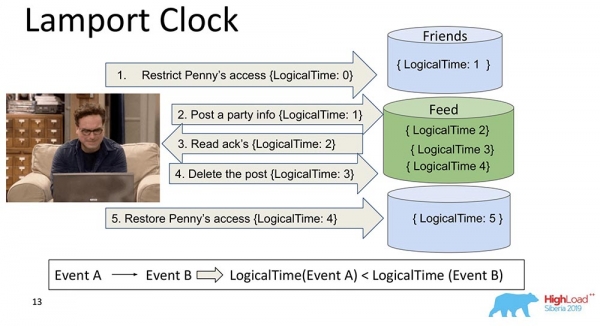
Así, la propiedad principal de este Reloj de Lamport y la consistencia causal (explicada a través del Reloj de Lamport) es la siguiente: si tenemos eventos A y B, y el evento B depende del evento A *, entonces se deduce que el LogicalTime del Evento A es menor que el LogicalTime del Evento B.
* A veces también se dice que A ocurrió antes que B, es decir, A sucedió antes de B – esta es una relación que parcialmente ordena todo el conjunto de eventos que han ocurrido.
Lo contrario no es cierto. De hecho, esta es una de las principales desventajas del Reloj de Lamport: el orden parcial. Hay un concepto de eventos simultáneos, es decir, eventos en los que ni (A ocurrió antes que B) ni (A ocurrió después de B). Un ejemplo podría ser la adición paralela de alguien a la lista de amigos por Leonard (incluso no Leonard, sino Sheldon, por ejemplo).
Esta es la propiedad que a menudo se utiliza al trabajar con relojes de Lamport: se observan precisamente la función y se infiere de esto – puede ser que estos eventos sean dependientes. Porque en un sentido esto es cierto: si LogicalTime A es menor que LogicalTime B, entonces B no puede haber ocurrido antes que A; y si es mayor, entonces puede ser.
Relojes vectoriales (Vector Clock)
El desarrollo lógico de los relojes de Lamport son los Relojes Vectoriales. Se diferencian en que cada nodo que hay aquí contiene sus propios relojes separados, y se transmiten como un vector.
En este caso, ves que el índice cero del vector corresponde a Feed, y el primer índice del vector corresponde a Friends (cada uno de estos nodos). Y ahora van a aumentar: el índice cero de "Feed" aumenta al registrar - 1, 2, 3:
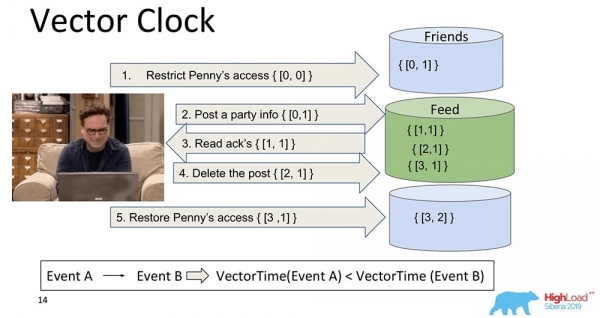
¿Por qué son mejores los relojes vectoriales? Porque permiten entender qué eventos son simultáneos y cuándo ocurren en diferentes nodos. Esto es muy importante para los sistemas de particionado, como MongoDB. Sin embargo, no lo elegimos, aunque es una gran herramienta, funciona de maravilla y probablemente nos hubiera servido...
Si tenemos 10,000 shards, no podemos transferir 10,000 componentes, incluso si comprimimos o encontramos alguna otra solución, aún así la carga útil será mucho menor que el volumen total de este vector. Por lo tanto, a regañadientes, optamos por abandonar este enfoque y pasar a otro.
Spanner TrueTime. Relojes atómicos
Dije que habría una explicación sobre el "Spanner". Es algo genial, realmente del siglo XXI: relojes atómicos, sincronización GPS.
¿Cuál es la idea? "Spanner" es un sistema de Google que recientemente se volvió accesible para las personas (le añadieron SQL). Cada transacción allí tiene un cierto timestamp. Dado que el tiempo está sincronizado*, a cada evento se le puede asignar un tiempo específico: los relojes atómicos tienen un tiempo de espera, después del cual se garantiza que "ocurre" un tiempo diferente.
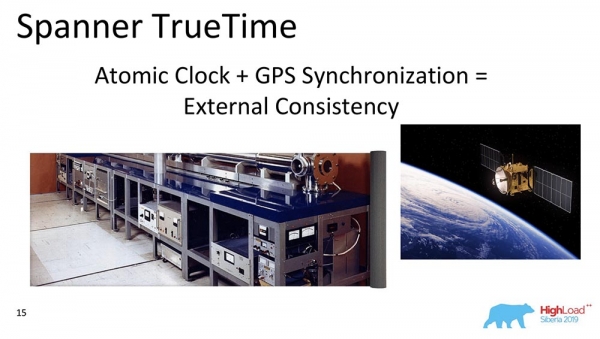
De esta manera, simplemente registrando en la base de datos y esperando un cierto período de tiempo, se garantiza automáticamente la serializabilidad del evento. Tienen el modelo de consistencia más fuerte que se puede imaginar: es una consistencia externa.
* Este es el principal problema de los relojes de Lamport: nunca están sincronizados en sistemas distribuidos. Pueden desviarse, incluso con NTP funcionan bastante mal. "Spanner" tiene relojes atómicos y sincronización, parece que está en microsegundos.
¿Por qué no lo elegimos? No suponemos que nuestros usuarios tengan relojes atómicos integrados. Cuando estos existan, integrados en cada laptop, habrá una super-sincronización GPS – entonces sí... Pero por ahora lo mejor que se puede hacer son los "Amazon", estaciones base – para los fanáticos... Por eso usamos otros relojes.
Relojes híbridos (Hybrid Clock)
Esto es, de hecho, lo que tic-tac en «MongoDB» al garantizar la consistencia causal. ¿En qué son híbridos? Híbrido es un valor escalar, pero consta de dos componentes:
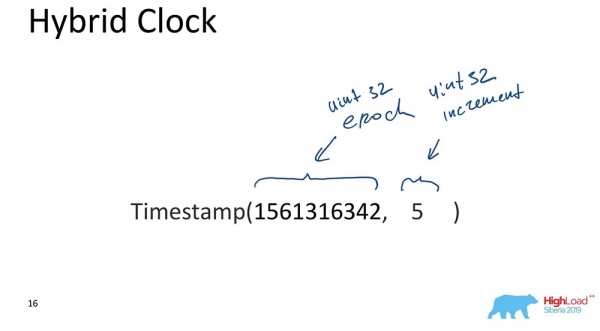
- El primero es la época unix (cuántos segundos han pasado desde el 'inicio del mundo de la computación').
- El segundo es un cierto incremento, también un entero sin signo de 32 bits.
Eso es todo. Hay un enfoque en el que la parte que se encarga del tiempo se sincroniza siempre con los relojes; cada vez que hay una actualización, esta parte se sincroniza con los relojes y resulta que el tiempo es más o menos correcto, mientras que el incremento permite distinguir eventos que ocurrieron en el mismo momento.
¿Por qué es esto importante para «MongoDB»? Porque permite hacer copias de seguridad y restauraciones en un momento específico, es decir, el evento se indexa en el tiempo. Esto es importante cuando se necesitan ciertos eventos; para la base de datos, los eventos son cambios en la base de datos que ocurrieron en intervalos de tiempo específicos.
La razón principal se la diré solo a usted (¡por favor, no se lo diga a nadie más)! Lo hicimos así porque así es como se ven los datos ordenados e indexados en MongoDB OpLog. OpLog es una estructura de datos que contiene todos los cambios en la base: primero van al OpLog y luego se aplican a Storage en caso de que sea una fecha replicada o shard.
Esta fue la razón principal. Sin embargo, también existen requisitos prácticos para el desarrollo de la base, lo que significa que debe ser simple: poco código, la menor cantidad posible de cosas rotas que deban reescribirse y probarse. El hecho de que nuestros oplogs se indexaran con relojes híbridos ayudó mucho y permitió tomar la decisión correcta. Realmente valió la pena y funcionó de manera casi mágica en el primer prototipo. ¡Fue genial!
Sincronización de relojes
Existen varias formas de sincronización descritas en la literatura científica. Estoy hablando de la sincronización cuando tenemos dos shards diferentes. Si hay un replica set, no se necesita ninguna sincronización: es un 'single-master'; tenemos un OpLog en el que se registran todos los cambios - en este caso, todo ya está ordenado secuencialmente en el propio 'OpLog'. Pero si tenemos dos shards diferentes, aquí la sincronización del tiempo es importante. ¡Aquí es donde los relojes vectoriales ayudan más! Pero no los tenemos.
El segundo método es el de los 'Heartbeats'. Se pueden intercambiar algunas señales que ocurren cada unidad de tiempo. Pero los 'Heartbeats' son demasiado lentos, no podemos garantizar la latencia a nuestro cliente.
El tiempo verdadero es, por supuesto, algo maravilloso. Pero, de nuevo, probablemente es el futuro... Aunque en 'Atlas' ya se puede hacer, ya existen rápidos sincronizadores de tiempo 'amazonianos'. Pero esto no estará disponible para todos.
El 'Gossiping' es cuando todos los mensajes contienen un tiempo. Es aproximadamente lo que usamos. Cada mensaje entre nodos, controladores, enrutadores de nodos de datos, absolutamente todo para 'MongoDB' - son elementos, componentes de la base de datos, que contienen relojes que fluyen. Todos tienen un valor de tiempo híbrido que se transmite. ¿64 bits? Eso es posible.
¿Cómo funciona todo esto junto?
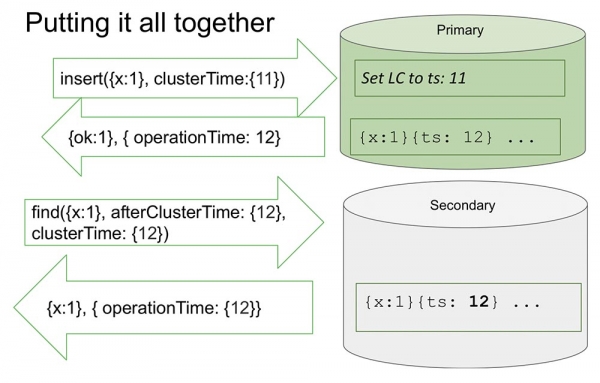
Aquí estoy considerando un replica set para que sea un poco más simple. Hay un Primary y uno Secondary. El Secondary realiza la replicación y no siempre está completamente sincronizado con el Primary.
Se produce una inserción en el 'Primary' con algún valor de tiempo. Esta inserción incrementa un contador interno en 11, si es máximo. O verificará los valores de los relojes y se sincronizará según el reloj, si los valores de los relojes son mayores. Esto permite ordenar por tiempo.
Después de que hace la escritura, ocurre un momento importante. Los relojes en 'MongoDB' solo se incrementan en caso de que se escriba en el 'OpLog'. Este es el evento que cambia el estado del sistema. En todos los artículos clásicos, el evento se considera como la llegada de un mensaje a un nodo: el mensaje ha llegado, lo que significa que el sistema ha cambiado su estado.
Esto se debe a que al investigar no se puede entender completamente cómo se interpretará este mensaje. Sabemos con certeza que si no se refleja en el "Oplog", no será interpretado de ninguna manera, y el único cambio en el estado del sistema es el registro en el "Oplog". Esto nos facilita todo: simplifica el modelo, permite organizar dentro de un único conjunto de réplicas y muchas otras cosas útiles.
Se devuelve un valor que ya está registrado en el "Oplog"; sabemos que en el "Oplog" ya se encuentra este valor, y su tiempo es 12. Ahora, digamos que se comienza a leer desde otro nodo (Secundario), y ya transmite afterClusterTime en el mismo mensaje. Él dice: "Necesito todo lo que ocurrió al menos después del 12 o en el momento de las doce" (ver la figura anterior).
Esto se denomina causalmente consistente (CAT). Hay un concepto en teoría que se refiere a un corte de tiempo que es consistente en sí mismo. En este caso, se puede decir que este es el estado del sistema que se observó en el momento 12.
Ahora aquí no hay nada, porque simula la situación en la que se necesita que el Secundario replique datos del Primario. Él espera... Y aquí llegan los datos, devolviendo estos valores de nuevo.
Así es como funciona todo más o menos. Casi.
¿Qué quiere decir "casi"? Supongamos que hay una persona que ha leído y entendido cómo funciona todo. Entendió que cada vez ocurre un ClusterTime, actualiza los relojes lógicos internos, y el siguiente registro incrementa en uno. Esta función ocupa 20 líneas. Supongamos que esta persona transmite un número máximo de 64 bits, menos uno.
¿Por qué "menos uno"? Porque los relojes internos se ajustarán a este valor (obviamente, este es el más grande posible y mayor que el tiempo actual), luego ocurrirá el registro en el "Oplog", y el reloj se incrementará en uno más, y ya tendrá el valor máximo (allí simplemente son todos unos, no hay más, unsaint int’s).
Es claro que después de esto el sistema se vuelve absolutamente inaccesible para nada. Solo se puede descargar, limpiar: mucho trabajo manual. Disponibilidad total:
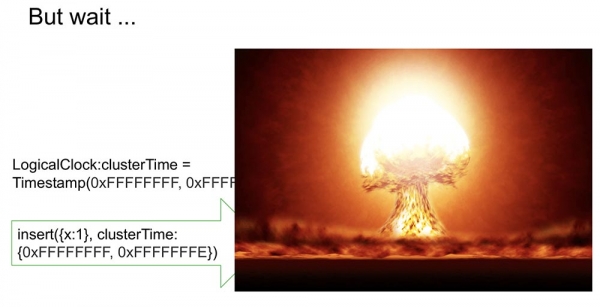
De hecho, si esto se replica a otro lugar, todo el clúster simplemente colapsa. ¡Una situación absolutamente inaceptable que cualquier persona puede organizar muy rápido y fácil! Por eso consideramos este aspecto como uno de los más importantes. ¿Cómo prevenirlo?
Nuestro enfoque es firmar clusterTime
Así se transmite en el mensaje (antes del texto azul). Pero también comenzamos a generar una firma (texto azul):
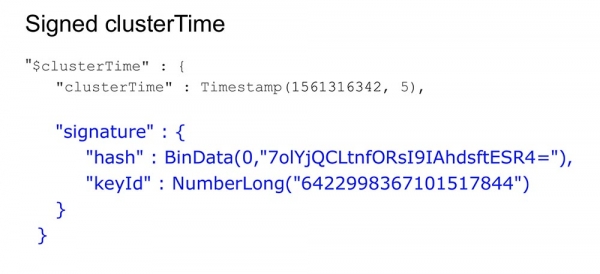
La firma se genera con una clave que se almacena dentro de la base de datos, dentro de un perímetro protegido; se genera y actualiza automáticamente (los usuarios no ven esto). Se genera un hash, y cada mensaje se firma al crearlo, y al recibirlo se valida.
Probablemente, la gente se preguntará: '¿Cuánto ralentiza todo esto?' Dije que debería funcionar rápidamente, especialmente en ausencia de esta función.
¿Qué significa usar la consistencia causal en este caso? Esto implica mostrar el parámetro afterClusterTime. Sin esto, simplemente transmitirá valores de cualquier forma. Gossiping, a partir de la versión 3.6, siempre funciona.
Si dejamos la generación constante de firmas, esto ralentizará el sistema incluso en ausencia de la función, lo que no se alinea con nuestros enfoques y requisitos. ¿Y qué hicimos?
¡Hazlo rápido!
Es algo bastante simple, pero el truco es interesante: lo compartiré, tal vez a alguien le interese.
Tenemos un hash que almacena los datos firmados. Todos los datos pasan a través de la caché. La caché no firma un tiempo específico, sino un rango. Cuando llega un cierto valor, generamos un rango, enmascaramos los últimos 16 bits y firmamos este valor:
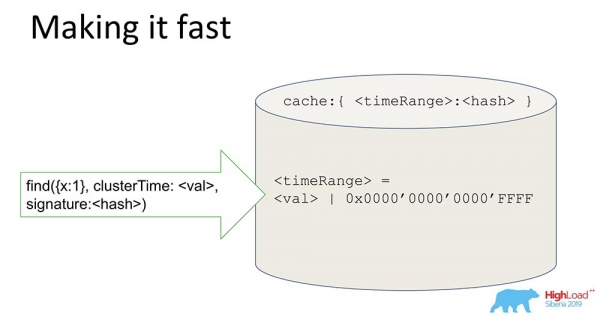
Al obtener tal firma, aceleramos el sistema (condicionalmente) 65 mil veces. Funciona perfectamente: cuando realizamos los experimentos, realmente se redujo el tiempo en 10 mil veces en nuestro proceso de actualización secuencial. Es evidente que cuando están desincronizados, esto no se logra. Pero en la mayoría de los casos prácticos, esto funciona. La combinación de la firma del rango junto con la firma permitió resolver el problema de seguridad.
¿Qué hemos aprendido?
Las lecciones que hemos extraído de esto:
- Es necesario leer materiales, historias, artículos, porque tenemos muchas cosas interesantes. Cuando estamos trabajando en alguna funcionalidad (especialmente ahora, cuando hemos hecho transacciones, etc.), es necesario leer y entender. Esto lleva tiempo, pero en realidad es muy útil, porque queda claro dónde estamos. No hemos inventado nada nuevo, simplemente hemos tomado ingredientes.
De hecho, hay una diferencia notable en el pensamiento cuando se lleva a cabo una conferencia académica (como ‘Sigmon’, por ejemplo) – allí todos se enfocan en nuevas ideas. ¿Cuál es la novedad de nuestro algoritmo? Aquí no hay gran novedad. La novedad radica más en cómo hemos combinado enfoques existentes. Por lo tanto, primero, hay que leer a los clásicos, comenzando por Lamport.
- En producción, los requisitos son completamente diferentes. Estoy seguro de que muchos de ustedes no se enfrentan a bases de datos 'esféricas' en un vacío abstracto, sino a cosas normales y reales que tienen problemas de disponibilidad, latencia y resistencia a fallos.
- Lo último es que tuvimos que considerar diferentes ideas y combinar varios artículos muy distintos en un solo enfoque. La idea sobre la firma, por ejemplo, provino de un artículo que trataba sobre el protocolo Paxos, que es para fallos no bizantinos dentro del protocolo de autorización, y para bizantinos, fuera del protocolo de autorización… En resumen, eso es exactamente lo que hemos hecho.
No hay nada absolutamente nuevo aquí. Pero en cuanto combinamos todo… Es como decir que la receta de la ensalada Olivier es una tontería porque ya se han inventado los huevos, la mayonesa y los pepinos… Es prácticamente la misma historia.
Con esto concluyo. ¡Gracias!
Preguntas
Pregunta del público (en adelante – P): – Gracias, Mikhail, por la presentación. El tema del tiempo es interesante. Ustedes utilizan Gossiping. Dijo que todos tienen su propio tiempo, todos conocen su hora local. Entiendo que tenemos controladores – puede haber muchos clientes con controladores, también habrá muchos planificadores de consultas, y muchos fragmentos… ¿A qué puede llevar el sistema si de repente hay una discrepancia: alguien decide que está un minuto adelantado, y otro que está un minuto retrasado? ¿Dónde terminaremos?
MT: – ¡Es una excelente pregunta! Justo quería hablar sobre los shards. Si entiendo bien la pregunta, tenemos la siguiente situación: shard 1 y shard 2, la lectura ocurre desde estos dos shards — tienen discrepancias, no interactúan entre sí, porque el tiempo que conocen es diferente, especialmente el tiempo que existe en sus oplogs.
Supongamos que shard 1 hizo un millón de registros, shard 2 — nada, y la solicitud llegó a los dos shards. Y el primero tiene afterClusterTime superior a un millón. En esta situación, como expliqué, shard 2 nunca responderá.
Q: – Quería saber cómo se sincronizan y eligen un tiempo lógico único.
MT: – Se sincronizan de manera muy sencilla. Cuando shard recibe afterClusterTime y no encuentra tiempo en el ‘Oplog’ — inicia no approved. Es decir, establece manualmente su tiempo a ese valor. Esto significa que no tiene eventos que respondan a esa solicitud. Crea este evento de manera artificial y así se vuelve Causal Consistent.
Q: – ¿Y si después de eso llegan eventos que se perdieron en la red?
MT: – La arquitectura de los shards es tal que ya no llegarán, ya que es single master. Si ya se ha registrado, no llegarán más, vendrán después. No puede suceder que algo se quede atascado, luego se haga no write y después esos eventos lleguen — y se rompa la consistencia causal. Cuando hace no write, todos deben llegar después (los esperará).
Q: – Tengo algunas preguntas sobre las colas. La consistencia causal implica que hay una cola de acciones que deben ejecutarse. ¿Qué sucede si se pierde un paquete? Digamos que va el 10, el 11… el 12 se pierde, y todos los demás esperan a que se ejecute. Y de repente la máquina se muere, no podemos hacer nada. ¿Hay una longitud máxima de la cola que se acumula antes de ser ejecutada? ¿Qué falla fatal ocurre al perder un solo estado? Más aún, si estamos registrando que hay un estado anterior, ¿no deberíamos basarnos en eso? ¡Pero no nos basamos en él!
MT: – ¡También es una excelente pregunta! ¿Qué hacemos? En MongoDB existe el concepto de registros de quórum y lectura de quórum. ¿En qué casos puede perderse un mensaje? Cuando la escritura no es quórum o cuando la lectura no es quórum (también puede haber algún garbage).
Realizamos una extensa verificación experimental sobre la consistencia causal, cuyo resultado indica que en los casos donde las escrituras y lecturas son no cuórum, se producen violaciones de la consistencia causal. ¡Exactamente lo que dices!
Nuestro consejo: utilizar al menos lecturas de cuórum al emplear la consistencia causal. De esta manera, no se perderá nada, incluso si la escritura de cuórum desaparece... Esta es una situación ortogonal: si el usuario no quiere que los datos se pierdan, debe utilizar escritura de cuórum. La consistencia causal no garantiza durabilidad. La durabilidad es proporcionada por la replicación y la maquinaria asociada a la replicación.
Q: – Cuando creamos una instancia que realiza el sharding (no maestro, sino esclavo), se basa en el tiempo Unix de su propia máquina o en el tiempo del 'maestro'; ¿sincroniza por primera vez o periódicamente?
MT: – Ahora aclaro. Un shard (es decir, una partición horizontal) siempre tiene un Primario. Y en el shard puede haber un 'maestro' y puede haber réplicas. Pero el shard siempre mantiene la escritura, porque debe soportar algún dominio (en el shard está el Primario).
Q: – Entonces, ¿todo depende estrictamente del 'maestro'? ¿Siempre se utiliza el tiempo del 'maestro'?
MT: – Sí. Se puede decir de manera figurada: los relojes avanzan cuando se realiza una escritura en el 'maestro', en el 'OpLog'.
Q: – Tenemos un cliente que se conecta y no necesita saber nada sobre el tiempo?
MT: – ¡No necesita saber nada en absoluto! Si hablamos de cómo funciona en el cliente: el cliente, cuando desea usar la consistencia causal, necesita abrir una sesión. Ahora allí está todo: tanto las transacciones en la sesión como el recuperar derechos... La sesión es la ordenación de eventos lógicos que ocurren con el cliente.
Si abre esta sesión y dice que quiere consistencia causal (si por defecto la sesión soporta consistencia causal), todo funciona automáticamente. El controlador recuerda este tiempo y lo incrementa cuando recibe un nuevo mensaje. Recuerda qué respuesta devolvió el servidor que proporcionó los datos. La siguiente solicitud contendrá afterCluster ('hora mayor que esta').
¡El cliente no necesita saber nada en absoluto! Es completamente opaco para él. Si las personas utilizan estas características, ¿qué se puede hacer? Primero, se pueden leer secundarias de manera segura: se puede escribir en Primaria y leer desde secundarias replicadas geográficamente y estar seguros de que funciona. Al mismo tiempo, las sesiones que se escribieron en Primaria se pueden transferir incluso a Secundaria, es decir, se puede utilizar no una sesión, sino varias.
Q: – La consistencia eventual está muy relacionada con una nueva rama de la ciencia computacional: los tipos de datos CRDT (Tipos de Datos Replicados Sin Conflictos). ¿Han considerado integrar estos tipos de datos en la base y qué pueden decir al respecto?
MT: – ¡Buena pregunta! CRDT tiene sentido para los conflictos al escribir: en MongoDB hay un único maestro.
Q: – Tengo una pregunta de los devops. En el mundo real, hay situaciones que se parecen a esto, donde ocurre una falla bizantina, y personas maliciosas dentro del perímetro protegido comienzan a interferir con el protocolo, enviando paquetes diseñados a medida de manera especial.
MT: – Las personas maliciosas dentro del perímetro son como un caballo de Troya. Pueden hacer muchas cosas malas.
Q: – Está claro que dejar un pequeño agujero en el servidor, por así decirlo, a través del cual se puede introducir un zoológico de elefantes y colapsar todo el clúster para siempre… Tomará tiempo para la recuperación manual… Esto, por decirlo suavemente, no está bien. Por otro lado, es interesante saber: en la vida real, en la práctica, ¿hay situaciones en las que ocurren de forma natural ataques internos como este?
MT: – Como no me encuentro a menudo con brechas de seguridad en la vida real, no puedo decirlo, tal vez sí ocurran. Pero si hablamos de la filosofía de desarrollo, pensamos así: tenemos un perímetro que protege a los chicos que hacen la seguridad, es como una cerradura, una pared; y dentro del perímetro se puede hacer lo que se quiera. Está claro que hay usuarios con acceso solo para ver y hay usuarios con acceso para borrar un directorio.
Dependiendo de los derechos, el daño que los usuarios pueden causar puede ser como con un ratón, o también con un elefante. Es evidente que un usuario con derechos completos puede hacer cualquier cosa. Un usuario con derechos limitados puede causar mucho menos daño. En particular, no puede romper el sistema.
Q: – En el perímetro protegido, alguien está intentando formar protocolos inesperados para el servidor, con el fin de comprometerlo y, con suerte, todo el clúster… ¿Puede llegar a ser tan "bueno"?
MT: – Nunca he oído hablar de tales cosas. Que se puede colapsar un servidor de esta manera no es un secreto. Colapsar desde dentro, estando en el protocolo, siendo un usuario autorizado que puede escribir en un mensaje algo así… En realidad no es posible, porque de todos modos se validará. Hay una posibilidad de desactivar esta autenticación para los usuarios que no lo desean; ese es entonces su problema; ellos, en términos generales, han destruido las paredes por sí mismos y se puede meter un elefante ahí que lo aplaste… En general, uno podría disfrazarse de reparador, venir y sacar todo.
Q: – Gracias por el informe. Sergey ("Yandex"). En "Mongo", hay una constante que limita el número de miembros votantes en el Replica Set, y esta constante es 7 (siete). ¿Por qué es una constante? ¿Por qué no es algún parámetro?
MT: – En Replica Set a veces tenemos hasta 40 nodos. Siempre hay mayoría. No sé qué versión es…
Q: – En el Replica Set se pueden poner miembros no votantes, pero los votantes son un máximo de 7. ¿Cómo manejar esto en caso de que tengamos un Replica Set repartido en 3 centros de datos? Un centro de datos puede apagarse fácilmente, y otra máquina puede caer fuera.
MT: – Esto ya está un poco fuera del tema de la presentación. Es una pregunta general. Tal vez luego pueda contarle.
Un poco de publicidad 🙂
Gracias por permanecer con nosotros. ¿Te gustan nuestros artículos? ¿Quieres ver más contenido interesante? Apóyanos haciendo un pedido o recomendando a tus conocidos, , un análogo único de servidores entry-level que hemos diseñado para Ti: (disponibles opciones con RAID1 y RAID10, hasta 24 núcleos y hasta 40GB DDR4).
¿Dell R730xd a mitad de precio en el centro de datos Equinix Tier IV en Ámsterdam? Solo aquí ¡en los Países Bajos! Dell R420 — 2x E5-2430 2.2Ghz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — ¡desde $99! Lee sobre cómo
Fuente: habr.com
