

La configuración del almacenamiento de datos de aplicaciones que se ejecutan en un clúster de Kubernetes se puede realizar de varias maneras. Algunas de ellas ya están obsoletas, otras han surgido recientemente. En este artículo, examinaremos el concepto de tres opciones de conexión de almacenamiento, incluida la más reciente: la conexión a través de Container Storage Interface.
Método 1. Especificar PV en el manifiesto del pod
Un manifiesto típico que describe un pod en un clúster de Kubernetes:
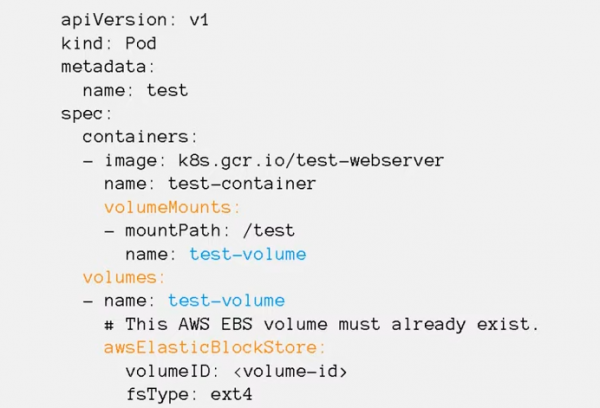
Las partes del manifiesto que indican qué volumen se conecta y dónde están resaltadas en color.
En la sección volumeMounts indican los puntos de montaje (mountPath) — en qué directorio dentro del contenedor se montará el volumen persistente, así como el nombre del volumen.
En la sección x enumeran todos los volúmenes que se utilizan en el pod. Indican el nombre de cada volumen, así como su tipo (en nuestro caso: awsElasticBlockStore) y los parámetros de conexión. Los parámetros exactos que se enumeran en el manifiesto dependen del tipo de volumen.
El mismo volumen puede montarse simultáneamente en varios contenedores del pod. De este modo, diferentes procesos de la aplicación pueden tener acceso a los mismos datos.
Este método de conexión se ideó al principio, cuando Kubernetes apenas comenzaba, y hoy en día está obsoleto.
Su uso plantea varios problemas:
- todos los volúmenes deben ser creados manualmente, Kubernetes no podrá crear nada por nosotros;
- los parámetros de acceso a cada uno de los volúmenes son únicos y deben especificarse en los manifiestos de todos los pods que utilizan el volumen;
- si se desea cambiar el sistema de almacenamiento (por ejemplo, trasladarse de AWS a Google Cloud), se deben cambiar las configuraciones y el tipo de volúmenes conectados en todos los manifiestos.
Todo esto es muy incómodo, por lo que en la práctica este método solo se utiliza para conectar algunos tipos especiales de volúmenes: configMap, secret, emptyDir, hostPath:
configMap y secret — son volúmenes de servicio que permiten crear en el contenedor un volumen con archivos de los manifiestos de Kubernetes.
emptyDir — es un volumen temporal que se crea solo durante la vida útil del pod. Es conveniente usarlo para pruebas o almacenamiento de datos temporales. Cuando se elimina el pod, el volumen de tipo emptyDir también se elimina y todos los datos desaparecen.
hostPath permite montar cualquier directorio del disco local del servidor que ejecuta la aplicación dentro del contenedor de la aplicación, incluyendo /etc/kubernetes. Esta es una capacidad insegura, por lo que las políticas de seguridad suelen prohibir el uso de volúmenes de este tipo. De lo contrario, un atacante podría montar el directorio HTC Kubernetes dentro de su contenedor y robar todos los certificados del clúster. En general, se permite el uso de volúmenes hostPath solo para aplicaciones del sistema que se ejecutan en el namespace kube-system.
se indican en la documentación.
Método 2. Conexión a pods SC/PVC/PV
Un método alternativo de conexión es la concepción de Storage class, PersistentVolumeClaim, PersistentVolume.
Storage class almacena los parámetros de conexión al sistema de almacenamiento.
PersistentVolumeClaim describe los requisitos del volumen que la aplicación necesita.
PersistentVolume almacena los parámetros de acceso y el estado del volumen.
La idea es la siguiente: en el manifiesto del pod se indica un volumen del tipo PersistentVolumeClaim y se especifica el nombre de esta entidad en el parámetro claimName.
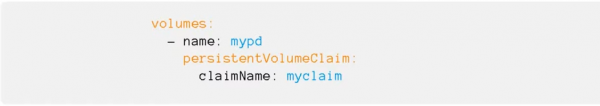
En el manifiesto de PersistentVolumeClaim se describen los requisitos para el volumen de datos que la aplicación necesita. Incluyendo:
- tamaño del disco;
- modo de acceso: ReadWriteOnce o ReadWriteMany;
- referencia a Storage class — en qué sistema de almacenamiento queremos crear el volumen.
En el manifiesto de Storage class se almacenan el tipo y los parámetros de conexión al sistema de almacenamiento. Son necesarios para que el kubelet monte el volumen en su nodo.
En los manifiestos de PersistentVolume se especifica Storage class y los parámetros de acceso a un volumen específico (ID del volumen, ruta, etc.).
Al crear PVC, Kubernetes verifica qué volumen de qué tamaño y de qué Storage class se necesita, y selecciona un PersistentVolume libre.
Si no hay PV disponibles, Kubernetes puede iniciar un programa especial: Provisioner (su nombre se indica en Storage class). Este programa se conecta al sistema de almacenamiento, crea un volumen del tamaño requerido, obtiene el identificador y crea un manifiesto de PersistentVolume en el clúster de Kubernetes que se vincula con el PersistentVolumeClaim.
Todo este conjunto de abstracciones permite eliminar la información sobre qué sistema de almacenamiento utiliza la aplicación, del nivel del manifiesto de aplicaciones al nivel de administración.
Todos los parámetros de conexión al sistema de almacenamiento se encuentran en la clase de almacenamiento, de la cual son responsables los administradores del clúster. Todo lo que se necesita hacer al cambiar de AWS a Google Cloud es modificar el nombre de la clase de almacenamiento en el PVC dentro de los manifiestos de la aplicación. El volumen persistente para el almacenamiento de datos será creado automáticamente en el clúster mediante el programa Provisioner.
Método 3. Interfaz de Almacenamiento de Contenedores
Todo el código que interactúa con los diferentes sistemas de almacenamiento es parte del núcleo de Kubernetes. La publicación de correcciones de errores o nuevas funcionalidades está ligada a nuevos lanzamientos, lo que obliga a modificar el código para todas las versiones de Kubernetes que se soportan. Todo esto es difícil de mantener y de añadir nuevas funcionalidades.
Para abordar el problema, los desarrolladores de Cloud Foundry, Kubernetes, Mesos y Docker crearon la Interfaz de Almacenamiento de Contenedores (CSI), una interfaz unificada y sencilla que describe la interacción entre el sistema de gestión de contenedores y un controlador específico (Controlador CSI) que trabaja con un sistema de almacenamiento particular. Todo el código que interactúa con el sistema de almacenamiento se ha sacado del núcleo de Kubernetes a un sistema separado.
.
Por lo general, el Controlador CSI consta de dos componentes: el Plugin de Nodo y el Plugin de Controlador.
El Plugin de Nodo se ejecuta en cada nodo y es responsable de montar volúmenes y realizar operaciones sobre ellos. El Plugin de Controlador interactúa con el sistema de almacenamiento: crea o elimina volúmenes, asigna permisos de acceso, etc.
Mientras en el núcleo de Kubernetes permanezcan los controladores antiguos, no se recomienda su uso, y se aconseja a todos instalar el Controlador CSI específico para el sistema con el que se trabajará.
La novedad puede asustar a aquellos que ya están acostumbrados a configurar el almacenamiento a través de la clase de almacenamiento, pero en realidad no ha sucedido nada grave. Para los programadores, nada cambia realmente: seguirán trabajando solo con el nombre de la clase de almacenamiento. Para los administradores, se ha añadido la instalación del gráfico de helm y se ha modificado la estructura de configuración. Si antes las configuraciones se introducían directamente en la clase de almacenamiento, ahora primero deben definirse en el gráfico de helm y luego en la clase de almacenamiento. Si se analiza, no ha pasado nada grave.
Veamos, con un ejemplo, qué ventajas se pueden obtener al cambiar a la conexión al sistema de almacenamiento Ceph mediante el controlador CSI.
Al trabajar con Ceph, el plugin CSI ofrece más posibilidades para interactuar con el sistema de almacenamiento que los controladores integrados.
- Creación dinámica de discos. Normalmente, los discos RBD se utilizan solo en modo RWO, mientras que CSI para Ceph permite usarlos en modo RWX. Varios pods en diferentes nodos pueden montar el mismo disco RBD en sus nodos y trabajar con él de manera paralela. Para ser justos, no todo es tan brillante: este disco solo se puede conectar como un dispositivo de bloque, es decir, se debe adaptar la aplicación para que funcione con él en modo de acceso compartido.
- Creación de instantáneas. En el clúster de Kubernetes, se puede crear un manifiesto que solicite la creación de una instantánea. El complemento CSI lo verá y creará una instantánea del disco. Con base en ella, se podrá hacer una copia de seguridad o una copia del PersistentVolume.
- Aumento del tamaño del disco en el almacenamiento y en el PersistentVolume del clúster de Kubernetes.
- Cuotas. Los controladores CephFS integrados en Kubernetes no admiten cuotas, y los nuevos complementos CSI con el nuevo Ceph Nautilus pueden habilitar cuotas en las particiones de CephFS.
- Métricas. El complemento CSI puede proporcionar a Prometheus muchas métricas sobre qué volúmenes están conectados, qué interacciones están ocurriendo, etc.
- Consciente de la topología. Permite especificar en los manifiestos cómo está distribuido geográficamente el clúster y evitar la conexión a pods que se están ejecutando en Londres de un sistema de almacenamiento de datos ubicado en Ámsterdam.
Cómo conectar Ceph al clúster de Kubernetes a través de CSI, véase . También se puede suscribir a , que comenzará el 15 de octubre.
Autor del artículo: Sergey Bondarev, arquitecto practicante de Southbridge, Administrador Certificado de Kubernetes, uno de los desarrolladores de kubespray.
Un poco de Post Scriptum no es publicidad, sino por utilidad…
P.D. Sergey Bondarev lleva a cabo dos intensivos: el actualizado del 28 al 30 de septiembre y uno avanzado del 14 al 16 de octubre.
Fuente: habr.com
