

Durante más de 20 años hemos estado navegando por páginas web a través del protocolo HTTP. La mayoría de los usuarios ni siquiera se detiene a pensar en lo que es y cómo funciona. Otros saben que debajo de HTTP está TLS, y debajo de este TCP, y luego IP, y así sucesivamente. Y hay quienes, considerados herejes, creen que TCP es cosa del pasado y desean algo más rápido, confiable y seguro. Pero en sus intentos de inventar un nuevo protocolo ideal, han regresado a las tecnologías de los años 80, tratando de construir su maravilloso nuevo mundo sobre ellas.
Un poco de historia: HTTP/1.1
En 1997, el protocolo de intercambio de información textual HTTP versión 1.1 obtuvo su RFC. En ese momento, el protocolo ya había sido utilizado por los navegadores durante varios años, y el nuevo estándar se mantuvo vigente durante otros quince. El protocolo funcionaba únicamente según el principio de solicitud-respuesta y estaba destinado, principalmente, a la transmisión de información textual.
HTTP fue diseñado para funcionar sobre el protocolo TCP, que garantiza la entrega confiable de paquetes al destinatario. El funcionamiento de TCP se basa en establecer y mantener una conexión confiable entre los puntos finales y en segmentar el tráfico. Los segmentos tienen un número de serie y un valor de comprobación. Si alguno de los segmentos no llega o llega con un valor de comprobación incorrecto, la transmisión se detiene hasta que se recupere el segmento perdido.
En HTTP/1.0, la conexión TCP se cerraba después de cada solicitud. Esto era sumamente derrochador, ya que establecer una conexión TCP (3-Way-Handshake) no es un proceso rápido. En HTTP/1.1 se introdujo el mecanismo keep-alive, que permite reutilizar una conexión para varias solicitudes. Sin embargo, ya que esto puede convertirse fácilmente en un cuello de botella, en diferentes implementaciones de HTTP/1.1 se permite abrir varias conexiones TCP a un mismo host. Por ejemplo, en Chrome y en las últimas versiones de Firefox se permiten hasta seis conexiones.
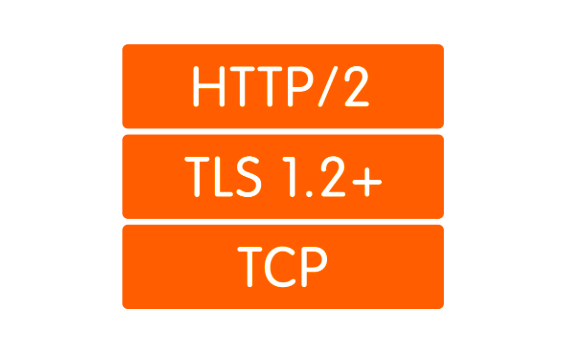
Se suponía que la cifrado también sería delegado a otros protocolos, y para ello, sobre TCP se comenzó a utilizar el protocolo TLS, que protege los datos de manera bastante confiable, pero también incrementó aún más el tiempo necesario para establecer una conexión. En consecuencia, el proceso de handshake se veía así:
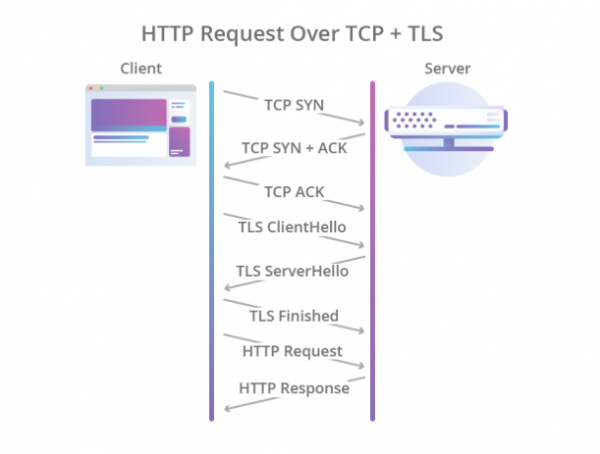
Ilustración de Cloudflare
De este modo, HTTP/1.1 tenía varios problemas:
- Lento establecimiento de la conexión.
- Los datos se transmiten en formato de texto, lo que significa que la transmisión de imágenes, videos y otra información no textual no es eficiente.
- Una conexión TCP se utiliza para una solicitud, por lo que las demás solicitudes deben encontrar otra conexión o esperar a que la solicitud actual la libere.
- Solo se admite el modelo de pull. No hay nada en el estándar sobre server-push.
- Las cabeceras se transmiten como texto.
Si bien el server-push se implementa más o menos a través del protocolo WebSocket, había que abordar otros problemas de manera más radical.
Un poco de modernidad: HTTP/2
En 2012, en las entrañas de Google, comenzó a trabajarse en el protocolo SPDY (se pronuncia 'speedy'). Este protocolo estaba destinado a resolver los principales problemas de HTTP/1.1, mientras mantenía la compatibilidad hacia atrás. En 2015, el grupo de trabajo de IETF presentó la especificación HTTP/2, basada en el protocolo SPDY. Estas son las diferencias en HTTP/2:
- Serialización binaria.
- Multiplexación de múltiples solicitudes HTTP en una única conexión TCP.
- Server-push de serie (sin WebSocket).
El protocolo representó un gran avance. Es significativamente y no requiere la creación de múltiples conexiones TCP: todas las solicitudes a un mismo host se multiplexan en una sola. Es decir, en una conexión hay varios llamados streams, cada uno con su ID. Como ventaja extra, viene con server-push.
Sin embargo, la multiplexación lleva a otro problema crucial. Imagina que estamos realizando 5 solicitudes asincrónicas a un mismo servidor. Con HTTP/2, todas estas solicitudes se ejecutarán en el marco de una única conexión TCP, así que si se pierde un segmento de cualquiera de las solicitudes o llega incorrecto, la transmisión de todas las solicitudes y respuestas se detendrá hasta que se recupere el segmento perdido. Es evidente que cuanto peor sea la calidad de la conexión, más lento funcionará HTTP/2. , en condiciones en las que los paquetes perdidos representan el 2% del total, HTTP/1.1 en el navegador se comporta mejor que HTTP/2 porque abre 6 conexiones en lugar de una.
Este problema se llama 'head-of-line blocking' y, lamentablemente, no parece posible resolverlo utilizando TCP.
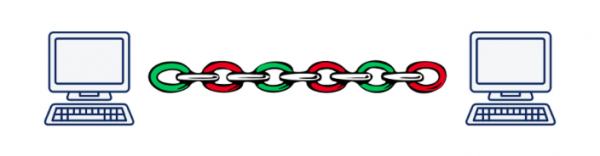
Ilustración de Daniel Steinberg
Como resultado, los desarrolladores del estándar HTTP/2 hicieron un gran trabajo y lograron prácticamente todo lo que se podía hacer a nivel de aplicación en el modelo OSI. Ha llegado el momento de descender al nivel de transporte e inventar un nuevo protocolo de transporte.
Necesitamos un nuevo protocolo: UDP vs TCP
Pronto quedó claro que implementar un protocolo de transporte completamente nuevo es una tarea prácticamente irreversible en la actualidad. Esto se debe a que el hardware, como los routers, firewalls y servidores NAT, conocen el nivel de transporte, y enseñarles algo nuevo es una tarea extremadamente complicada. Además, el soporte para protocolos de transporte está integrado en el núcleo de los sistemas operativos, y los núcleos no cambian tan fácilmente.
Aquí podríamos rendirnos y decir: "Claro, inventaremos un nuevo HTTP/3 con preferencias y cortesanas, pero su implementación llevará de 10 a 15 años (aproximadamente el tiempo que tardará en reemplazarse la mayoría del hardware)". Sin embargo, hay otra opción, no tan obvia: usar el protocolo UDP. Sí, ese mismo protocolo con el que intercambiábamos archivos en la red local a finales de los noventa y principios de los dos mil. Prácticamente todos los dispositivos actuales saben cómo trabajar con él.
¿Cuáles son las ventajas de UDP en comparación con TCP? En primer lugar, no tenemos una sesión de transporte que conozcan los dispositivos. Esto nos permite definir nosotros mismos la sesión en los puntos finales y solucionar los conflictos que surjan. Es decir, no estamos limitados a una o varias sesiones (como en TCP), sino que podemos crear tantas como necesitemos. En segundo lugar, la transmisión de datos por UDP es más rápida que por TCP. Así, en teoría, podríamos romper el techo de velocidad alcanzado en HTTP/2.
Sin embargo, UDP no garantiza la fiabilidad en la transmisión de datos. De hecho, simplemente enviamos paquetes, esperando que sean recibidos en el otro extremo. ¿No se recibieron? Bueno, no hubo suerte... Esto fue suficiente para la transmisión de videos para adultos, pero para cosas más serias se requiere fiabilidad, lo que significa que tendremos que añadir algo más sobre UDP.
Al igual que con HTTP/2, el trabajo en la creación de un nuevo protocolo comenzó en Google en 2012, es decir, aproximadamente al mismo tiempo que se inició el trabajo en SPDY. En 2013, Jim Roskind presentó al público en general , y ya en 2015 se presentó un borrador de Internet para su estandarización en la IETF. En ese momento, el protocolo desarrollado por Roskind en Google difería significativamente del propuesto para el estándar, por lo que la versión de Google comenzó a llamarse gQUIC.
¿Qué es QUIC?
En primer lugar, como ya se mencionó, es un envoltorio sobre UDP. Sobre UDP se establece una conexión QUIC, en la que, al igual que en HTTP/2, pueden existir múltiples flujos. Estos flujos existen solo en los puntos finales y se gestionan de manera independiente. Si se pierde un paquete en un flujo, los demás no se ven afectados.
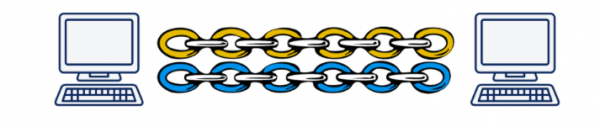
Ilustración de Daniel Steinberg
En segundo lugar, el cifrado ahora se implementa no como un nivel separado, sino que está incorporado en el protocolo. Esto permite establecer conexiones y compartir claves públicas en un solo apretón de manos, y también permite utilizar un ingenioso mecanismo de apretón de manos 0-RTT y evitar retrasos durante el apretón de manos. Además, ahora es posible cifrar paquetes de datos individuales. Esto permite no esperar a que se complete la recepción de datos del flujo, sino descifrar los paquetes recibidos de manera independiente. Este modo de operación era totalmente imposible en TCP, ya que TLS y TCP funcionaban de forma independiente, y TLS no podía saber en qué fragmentos se dividirían los datos de TCP. Por lo tanto, no podía preparar sus segmentos para que coincidieran uno a uno con los segmentos de TCP y pudieran ser descifrados de manera independiente. Todas estas mejoras permiten a QUIC reducir la latencia en comparación con TCP.
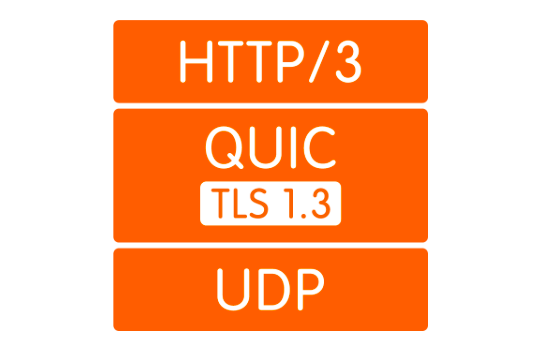
En tercer lugar, el concepto de flujos ligeros permite desacoplar la conexión de la dirección IP del cliente. Esto es importante, por ejemplo, cuando el cliente cambia de un punto de acceso Wi-Fi a otro, cambiando su IP. En este caso, al usar TCP, ocurre un prolongado proceso en el que las conexiones TCP existentes se caen por timeout y se crean nuevas conexiones desde la nueva IP. En el caso de QUIC, el cliente simplemente sigue enviando paquetes al servidor desde la nueva IP con el ID de flujo anterior. Dado que el ID de flujo ahora es único y no se reutiliza, el servidor entiende que el cliente ha cambiado de IP, reenvía los paquetes perdidos y continúa la comunicación desde la nueva dirección.
En cuarto lugar, QUIC se implementa a nivel de aplicación, no del sistema operativo. Esto, por un lado, permite realizar cambios en el protocolo más rápidamente, ya que solo es necesario actualizar la biblioteca, en lugar de esperar una nueva versión del sistema operativo. Por otro lado, esto conlleva un aumento significativo en el consumo del procesador.
Y por último, los encabezados. La compresión de los encabezados es uno de los puntos que difieren entre QUIC y gQUIC. No veo mucho sentido en dedicarle mucho tiempo a esto, solo diré que en la versión sometida a estandarización, la compresión de los encabezados se hizo lo más parecida posible a la compresión de los encabezados en HTTP/2. Se puede leer más al respecto. .
¿Cuán rápido es?
Es una pregunta compleja. El hecho es que, hasta que tengamos un estándar, no hay nada que medir. Tal vez, los únicos datos estadísticos de los que disponemos son las estadísticas de Google, que utiliza gQUIC desde 2013 y en 2016 , que aproximadamente el 90% del tráfico que llega a sus servidores desde el navegador Chrome ahora utiliza QUIC. En esta misma presentación, informan que a través de gQUIC, las páginas se cargan aproximadamente un 5% más rápido, y en video en streaming hay un 30% menos de interrupciones en comparación con TCP.
En 2017, un grupo de investigadores liderados por Arash Molavi Kakhki publicó sobre el rendimiento de gQUIC en comparación con TCP.
La investigación identificó varias debilidades de gQUIC, como la inestabilidad ante la mezcla de paquetes de red, la codicia (unfairness) en el ancho de banda del canal y una transmisión más lenta de objetos pequeños (hasta 10 kB). Sin embargo, esto último se puede compensar utilizando 0-RTT. En todos los demás casos investigados, gQUIC mostró un aumento en la velocidad en comparación con TCP. Es difícil hablar de cifras aquí. Es mejor leer o .
Es importante mencionar que estos datos se refieren específicamente a gQUIC y no son relevantes para el estándar en desarrollo. Lo que sucederá con QUIC: por ahora es un misterio, pero hay esperanzas de que las debilidades identificadas en gQUIC sean tomadas en cuenta y corregidas.
Un poco de futurismo: ¿qué pasa con HTTP/3?
Aquí todo está cristalino: la API no cambiará en absoluto. Todo permanecerá exactamente como estaba en HTTP/2. Si la API sigue siendo la misma, la transición a HTTP/3 deberá resolverse utilizando en el backend una versión reciente de la biblioteca que soporte el transporte por QUIC. Sin embargo, todavía tendremos que mantener compatibilidad con las versiones anteriores de HTTP, ya que Internet aún no está listo para una transición completa a UDP.
¿Quién ya lo soporta?
Aquí implementaciones existentes de QUIC. A pesar de la falta de un estándar, la lista es bastante buena.
Ningún navegador soporta actualmente QUIC en la versión de producción. Recientemente, hubo información de que Chrome activó el soporte para HTTP/3, pero solo en Canary.
De los backends, solo HTTP/3 es soportado por y , aunque de manera experimental. NGINX a finales de la primavera de 2019 , que comenzaron a trabajar en el soporte de HTTP/3, pero aún no han terminado.
¿Cuáles son los problemas?
Vivimos en un mundo real donde ninguna gran tecnología puede llegar a las masas sin enfrentar resistencia, y QUIC no es la excepción.
Lo más importante es que necesitamos explicar al navegador que "https://" ahora no necesariamente conduce al puerto 443 de TCP. Puede que no haya TCP en absoluto. Para esto se utiliza el encabezado Alt-Svc. Permite informar al navegador que este sitio web también está disponible en un protocolo específico en una dirección determinada. En teoría, esto debería funcionar como la seda, pero en la práctica nos encontraremos con que UDP puede estar, por ejemplo, bloqueado en el firewall para evitar ataques DDoS.
Pero incluso si UDP no está bloqueado, el cliente puede estar detrás de un router NAT, que está configurado para mantener la sesión TCP por dirección IP, y dado que usamos UDP, que no tiene sesión a nivel de hardware, el NAT no mantendrá la conexión, y la sesión QUIC .
Todos estos problemas están relacionados con el hecho de que UDP no se había utilizado antes para la transmisión de contenido en Internet, y los fabricantes de hardware no pudieron prever que esto sucedería algún día. De la misma manera, los administradores todavía no comprenden bien cómo configurar correctamente sus redes para trabajar con QUIC. Esta situación cambiará poco a poco, y, en cualquier caso, tales cambios llevarán menos tiempo que la implementación de un nuevo protocolo de nivel de transporte.
Además, como ya se ha mencionado, QUIC aumenta considerablemente el uso de CPU. Daniel Stenberg el incremento en el uso de CPU hasta tres veces.
¿Cuándo llegará HTTP/3?
El estándar Para mayo de 2020, sin embargo, dado que actualmente hay documentos que aún no están terminados, programados para julio de 2019, se puede decir que la fecha probablemente se aplazará.
Google ha estado utilizando su implementación de gQUIC desde 2013. Si miramos la solicitud HTTP que se envía al motor de búsqueda de Google, podemos ver esto:
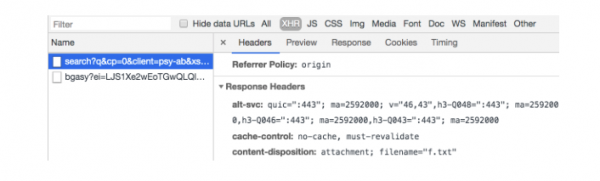
Conclusiones
QUIC actualmente se presenta como una tecnología algo cruda pero muy prometedora. Dado que en los últimos 20 años todas las optimizaciones de los protocolos de nivel de transporte han estado principalmente centradas en TCP, QUIC, que en la mayoría de los casos supera en rendimiento, ya se ve bastante bien.
Sin embargo, todavía hay problemas no resueltos que debemos enfrentar en los próximos años. El proceso puede extenderse debido a que está involucrado hardware que nadie quiere actualizar, pero, sin embargo, todos los problemas parecen ser solucionables, y tarde o temprano todos tendremos HTTP/3.
¡El futuro está cerca!
Fuente: habr.com
