

El 26 de febrero celebramos un meetup de Apache Ignite GreenSource, donde presentaron contribuyentes del proyecto de código abierto. Un evento importante en la vida de esta comunidad fue la reestructuración del componente , que permite desplegar microservicios personalizados directamente en el clúster Ignite. Sobre este complejo proceso habló , ingeniero de software y contribuyente de Apache Ignite desde hace más de dos años.
Comencemos explicando qué es Apache Ignite. Es una base de datos que actúa como un almacén distribuido de clave/valor con soporte para SQL, transacciones y caché. Además, Ignite permite desplegar servicios personalizados directamente en el clúster Ignite. El desarrollador tiene acceso a todas las herramientas que ofrece Ignite: estructuras de datos distribuidas, mensajería, streaming, computación y Data Grid. Por ejemplo, al usar Data Grid se elimina el problema de administrar una infraestructura separada para el almacenamiento de datos, así como los costos indirectos resultantes.
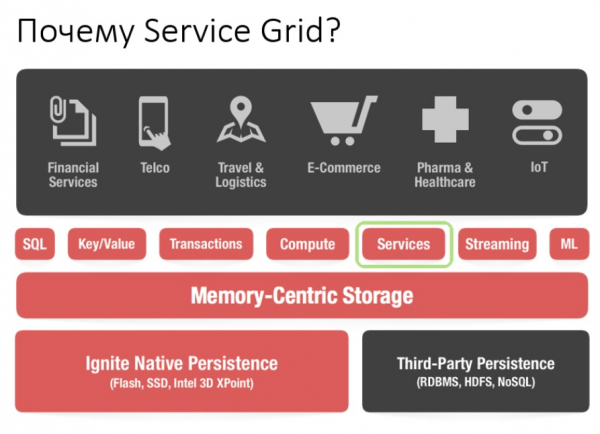
Utilizando la API de Service Grid, se puede desplegar un servicio simplemente especificando en la configuración el esquema de despliegue y, por supuesto, el propio servicio.
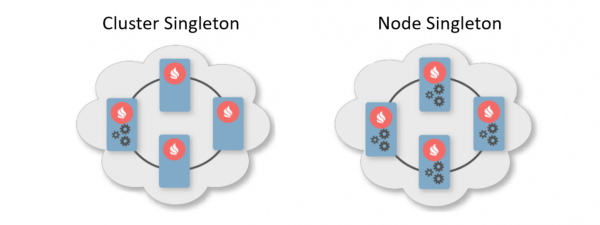
Generalmente, el esquema de despliegue significa indicar la cantidad de instancias que deben desplegarse en los nodos del clúster. Existen dos esquemas de despliegue típicos. El primero es Cluster Singleton: en cualquier momento en el clúster habrá garantizado un único ejemplar del servicio personalizado. El segundo es Node Singleton: en cada nodo del clúster se despliega un ejemplar del servicio.
El usuario también puede especificar la cantidad de instancias del servicio en todo el clúster y definir un predicado para filtrar nodos adecuados. En este escenario, Service Grid calculará automáticamente la distribución óptima para el despliegue de servicios.
Además, existe una función llamada Affinity Service. Affinity es una característica que determina la relación entre las claves y las particiones, así como la relación entre los grupos y los nodos en la topología. A través de la clave se puede identificar el nodo primario donde se almacenan los datos. De esta manera, puedes asociar tu propio servicio con una clave y la caché de la función affinity. En caso de que cambie la función affinity, se realizaría un redeployment automático. Así, el servicio siempre estará ubicado cerca de los datos que necesita manipular, reduciendo así los costos de acceso a la información. Este esquema puede considerarse como una especie de computación colocalizada.
Ahora que hemos explorado las ventajas de Service Grid, hablemos de su historia de desarrollo.
Lo que había antes
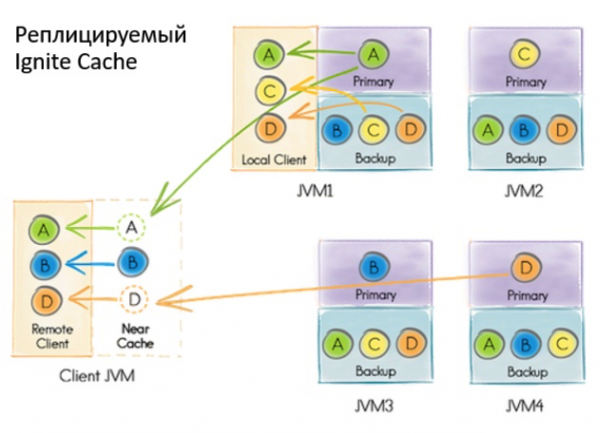
La implementación anterior de Service Grid se basaba en un caché de sistema replicado transaccional Ignite. Por "caché" en Ignite se entiende un almacenamiento. Es decir, no es algo temporal, como se podría pensar. A pesar de que el caché es replicado y cada nodo contiene todo el conjunto de datos, dentro del caché existe una representación particionada. Esto está relacionado con la optimización de los almacenes.
¿Qué sucedía cuando un usuario quería desplegar un servicio?
- Todos los nodos del clúster se suscribían a la actualización de datos en el almacenamiento mediante el mecanismo incorporado Continuous Query.
- El nodo iniciador, bajo una transacción read-committed, realizaba una escritura en la base de datos que contenía la configuración del servicio, incluyendo la instancia serializada.
- Al recibir la notificación de una nueva entrada, el coordinador calculaba la distribución a partir de la configuración. El objeto obtenido se escribía de nuevo en la base de datos.
- Si un nodo entraba en la distribución, el coordinador debía desplegarlo.
Lo que no nos satisfacía
En algún momento, llegamos a la conclusión de que no se podía trabajar así con los servicios. Las razones eran varias.
Si durante el despliegue ocurría algún error, solo se podía conocer a través de los registros del nodo donde ocurrió todo. Existía solo un despliegue asíncrono, así que después de devolver el control al usuario desde el método de despliegue, era necesario un tiempo adicional para iniciar el servicio, y durante ese tiempo, el usuario no podía administrar nada. Para avanzar en Service Grid, desarrollar nuevas funciones, atraer nuevos usuarios y facilitar la vida a todos, era necesario realizar cambios.
Al diseñar la nueva Service Grid, queríamos ofrecer primero la garantía de un despliegue síncrono: tan pronto como el usuario recupera el control de la API, puede comenzar a utilizar los servicios de inmediato. También deseábamos brindar al iniciador la posibilidad de manejar los errores de despliegue.
Además, queríamos facilitar la implementación, específicamente alejarnos de las transacciones y el reequilibrio. A pesar de que la caché es replicable y no hay balanceo, durante un gran despliegue con múltiples nodos surgieron problemas. Al cambiar la topología, los nodos deben intercambiar información, y durante un gran despliegue, estos datos pueden ser muy pesados.
Cuando la topología era inestable, el coordinador necesitaba recalcular la distribución de los servicios. Y en general, cuando se trabaja con transacciones en una topología inestable, esto puede llevar a errores difíciles de predecir.
Problemas
¿Qué cambios globales vienen sin problemas asociados? El primero de ellos fue el cambio de topología. Hay que entender que en cualquier momento, incluso durante el despliegue de un servicio, un nodo puede unirse o salir del clúster. Además, si un nodo entra en el clúster durante el despliegue, se necesita transmitir de manera consistente toda la información sobre los servicios al nuevo nodo. Y esto no solo se refiere a lo que ya ha sido desplegado, sino también a los despliegues actuales y futuros.
Este es solo uno de los problemas que se pueden recopilar en una lista separada:
- ¿Cómo desplegar servicios configurados estáticamente al iniciar un nodo?
- Salida de un nodo del clúster: ¿qué hacer si el nodo alojó servicios?
- ¿Qué hacer si el coordinador cambia?
- ¿Qué hacer si el cliente se reconecta al clúster?
- ¿Es necesario manejar las solicitudes de activación / desactivación y cómo?
- ¿Y si se invoca la destrucción de la caché y tenemos servicios de afinidad vinculados a ella?
Y esto no es todo.
Solución
Como objetivo, elegimos un enfoque basado en eventos con una implementación de comunicación entre procesos a través de mensajes. En Ignite ya se han implementado dos componentes que permiten a los nodos enviar mensajes entre sí: communication-spi y discovery-spi.
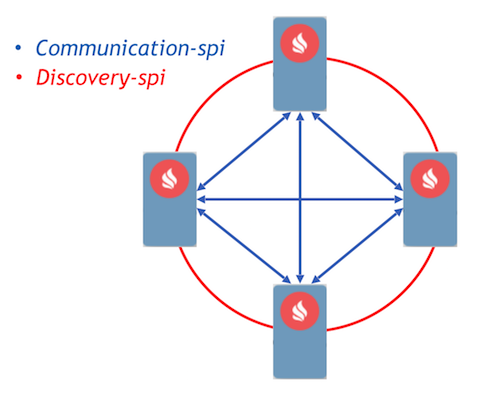
Communication-spi permite que los nodos se comuniquen directamente y envíen mensajes. Es adecuado para el envío de grandes volúmenes de datos. Discovery-spi permite enviar un mensaje a todos los nodos en el clúster. En la implementación estándar, esto se realiza mediante la topología "anillo". También hay integración con Zookeeper, en este caso se utiliza la topología "estrella". Además, es importante señalar que discovery-spi proporciona garantías de que el mensaje se entregará en el orden correcto a todos los nodos.
Analicemos el protocolo de despliegue. Todas las solicitudes de los usuarios para desplegar y desimplantar se envían a través de discovery-spi. Esto proporciona las siguientes garantías:
- La solicitud será recibida por todos los nodos en el clúster. Esto permitirá continuar el procesamiento de la solicitud al cambiar de coordinador. También significa que cada nodo tendrá todos los metadatos necesarios para un mensaje, como la configuración del servicio y su instancia serializada.
- Un estricto orden de entrega de mensajes permite resolver conflictos de configuraciones y solicitudes en competencia.
- Dado que la entrada de un nodo en la topología también se maneja a través de discovery-spi, el nuevo nodo recibirá todos los datos necesarios para trabajar con los servicios.
Al recibir una solicitud, los nodos en el clúster la validan y crean tareas para procesarla. Estas tareas se colocan en una cola y luego se procesan en otro hilo por un trabajador separado. Esto se implementa de esta manera porque el despliegue puede llevar un tiempo considerable y retardar el valioso flujo de discovery es inaceptable.
Todas las solicitudes de la cola son procesadas por el gestor de despliegue. Tiene un trabajador especial que extrae una tarea de esta cola e inicia su proceso para comenzar el despliegue. Después de esto, se realizan las siguientes acciones:
- Cada nodo calcula de forma independiente la distribución gracias a una nueva función de asignación determinista.
- Los nodos forman un mensaje con los resultados del despliegue y lo envían al coordinador.
- El coordinador agrega todos los mensajes y forma el resultado de todo el proceso de despliegue, que se envía a través de discovery-spi a todos los nodos en el clúster.
- Al recibir el resultado, el proceso de despliegue finaliza, después de lo cual la tarea se elimina de la cola.
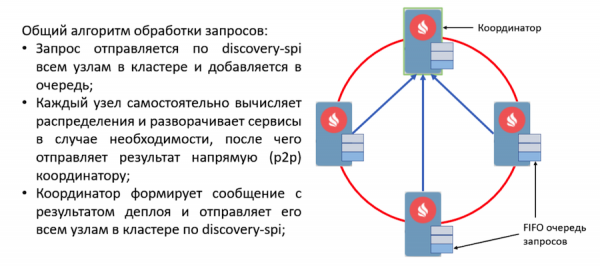
Nuevo diseño impulsado por eventos: org.apache.ignite.internal.processors.service.IgniteServiceProcessor.java
Si ocurre un error en el momento de la implementación, el nodo incluye inmediatamente este error en el mensaje que envía al coordinador. Después de agregar los mensajes, el coordinador tendrá información sobre todos los errores durante el despliegue y enviará ese mensaje a través de discovery-spi. La información sobre los errores estará disponible en cualquier nodo del clúster.
Todos los eventos importantes en el Service Grid se procesan según este algoritmo de trabajo. Por ejemplo, un cambio de topología también es un mensaje a través de discovery-spi. En general, comparándolo con lo que había antes, el protocolo resultó ser bastante ligero y confiable. Suficientemente para manejar cualquier situación durante el despliegue.
¿Qué viene después?
Ahora sobre los planes. Cualquier mejora importante en el proyecto Ignite se lleva a cabo como una iniciativa para mejorar Ignite, denominado IEP. El rediseño del Service Grid también tiene su propio IEP — con el título humorístico «Cambio de aceite en el Service Grid». Pero de hecho, no cambiamos el aceite en el motor, sino el motor completo.
Dividimos las tareas del IEP en 2 fases. La primera - una fase importante que consiste en rehacer el protocolo de despliegue. Ya se ha integrado en la rama principal, se puede probar el nuevo Service Grid, que aparecerá en la versión 2.8. La segunda fase incluye muchas otras tareas:
- Redespliegue en caliente
- Versionado de servicios
- Aumento de la tolerancia a fallos
- Cliente ligero
- Herramientas de monitoreo y conteo de diversas métricas
Por último, podemos recomendarle Service Grid para construir sistemas tolerantes a fallos de alta disponibilidad. También lo invitamos a nuestro y para compartir su experiencia. Su experiencia es realmente importante para la comunidad, ayudará a entender hacia dónde avanzar en el futuro y cómo desarrollar el componente.
Fuente: habr.com
