

En memoria: un conjunto de conceptos para el almacenamiento de datos, donde se mantienen en la memoria RAM de la aplicación y el disco se utiliza para copias de seguridad. En los enfoques clásicos, los datos se almacenan en disco y la memoria funciona como caché. Por ejemplo, una aplicación web con un backend que procesa datos solicita estos en el almacenamiento: recibe, transforma y transmite grandes cantidades de datos a través de la red. En memoria, los cálculos se envían a los datos, donde se procesan y la red se carga menos.

Qué otras posibilidades ofrece en memoria y de qué trata este enfoque, lo contará Vladimir Pligin , ingeniero de la empresa GridGain. Este material de referencia será útil para los desarrolladores de backend de aplicaciones web que no han trabajado con en memoria y desean probarlo, o que están interesados en las tendencias modernas en el desarrollo de soluciones de software y el diseño de arquitecturas.
Nota. El artículo se basa en la transcripción de la charla de Vladimir en la conferencia #GetIT Conf. Antes de la introducción del aislamiento, organizábamos regularmente meetups y conferencias para desarrolladores en Moscú y San Petersburgo: discutíamos tendencias, cuestiones relevantes en el desarrollo, problemas y sus soluciones. Ahora no se pueden realizar conferencias, pero es el momento perfecto para compartir materiales útiles de eventos pasados.
Quién y cómo utiliza en memoria
En memoria se utiliza más comúnmente donde se requiere una interacción rápida con el usuario o el procesamiento de grandes volúmenes de datos.
- Bancos utilizan en memoria, por ejemplo, para reducir la latencia al usar aplicaciones por parte de los clientes o para analizar al cliente antes de otorgar un crédito.
- Fintech utiliza en memoria para mejorar el rendimiento de los servicios y aplicaciones para bancos que subcontratan el procesamiento y análisis de datos.
- Compañías de seguros: para calcular riesgos, por ejemplo, analizando los datos de los clientes durante varios años.
- Empresas de logística. Procesan grandes volúmenes de datos, por ejemplo, para calcular las rutas óptimas de transporte de mercancías y pasajeros con miles de parámetros, y rastrear el estado de los envíos.
- Retail. Las soluciones In-Memory ayudan a atender a los clientes más rápido y a manejar grandes volúmenes de información: envíos, facturas, transacciones, disponibilidad de miles de productos en almacenes, y a preparar informes analíticos.
- En IoT In-Memory reemplaza bases de datos tradicionales.
- Empresas farmacéuticas utilizan In-Memory, por ejemplo, para explorar combinaciones de ingredientes de medicamentos.
Voy a contar algunos ejemplos de cómo nuestros clientes utilizan soluciones In-Memory y cómo puede implementarlas en su empresa.
In-Memory como almacenamiento principal
Uno de nuestros clientes es un importante proveedor de equipos científicos médicos en EE. UU. Utilizan una solución In-Memory como almacenamiento principal de datos. Todos los datos se almacenan en disco, mientras que un subconjunto de datos que se utiliza activamente se mantiene en la memoria RAM. Los métodos de acceso al almacenamiento son estándar: GDBC (Generic Database Connector) y el lenguaje de consultas SQL.
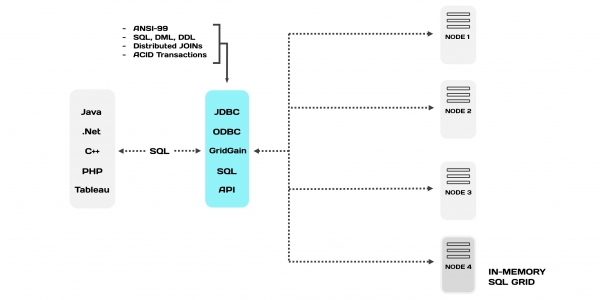
Todo esto se llama In-Memory Database (IMDB) o Almacenamiento Centrado en la Memoria. Esta clase de soluciones tiene muchos nombres, no son los únicos.
Características de IMDB:
- Los datos que se almacenan en In-Memory y son accesibles a través de SQL son los mismos que en otros enfoques. Están sincronizados, solo difiere la forma de representación y el método de acceso. La transaccionalidad opera entre los datos.
- IMDB es más rápido que las bases de datos relacionales, ya que acceder a la información desde la memoria RAM es más rápido que desde el disco.
- Los algoritmos internos de optimización tienen menos instrucciones.
- IMDB son adecuados para la gestión de datos, eventos y transacciones en aplicaciones.
IMDB soportan parcialmente ACID: atomicidad, consistencia e aislamiento. Pero no soportan la «durabilidad»; al desconectar la energía, todos los datos se pierden. Para resolver este problema, se pueden usar instantáneas: una «foto» de la base de datos, similar a un respaldo en disco duro, o registrar transacciones (logs) para restaurar datos tras un reinicio.
Para crear aplicaciones tolerantes a fallos
Imaginemos una arquitectura clásica de una aplicación web tolerante a fallos. Funciona de la siguiente manera: todas las solicitudes son distribuidas por un balanceador de carga entre los servidores. Este sistema es robusto porque los servidores se duplican entre sí y se respaldan en caso de incidentes.
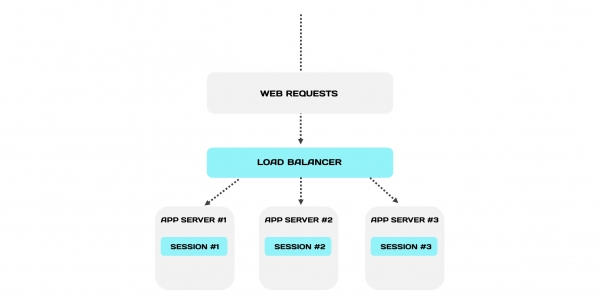
El balanceador dirige todas las solicitudes de una sesión estrictamente a un solo servidor. Este es el mecanismo de sesiones pegajosas: cada sesión se vincula a servidor, donde se almacena y procesa localmente.
¿Qué sucederá cuando falle uno de los servidores?
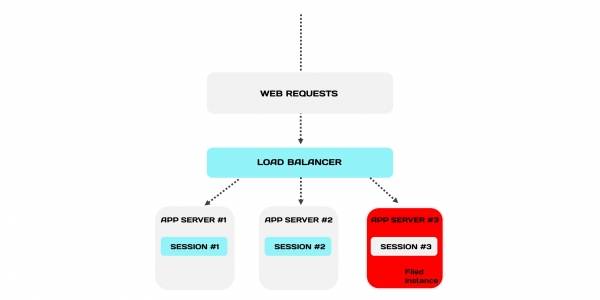
El servicio no se verá afectado, porque la arquitectura está duplicada. Pero perderemos un subconjunto de sesiones del servidor caído. Y, además, a los usuarios que están vinculados a estas sesiones. Por ejemplo, un cliente realiza un pedido y, de repente, es expulsado de su cuenta. No estará contento cuando inicie sesión nuevamente y descubra que tendrá que hacer su pedido otra vez.
Se espera que la aplicación web soporte un gran número de usuarios y no 'ralentice' para que sea cómodo trabajar. Pero en caso de fallo, con cada nueva solicitud, el tiempo de comunicación con el almacenamiento de sesiones aumentará. Esto incrementa la latencia promedio para los otros usuarios. Pero ellos no quieren esperar más de lo que están acostumbrados.
Este problema se puede resolver, como lo hizo otro de nuestros clientes: un gran proveedor de PASS en Estados Unidos. Utiliza In-Memory para agrupar sesiones web. Para ello, las almacena de forma centralizada en un clúster In-Memory. En este caso, las sesiones son accesibles mucho más rápido, ya que se encuentran en la memoria RAM.
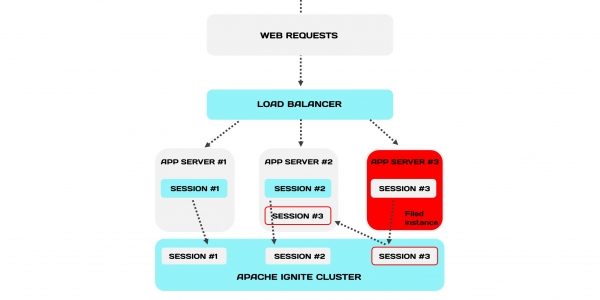
Cuando un servidor falla, el balanceador envía las solicitudes del servidor caído a otros servidores, como en la arquitectura clásica. Pero hay una diferencia importante: las sesiones se almacenan en un clúster In-Memory y los servidores tienen acceso a las sesiones del servidor caído.
Esta arquitectura mejora la tolerancia a fallos de todo el sistema. Además, es posible prescindir completamente del mecanismo de sesiones pegajosas.
Procesamiento híbrido transaccional-analítico (HTAP)
Por lo general, los sistemas transaccionales y analíticos se mantienen por separado. Cuando se separan, la base de datos principal se ve sometida a la carga. Para el procesamiento analítico, los datos se copian en una réplica, de modo que el procesamiento analítico no interfiera con los procesos transaccionales. Sin embargo, la copia se realiza con un retraso; replicar sin retraso es imposible. Si lo hiciéramos de manera síncrona, también ralentizaría la base de datos principal y no obtendríamos beneficios.
En HTAP, todo funciona de manera diferente: el mismo almacén de datos se utiliza para la carga transaccional de las aplicaciones y para las consultas analíticas, que pueden llevar tiempo. Cuando los datos están en la memoria, las consultas analíticas se ejecutan más rápido y el servidor de la base de datos se carga menos (en promedio).
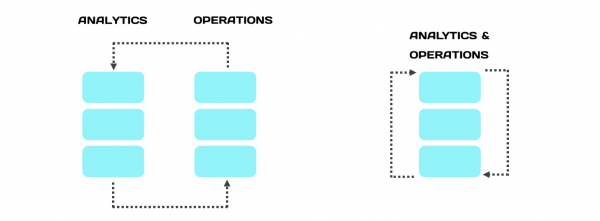
El enfoque híbrido "rompe la barrera" entre el procesamiento de transacciones y la analítica. Si realizamos analítica en el mismo almacén, entonces las consultas analíticas se ejecutan sobre datos en la memoria. Son mucho más precisas, más interpretables y adecuadas.
Integración de soluciones In-Memory
Una forma (relativamente) sencilla es desarrollar todo desde cero. Mantenemos los datos en disco y lo caliente lo almacenamos en memoria. Esto ayuda a soportar reinicios de servidores o cortes.
Aquí funcionan dos escenarios principales cuando los datos se almacenan en disco. En el primero, queremos soportar caídas o reinicios planificados del clúster o de partes del mismo; queremos utilizarlo como una base de datos simple. En el segundo escenario, cuando hay demasiados datos, parte de ellos está en memoria.
Si no hay posibilidad de construir todo desde cero, es posible integrar In-Memory en una arquitectura existente. Pero no todas las soluciones In-Memory son adecuadas para esto. Hay tres condiciones necesarias. La solución In-Memory debe soportar:
- un método estándar de conexión con la base de datos que estará por debajo (por ejemplo, MySQL);
- un lenguaje de consultas estándar, para no reescribir y cambiar la lógica de interacción con el almacén;
- transaccionalidad: mantener la semántica de la interacción.
Si se cumplen las tres condiciones, la integración es posible. Colocamos un In-Memory Data Grid entre la aplicación y la base de datos. Ahora, las solicitudes de escritura se delegarán a la base de datos subyacente, y las solicitudes de lectura a la base de datos, si los datos no están en caché.
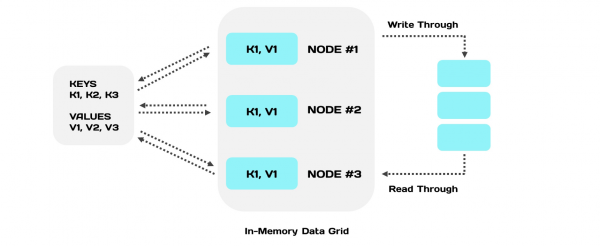
Si la rapidez en el acceso a los datos y su procesamiento es crucial para usted, por ejemplo, para el análisis empresarial, considere implementar In-Memory. Para su implementación, puede emplear ambos métodos al diseñar una nueva arquitectura.
Fuente: habr.com
