

¡Hola, Habr!
¿Te gusta volar en aviones? A mí me encanta, pero durante la autoaislación también he aprendido a analizar datos sobre boletos de avión de un conocido recurso: Aviasales.
Hoy analizaremos el funcionamiento de Amazon Kinesis, construiremos un sistema de streaming con análisis en tiempo real, implementaremos una base de datos NoSQL Amazon DynamoDB como almacenamiento de datos principal y configuraremos alertas por SMS sobre boletos interesantes.
¡Todos los detalles a continuación! ¡Vamos!
Introducción
Para este ejemplo, necesitaremos acceso a . El acceso es gratuito y sin restricciones, solo es necesario registrarse en la sección 'Desarrolladores' para obtener tu token API para acceder a los datos.
El principal objetivo de este artículo es ofrecer una comprensión general sobre el uso de la transmisión de información en AWS; dejamos de lado que los datos devueltos por la API utilizada no son estrictamente actuales y se transfieren desde una caché que se forma a partir de las búsquedas de los usuarios en los sitios Aviasales.ru y Jetradar.com de las últimas 48 horas.
Los datos sobre boletos de avión obtenidos a través de la API serán automáticamente analizados y enviados al flujo correspondiente a través de Kinesis Data Analytics por el agente Kinesis instalado en la máquina productora. La versión sin procesar de este flujo se escribirá directamente en el almacenamiento. El almacenamiento 'crudo' desplegado en DynamoDB permitirá realizar un análisis más profundo de los boletos mediante herramientas de BI, como AWS QuickSight.
Analizaremos dos opciones para desplegar toda la infraestructura:
- Manualmente — a través de la consola de gestión de AWS;
- Infraestructura desde código Terraform — para los automatizadores perezosos;
Arquitectura del sistema en desarrollo
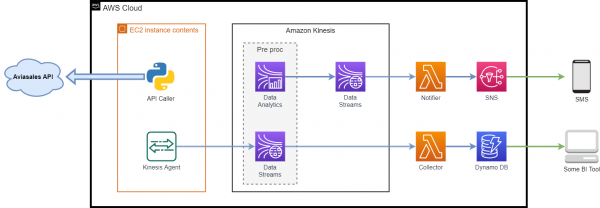
Componentes utilizados:
- — los datos devueltos por esta API serán utilizados para todo el trabajo posterior;
- — una máquina virtual ordinaria en la nube que generará el flujo de datos de entrada:
- — es una aplicación Java que se instala localmente en la máquina y proporciona una forma sencilla de recopilar y enviar datos a Kinesis (Kinesis Data Streams o Kinesis Firehose). El agente monitorea constantemente un conjunto de archivos en los directorios especificados y envía nuevos datos a Kinesis;
- — un script en Python que realiza solicitudes a la API y almacena las respuestas en una carpeta que monitorea el Kinesis Agent;
- — un servicio de transmisión de datos en tiempo real con amplias capacidades de escalado;
- — servicio sin servidor que simplifica el análisis de datos en tiempo real. Amazon Kinesis Data Analytics configura recursos para aplicaciones y se escala automáticamente para manejar cualquier volumen de datos entrantes;
- — servicio que permite ejecutar código sin aprovisionar ni configurar servidores. Todos los recursos de computación se escalan automáticamente para cada llamada;
- — base de datos de pares «clave-valor» y documentos, que garantiza una latencia de menos de 10 milisegundos a cualquier escala. Al usar DynamoDB, no se requiere aprovisionar servidores, aplicar parches o administrarlos. DynamoDB escala automáticamente las tablas, ajustando la cantidad de recursos disponibles y manteniendo un alto rendimiento. No se requieren acciones de administración del sistema;
- — servicio de mensajería totalmente gestionado basado en el modelo de «publicador-suscriptor» (Pub/Sub), que permite aislar microservicios, sistemas distribuidos y aplicaciones sin servidor. SNS se puede utilizar para enviar información a usuarios finales a través de notificaciones push para móviles, mensajes SMS y correos electrónicos.
Preparación inicial
Para emular un flujo de datos, decidí usar información sobre boletos de avión proporcionada por la API de Aviasales. En una lista bastante extensa de diferentes métodos, tomaremos uno de ellos: «Calendario de precios del mes», que devuelve los precios para cada día del mes, agrupados por la cantidad de escalas. Si no se especifica el mes de búsqueda en la solicitud, se devolverá la información para el mes siguiente al actual.
Entonces, nos registramos y obtenemos nuestro token.
Ejemplo de solicitud a continuación:
http://api.travelpayouts.com/v2/prices/month-matrix?currency=rub&origin=LED&destination=HKT&show_to_affiliates=true&token=TOKEN_APIEl método descrito anteriormente para obtener datos de la API con el token en la solicitud funcionará, pero prefiero pasar el token de acceso a través del encabezado, por lo que en el script api_caller.py utilizaremos precisamente este método.
Ejemplo de respuesta:
{{
   "success":true,
   "data":[{
      "show_to_affiliates":true,
      "trip_class":0,
      "origin":"LED",
      "destination":"HKT",
      "depart_date":"2015-10-01",
      "return_date":"",
      "number_of_changes":1,
      "value":29127,
      "found_at":"2015-09-24T00:06:12+04:00",
      "distance":8015,
      "actual":true
   }]
}
En el ejemplo de respuesta de la API anterior, se muestra un boleto de San Petersburgo a Phuket… Ah, para qué soñar…
Dado que soy de Kazán y Phuket ahora es un lugar que 'solo soñamos', busquemos boletos de San Petersburgo a Kazán.
Se supone que ya tienes una cuenta en AWS. Quiero señalar especialmente que Kinesis y el envío de notificaciones por SMS no están incluidos en el año. . Sin embargo, a pesar de esto, con unos pocos dólares en mente, es totalmente posible construir el sistema propuesto y experimentar con él. Y, por supuesto, no debemos olvidar eliminar todos los recursos después de que ya no sean necesarios.
Afortunadamente, DynamoDb y las funciones lambda serán condicionalmente gratuitas para nosotros si permanecemos dentro de los límites mensuales gratuitos. Por ejemplo, para DynamoDB: 25 GB de almacenamiento, 25 WCU/RCU y 100 millones de solicitudes. Y un millón de invocaciones de funciones lambda al mes.
Implementación manual del sistema
Configuración de Kinesis Data Streams
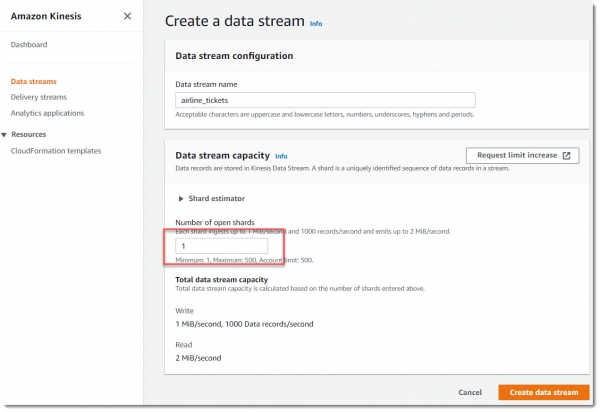
Pasemos al servicio Kinesis Data Streams y creamos dos nuevos flujos con un shard cada uno.
¿Qué es un shard?
Un shard es la unidad principal de transmisión de datos en Amazon Kinesis. Un shard proporciona una tasa de entrada de datos de hasta 1 MB/s y una tasa de salida de hasta 2 MB/s. Un shard admite hasta 1000 registros PUT por segundo. Al crear un flujo de datos, se debe especificar el número requerido de shards. Por ejemplo, se puede crear un flujo de datos con dos shards. Este flujo de datos permitirá una entrada de datos de 2 MB/s y una salida de 4 MB/s, soportando hasta 2000 registros PUT por segundo.
Cuantos más shards tenga su flujo, mayor será su capacidad de transmisión. En principio, así es como se escalan los flujos: agregando shards. Pero cuanto más shards tenga, más alto será el costo. Cada shard cuesta 1.5 centavos por hora y adicionalmente 1.4 centavos por cada millón de operaciones de adición al flujo (unidades de carga útil PUT).
Crearemos un nuevo flujo llamado airline_tickets, con un solo shard será suficiente:
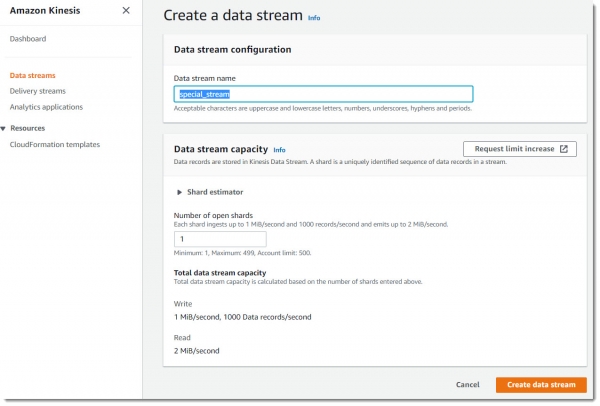
Ahora crearemos otro flujo llamado special_stream:
Configuración del productor
Como productor de datos para resolver la tarea, basta con usar una instancia EC2 normal. No tiene que ser una máquina virtual potente y cara; un t2.micro spot es suficiente.
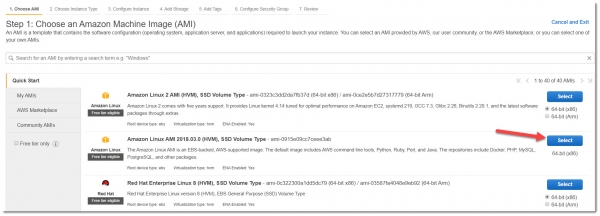
Nota importante: para este ejemplo, se debe usar la imagen - Amazon Linux AMI 2018.03.0, ya que requiere menos configuraciones para un rápido inicio del Kinesis Agent.
Accedemos al servicio EC2, creamos una nueva máquina virtual, elegimos la AMI adecuada con tipo t2.micro, que está incluida en el Free Tier:
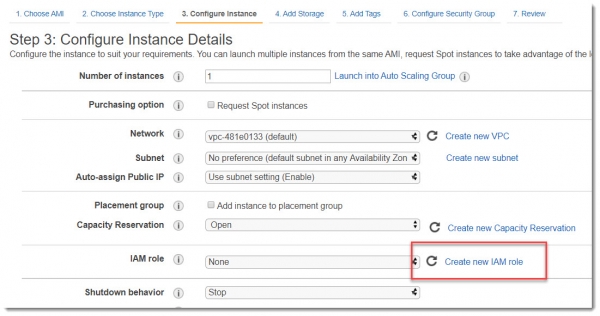
Para que la nueva máquina virtual pueda interactuar con el servicio Kinesis, es necesario otorgarle permisos. La mejor manera de hacerlo es asignar un Rol de IAM. Por lo tanto, en la pantalla Paso 3: Configurar detalles de la instancia, se debe seleccionar Crear nuevo Rol de IAM:
Creación de un Rol de IAM para EC2
En la ventana que se abre, seleccionamos que creamos un nuevo rol para EC2 y accedemos a la sección de Permisos:
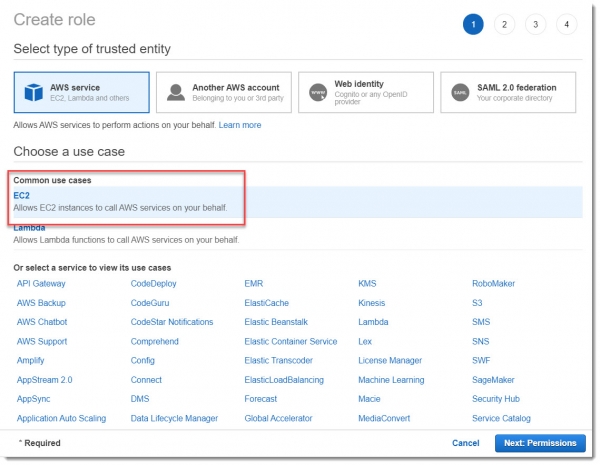
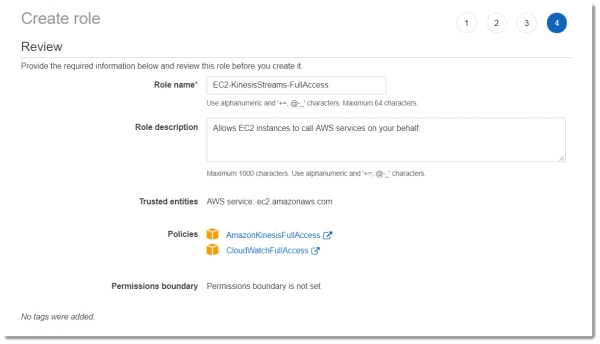
En el ejemplo de práctica, no es necesario profundizar en todos los matices de la configuración granular de permisos para los recursos, así que elegiremos las políticas preconfiguradas por Amazon: AmazonKinesisFullAccess y CloudWatchFullAccess.
Demos un nombre significativo a este rol, por ejemplo: EC2-KinesisStreams-FullAccess. Como resultado, debe ser lo mismo que se indica en la imagen a continuación:
Después de crear este nuevo rol, no olvidemos adjuntarlo a la instancia de máquina virtual que estamos creando:
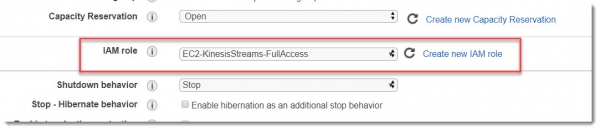
No cambiamos nada más en esta pantalla y pasamos a las siguientes ventanas.
Los parámetros del disco duro se pueden dejar por defecto, las etiquetas también (aunque, es una buena práctica utilizarlas; al menos se debe dar un nombre a la instancia y especificar el entorno).
Ahora estamos en la pestaña Paso 6: Configurar Grupo de Seguridad, donde es necesario crear uno nuevo o especificar uno existente que permita conectarse a través de ssh (puerto 22) a la instancia. Elija ahí Fuente → Mi IP y puede iniciar la instancia.
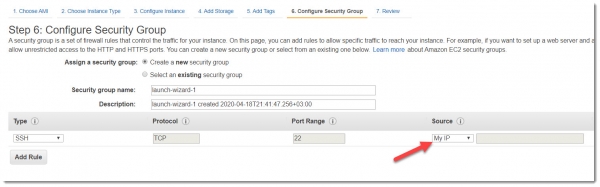
Tan pronto como pase al estado en ejecución, puede intentar conectarse a ella a través de ssh.
Para poder trabajar con Kinesis Agent, después de conectarse con éxito a la máquina, es necesario introducir los siguientes comandos en la terminal:
sudo yum -y update
sudo yum install -y python36 python36-pip
sudo /usr/bin/pip-3.6 install --upgrade pip
sudo yum install -y aws-kinesis-agent
Crearemos una carpeta para guardar las respuestas de la API:
sudo mkdir /var/log/airline_ticketsAntes de iniciar el agente, es necesario configurar su archivo de configuración:
sudo vim /etc/aws-kinesis/agent.jsonEl contenido del archivo agent.json debe tener el siguiente formato:
{
  "cloudwatch.emitMetrics": true,
  "kinesis.endpoint": "",
  "firehose.endpoint": "",

  "flows": [
    {
      "filePattern": "/var/log/airline_tickets/*log",
      "kinesisStream": "airline_tickets",
      "partitionKeyOption": "RANDOM",
      "dataProcessingOptions": [
         {
            "optionName": "CSVTOJSON",
            "customFieldNames": ["cost","trip_class","show_to_affiliates",
                "return_date","origin","number_of_changes","gate","found_at",
                "duration","distance","destination","depart_date","actual","record_id"]
         }
      ]
    }
  ]
}
Como se puede ver en el archivo de configuración, el agente monitoreará en el directorio /var/log/airline_tickets/ archivos con extensión .log, los analizará y los enviará al flujo airline_tickets.
Reiniciamos el servicio y aseguramos que se haya iniciado y esté funcionando:
sudo service aws-kinesis-agent restartAhora descargamos el script de Python, que consultará los datos de la API:
REPO_PATH=https://raw.githubusercontent.com/igorgorbenko/aviasales_kinesis/master/producer

wget $REPO_PATH/api_caller.py -P /home/ec2-user/
wget $REPO_PATH/requirements.txt -P /home/ec2-user/
sudo chmod a+x /home/ec2-user/api_caller.py
sudo /usr/local/bin/pip3 install -r /home/ec2-user/requirements.txt
El script api_caller.py solicita datos de Aviasales y guarda la respuesta obtenida en el directorio que escanea el agente de Kinesis. La implementación de este script es bastante estándar; hay una clase TicketsApi que permite consultar la API de forma asíncrona. En esta clase, pasamos el encabezado con el token y los parámetros de la consulta:
class TicketsApi:
    """Clase de llamada a la API."""

    def __init__(self, headers):
        """Método de inicialización."""
        self.base_url = BASE_URL
        self.headers = headers

    async def get_data(self, data):
        """Obtiene los datos de la consulta API."""
        response_json = {}
        async with ClientSession(headers=self.headers) as session:
            try:
                response = await session.get(self.base_url, data=data)
                response.raise_for_status()
                LOGGER.info('Estado de respuesta %s: %s',
                            self.base_url, response.status)
                response_json = await response.json()
            except HTTPError as http_err:
                LOGGER.error('¡Vaya! Ocurrió un error HTTP: %s', str(http_err))
            except Exception as err:
                LOGGER.error('¡Vaya! Ocurrió un error: %s', str(err))
            return response_json


def prepare_request(api_token):
    """Devuelve los encabezados y la consulta para la solicitud API."""
    headers = {'X-Access-Token': api_token,
               'Accept-Encoding': 'gzip'}

    data = FormData()
    data.add_field('currency', CURRENCY)
    data.add_field('origin', ORIGIN)
    data.add_field('destination', DESTINATION)
    data.add_field('show_to_affiliates', SHOW_TO_AFFILIATES)
    data.add_field('trip_duration', TRIP_DURATION)
    return headers, data


async def main():
    """Ejecuta el código."""
    if len(sys.argv) != 2:
        print('Uso: api_caller.py ')
        sys.exit(1)
        return
    api_token = sys.argv[1]
    headers, data = prepare_request(api_token)

    api = TicketsApi(headers)
    response = await api.get_data(data)
    if response.get('success', None):
        LOGGER.info('La API ha devuelto %s artículos', len(response['data']))
        try:
            count_rows = log_maker(response)
            LOGGER.info('%s filas se han guardado en %s',
                        count_rows,
                        TARGET_FILE)
        except Exception as e:
            LOGGER.error('¡Vaya! El resultado de la solicitud no se guardó en el archivo. %s',
                         str(e))
    else:
        LOGGER.error('¡Vaya! La solicitud a la API fue no exitosa %s!', response)
Para probar la corrección de la configuración y la funcionalidad del agente, haremos una ejecución de prueba del script api_caller.py:
sudo ./api_caller.py TOKEN 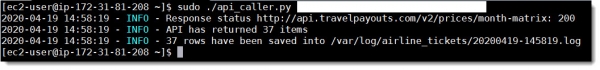
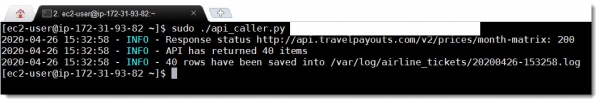
Y vemos el resultado en los registros del agente y en la pestaña de Monitoreo en el flujo de datos airline_tickets:
tail -f /var/log/aws-kinesis-agent/aws-kinesis-agent.log 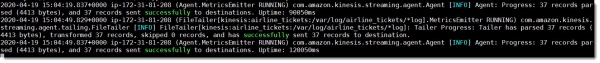
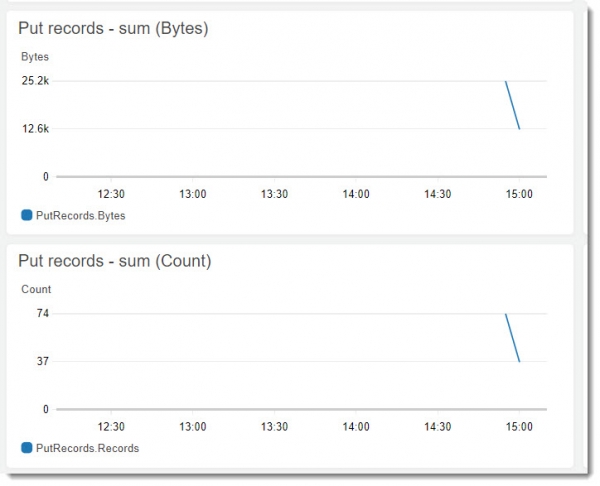
Como se puede ver, todo funciona y el Kinesis Agent está enviando datos al flujo con éxito. Ahora configuraremos el consumidor.
Configuración de Kinesis Data Analytics
Vamos al componente central del sistema: crearemos una nueva aplicación en Kinesis Data Analytics llamada kinesis_analytics_airlines_app:
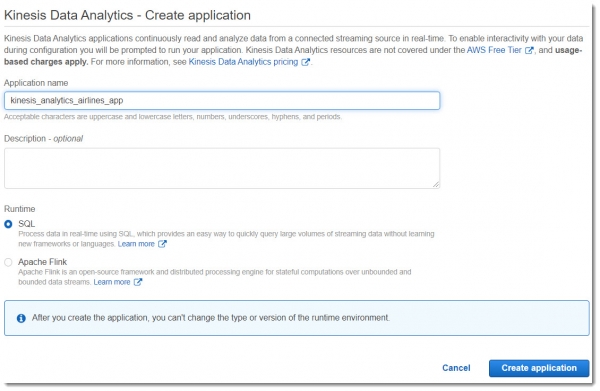
Kinesis Data Analytics permite realizar análisis de datos en tiempo real desde Kinesis Streams utilizando SQL. Es un servicio completamente escalable (a diferencia de Kinesis Streams) que:
- permite crear nuevos flujos (Output Stream) basados en consultas sobre los datos de entrada;
- proporciona un flujo de errores que ocurrieron durante la ejecución de aplicaciones (Error Stream);
- puede identificar automáticamente el esquema de los datos de entrada (que se puede sobreescribir manualmente si es necesario).
Este servicio no es barato: 0.11 USD por hora de funcionamiento, por lo que debe usarse con precaución y eliminarse al finalizar su uso.
Conectaremos la aplicación a la fuente de datos:
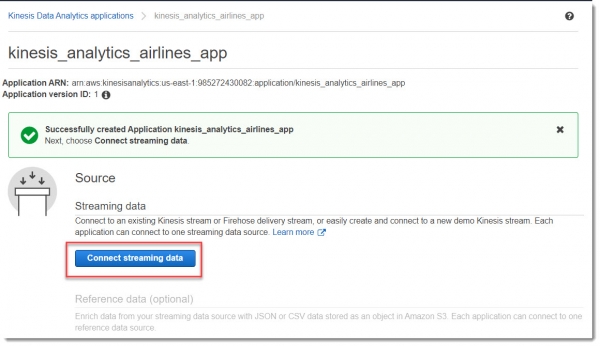
Seleccionamos el flujo al que queremos conectarnos (airline_tickets):
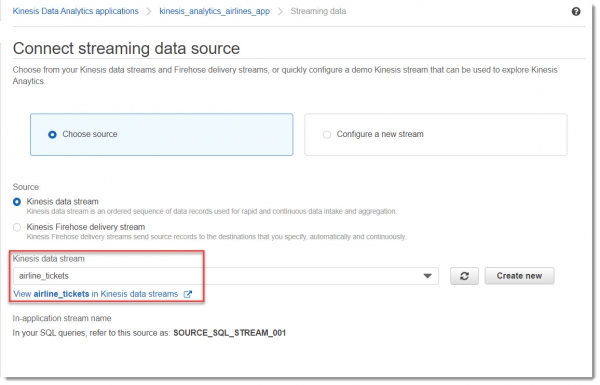
A continuación, es necesario adjuntar un nuevo rol de IAM para que la aplicación pueda leer y escribir en el flujo. Para ello, no es necesario cambiar nada en el bloque de permisos de acceso:
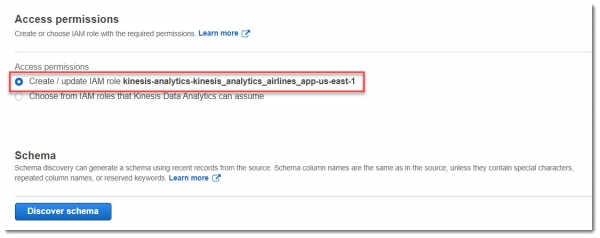
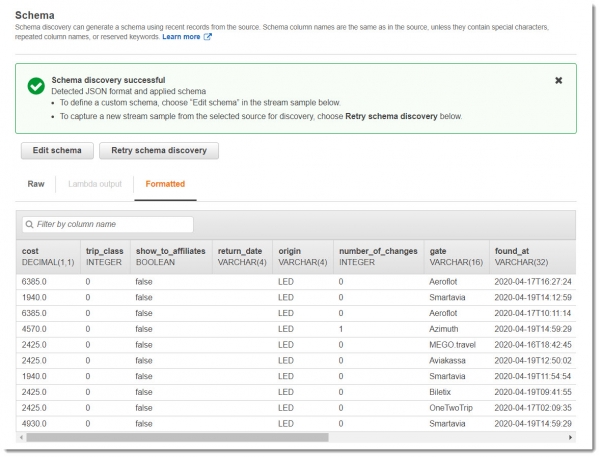
Ahora solicitaremos la detección del esquema de datos en el flujo, para esto presionamos el botón «Discover schema». Como resultado, se actualizará (se creará un nuevo) rol de IAM y se iniciará la detección del esquema a partir de los datos ya llegados al flujo:
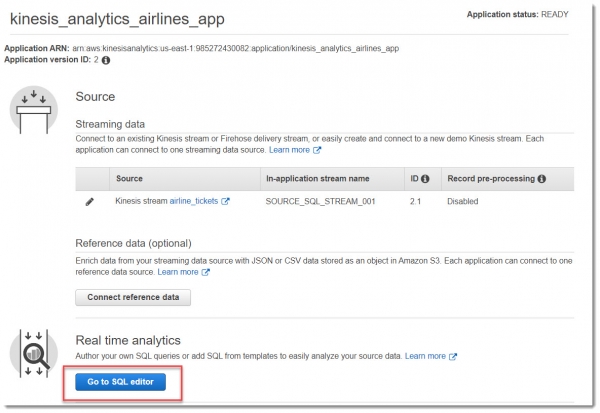
Ahora es necesario pasar al editor SQL. Al hacer clic en este botón, aparecerá una ventana con la pregunta sobre el lanzamiento de la aplicación: elegimos qué queremos iniciar:
En la ventana del editor SQL insertaremos esta sencilla consulta y presionamos Save and Run SQL:
CREATE OR REPLACE STREAM "DESTINATION_SQL_STREAM" ("cost" DOUBLE, "gate" VARCHAR(16));

CREATE OR REPLACE PUMP "STREAM_PUMP" AS INSERT INTO "DESTINATION_SQL_STREAM"
SELECT STREAM "cost", "gate"
FROM "SOURCE_SQL_STREAM_001"
WHERE "cost" < 5000
    and "gate" = 'Aeroflot';
En bases de datos relacionales, trabajas con tablas utilizando las instrucciones INSERT para agregar registros y la instrucción SELECT para consultar datos. En Amazon Kinesis Data Analytics trabajas con flujos (STREAM) y «bombas» (PUMP) — consultas continuas de inserción que insertan datos de un flujo en la aplicación a otro flujo.
En la consulta SQL presentada arriba, se busca boletos de Aeroflot con un costo inferior a cinco mil rublos. Todos los registros que cumplen con estas condiciones se colocarán en el flujo DESTINATION_SQL_STREAM.
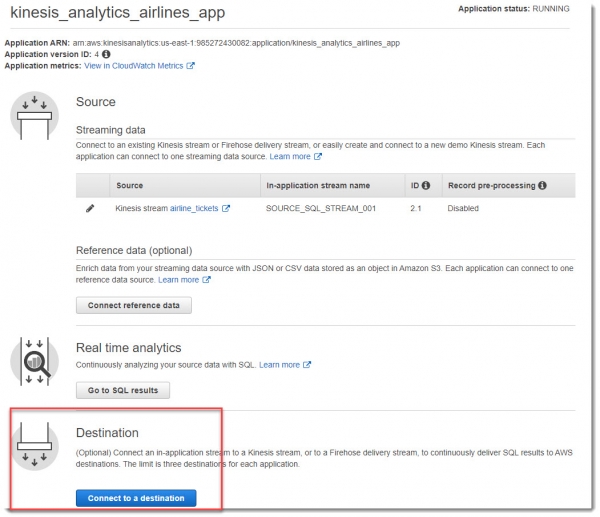
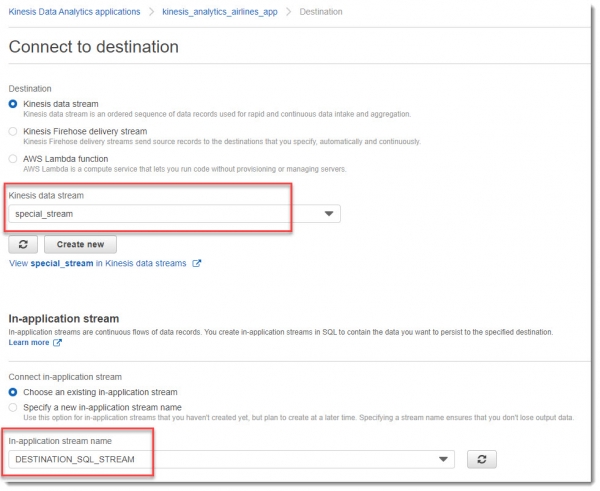
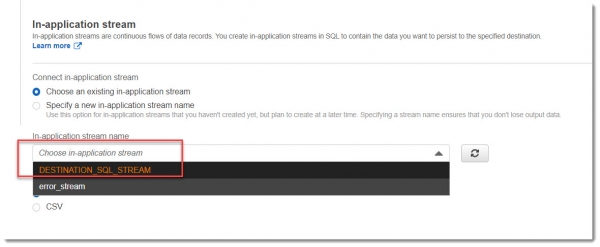
En el bloque Destination seleccionamos el flujo special_stream, y en la lista desplegable In-application stream name DESTINATION_SQL_STREAM:
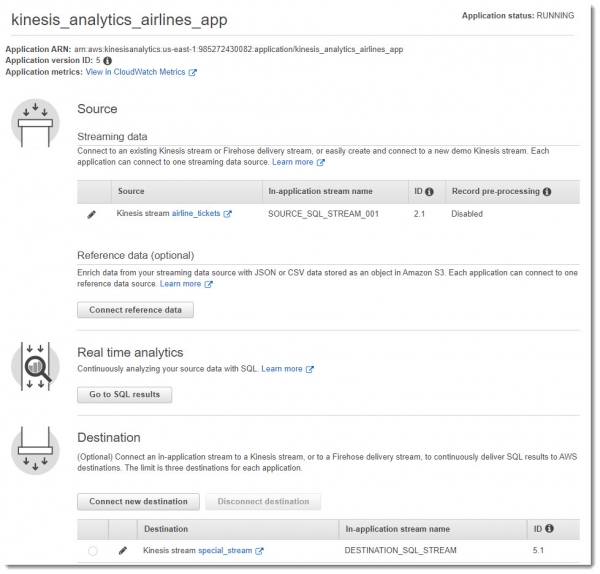
Como resultado de todas las manipulaciones, debería parecerse a la imagen de abajo:
Creación y suscripción a un tema SNS
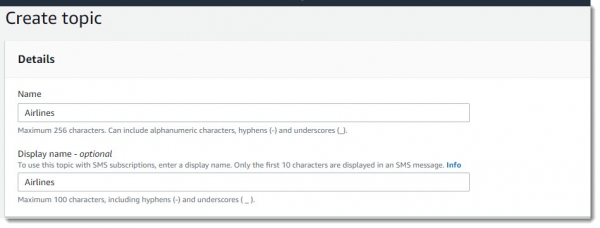
Vamos al servicio Simple Notification Service y creamos un nuevo tema con el nombre Airlines:
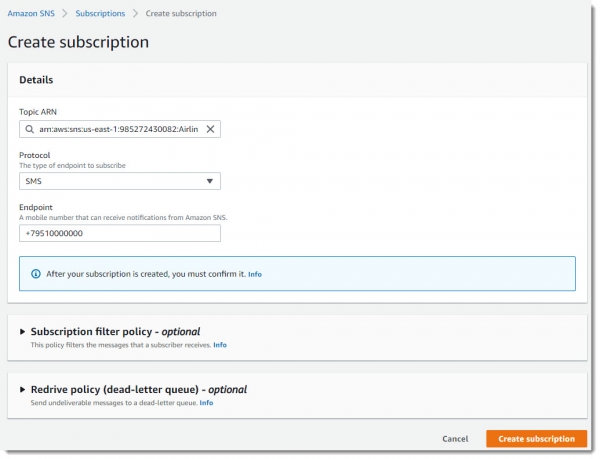
Creamos una suscripción a este tema, indicando el número de teléfono móvil al que se enviarán las notificaciones SMS:
Creación de una tabla en DynamoDB
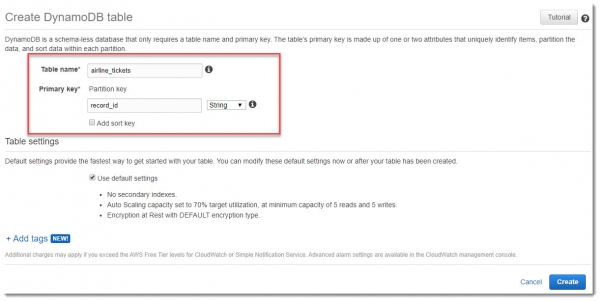
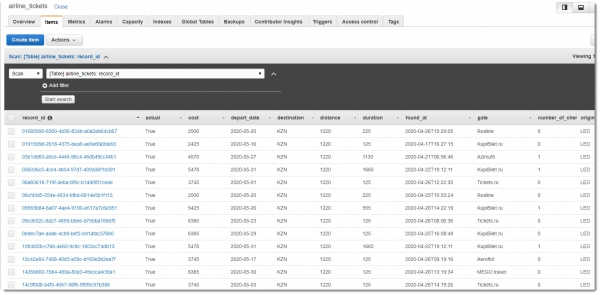
Para almacenar los datos no procesados de su flujo airline_tickets, crearemos una tabla en DynamoDB con el mismo nombre. Como clave primaria utilizaremos record_id:
Creación de la función lambda collector
Crearemos una función lambda llamada Collector, cuya tarea será sondear el flujo airline_tickets y, en caso de encontrar nuevos registros, insertar esos registros en la tabla de DynamoDB. Obviamente, además de los permisos predeterminados, esta lambda debe tener acceso para leer el flujo de datos Kinesis y escribir en DynamoDB.
Creación de un rol IAM para la función lambda collector
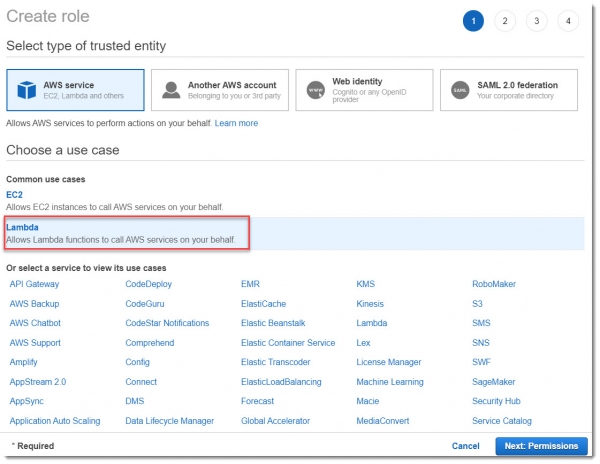
Primero crearemos un nuevo rol IAM para la lambda con el nombre Lambda-TicketsProcessingRole:
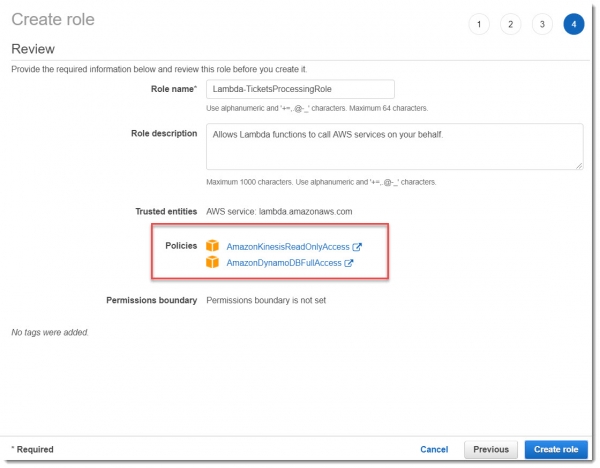
Para el ejemplo de prueba, son adecuados los permisos preconfigurados AmazonKinesisReadOnlyAccess y AmazonDynamoDBFullAccess, como se muestra en la imagen de abajo:
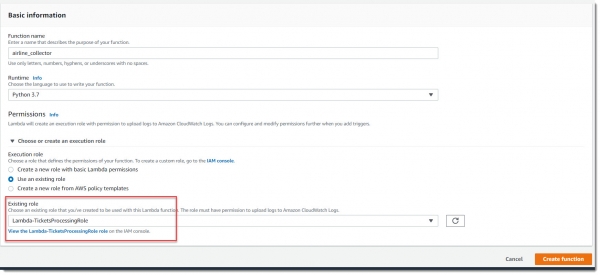
Esta lambda debe ejecutarse mediante un disparador de Kinesis cuando se agreguen nuevos registros al flujo airline_stream, así que hay que agregar un nuevo disparador:
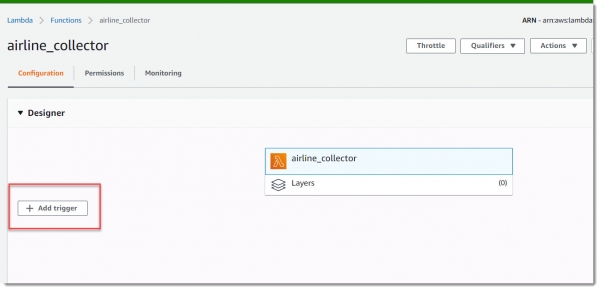
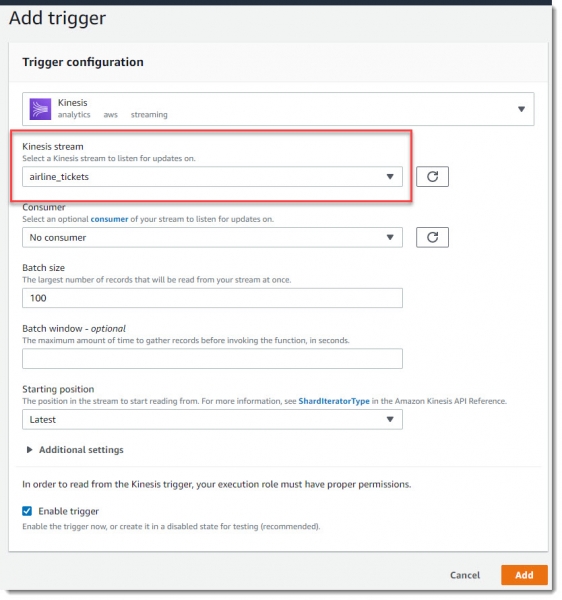
Solo queda insertar el código y guardar la lambda.
"""Analizando el flujo e insertando en la tabla de DynamoDB."""
import base64
import json
import boto3
from decimal import Decimal

DYNAMO_DB = boto3.resource('dynamodb')
TABLE_NAME = 'airline_tickets'

class TicketsParser:
    """Analiza la información del flujo."""

    def __init__(self, table_name, records):
        """Método de inicialización."""
        self.table = DYNAMO_DB.Table(table_name)
        self.json_data = TicketsParser.get_json_data(records)

    @staticmethod
    def get_json_data(records):
        """Devuelve datos deserializados del flujo."""
        decoded_record_data = ([base64.b64decode(record['kinesis']['data'])
                                for record in records])
        json_data = ([json.loads(decoded_record)
                      for decoded_record in decoded_record_data])
        return json_data

    @staticmethod
    def get_item_from_json(json_item):
        """Preprocesa los datos json."""
        new_item = {
            'record_id': json_item.get('record_id'),
            'cost': Decimal(json_item.get('cost')),
            'trip_class': json_item.get('trip_class'),
            'show_to_affiliates': json_item.get('show_to_affiliates'),
            'origin': json_item.get('origin'),
            'number_of_changes': int(json_item.get('number_of_changes')),
            'gate': json_item.get('gate'),
            'found_at': json_item.get('found_at'),
            'duration': int(json_item.get('duration')),
            'distance': int(json_item.get('distance')),
            'destination': json_item.get('destination'),
            'depart_date': json_item.get('depart_date'),
            'actual': json_item.get('actual')
        }
        return new_item

    def run(self):
        """Inserción por lotes en la tabla."""
        with self.table.batch_writer() as batch_writer:
            for item in self.json_data:
                dynamodb_item = TicketsParser.get_item_from_json(item)
                batch_writer.put_item(dynamodb_item)

        print('Se han añadido ', len(self.json_data), 'elementos')

def lambda_handler(event, context):
    """Analiza el flujo e inserta en la tabla DynamoDB."""
    print('Evento recibido:', event)
    parser = TicketsParser(TABLE_NAME, event['Records'])
    parser.run()
Creación de la función lambda notifier
La segunda función lambda que monitoreará el segundo flujo (special_stream) y enviará notificaciones a SNS se crea de manera similar. Por lo tanto, esta lambda debe tener acceso de lectura desde Kinesis y enviar mensajes al tema SNS designado, que luego el servicio SNS enviará a todos los suscriptores de este tema (correo electrónico, SMS, etc.).
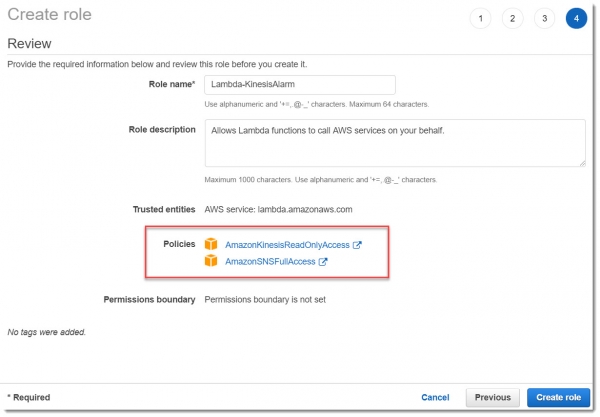
Creación de un rol IAM
Primero creamos el rol IAM Lambda-KinesisAlarm para esta lambda y luego asignamos este rol a la lambda alarm_notifier que se está creando:
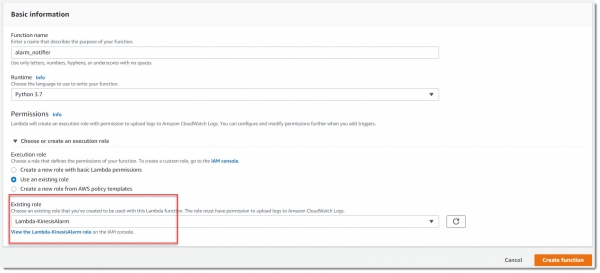
Esta lambda debe funcionar con un disparador al recibir nuevos registros en el flujo special_stream, por lo que es necesario configurar el disparador de manera similar a como lo hicimos para la lambda Collector.
Para facilitar la configuración de esta lambda, introduciremos una nueva variable de entorno: TOPIC_ARN, donde colocamos el ANR (Amazon Resource Names) del tema Airlines:
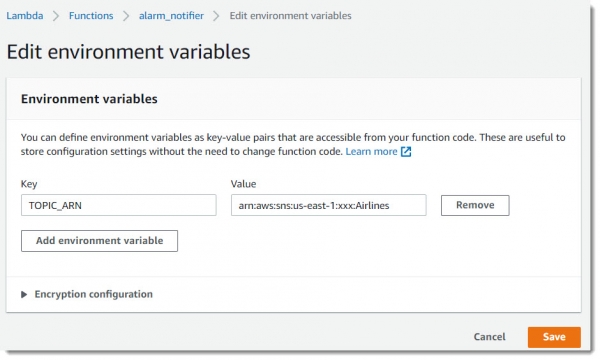
Y colocamos el código de la lambda, que es bastante sencillo:
import boto3
import base64
import os

SNS_CLIENT = boto3.client('sns')
TOPIC_ARN = os.environ['TOPIC_ARN']


def lambda_handler(event, context):
    try:
        SNS_CLIENT.publish(TopicArn=TOPIC_ARN,
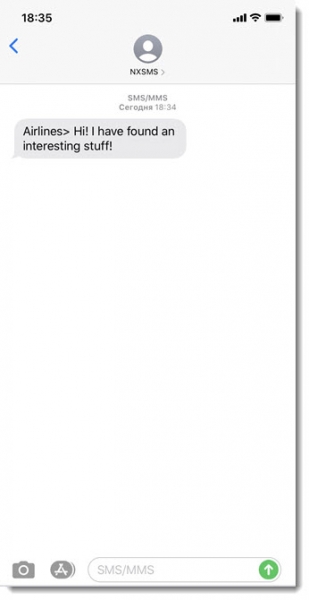
                           Message='¡Hola! He encontrado algo interesante!',
                           Subject='Alarma de boletos de avión')
        print('El mensaje de alarma se ha entregado con éxito')
    except Exception as err:
        print('Error de entrega', str(err))
Parece que la configuración manual del sistema ha terminado. Solo queda probar y asegurarse de que todo esté configurado correctamente.
Despliegue desde el código Terraform
Preparación necesaria
— una herramienta open-source muy conveniente para desplegar infraestructura a partir del código. Tiene su propia sintaxis, que es fácil de aprender y muchos ejemplos de cómo y qué desplegar. Hay muchos plugins útiles en el editor Atom o Visual Studio Code que facilitan el trabajo con Terraform.
Se puede descargar la distribución . Un análisis detallado de todas las capacidades de Terraform va más allá del alcance de este artículo, por lo que nos limitaremos a los puntos principales.
Cómo ejecutar
El código completo del proyecto se encuentra . Clonamos el repositorio. Antes de ejecutar, necesitamos asegurarnos de que tenga instalado y configurado AWS CLI, ya que Terraform buscará las credenciales en el archivo ~/ .aws/ credentials.
Es una buena práctica, antes de desplegar toda la infraestructura, ejecutar el comando plan para ver qué creará Terraform en la nube:
terraform.exe planSe pedirá ingresar un número de teléfono para recibir notificaciones. En esta etapa, no es obligatorio introducirlo.
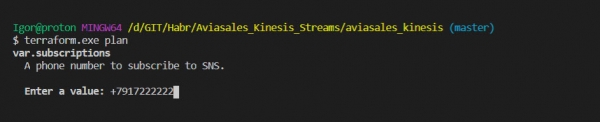
Analizando el plan de trabajo del programa, podemos iniciar la creación de recursos:
terraform.exe applyDespués de enviar este comando, aparecerá nuevamente la solicitud de ingresar el número de teléfono; introducimos «yes» cuando se muestre la pregunta sobre la ejecución real de las acciones. Esto permitirá levantar toda la infraestructura, realizar toda la configuración necesaria de EC2, desplegar funciones lambda, etc.
Después de que todos los recursos se hayan creado con éxito a través del código Terraform, es necesario acceder a los detalles de la aplicación Kinesis Analytics (desafortunadamente, no encontré cómo hacerlo directamente desde el código).
Ejecutamos la aplicación:
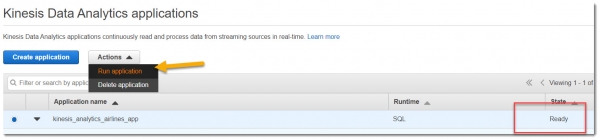
Después de eso, es necesario asignar explícitamente el nombre del flujo en la aplicación, eligiendo de la lista desplegable:
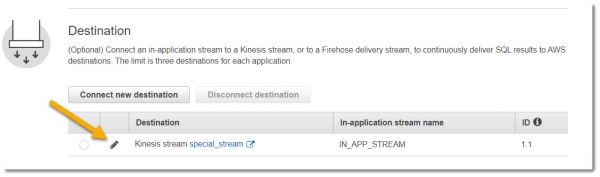
Ahora todo está listo para funcionar.
Prueba del funcionamiento de la aplicación
Independientemente de cómo desplegaste el sistema, manualmente o a través del código Terraform, funcionará de la misma manera.
Accedemos por SSH a la máquina virtual EC2, donde está instalado Kinesis Agent y ejecutamos el script api_caller.py
sudo ./api_caller.py TOKENSolo queda esperar el SMS en su número:
El SMS llega al teléfono prácticamente en 1 minuto:
Solo queda ver si se han guardado los registros en la base de datos DynamoDB para un análisis posterior y más detallado. La tabla airline_tickets contiene datos similares a los siguientes:
Conclusión
Durante el trabajo realizado se construyó un sistema de procesamiento de datos en línea basado en Amazon Kinesis. Se consideraron las opciones de uso de Kinesis Agent en conjunto con Kinesis Data Streams y analítica en tiempo real de Kinesis Analytics mediante comandos SQL, así como la interacción de Amazon Kinesis con otros servicios de AWS.
El sistema descrito arriba lo implementamos de dos maneras: un proceso manual bastante largo y otro rápido mediante código Terraform.
Todo el código fuente del proyecto está disponible , les invito a revisarlo.
Con gusto estoy dispuesto a discutir el artículo, espero sus comentarios. Agradezco la crítica constructiva.
¡Te deseo éxito!
Fuente: habr.com
