

— es un sistema de gestión de bases de datos columnar para el procesamiento en línea de consultas analíticas (OLAP) de código abierto, desarrollado por Yandex. Es utilizado por Yandex, CloudFlare, VK.com, Badoo y otros servicios en todo el mundo para almacenar realmente grandes volúmenes de datos (insertando miles de filas por segundo o petabytes de datos almacenados en disco).
En una base de datos ‘de fila’, cuyos ejemplos son MySQL, Postgres, MS SQL Server, los datos se almacenan en el siguiente orden:
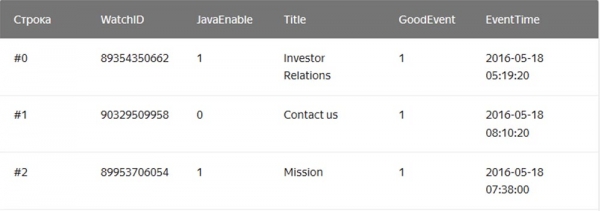
En este caso, los valores asociados a una fila se almacenan físicamente uno al lado del otro. En las bases de datos columnar, los valores de diferentes columnas se almacenan por separado, mientras que los datos de una columna se almacenan juntos:
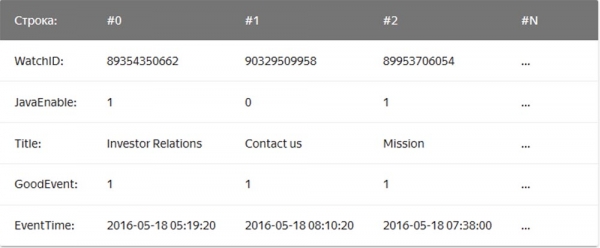
Ejemplos de bases de datos columnar incluyen Vertica, Paraccel (Actian Matrix, Amazon Redshift), Sybase IQ, Exasol, Infobright, InfiniDB, MonetDB (VectorWise, Actian Vector), LucidDB, SAP HANA, Google Dremel, Google PowerDrill, Druid, kdb+.
La empresa es un reenvío de correo comenzó a usar Clickhouse en 2018 para generar informes y quedó muy impresionada por su simplicidad, escalabilidad, soporte SQL y velocidad. La rapidez de esta base de datos era casi mágica.
Simplicidad
Clickhouse se instala en Ubuntu con un solo comando. Si conoces SQL, puedes comenzar a usar Clickhouse de inmediato para tus necesidades. Sin embargo, esto no significa que puedas ejecutar ‘show create table’ en MySQL y hacer un copiado y pegado de SQL en Clickhouse.
En comparación con MySQL, hay diferencias importantes en los tipos de datos en las definiciones de esquemas de tablas, por lo que necesitarás algo de tiempo para modificar las definiciones de los esquemas de tablas y estudiar los motores de las tablas.
Clickhouse funciona perfectamente sin ningún software adicional, pero si deseas usar la replicación, necesitarás instalar ZooKeeper. El análisis de rendimiento de las consultas muestra resultados excelentes: las tablas del sistema contienen toda la información y todos los datos se pueden obtener mediante el viejo y aburrido SQL.
Rendimiento
- comparaciones de Clickhouse con Vertica y MySQL en la configuración del servidor: dos sockets Intel® Xeon® CPU E5-2650 v2 @ 2.60GHz; 128 GiB RAM; md RAID-5 en 8 discos duros SATA de 6TB, ext4.
- comparaciones de Clickhouse con el almacenamiento de datos en la nube Amazon RedShift.
- Extractos del blog :
La base de datos ClickHouse tiene un diseño muy simple: todos los nodos en el clúster tienen la misma funcionalidad y solo utilizan ZooKeeper para la coordinación. Construimos un pequeño clúster de varios nodos y realizamos pruebas, durante las cuales descubrimos que el sistema tiene un rendimiento bastante impresionante, que se corresponde con las ventajas declaradas en los benchmarks de bases de datos analíticas. Decidimos examinar más detenidamente el concepto detrás de ClickHouse. El primer obstáculo para la investigación fue la falta de herramientas y la escasez de la comunidad de ClickHouse, por lo que profundizamos en el diseño de esta base de datos para entender cómo funciona.
ClickHouse no admite la recepción de datos directamente desde Kafka, ya que es solo una base de datos, por lo que escribimos nuestro propio servicio de adaptadores en el lenguaje Go. Leía los mensajes codificados de Cap’n Proto de Kafka, los transformaba en TSV y los insertaba en ClickHouse en paquetes a través de la interfaz HTTP. Posteriormente, reescribimos este servicio para utilizar la biblioteca Go junto con nuestra propia interfaz de ClickHouse para mejorar el rendimiento. Al evaluar el rendimiento de la recepción de paquetes, descubrimos algo importante: el rendimiento de ClickHouse depende en gran medida del tamaño del paquete, es decir, de la cantidad de filas insertadas simultáneamente. Para entender por qué ocurre esto, estudiamos cómo ClickHouse almacena los datos.
El motor principal, o más bien, el conjunto de motores para tablas, utilizado por ClickHouse para el almacenamiento de datos es MergeTree. Este motor es conceptualmente similar al algoritmo LSM utilizado en Google BigTable o Apache Cassandra, sin embargo, evita la construcción de una tabla intermedia en memoria y escribe los datos directamente en el disco. Esto le otorga una excelente capacidad de escritura, ya que cada paquete insertado se clasifica solo por la 'clave primaria' primary key, se comprime y se escribe en el disco para formar un segmento.
La ausencia de una tabla de memoria o de cualquier concepto de "frescura" de los datos también significa que solo se pueden agregar, ya que el sistema no admite modificaciones o eliminaciones. Hasta hoy, la única forma de eliminar datos es eliminarlos por meses calendario, ya que los segmentos nunca cruzan el límite del mes. El equipo de ClickHouse está trabajando activamente para hacer que esta función sea configurable. Por otro lado, esto hace que la escritura y la fusión de segmentos sean sin conflictos, por lo que el ancho de banda de recepción se escala linealmente con el número de inserciones paralelas hasta que se produce la saturación de I/O o núcleos.
Sin embargo, esta circunstancia también significa que el sistema no es adecuado para pequeños paquetes, por lo que se utilizan servicios de Kafka y ensertores para la acumulación. Además, ClickHouse continúa fusionando segmentos en segundo plano, de modo que muchas pequeñas partes de información se unirán y se grabarán más veces, aumentando así la intensidad de escritura. No obstante, demasiadas partes no relacionadas provocarán una reducción agresiva de las inserciones hasta que se complete la fusión. Hemos encontrado que el mejor compromiso entre la recepción de datos en tiempo real y el rendimiento de recepción es la aceptación de un número limitado de inserciones por segundo en la tabla.
La clave para el rendimiento de la lectura de tablas es la indexación y la ubicación de los datos en el disco. Independientemente de cuán rápida sea el procesamiento, cuando el motor necesita escanear terabytes de datos desde el disco y solo utilizar una parte de ellos, tomará tiempo. ClickHouse es un almacén columnar, por lo que cada segmento contiene un archivo para cada columna con valores ordenados para cada fila. Así, columnas enteras que no están en la consulta pueden omitirse en primer lugar, y luego varias celdas pueden procesarse en paralelo con ejecución vectorizada. Para evitar un escaneo completo, cada segmento tiene un pequeño archivo de índice.
Dado que todas las columnas están ordenadas por "clave primaria", el archivo de índice contiene solo las marcas (filas capturadas) de cada N-ésima fila, para poder almacenarlas en memoria incluso para tablas muy grandes. Por ejemplo, se puede establecer una configuración predeterminada de "marcar cada 8192 filas", entonces el "escaso" índice de una tabla con 1 billón de filas, que fácilmente cabe en memoria, ocupará solo 122,070 caracteres.
Desarrollo del sistema
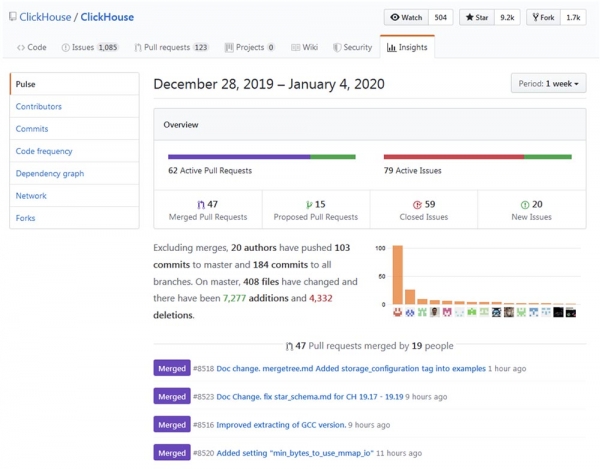
El desarrollo y perfeccionamiento de ClickHouse se puede seguir en y verificar que el proceso de "maduración" se está llevando a cabo a un ritmo impresionante.
Popularidad
Parece que la popularidad de ClickHouse está creciendo exponencialmente, especialmente en la comunidad de habla rusa. La conferencia del año pasado High Load 2018 (Moscú, 8-9 de noviembre de 2018) mostró que monstruos como vk.com y Badoo utilizan ClickHouse, con el que insertan datos (como registros) desde decenas de miles de servidores simultáneamente. En un video de 40 minutos, . Pronto publicaremos la transcripción en Habr para facilitar el trabajo con el material.
Áreas de aplicación
Después de dedicar un tiempo a la investigación, creo que hay áreas en las que ClickHouse puede ser útil o capaz de reemplazar completamente a otras soluciones más tradicionales y populares como MySQL, PostgreSQL, ELK, Google Big Query, Amazon RedShift, TimescaleDB, Hadoop, MapReduce, Pinot y Druid. A continuación se detallan los usos de ClickHouse para modernizar o reemplazar por completo las bases de datos mencionadas anteriormente.
Ampliación de MySQL y PostgreSQL
Recientemente reemplazamos en parte MySQL por ClickHouse para la plataforma de boletines informativos . El problema era que MySQL, debido a un diseño poco acertado, registraba cada correo enviado y cada enlace en ese correo con un hash base64, creando una enorme tabla MySQL (email_stats). Después de enviar a los suscriptores del servicio solo 10 millones de correos, esta tabla ocupaba 150 GB de espacio en disco, y MySQL comenzaba a 'ralentizarse' en consultas simples. Para resolver el problema del espacio en disco, utilizamos con éxito la compresión de la tabla InnoDB, que la redujo a una cuarta parte. Sin embargo, aún no tiene sentido almacenar más de 20-30 millones de correos electrónicos en MySQL solo para leer el historial, ya que cualquier consulta simple que por alguna razón deba realizar un escaneo completo provoca swapping y una gran carga en I/O, lo que nos generaba regularmente alertas de Zabbix.
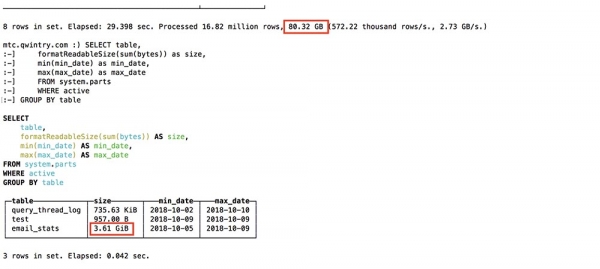
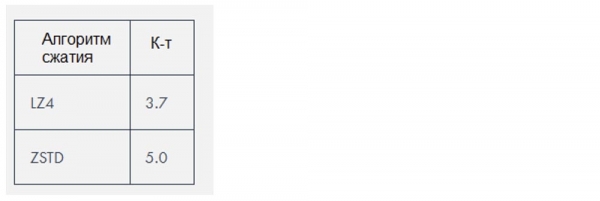
Clickhouse utiliza dos algoritmos de compresión que reducen el volumen de datos aproximadamente en , pero en este caso particular, los datos eran especialmente 'compresibles'.
Reemplazo de ELK
Desde mi propia experiencia, la pila ELK (ElasticSearch, Logstash y Kibana, en este caso particular ElasticSearch) requiere muchos más recursos para ejecutarse de los realmente necesarios para almacenar logs. ElasticSearch es un excelente motor si necesitas una buena búsqueda de texto completo en los logs (aunque no creo que realmente lo necesites), pero me pregunto por qué de facto se ha convertido en el motor estándar para el registro. Su rendimiento de recepción combinado con Logstash nos generaba problemas incluso con cargas bastante pequeñas y requería más memoria RAM y espacio en disco. Como base de datos, Clickhouse es mejor que ElasticSearch por las siguientes razones:
- Soporte para el dialecto SQL;
- Mejor tasa de compresión de datos almacenados;
- Soporte para búsquedas con expresiones regulares Regex en lugar de búsquedas de texto completo;
- Mejor planificación de consultas y mayor rendimiento general.
Actualmente, el mayor problema al comparar ClickHouse con ELK es la falta de soluciones para la exportación de logs, así como la escasez de documentación y tutoriales sobre el tema. Sin embargo, cualquier usuario puede configurar ELK utilizando la guía de Digital Ocean, lo cual es muy importante para la rápida implementación de tecnologías similares. Aquí hay un motor de base de datos, pero aún no hay Filebeat para ClickHouse. Sí, hay y un sistema para trabajar con logs existe una herramienta para ingresar datos de archivos de logs en ClickHouse, pero todo esto requiere más tiempo. Sin embargo, ClickHouse sigue siendo el líder por su simplicidad, por lo que incluso los novatos pueden instalarlo fácilmente y comenzar a usarlo completamente en literalmente 10 minutos.
Preferiendo soluciones minimalistas, intenté usar FluentBit, una herramienta para la descarga de logs que ocupa muy poca memoria, junto con ClickHouse, intentando evitar el uso de Kafka. Sin embargo, es necesario resolver pequeñas incompatibilidades, tales como , antes de que esto se pueda hacer sin una capa proxy que transforme los datos de FluentBit a ClickHouse.
Como alternativa a Kibana, se puede usar ClickHouse como backend . Según entiendo, pueden surgir problemas de rendimiento al renderizar una gran cantidad de puntos de datos, especialmente con versiones más antiguas de Grafana. En Qwintry aún no lo hemos probado, pero las quejas sobre esto aparecen de vez en cuando en el canal de soporte de ClickHouse en Telegram.
Sustituyendo a Google Big Query y Amazon RedShift (solución para grandes empresas)
La opción ideal de uso de BigQuery es cargar 1 TB de datos JSON y ejecutar consultas analíticas sobre ellos. BigQuery es un gran producto, cuya escalabilidad es difícil de sobreestimar. Es un software mucho más complejo que ClickHouse, que funciona en un clúster interno, pero desde el punto de vista del cliente tiene mucho en común con ClickHouse. BigQuery puede volverse rápidamente "costoso" una vez que empieces a pagar por cada SELECT, por lo que es una verdadera solución SaaS con todas sus ventajas y desventajas.
ClickHouse es la mejor opción si realizas muchas consultas que son costosas desde el punto de vista computacional. Cuantas más consultas SELECT realices cada día, más sentido tiene reemplazar BigQuery por ClickHouse, ya que este cambio te ahorrará miles de dólares si se trata de muchos terabytes de datos procesados. Esto no se aplica a los datos almacenados, cuyo procesamiento en BigQuery es bastante económico.
En un artículo del cofundador de Altinity, Alexander Zaitsev se abordan las ventajas de tal migración de base de datos.
Sustitución de TimescaleDB
TimescaleDB es una extensión de PostgreSQL que optimiza el trabajo con series temporales en una base de datos convencional (, ).
Aunque ClickHouse no es un competidor serio en el nicho de series temporales, su estructura columnar y la ejecución vectorizada de consultas lo hacen significativamente más rápido que TimescaleDB en la mayoría de los casos de procesamiento de consultas analíticas. Además, la capacidad de recepción de datos por lotes de ClickHouse es aproximadamente tres veces superior, y realmente utiliza 20 veces menos espacio en disco, lo que es crucial para procesar grandes volúmenes de datos históricos: .
A diferencia de ClickHouse, la única forma de ahorrar un poco de espacio en disco en TimescaleDB es utilizando ZFS u otros sistemas de archivos similares.
Las futuras actualizaciones de ClickHouse probablemente introducirán compresión delta, lo que lo hará aún más adecuado para el procesamiento y almacenamiento de datos temporales. TimescaleDB puede ser la mejor opción en comparación con un ClickHouse "en bruto" en los siguientes casos:
- instalaciones pequeñas con muy poca memoria RAM (<3 GB);
- un gran número de pequeñas inserciones que no deseas agrupar en fragmentos grandes;
- mejor consistencia, uniformidad y requisitos ACID;
- soporte para PostGIS;
- integración con tablas PostgreSQL existentes, ya que esencialmente TimescaleDB es PostgreSQL.
Competencia con sistemas Hadoop y MapReduce
Hadoop y otros productos de MapReduce pueden realizar numerosos cálculos complejos, pero generalmente operan con enormes latencias. ClickHouse resuelve este problema procesando terabytes de datos y entregando resultados casi instantáneamente. Así, ClickHouse es mucho más eficiente para realizar investigaciones analíticas rápidas e interactivas, lo que debería interesar a los especialistas en procesamiento de datos.
Competencia con Pinot y Druid
Los competidores más cercanos de ClickHouse son los productos open source de escalado lineal en columnas Pinot y Druid. Un excelente trabajo comparando estos sistemas fue publicado en el artículo del 1 de febrero de 2018.
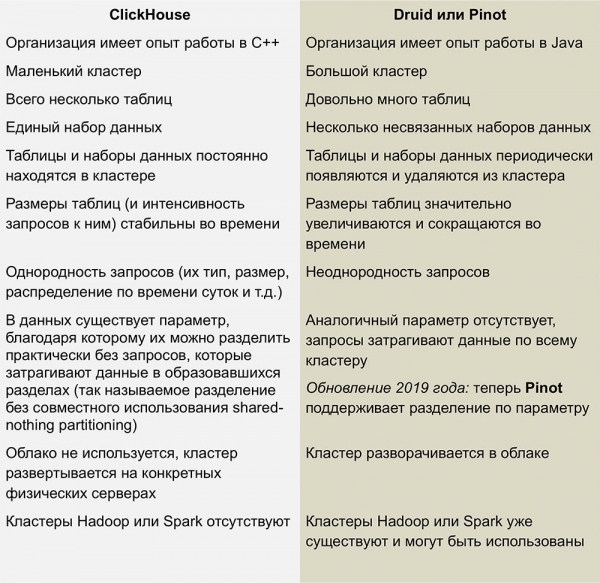
Este artículo necesita actualización: dice que ClickHouse no soporta operaciones UPDATE y DELETE, lo cual no es del todo cierto respecto a las últimas versiones.
No tenemos suficiente experiencia trabajando con estas bases de datos, pero realmente no me gusta la complejidad de la infraestructura necesaria para ejecutar Druid y Pinot; son un montón de "partes móviles" rodeadas de Java por todos lados.
Druid y Pinot son proyectos incubadores de Apache, cuyo progreso se detalla en las páginas de sus proyectos en GitHub. Pinot apareció en el incubador en octubre de 2018, mientras que Druid nació ocho meses antes, en febrero.
La falta de información sobre cómo funciona AFS me genera algunas preguntas, quizás ingenuas. Me pregunto si los autores de Pinot han notado que la Fundación Apache está más inclinada hacia Druid, y si esa actitud ha causado algún tipo de envidia hacia su competidor. ¿Se desacelerará el desarrollo de Druid y se acelerará el de Pinot si los patrocinadores que apoyan al primero se interesan repentinamente por el segundo?
Desventajas de ClickHouse
Inmadurez: es evidente que todavía es una tecnología que no está madura, pero, de todos modos, no veo nada similar en otras bases de datos de columna.
Las pequeñas inserciones funcionan mal a alta velocidad: las inserciones deben agruparse en bloques grandes, porque el rendimiento de las pequeñas inserciones disminuye en proporción al número de columnas en cada fila. Así es como ClickHouse almacena los datos en el disco: cada columna representa 1 archivo o más, por lo tanto, para insertar 1 fila que contenga 100 columnas, es necesario abrir y escribir al menos 100 archivos. Por eso se requiere un intermediario para la inserción en búfer (a menos que el propio cliente proporcione el almacenamiento en búfer), que suele ser Kafka o algún sistema de gestión de colas. También se puede utilizar el motor Buffer table para copiar grandes fragmentos de datos a las tablas MergeTree luego.
Las uniones de tablas están limitadas por la memoria RAM del servidor, ¡pero al menos existen! Por ejemplo, Druid y Pinot no tienen tales uniones porque son difíciles de implementar directamente en sistemas distribuidos que no soportan el movimiento de grandes bloques de datos entre nodos.
Conclusiones
En los próximos años, planeamos utilizar ampliamente ClickHouse en Qwintry, ya que este SGBD ofrece un excelente equilibrio entre rendimiento, bajos costos generales, escalabilidad y simplicidad. Estoy casi seguro de que comenzará a expandirse rápidamente, una vez que la comunidad de ClickHouse encuentre más formas de utilizarlo en instalaciones pequeñas y medianas.
Un poco de publicidad 🙂
Gracias por permanecer con nosotros. ¿Te gustan nuestros artículos? ¿Quieres ver más contenido interesante? Apóyanos haciendo un pedido o recomendando a tus conocidos, , un análogo único de servidores entry-level que hemos diseñado para Ti: (disponibles opciones con RAID1 y RAID10, hasta 24 núcleos y hasta 40GB DDR4).
¿Dell R730xd a mitad de precio en el centro de datos Equinix Tier IV en Ámsterdam? Solo aquí ¡en los Países Bajos! Dell R420 — 2x E5-2430 2.2Ghz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — ¡desde $99! Lee sobre cómo
Fuente: habr.com
