

Los algoritmos basados en datos, como las redes neuronales, han tomado el mundo por asalto. Su desarrollo se debe a varias razones, incluyendo el hardware asequible y potente y la gran cantidad de datos disponibles. Actualmente, las redes neuronales están a la vanguardia de todas las tareas 'cognitivas', como el reconocimiento de imágenes, la comprensión del lenguaje natural, etc. Pero no deben limitarse a tales tareas. Este material trata sobre cómo comprimir imágenes utilizando redes neuronales a través del aprendizaje residual. El enfoque presentado en el artículo es más rápido y mejor que los códecs estándar. Diagramas, ecuaciones y, por supuesto, una tabla de pruebas se encuentran bajo el corte.
Este artículo se basa en trabajo. Se supone que estás familiarizado con las redes neuronales y sus conceptos convolución y función de pérdida.
¿Qué es la compresión de imágenes y qué tipos existen?
La compresión de imágenes es el proceso de convertir una imagen de tal manera que ocupe menos espacio. Simplemente almacenar imágenes ocuparía mucho espacio, por lo que existen códecs como JPEG y PNG que tienen como objetivo reducir el tamaño de la imagen original.
Como es bien sabido, hay dos tipos de compresión de imágenes: sin pérdida y con pérdida. Como indican los nombres, en la compresión sin pérdida se pueden recuperar los datos de la imagen original, mientras que en la compresión con pérdida se pierden algunos datos durante el proceso de compresión. Por ejemplo, JPG utiliza algoritmos con pérdida [nota del traductor: no olvidemos tampoco JPEG sin pérdida], mientras que PNG es un algoritmo sin pérdida.
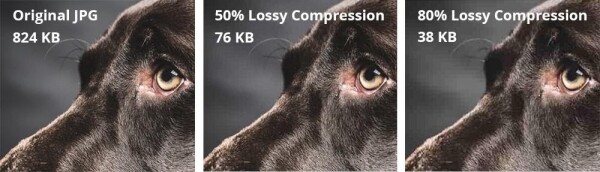
Comparación entre compresión sin pérdida y con pérdida
Tenga en cuenta que en la imagen de la derecha hay muchos artefactos en bloques. Esta es información perdida. Los píxeles vecinos de colores similares se comprimen como una sola área para ahorrar espacio, pero se pierde información sobre los píxeles reales. Por supuesto, los algoritmos aplicados en los códecs JPEG, PNG, etc., son mucho más complejos, pero este es un buen ejemplo intuitivo de compresión con pérdida. La compresión sin pérdida es buena, pero los archivos comprimidos sin pérdida ocupan mucho espacio en disco. Hay formas más eficaces de comprimir imágenes sin perder una gran cantidad de información, pero son bastante lentas, y muchas emplean enfoques iterativos. Esto significa que no se pueden ejecutar en paralelo en varios núcleos de la CPU o GPU. Esta limitación las hace completamente imprácticas para el uso diario.
Entrada de la red neuronal convolucional
Si se necesita calcular algo y los cálculos pueden ser aproximados, añada . Los autores utilizaron una red neuronal convolucional bastante estándar para mejorar la compresión de imágenes. El método presentado no solo funciona al nivel de las mejores soluciones (si no por encima), sino que también puede utilizar cálculos paralelos, lo que resulta en un aumento drástico de la velocidad. La razón es que las redes neuronales convolucionales (CNN) son muy buenas para extraer información espacial de las imágenes, que luego se representan de forma más compacta (por ejemplo, se guardan solo los 'bits importantes' de la imagen). Los autores querían aprovechar esta capacidad de las CNN para representar mejor las imágenes.
Arquitectura
Los autores propusieron una red dual. La primera red toma una imagen como entrada y genera una representación compacta (ComCNN). La salida de esta red se procesa luego mediante un códec estándar (por ejemplo, JPEG). Tras el procesamiento por el códec, la imagen se pasa a la segunda red, que 'corrige' la imagen del códec en un intento de recuperar la imagen original. Los autores llamaron a esta red la CNN reconstructora (RecCNN). Al igual que en las GAN, ambas redes se entrenan de forma iterativa.
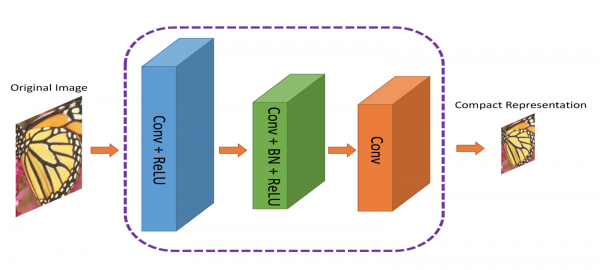
La representación compacta ComCNN se transfiere al códec estándar
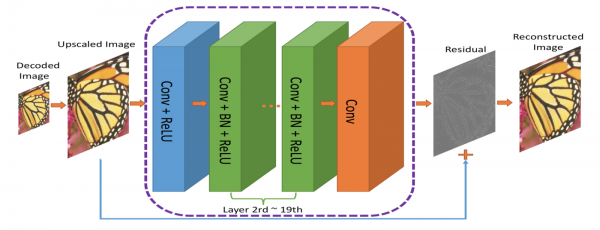
RecCNN. La salida de ComCNN se escala y se envía a RecCNN, que intentará aprender el residuo
Los resultados del códec se escalan a medida que aumentan y luego se transmiten a RecCNN. RecCNN intentará producir una imagen que se asemeje lo más posible al original.
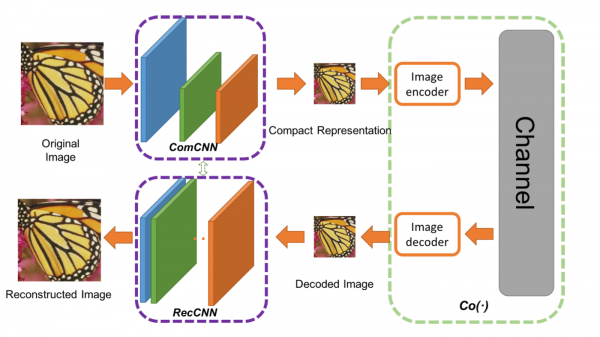
Un marco de compresión de imágenes. Co(.) es un algoritmo de compresión de imágenes. Los autores aplicaron JPEG, JPEG2000 y BPG.
¿Qué es el residuo?
El residuo puede considerarse un paso de post-procesamiento para "mejorar" la imagen decodificada por el códec. Con una gran cantidad de "información" sobre el mundo, la red neuronal puede tomar decisiones cognitivas sobre qué corregir. Esta idea se basa en , sobre el cual puede leer más detalles. .
Funciones de pérdida
Se utilizan dos funciones de pérdida porque tenemos dos redes neuronales. La primera de ellas, ComCNN, está marcada como L1 y se define así:
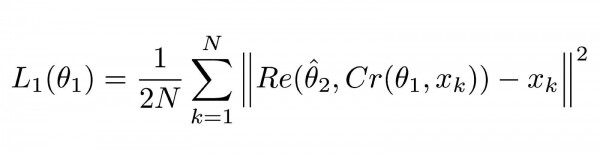
Función de pérdida para ComCNN
Explicación
Esta ecuación puede parecer compleja, pero en realidad es un estándar (error cuadrático medio). MSE. ||² significa la norma del vector que ellos envuelven.
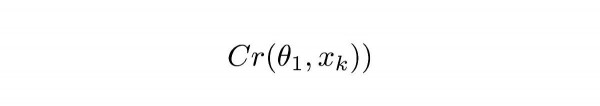
Ecuación 1.1
Cr representa los resultados de ComCNN. θ representa los parámetros entrenables de ComCNN, XK es la imagen de entrada.
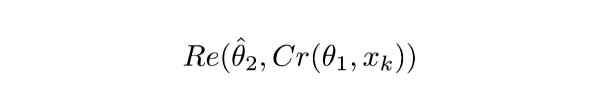
Ecuación 1.2
Re() representa a RecCNN. Esta ecuación simplemente transmite el valor de la ecuación 1.1 a RecCNN. θ representa los parámetros entrenables de RecCNN (el sombrero encima indica que los parámetros son fijos).
Definición intuitiva
La ecuación 1.0 hará que ComCNN ajuste sus pesos de modo que, después de ser recreada con RecCNN, la imagen final se asemeje lo más posible a la imagen de entrada. La segunda función de pérdida de RecCNN se define así:
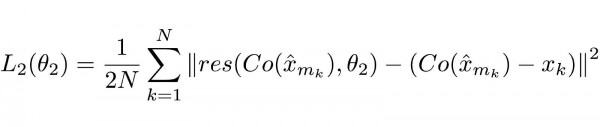
Ecuación 2.0
Explicación
Una vez más, la función puede parecer compleja, pero en su mayor parte es una función de pérdida estándar de la red neuronal (MSE).
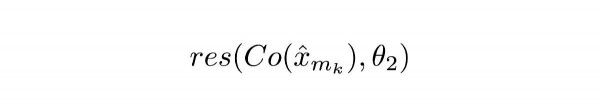
Ecuación 2.1
Co() representa la salida del códec, x con un sombrero encima indica la salida de ComCNN. θ2 son los parámetros entrenables de RecCNN, res() simplemente representa la salida residual de RecCNN. Cabe señalar que RecCNN se entrena con la diferencia entre Co() y la imagen de entrada, pero no con la imagen de entrada.
Definición intuitiva
La ecuación 2.0 hará que RecCNN ajuste sus pesos para que la salida se asemeje lo más posible a la imagen de entrada.
Esquema de entrenamiento
Los modelos se entrenan iterativamente, de manera similar a Los pesos del primer modelo se fijan, mientras que los pesos del segundo modelo se actualizan; luego, los pesos del segundo modelo se fijan mientras se entrena el primer modelo.
Pruebas
Los autores compararon su método con los métodos existentes, incluidos los códecs simples. Su método funciona mejor que los demás, manteniendo alta velocidad en el equipo correspondiente. Además, los autores intentaron usar solo una de las dos redes y notaron una caída en el rendimiento.
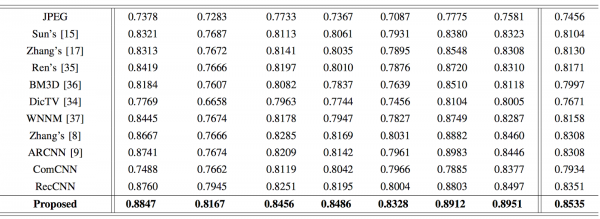
Comparación del índice de similitud estructural (SSIM). Los valores altos indican una mejor similitud con el original. Los resultados de los autores están en negrita.
Conclusión
Hemos examinado un nuevo enfoque para aplicar el aprendizaje profundo a la compresión de imágenes, y discutido la posibilidad de usar redes neuronales en tareas más allá de las 'generales', como la clasificación de imágenes y el procesamiento del lenguaje. Este método no solo cumple con los requisitos modernos, sino que también permite procesar imágenes mucho más rápido.
Estudiar redes neuronales se ha vuelto más fácil, ya que hemos creado un código promocional especialmente para los usuarios de Habr. HABR, que ofrece un 10% de descuento adicional sobre el descuento indicado en el banner.
Más cursos
Artículos recomendados
Fuente: habr.com
